 콘텐츠로 건너뛰기



AI 대 머신러닝 vs. 딥러닝: 차이점은 무엇인가요?
인공지능(AI)은 우리 시대를 정의하는 기술이지만, 이를 둘러싼 용어는 끊임없이 오용되고 있습니다. 비즈니스 리더와 언론 매체가 마치 똑같은 의미를 의미하는 것처럼 "AI", "Machine Learning"(ML) 및 "Deep Learning"(DL)을 사용하는 것을 종종 듣게 될 것입니다. 그들은하지 않습니다.
현대 기술과 ChatGPT와 같은 도구가 실제로 적합한 위치를 이해하려면 차이점을 알아야 합니다.
다음은 AI, 기계 학습 및 딥 러닝을 이해하고 서로 어떻게 관련되어 있는지, 각 용어를 정확히 언제 사용해야 하는지에 대한 완전한 초보자 친화적인 가이드입니다.
임원 답변: 30초 요약
다음 회의에서 사용할 정확한 정의를 찾고 있다면 다음과 같습니다.
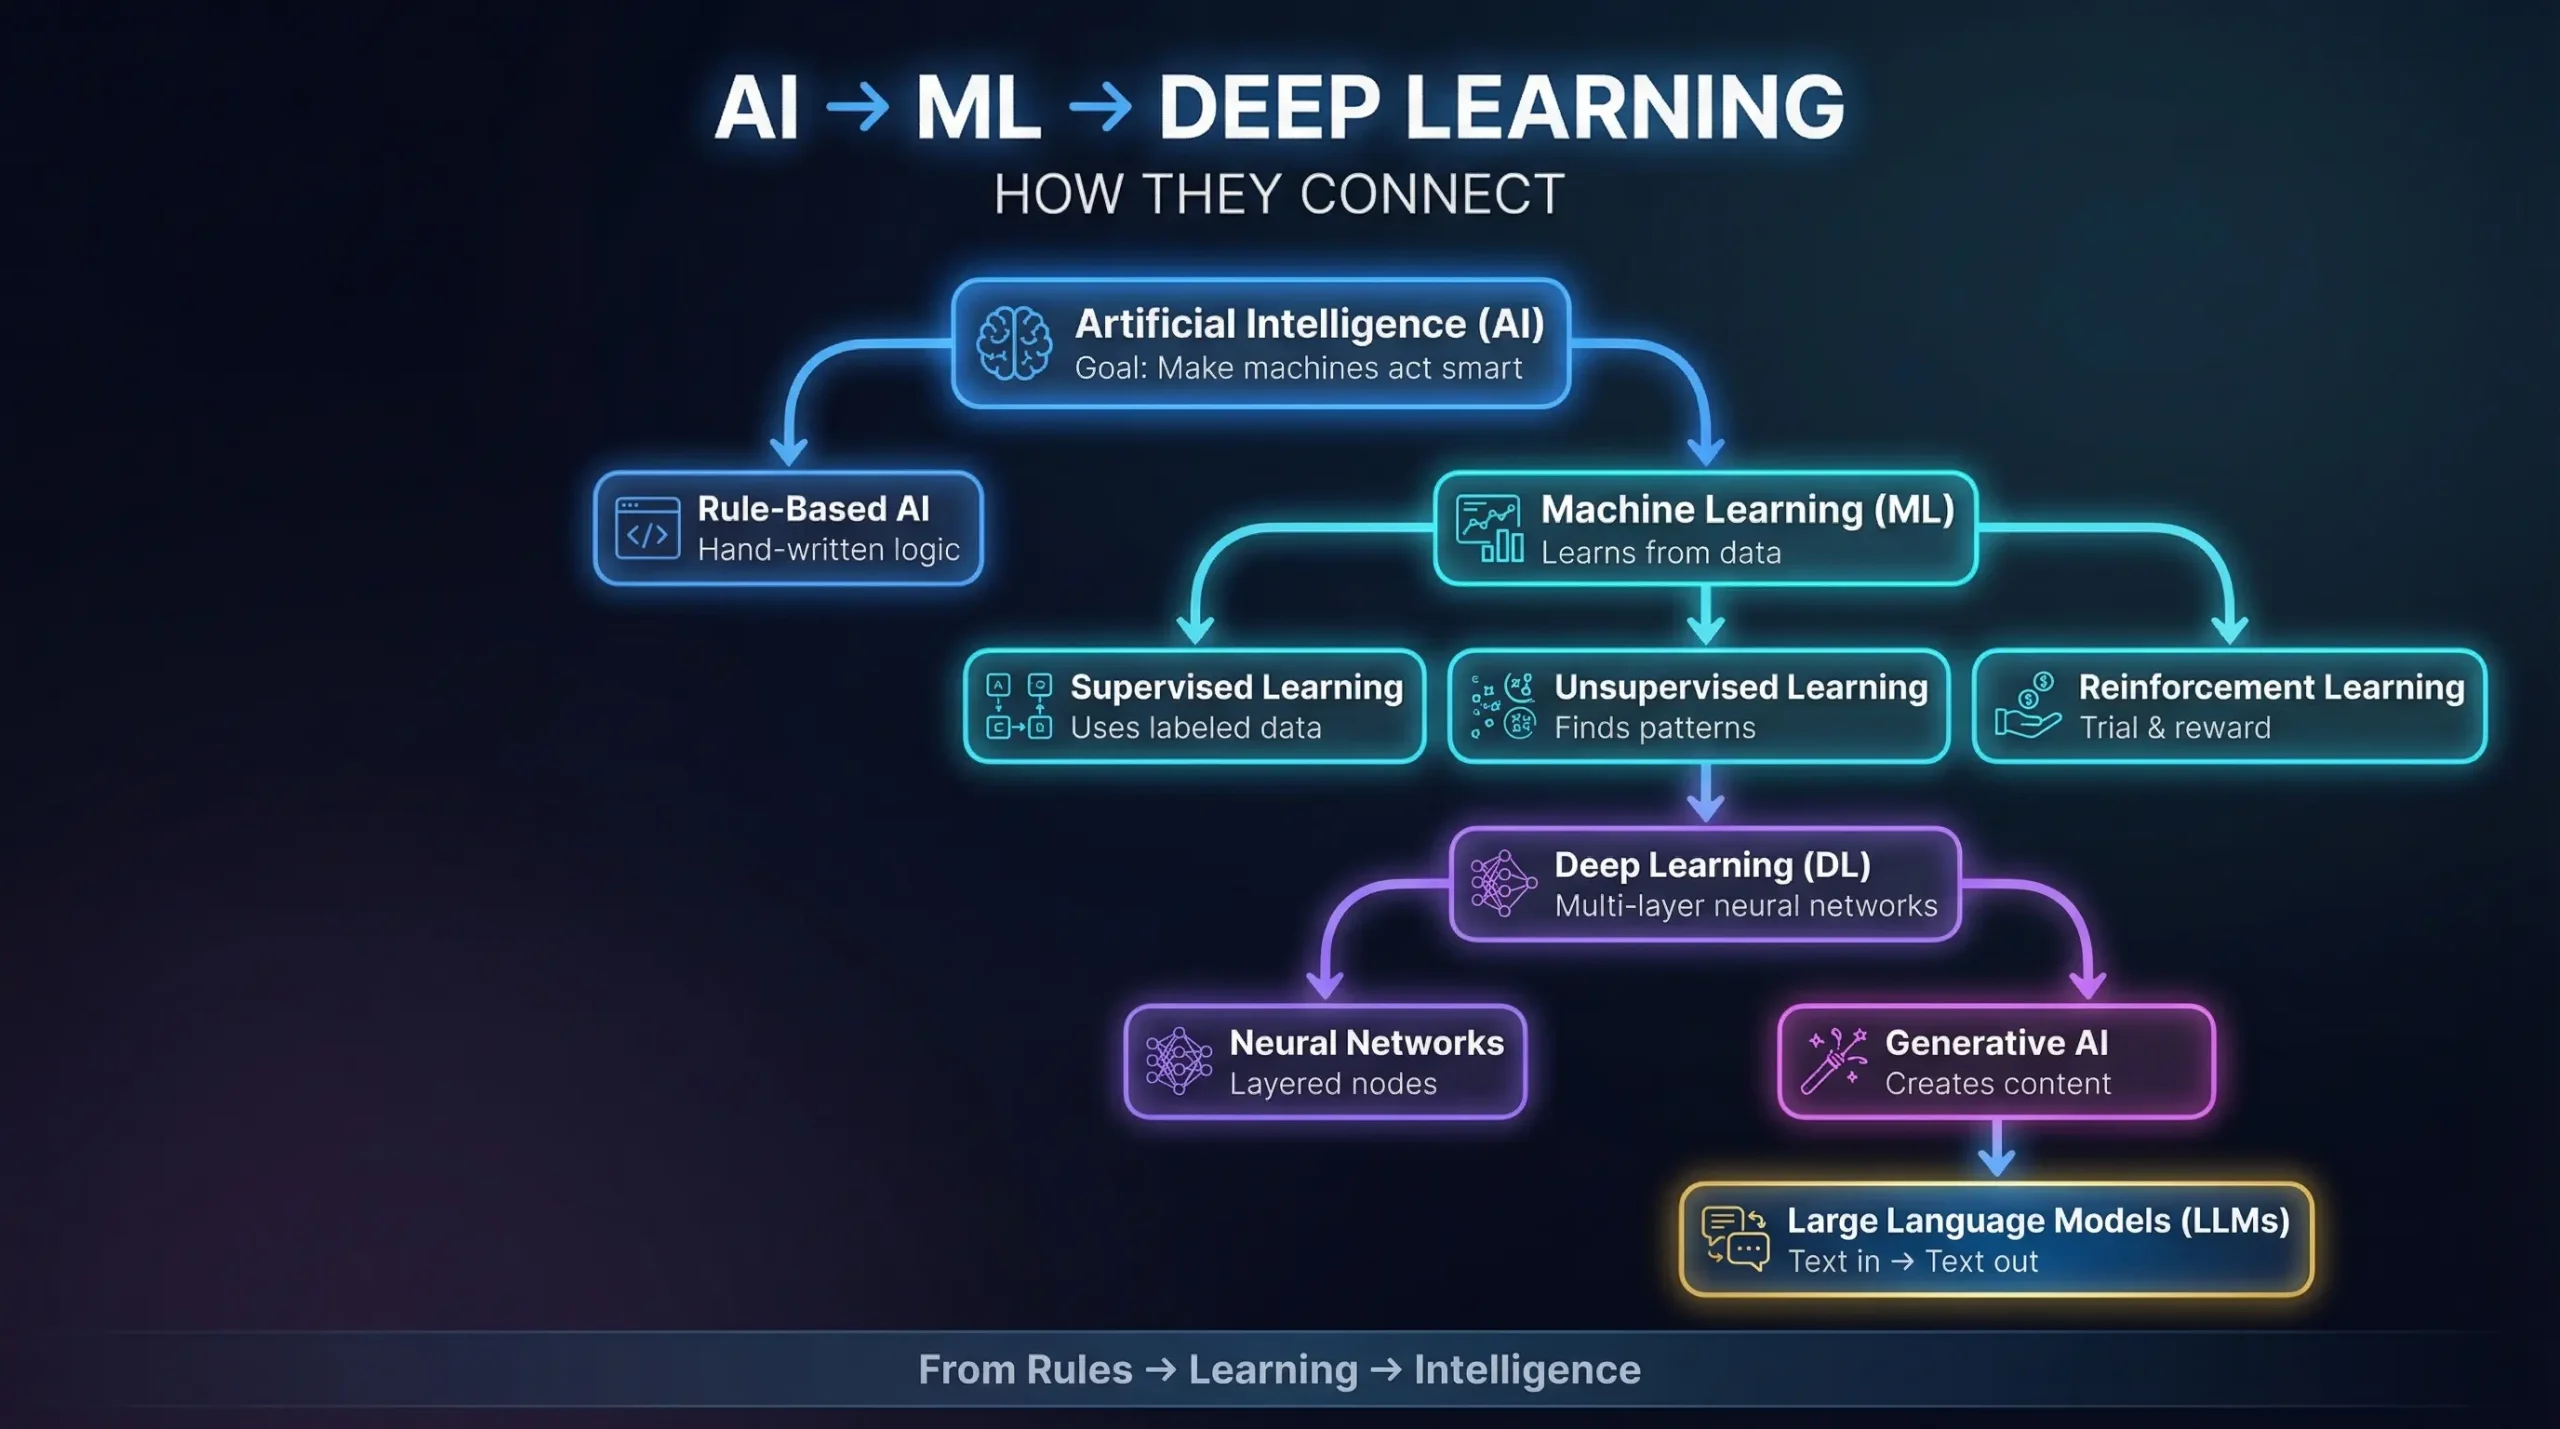
- 인공지능(AI): 컴퓨터가 "스마트"하게 행동하고 인간의 문제 해결 능력을 모방하는 광범위한 개념.
- 기계 학습(ML): 컴퓨터가 손으로 쓴 규칙에 의존하지 않고 성능을 향상시키기 위해 데이터를 학습하는 AI를 수행하는 특정 방법입니다.
- 딥 러닝(DL): 인공 신경망의 여러 계층을 사용하는 고도로 발전된 유형의 머신러닝으로, 방대한 양의 데이터를 공급할 때 매우 강력해집니다.
관계를 그리는 가장 간단한 방법
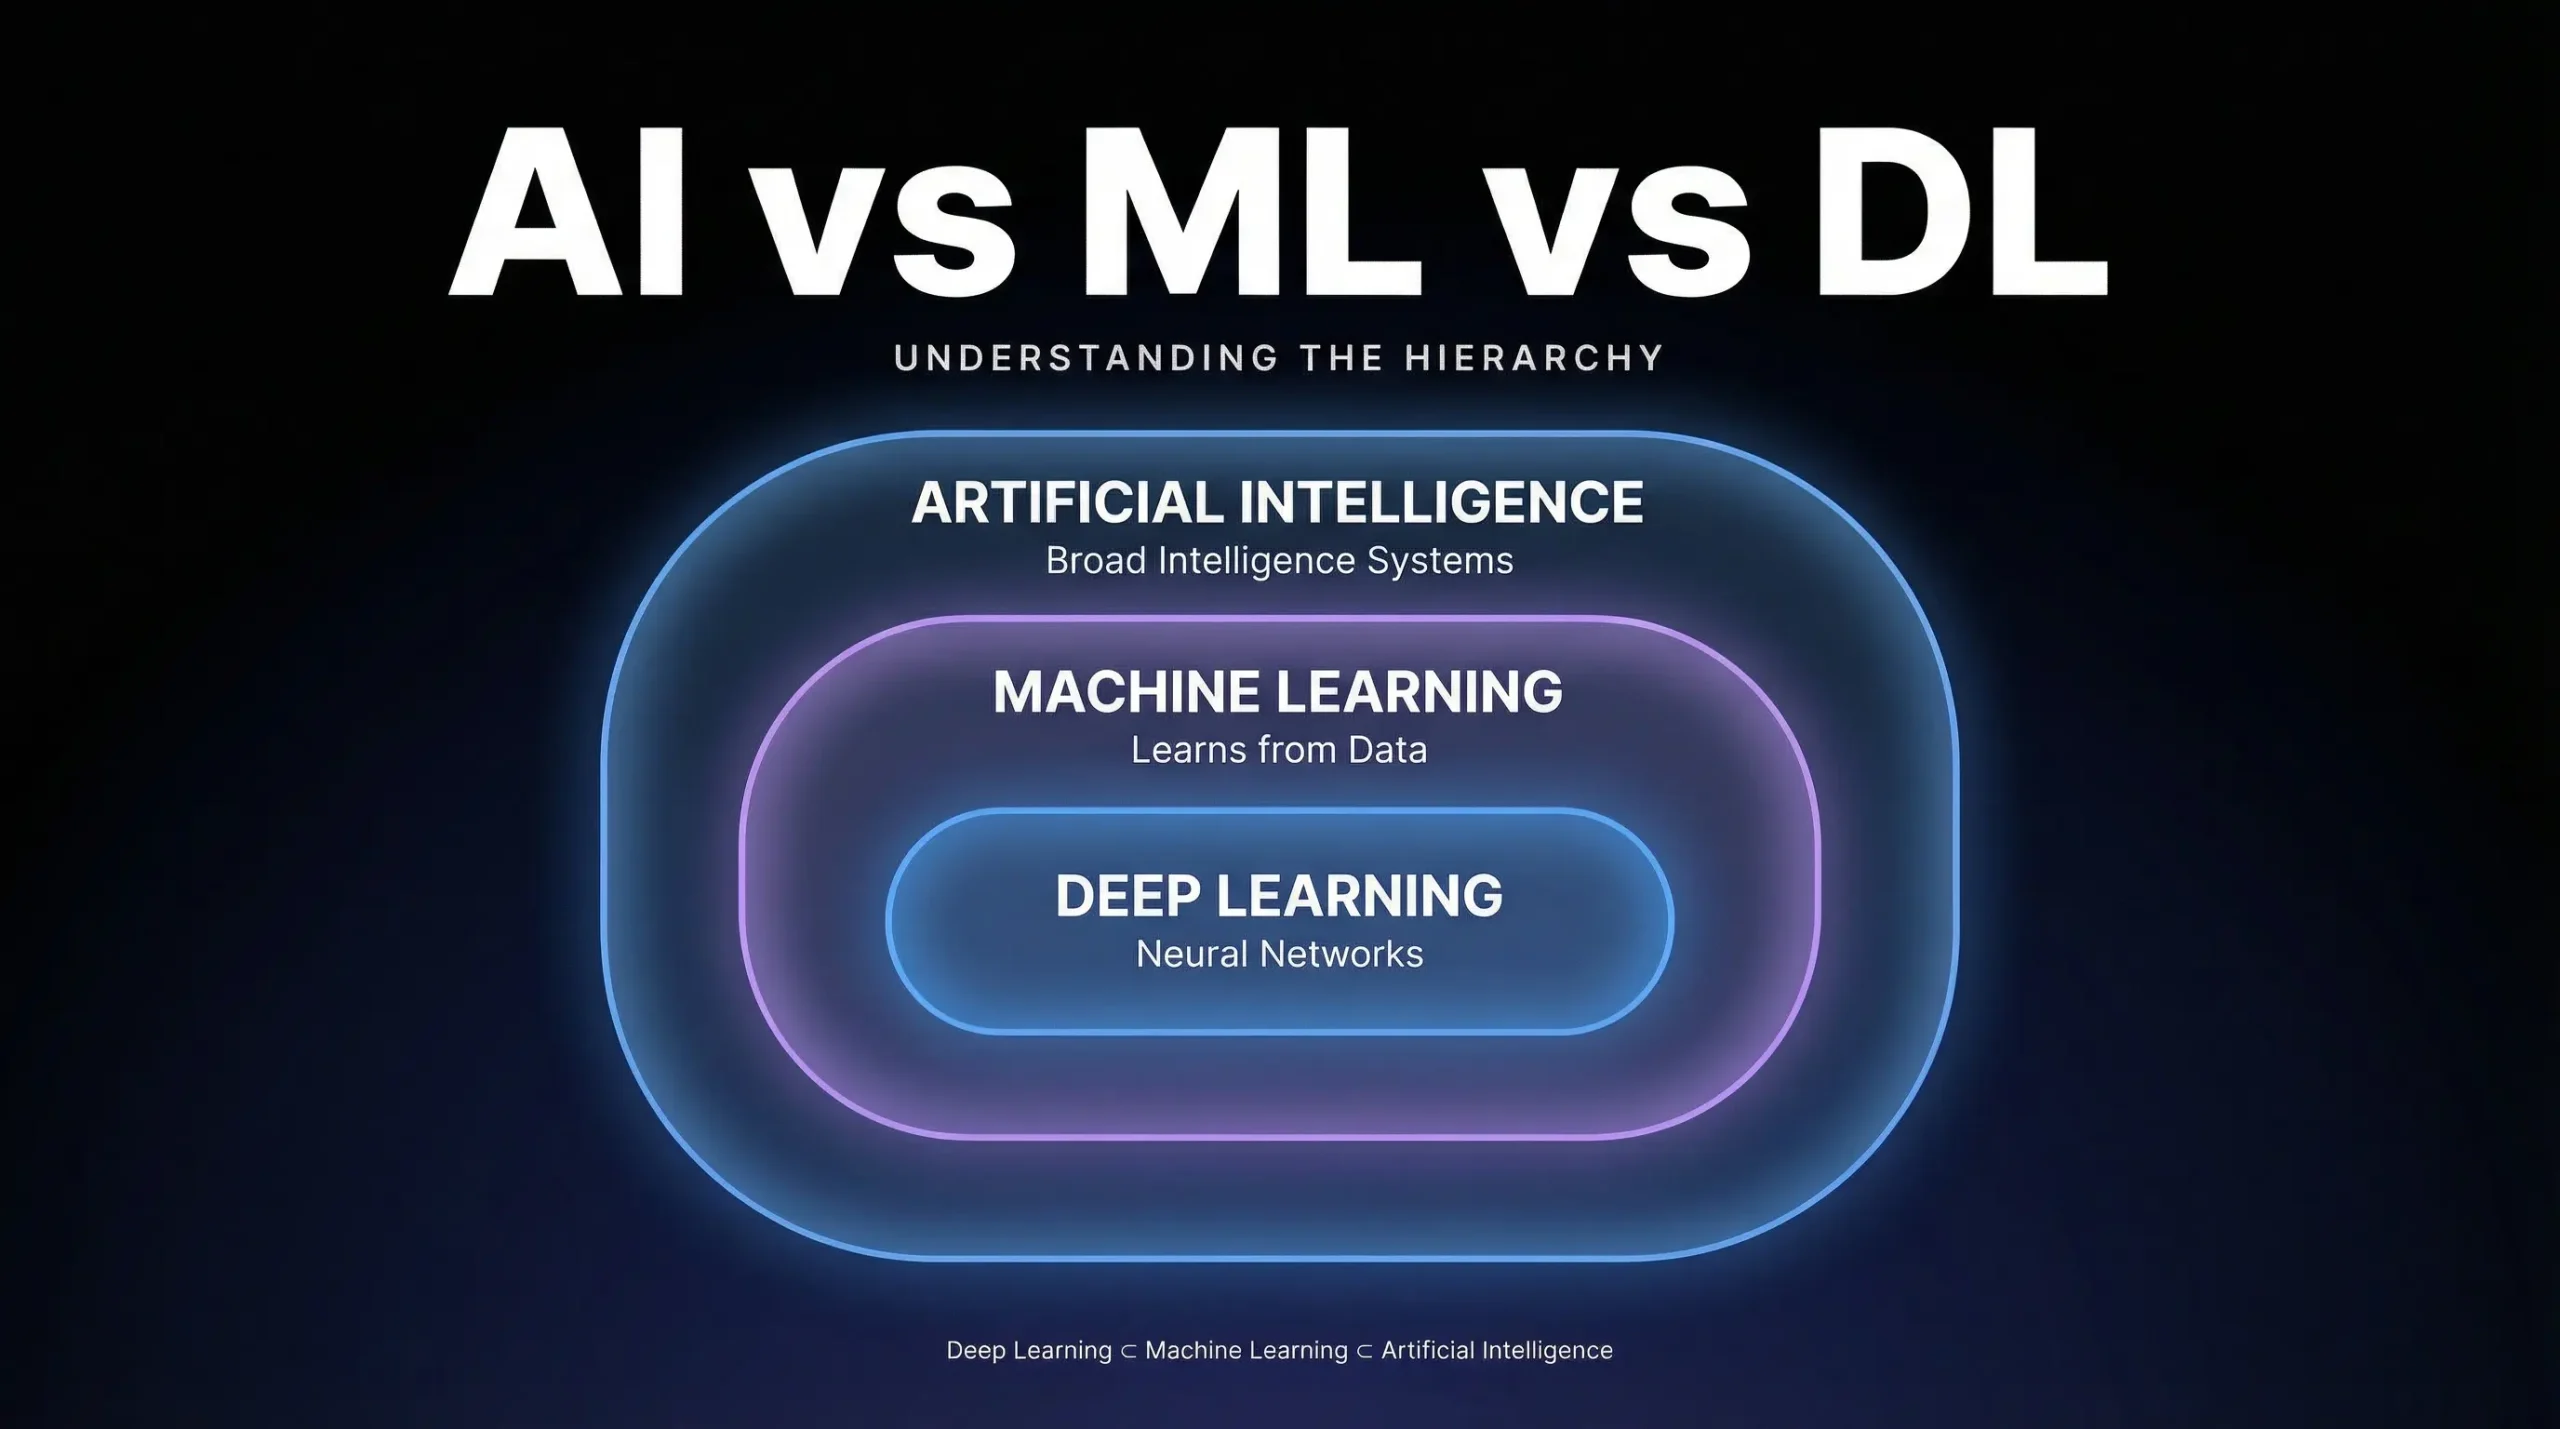
이러한 기술이 어떻게 조화를 이루는지 이해하는 가장 정확한 방법은 중첩된 원의 집합으로 묘사하는 것입니다.
- AI는 외부 우산입니다. 그것은 모든 것을 포함합니다.
- ml는 중간 원입니다. AI 서클 안에 완전히 앉아 있는 부분집합입니다.
- DL은 중심 원입니다. 기계 학습 서클 안에 완전히 앉아 있는 더 작은 하위 집합입니다.

AI가 의미하는 것(그리고 사람들이 그것을 혼동하는 이유)
"인공 지능"의 개념은 새로운 것이 아닙니다. 이 용어는 공식적으로 1955 다트머스 대학 연구 제안, 기계가 언어를 사용하고, 추상화를 형성하고, 인간을 위한 문제를 해결하는 방법을 찾고자 했습니다. 그 직전인 1950년에는 컴퓨팅 파이오니아 앨런 튜링 proposed the “imitation game”—now famous as the Turing Test—to measure a machine’s ability to exhibit intelligent behavior.
오늘날 사람들이 혼란스러워하는 이유는 핵심 사실을 잊어버리기 때문입니다. 모든 AI가 배우는 것은 아닙니다.
규칙 기반 AI 대 학습 기반 AI
AI를 이해하려면 AI를 두 개의 역사적 진영으로 나누어야 합니다.
- 규칙 기반 AI(좋은 구식 AI): 초기에 프로그래머는 수천 개의 엄격한 "X가 발생하면 Y를 수행하십시오"라는 규칙을 작성했습니다. 1997년 Garry Kasparov를 꺾은 세금 계산기나 유명한 Chess Computer Deep Blue를 생각해 보십시오. Deep Blue는 훌륭했지만 그렇지 않았습니다. 배우다 체스; 그것은 인간이 쓴 규칙을 기반으로 수백만 개의 프로그래밍된 가능성을 평가했습니다.
- 학습 기반 AI: 이것은 현대 시대입니다. 모든 규칙을 하드 코딩하는 대신 엔지니어는 컴퓨터 데이터를 제공하고 규칙 자체를 파악하도록 합니다. 이것은 우리를 기계 학습으로 이끕니다.
기계 학습의 의미("학습"이 작동하는 방식)
머신러닝(ML)은 컴퓨터 과학의 패러다임을 바꿨다. 작업을 해결하기 위해 컴퓨터를 프로그래밍하는 대신 컴퓨터를 다음과 같이 프로그래밍합니다. 배우다 작업을 해결합니다.
두 명의 전설적인 컴퓨터 과학자가 오늘날에도 여전히 사용하고 있는 학문적 정의를 제공했습니다.
- 아서 사무엘(1959): 컴퓨터가 명시적으로 프로그래밍되지 않고 학습할 수 있는 능력을 제공하는 연구 분야로 ML을 설명했습니다.
- 톰 미첼(1997): 컴퓨터 프로그램이 그 경험으로 성능이 향상되는 경우 일부 "작업"과 관련하여 "경험"에서 배운다고 명시한 엔지니어링 정의를 제공했습니다.
간단한 ML 워크플로
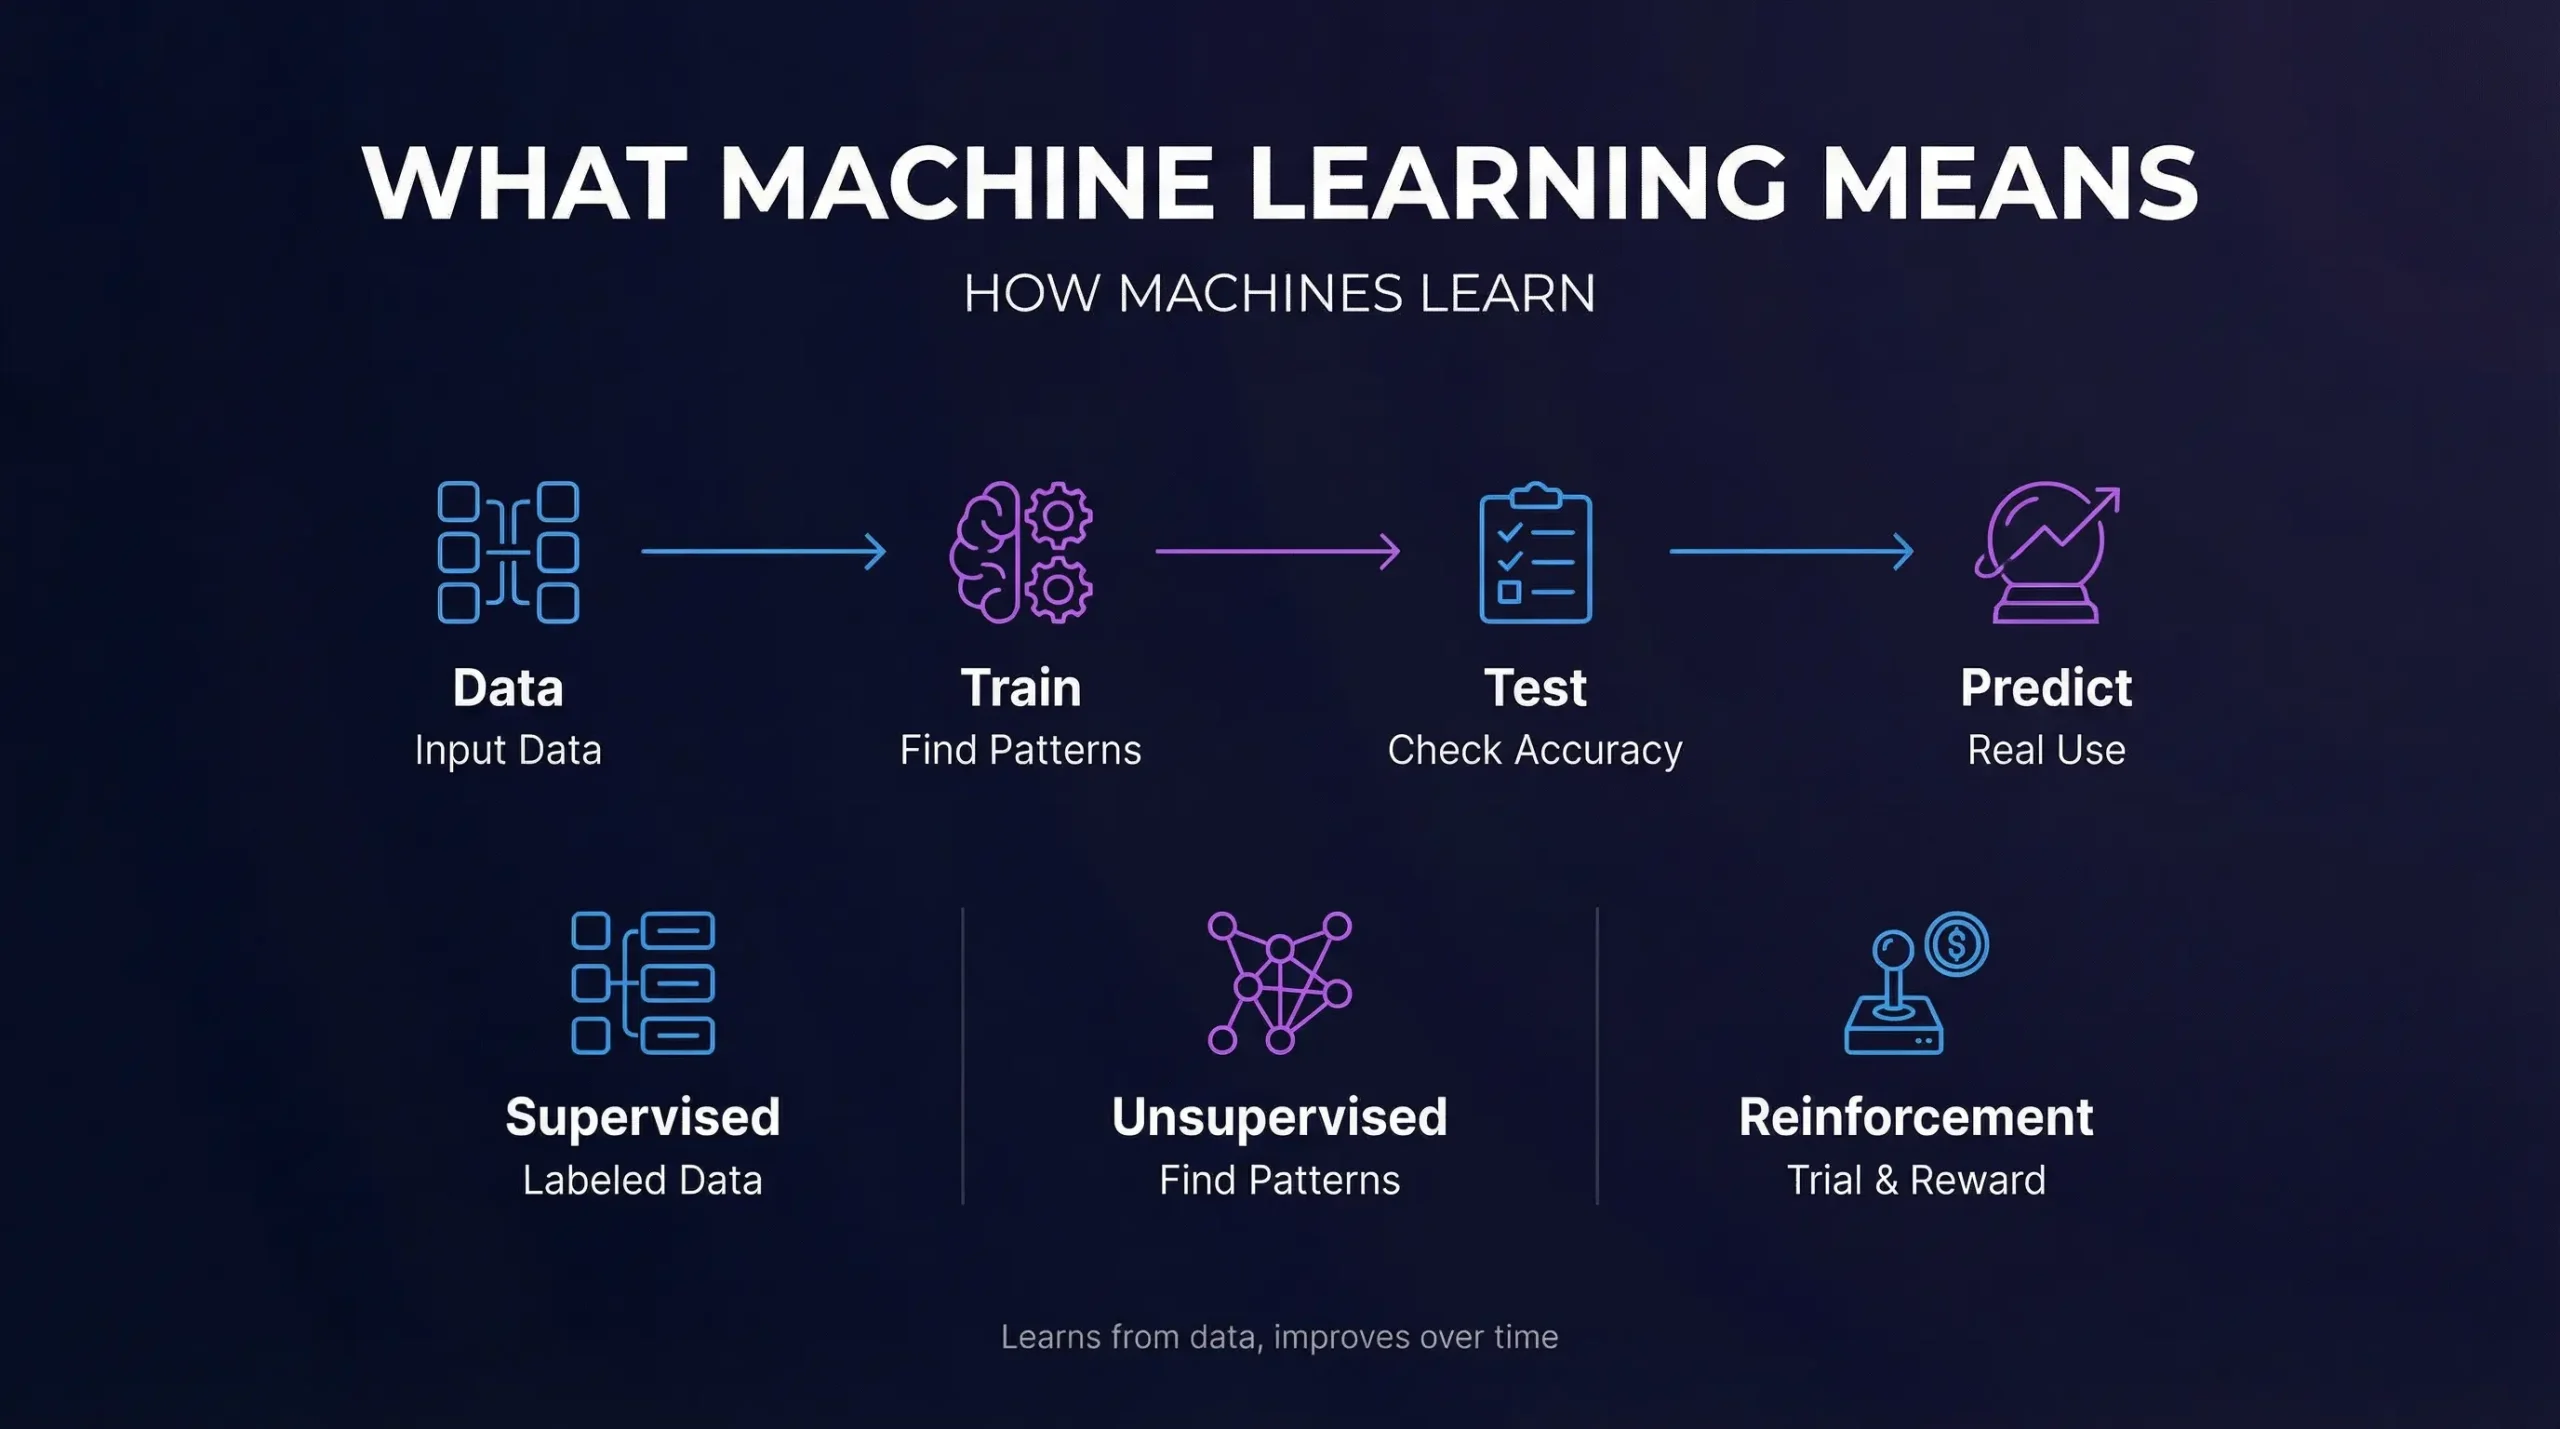
기계는 실제로 어떻게 배우는가? 일반적으로 4단계 주기를 따릅니다.
- 데이터 수집: 기록 데이터(예: 100,000개의 이메일, 일부는 "스팸"으로 표시됨, 일부는 "안전함"로 표시됨)를 제공합니다.
- 교육 단계: 알고리즘은 데이터를 분석하여 수학적 패턴을 검색합니다(예: "복권 당첨자"라는 단어가 있는 이메일과 링크는 일반적으로 스팸입니다).
- 테스트 단계: 당신은 모델에 보이지 않는 새 이메일을 주어 예측이 정확한지 확인합니다.
- 추론(사용): 훈련된 모델은 실시간으로 받은 편지함을 자동으로 필터링하기 위해 배포됩니다.
기계 학습의 세 가지 주요 유형
- 지도 학습: 알고리즘은 명확하게 레이블이 지정된 데이터에 대해 훈련됩니다. 예: "cat" 또는 "dog"라는 레이블이 명시된 사진에 대해 훈련된 시스템을 통해 향후 사진을 분류할 수 있습니다.
- 감독되지 않은 학습: 알고리즘에 지저분하고 레이블이 지정되지 않은 데이터가 주어지고 숨겨진 구조 또는 그룹화를 찾기 위해 요청됩니다. 예: 해당 클러스터를 정확히 무엇이라고 불러야 할지 모른 채 유사한 구매 습관을 가진 고객을 클러스터링하는 전자 상거래 사이트.
- 강화 학습: 알고리즘은 시뮬레이션된 환경에서 순전히 시행착오를 통해 학습하여 좋은 결정에 대한 수학적 "보상"을 얻습니다. 예: 물리 시뮬레이터에서 걷는 법을 배우는 AI.
딥 러닝이 의미하는 것("깊은 것"으로 만드는 것)
딥 러닝(DL)은 우리가 지금 겪고 있는 대규모 AI 붐을 담당하는 최첨단 기술입니다.
그것은 인공을 기반으로합니다 신경망, 인간 뇌의 생물학적 뉴런에서 느슨하게 영감을 받은 컴퓨팅 아키텍처. 초기 신경망은 수십 년 동안 존재했지만 컴퓨터 과학자의 기초 연구는 다음과 같습니다. Yann Lecun, Yoshua Bengio, Geoffrey Hinton 이러한 네트워크를 복잡한 계층으로 쌓으면 탁월한 결과를 얻을 수 있음을 입증했습니다.
딥 러닝의 레이어
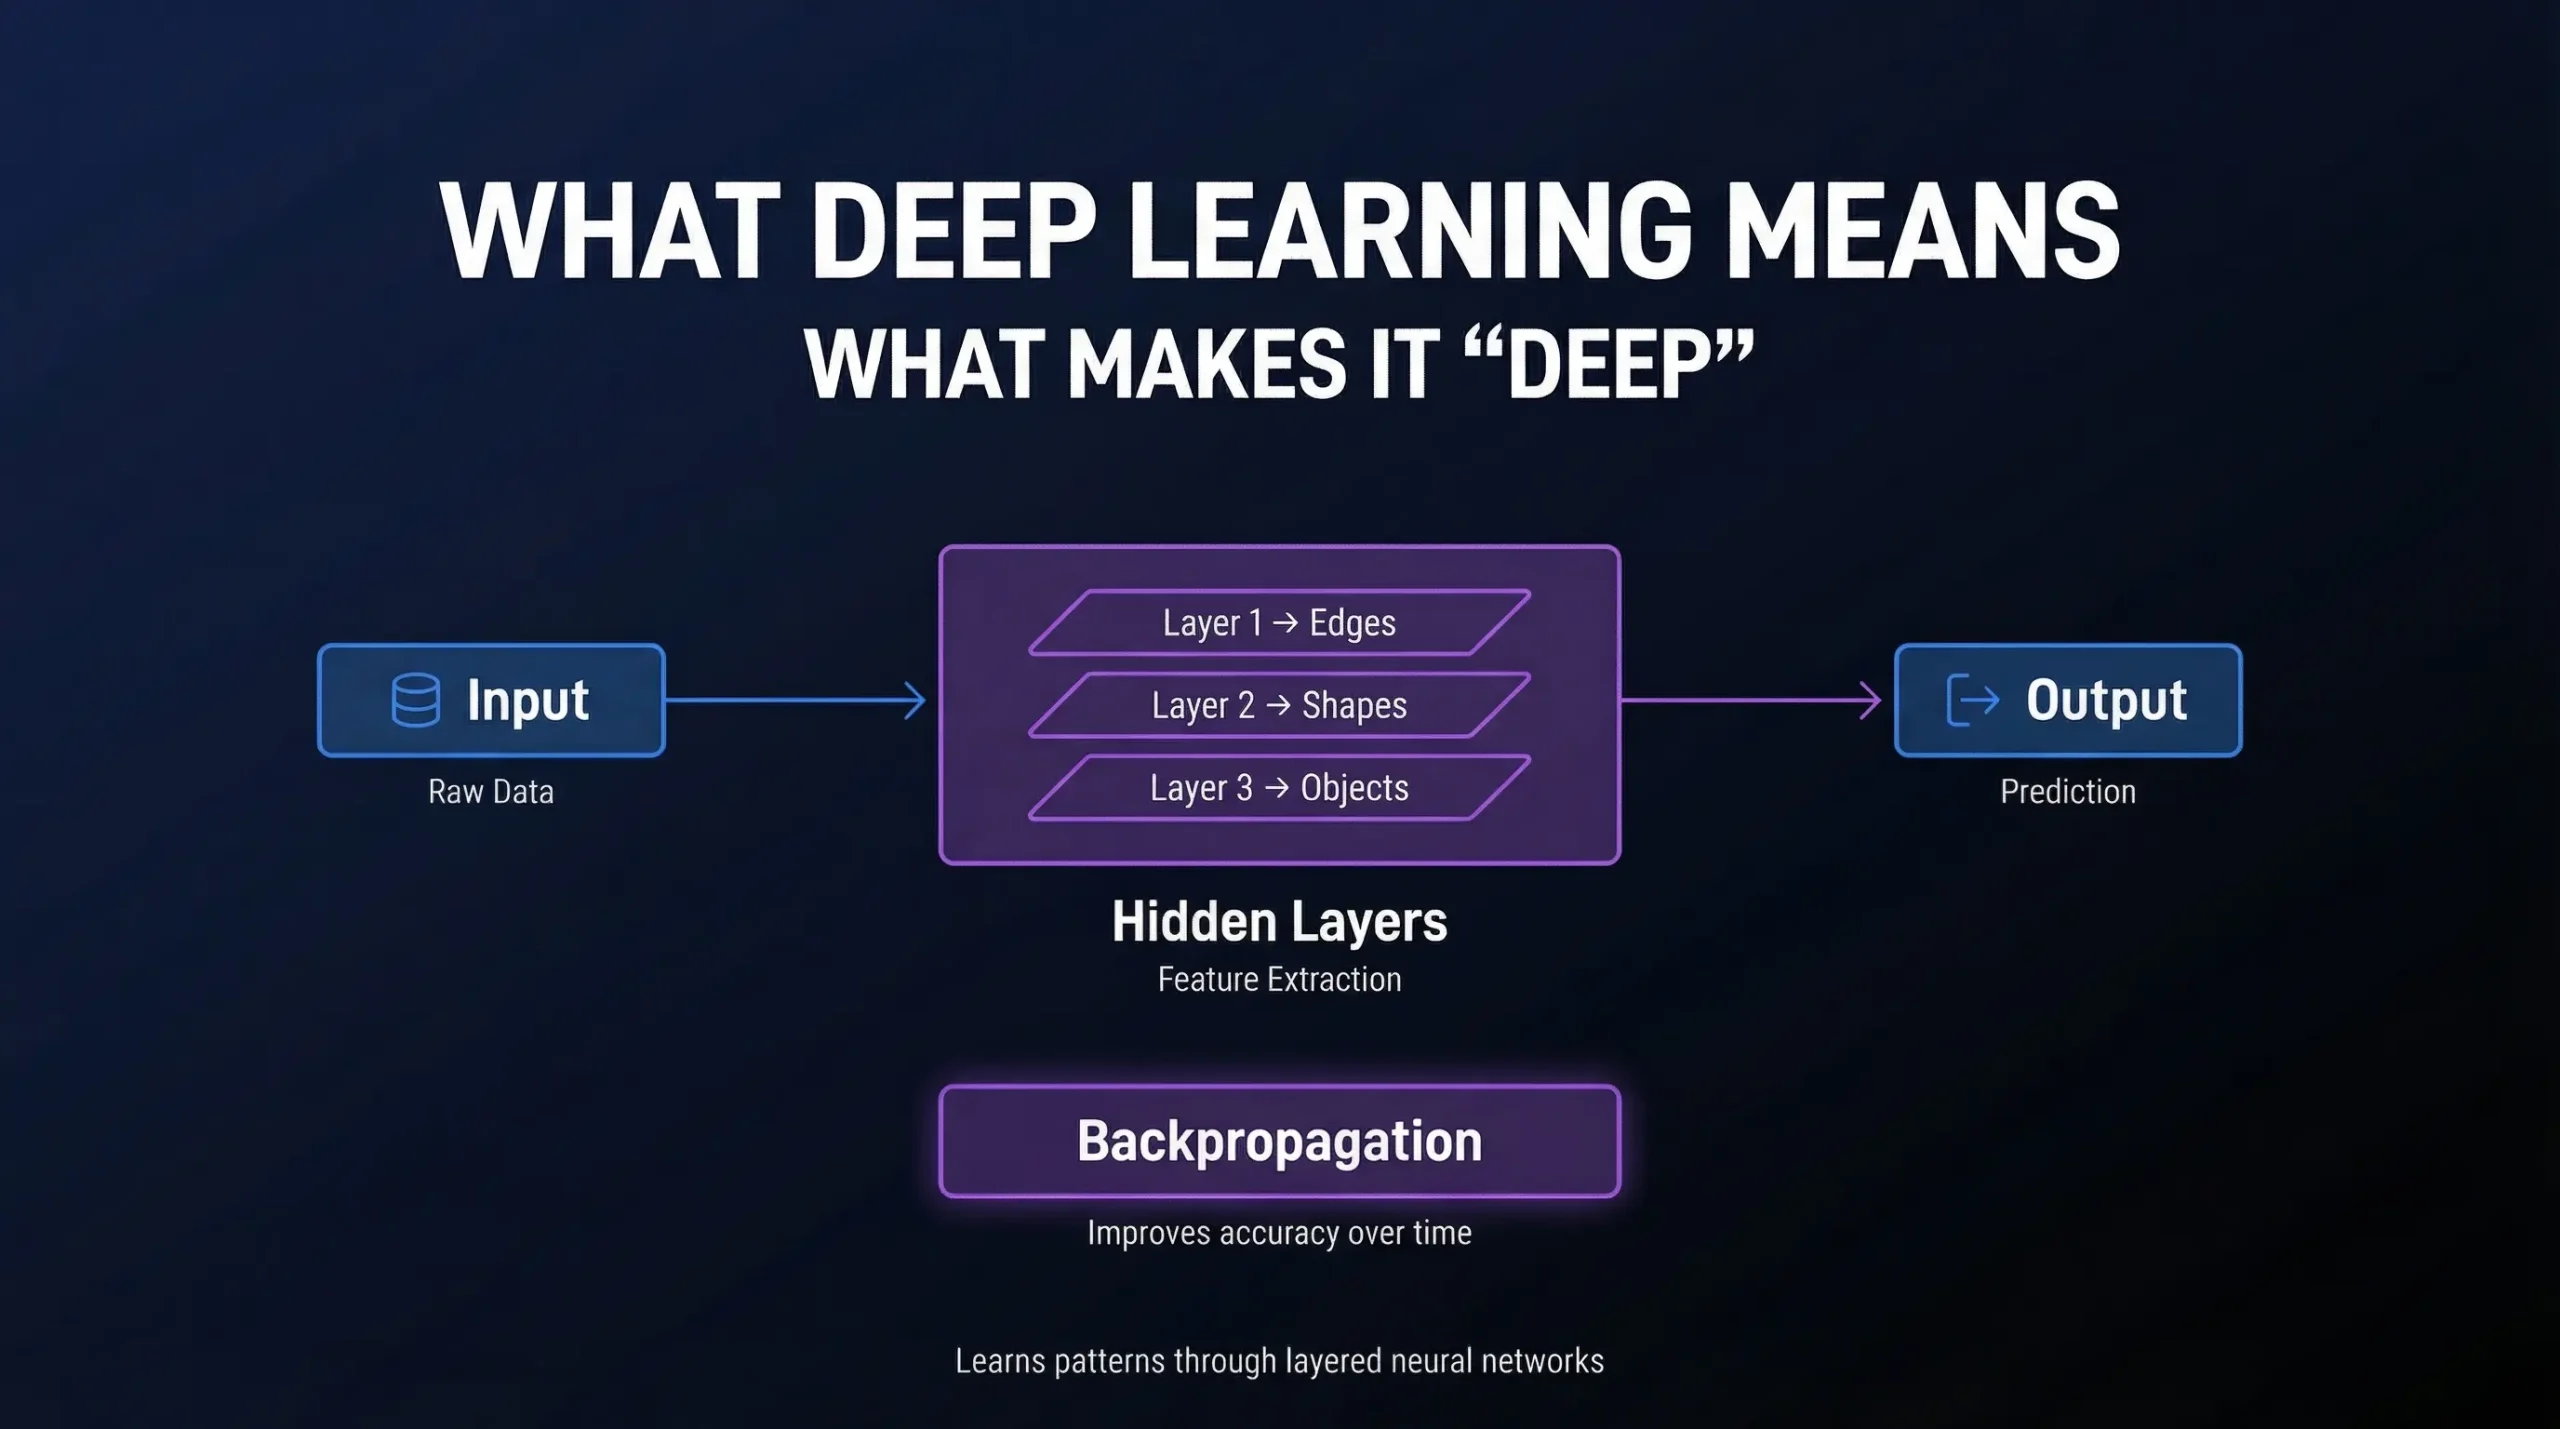
딥러닝을 "딥러닝"으로 만드는 것은 무엇입니까? 데이터가 통과해야 하는 처리 계층의 수를 나타냅니다.
- 입력 레이어: 원시 데이터(이미지의 픽셀, 음성의 오디오 웨이브)가 시스템에 들어갑니다.
- 숨겨진 레이어: 이것은 "깊은" 섹션입니다. 데이터는 인공 뉴런의 밀도가 높은 여러 층을 통과합니다. 각 레이어는 더 복잡한 기능을 추출합니다. 안면 인식 시스템의 경우 레이어 1은 가장자리와 그림자를 찾고, 레이어 2는 모양(눈, 코)을 찾고, 레이어 3은 특정 얼굴을 식별합니다.
- 출력 계층: 시스템은 최종 예측 또는 생성된 콘텐츠를 제공합니다.
실수를 수정하기 위해 딥 러닝은 복잡한 수학 절차에 의존합니다. 역전파, 모든 추측 후에 연결의 내부 "가중치"(중요도)를 조정하여 시간이 지남에 따라 모델이 더 스마트해집니다.
제너레이티브 AI와 LLM은 어디에 적합합니까?
ChatGPT, Claude 또는 MidJourney와 같은 생성 AI 도구는 이 기술의 최신 진화입니다.
- 생성적 AI 일반적으로 딥 러닝 모델을 기반으로 합니다.
- 대규모 언어 모델(LLMS) 인간 텍스트의 테라바이트에 대해 훈련된 특정 유형의 딥 러닝 모델입니다. 그들은 믿을 수 없을 정도로 깊은 신경 계층을 통해 언어를 처리하기 때문에 시퀀스에서 가장 논리적인 "다음 단어"를 예측할 수 있어 인간처럼 들리는 에세이, 코드 및 대화 응답을 작성할 수 있습니다.
"올바른 단어 사용" 결정 가이드
용어 혼합을 중지합니다. 이 간단한 프레임워크를 사용하여 전문적인 환경에서 어떤 단어를 사용할지 정확히 알 수 있습니다.
| 기능 | 인공지능(AI) | 머신러닝(ML) | 딥러닝(DL) |
| 간단한 정의 | 인간의 지능을 모방하는 모든 시스템. | 작업을 개선하기 위해 데이터에서 학습하는 시스템입니다. | 복잡한 데이터를 위한 다층 신경망 시스템. |
| 작동 방식 | 하드 코딩된 규칙을 사용할 수 있습니다 또는 데이터에서 배우십시오. | 패턴을 찾기 위해 통계 알고리즘을 사용합니다. | 인공 뉴런과 역전파의 방대한 배열을 사용합니다. |
| 데이터 요구 사항 | 다름(규칙 기반 AI에는 과거 데이터가 필요하지 않음)이 필요합니다. | 적당한 양의 구조화된 데이터가 필요합니다. | 엄청난 양의 원시 비정형 데이터가 필요합니다. |
| 컴퓨팅 파워 | 낮음에서 보통. | 적당히. | 매우 높음(강력한 GPU 칩이 필요함). |
| 에 가장 잘 사용됩니다 | 일반적인 문제 해결, 간단한 자동화. | 가격 예측, 추천 엔진, 스팸 필터. | 이미지 인식, 음성 번역, 대형 언어 모델. |
AI 용어의 황금률
- 규칙 1: 시스템이 똑똑하지만 전적으로 인간이 쓴 규칙에 의존한다면, 아이.
- 규칙 2: 시스템이 재프로그래밍하지 않고 예측을 개선하기 위해 과거 데이터를 적극적으로 살펴본다면 머신 러닝.
- 규칙 3: 시스템이 신경망을 사용하여 사람의 음성, 고해상도 이미지 또는 창의적인 글쓰기와 같은 방대하고 복잡한 데이터 세트를 처리하는 경우 딥 러닝.
자주 묻는 질문(FAQ)
AI는 간단한 단어로 무엇입니까?
인공 지능(AI)은 일반적으로 인간 지능이 필요한 작업을 수행할 수 있는 컴퓨터 시스템을 만드는 광범위한 과학입니다. 여기에는 언어 이해, 패턴 인식, 문제 해결 및 결정이 포함됩니다.
머신 러닝은 AI와 동일합니까?
아니요, 그들은 정확히 동일하지 않습니다. 머신 러닝은 전문화된 하위 분야입니다 이내에 인공지능. 모든 기계 학습은 AI의 한 형태이지만 모든 AI가 머신러닝을 사용하는 것은 아닙니다.
모든 AI 시스템이 머신러닝을 사용합니까?
아니요. 초기의 고도로 신뢰할 수 있는 많은 AI 시스템은 "규칙 기반"입니다. 즉, 데이터에서 독립적으로 학습하기보다 엄격하고 사람이 작성한 "If-then" 코드에 의존합니다.
딥 러닝은 머신 러닝의 일부입니까?
네. 딥 러닝은 머신 러닝의 고급 하위 카테고리입니다. 특히 인공 신경망의 여러 계층을 사용하여 정보를 처리하는 기계 학습 알고리즘을 말합니다.
딥 러닝과 신경망의 차이점은 무엇입니까?
신경망은 기본 아키텍처(노드가 함께 연결됨)이며, 딥 러닝은 특히 입력과 출력 사이에 많은 "숨겨진 계층"이 있는 신경망을 나타냅니다. 모든 딥 러닝은 신경망을 사용하지만 단순하고 단일 계층 신경망은 "깊은" 것으로 간주되지 않습니다.
AI, ML 및 DL에서 ChatGPT는 어디에 적합합니까?
CHATGPT는 제너레이티브 AI의 우산 아래에 있는 대규모 LLM(Large Language Model)입니다. 기술적으로는 기계 학습의 한 유형인 딥 러닝(특히 트랜스포머라고 하는 신경망 아키텍처)을 사용하여 구축되었으며, 이는 궁극적으로 인공 지능에 속합니다.
