


什么是服务器正常运行时间和停机时间:完整指南
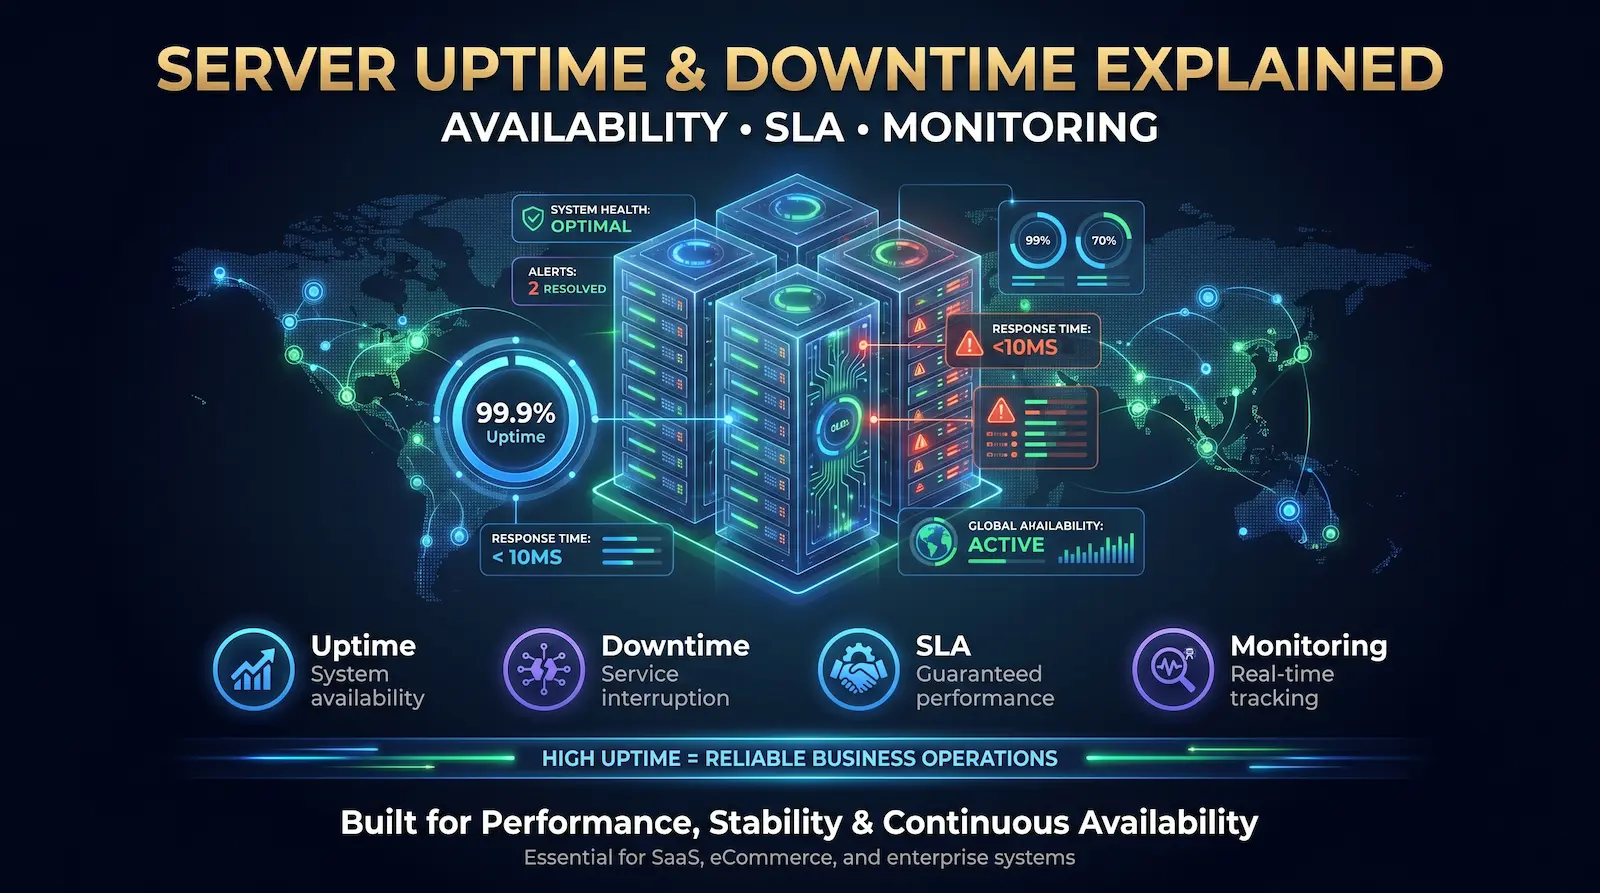
服务器正常运行时间是系统成功交付其预期服务的总时间。 当用户完全无法访问基础架构时,会发生服务器停机时间。 这种持续可用性直接影响企业收入、SEO 可见性和品牌信任。 轻微的中断会引发严重的潜在收入损失。
定义服务器正常运行时间
服务器正常运行时间测量机器成功运行并完成其主要功能的持续时间。 IT 团队将此指标作为定义时间窗口内的百分比跟踪。 该设备正常运行时间定义严格衡量硬件和网络可靠性,形成您的数字基础。
服务器保持在线的每一分钟都为用户和无缝的业务运营创建不间断的服务。 IT 领导者应注意,原始服务器正常运行时间仅衡量物理硬件状态。 它证实了 裸机服务器 或 VPS 具有电源和网络连接,但它不能保证应用程序实际上为客户正确路由流量。
定义服务器停机时间
服务器停机时间表示系统完全无响应或无法访问的对立状态。 这种停机时间意味着基础设施无法履行其主要功能。 这会导致立即中断服务,并且通常会导致 HTTP 500 范围错误,例如 503 服务不可用 状态。
停机时间代表了连续性的艰难突破。 无论您面临整个系统故障还是微妙的、间歇性的数据包丢失,结果都保持不变:用户无法访问该环境。 系统停机时间源于物理硬件故障、代码部署错误、目标 DDoS 网络攻击或紧张的市政电网。 除了直接的技术中断之外,企业停机时间直接转化为停滞的工人生产力、搜索引擎排名下降和持久的品牌损害。
正常运行时间与可用性:西瓜效应
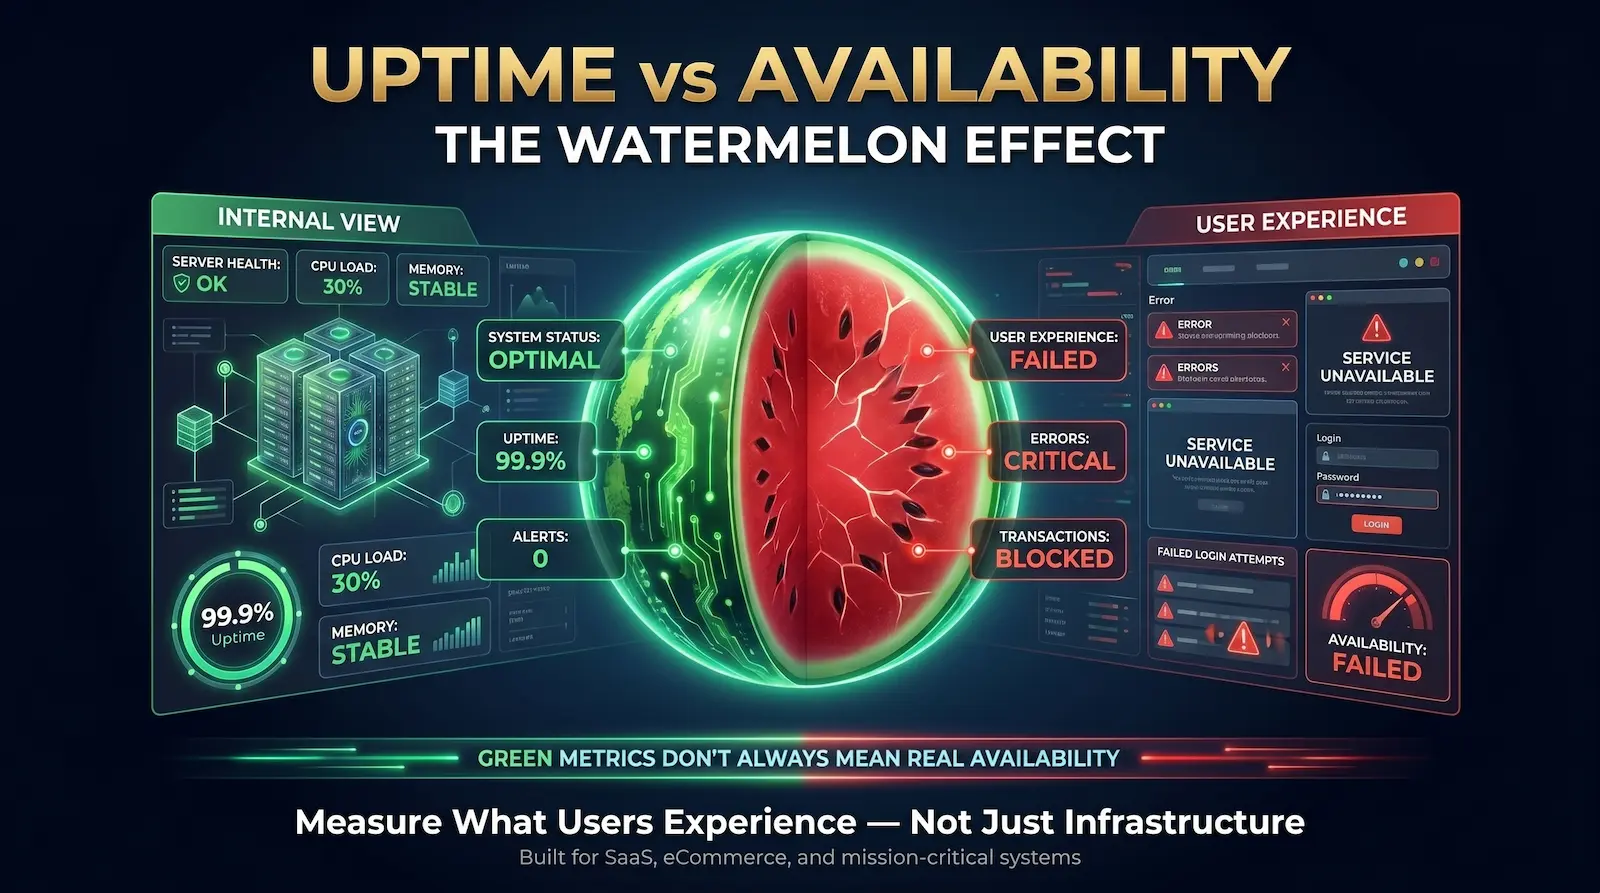
服务器正常运行时间严格衡量单个机器或基础设施组件的物理可靠性。 服务可用性 表示最终用户可访问系统的实际时间比例。 当托管应用程序完全无法用于客户交易时,服务器可能会显示完美的正常运行时间。
IT 团队经常在事件响应期间混淆这两个指标。 工程师查看内部监控仪表板,看到令人满意的绿灯。 硬件运行正常,网络服务正常运行。 由于依赖关系层失败,外部用户仍然会遇到负面问题。
行业专家称之为西瓜效应。 服务水平指标在外面看起来是绿色的,但实际的客户体验是红色的,内部并不令人满意。
追踪 正常运行时间与可用性 迫使工程团队专注于最终用户。 您必须使用连续的数字体验监控来衡量整个客户旅程,而不是检查单个硬件组件。 客户不在乎数据中心是否保持在线状态。 他们只关心他们是否可以购买您的产品。 围绕真实可用性构建内部服务级别目标可保护您的收入并建立长期客户信任。
服务器停机时间对财务和 SEO 的影响
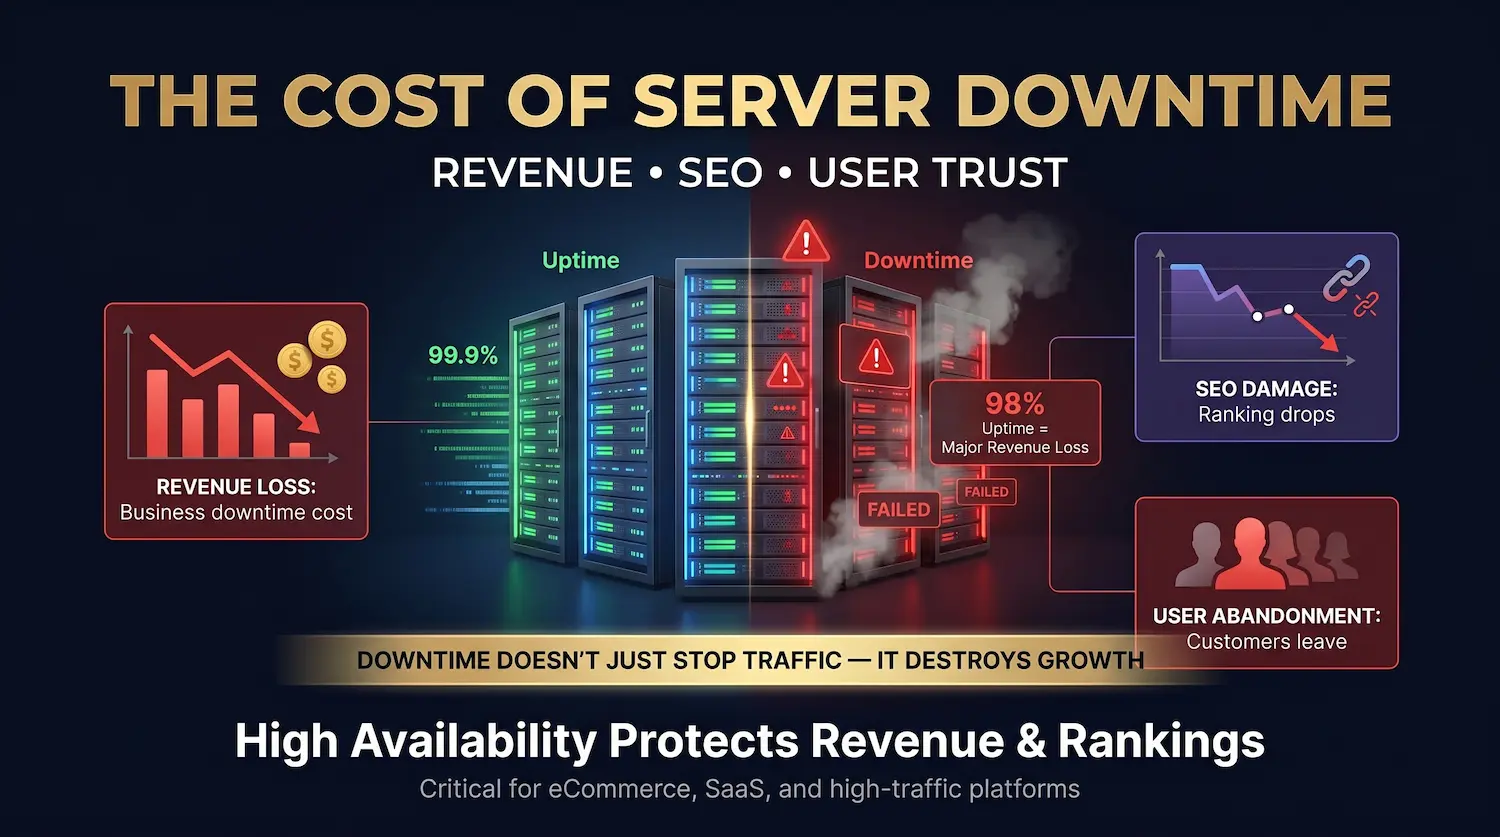
服务器停机时间直接导致严重的财务损失和搜索引擎排名下降。 每年产生 1000 万美元的企业损失了大约 $192,066,以 98% 的正常运行时间基准运行。 延长的中断还迫使搜索引擎限制其爬网率,永久性地损害您的数字可见性。
中断的财务成本远远超出了即时离线时间。 数据显示,9% 的访问者在经历了一个被击落的网站后,永久放弃了一个品牌,转而支持竞争对手。 如果在交通高峰时段发生中断,这种放弃率将转化为数千名失去的客户。
您的搜索引擎优化也会受到直接打击。 谷歌希望为其用户提供高质量的链接。 如果搜索引擎机器人在您的服务器上遇到 500 级错误,则会注册不良用户体验。 谷歌稍后将尝试重新抓取页面。 如果网站仍然没有响应,Google 将对您的网页进行删除索引,您将失去您的搜索排名。
如何将停机时间的SEO影响降至最低
您可以使用 503 服务不可用的 HTTP 状态代码在计划维护期间保护您的搜索引擎排名。 此特定代码告诉搜索引擎机器人停机是暂时的。 Google 将暂停抓取并稍后返回,而不会对您现有的搜索排名进行处罚。
切勿在维护期间提供标准 200 OK 错误页面或未找到 404 屏幕。 您必须设置一个包含 Retry-After 标头的自定义 503 页面。 此标题为搜索引擎提供了特定的时间回来。 您还应该保持 robots.txt 文件处于活动状态,以便 Crawlers 可以准确地读取 503 状态。
一些网站管理员尝试在 Google Search Console 中限制抓取率以修复服务器负载问题。 您应该完全避免此设置。 仅当 Googlebot 流量使您的服务器物理崩溃时,您才应该使用抓取限制工具。 如果标准的机器人流量使您的系统不堪重负,您需要升级您的托管基础设施,而不是阻止搜索引擎。
现代数据中心停机的常见原因
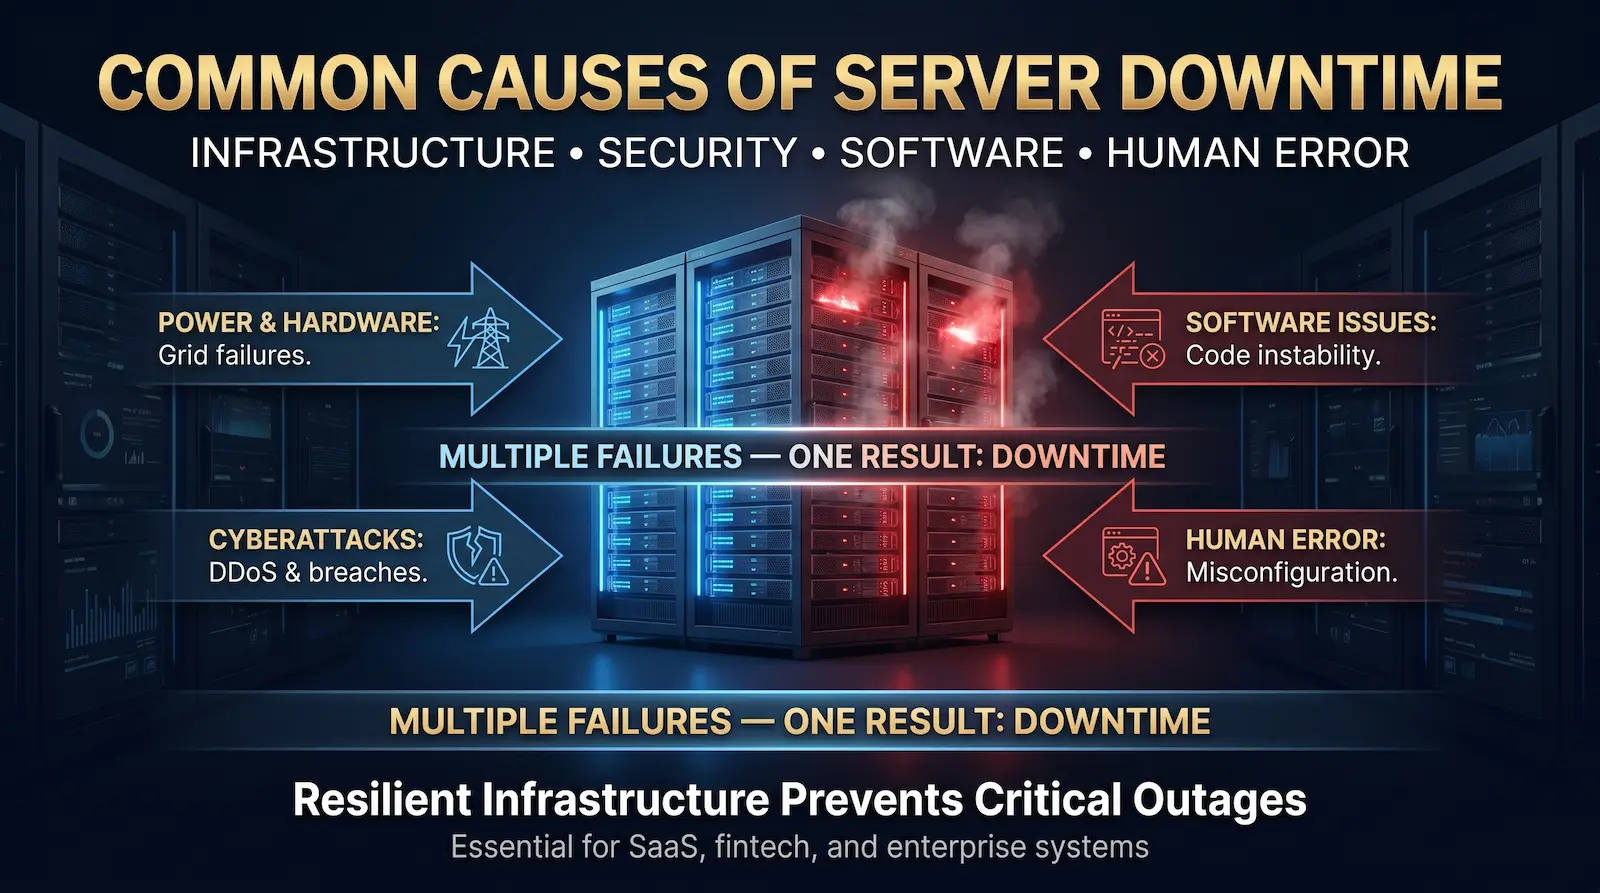
现代系统故障源于严重的市政电网压力、物理硬件故障和复杂的网络攻击。 未维护的软件插件和管理监督也会立即造成服务中断。 IT 领导者必须部署冗余架构,以抵御这些物理和数字威胁并保持持续可用性。
硬件故障和电网应变
物理硬件组件出现故障,但宏观经济功率限制是更大的威胁。 高密度人工智能计算严重耗尽了全球市政电网。 数据中心面临着巨大的冷却瓶颈。 除非设施利用独立的微电网和高级故障转移系统,否则服务器在本地电网故障期间会变暗。
安全漏洞和流量过载
有针对性的安全漏洞迫使高度稳定的系统脱机。 攻击者部署分布式拒绝服务策略以压倒网络容量和耗尽服务器资源。 高级网络威胁还针对 DNS 路由和操作 SSL 证书,在安全团队清理受损基础设施的同时,迫使服务中断。
软件问题和代码不稳定
内部软件问题经常崩溃健康的硬件环境。 将未经测试的代码推送到生产环境会立即导致系统不稳定。 过时的插件问题代表了内容管理系统的巨大结构漏洞。 一个编码不良的扩展很容易耗尽服务器内存并触发完整的应用程序崩溃。
行政监督和人为错误
基本的管理错误很容易破坏整个数字依赖链。 人为错误导致大量可预防的网络故障。 工作人员跳过既定程序或错误配置防火墙会破坏系统可用性。 一个简单的失效域名注册会完全从全球注册表中删除您的网址。
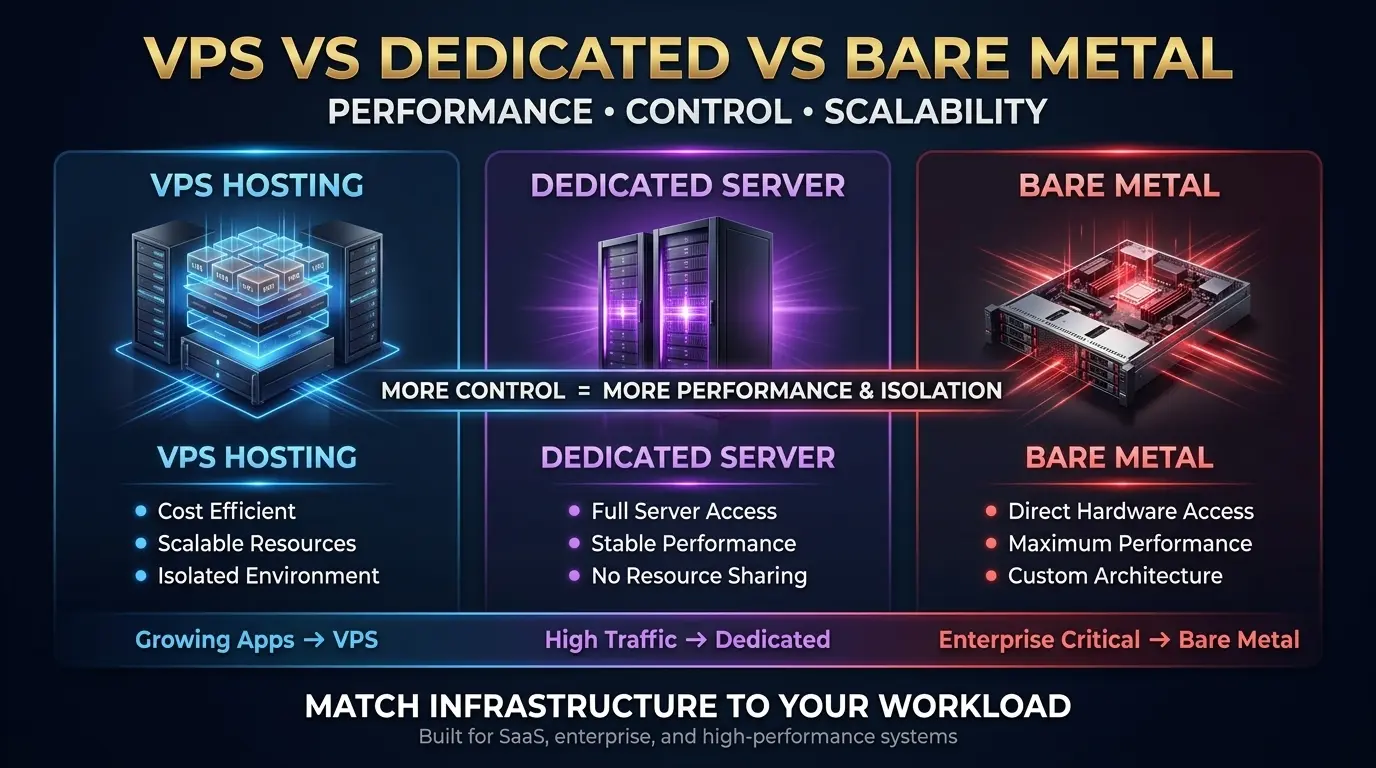
选择正确的基础设施:VPS、专用和裸机
选择正确的托管环境可直接决定您的系统稳定性。 高流量企业系统需要裸机专用服务器提供的绝对资源隔离,以防止资源耗尽噪声的邻居场景,并确保在网络峰值负载期间的最佳性能。
廉价托管仍然是系统故障的主要原因。 您必须将您的硬件类型与所需的可用性标准保持一致。 高级提供商喜欢 Atal Networks 专为最大限度的正常运行时间和网络安全而设计的工程师环境。
如果您运行快速增长的应用程序, 最好的VPS 在共享的物理环境中提供专用资源。 虚拟服务器托管利用虚拟化将您的数据与其他用户隔离。 这在成本和性能之间创造了一个稳定的中间地带。
在严格的服务级别协议下运营的企业组织需要物理硬件隔离。 那个 最佳独立服务器 授予您的工程团队直接访问物理硬件而无需虚拟机管理程序层。 这消除了其他租户消耗您的计算能力的风险。 当您完全控制硬件时,您可以设计共享环境根本无法支持的自定义故障转移协议。
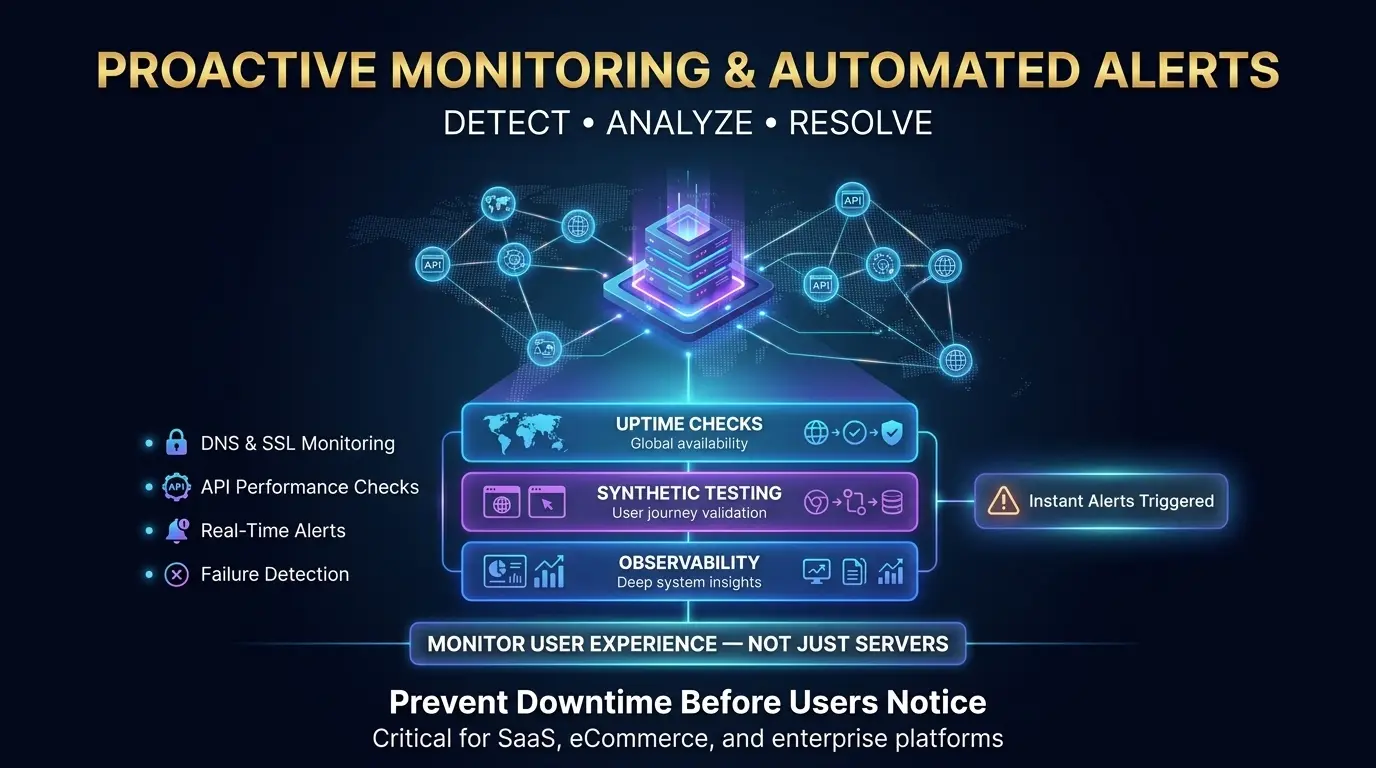
主动监控和自动警报
现代主动监控需要持续的数字体验监控。 该策略不是简单地 ping 硬件,而是利用全球合成检查点来验证 DNS 记录、SSL 握手和 API 功能。 这允许团队在用户注意到问题之前触发自动警报并解决故障。
Ping 服务器 IP 地址以检查电源的时代已经结束。 企业必须部署跟踪实际客户旅程的监控架构。 如果您的支付网关 API 失败,您的服务器在技术上仍然处于启动状态,但您的业务在财务上处于低迷状态。
有效的基础设施监控在三个不同的层面上运行:
- 简单的正常运行时间检查: 验证站点从多个全局位置快速加载。
- 合成交易测试: 通过关键用户流运行自动化机器人,例如将项目添加到购物车或完成登录,以确保应用程序真正正常工作。
- 完整的企业可观察性: 集成服务器日志、CPU 遥测和应用程序性能指标,以在问题触发中断之前诊断问题的根本原因。
常见问题(FAQ)
服务器正常运行时间到底是什么意思?
服务器正常运行时间表示数字服务成功运行并保持用户可访问的持续时间。 IT 团队在设定的时间窗口中以百分比跟踪此指标。 保持高可用性可确保您的应用程序处理流畅。 这种稳定性直接保护您的每月收入。
停机时间和停机时间有区别吗?
停机时间和停机时间这两个术语在计算中意味着完全相同的事情。 这两个短语都描述了一个网络对用户完全不可用的状态。 企业基础设施团队使用单字停机时间作为标准行业术语,记录系统故障并跟踪数字故障。
我如何知道我的网站是向上还是向下?
通过部署自动化的数字体验监控工具,您可以准确地跟踪站点功能。 这些合成跟踪平台对您的 Web 应用程序运行持续的全局检查。 如果您的服务器停止响应或您的安全证书失败,监控系统会直接向您的工程团队发送自动警报。
是否有良好的服务器正常运行时间百分比的标准?
现代企业应用程序的标准服务器正常运行时间百分比为 99.99%。 行业专业人士称之为四级可靠性。 该特定指标每年仅允许 52 分钟的总离线时间。 关键任务系统的目标是五个九节,以将年度故障减少到仅五分钟。
参考和变更日志
最后更新: 2026 年 4 月 16 日
官方参考:
- 运行时间研究所: 年度中断分析报告
- 亚马逊网络服务 (AWS): 计算服务级别协议
- 谷歌搜索中心: 处理 HTTP 网络错误和 503 状态代码
- 万维网联盟(W3C): Web 内容可访问性指南 (WCAG) 2.2