


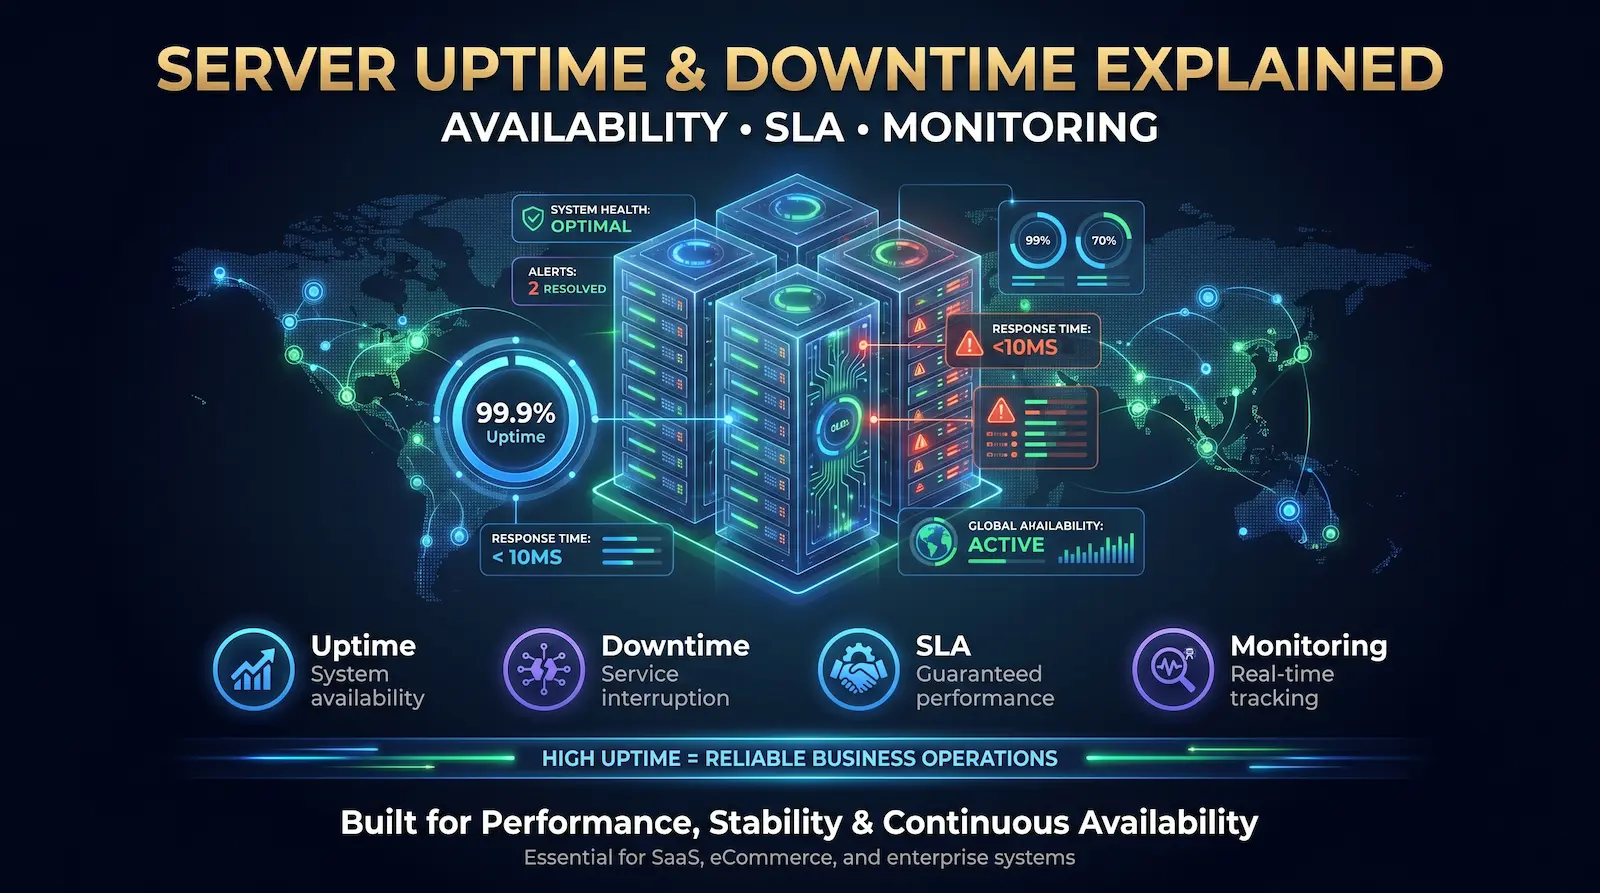
Was ist Server-Ausfallzeit und -ausfallzeit: Eine vollständige Anleitung
Die Serververfügbarkeit ist die Gesamtzeit, die ein System erfolgreich bereitstellt. Server-Ausfallzeiten treten auf, wenn die Infrastruktur für Benutzer vollständig unzugänglich wird. Diese kontinuierliche Verfügbarkeit wirkt sich direkt auf den Umsatz, die SEO-Sichtbarkeit und das Markenvertrauen aus. Kleinere Ausfälle führen zu schweren potenziellen Einnahmeverlusten.
Definieren der Serverbetriebszeit
Server Uptime misst die Dauer, die eine Maschine erfolgreich betreibt und ihre primären Funktionen erfüllt. IT-Teams verfolgen diese Metrik als Prozentsatz über ein definiertes Zeitfenster. Diese Geräteverfügbarkeitsdefinition misst streng die Hardware- und Netzwerkzuverlässigkeit, die Ihre digitale Grundlage bildet.
Jede Minute, die ein Server online bleibt, schafft ein ununterbrochener Dienst für Benutzer und nahtlose Geschäftsabläufe. IT-Leader sollten beachten, dass die RAW-Server-Uptime nur den physischen Hardware-Status misst. es bestätigt die Bare-Metal-Server oder VPS Verfügt über Strom- und Netzwerkkonnektivität, garantiert jedoch nicht, dass die Anwendung den Datenverkehr für den Kunden tatsächlich korrekt weiterleitet.
Definieren von Server-Ausfallzeiten
Die Server-Ausfallzeit stellt den entgegengesetzten Zustand dar, in dem ein System vollständig nicht reagiert oder nicht erreichbar ist. Diese Ausfallzeit bedeutet, dass die Infrastruktur ihre Hauptfunktionen nicht erfüllen kann. Dies führt zu sofortigen Unterbrechungen des Dienstes und führt häufig zu HTTP-500-Range-Fehlern, z. 503 Service nicht verfügbar Status
Ausfallzeiten sind eine harte Unterbrechung der Kontinuität. Das Ergebnis bleibt das gleiche, ob Sie mit einem vollständigen Systemausfall oder einem subtilen, intermittierenden Paketverlust konfrontiert sind: Die Umgebung ist für Benutzer nicht zugänglich. Systemausfälle entstehen durch physische Hardwarefehler, Code-Bereitstellungsfehler, gezielte DDoS-Cyberangriffe oder angespannte kommunale Stromnetze. Über die unmittelbaren technischen Unterbrechungen hinaus führt die Ausfallzeit von Unternehmen direkt zu einer blockierten Produktivität, zu sinkenden Suchmaschinen-Rankings und dauerhaftem Markenschaden.
Verfügbarkeit vs. Verfügbarkeit: Der Wassermeloneneffekt
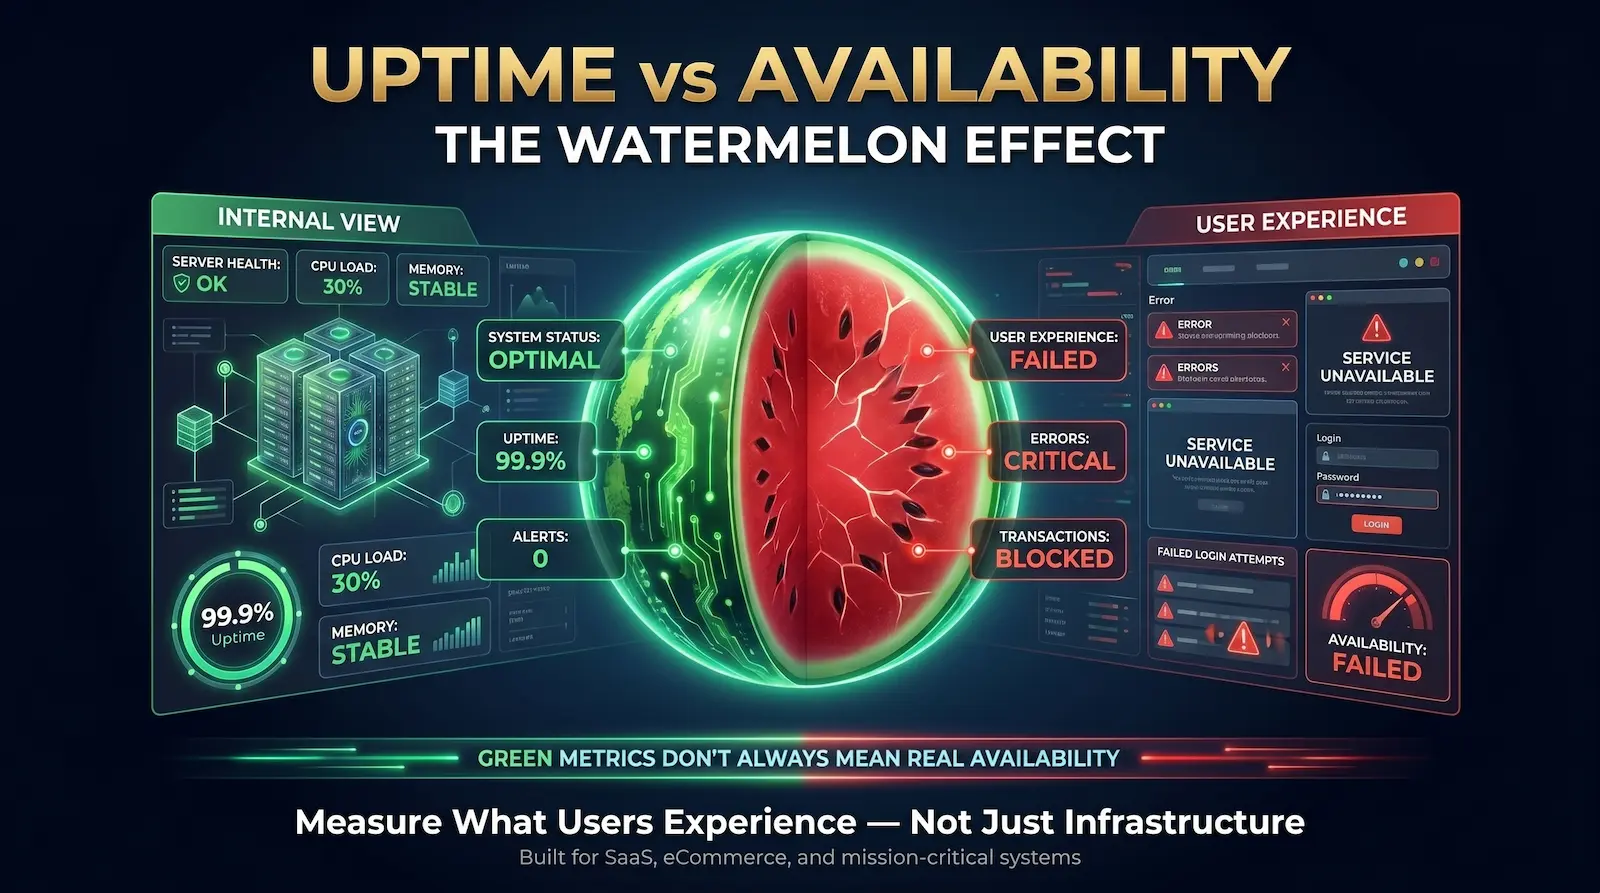
Die Server-Uptime misst streng die physikalische Zuverlässigkeit einer einzelnen Maschine oder Infrastrukturkomponente. Die Serviceverfügbarkeit stellt den tatsächlichen Anteil der Zeit dar, die dem Endbenutzer zugänglich bleibt. Ein Server zeigt möglicherweise die perfekte Betriebszeit an, während die gehostete Anwendung für Kundentransaktionen vollständig nicht verfügbar ist.
IT-Teams verwechseln diese beiden Metriken häufig während der Reaktion auf Vorfälle. Die Ingenieure betrachten interne Überwachungs-Dashboards und sehen zufriedenstellende grüne Lichter. Die Hardware läuft einwandfrei und der Netzwerkdienst funktioniert einwandfrei. Benutzer auf der Außenseite haben immer noch negative Probleme, da eine Abhängigkeitsschicht fehlgeschlagen ist.
Branchenexperten nennen dies den Wassermeloneneffekt. Die Service-Level-Metriken sehen außen grün aus, aber das tatsächliche Kundenerlebnis ist rot und innen unbefriedigend.
Verfolgung Betriebszeit vs. Verfügbarkeit Zwingt Ingenieurteams, sich auf den Endbenutzer zu konzentrieren. Sie müssen die gesamte Customer Journey mit kontinuierlicher digitaler Erfahrungsüberwachung messen, anstatt einzelne Hardwarekomponenten zu überprüfen. Kunden ist es egal, ob ein Rechenzentrum online bleibt. Sie kümmern sich nur darum, ob sie Ihre Produkte kaufen können. Der Aufbau Ihrer internen Service-Level-Ziele auf echte Verfügbarkeit schützt Ihren Umsatz und schafft langfristiges Kundenvertrauen.
Die finanziellen und SEO-Auswirkungen von Server-Ausfallzeiten
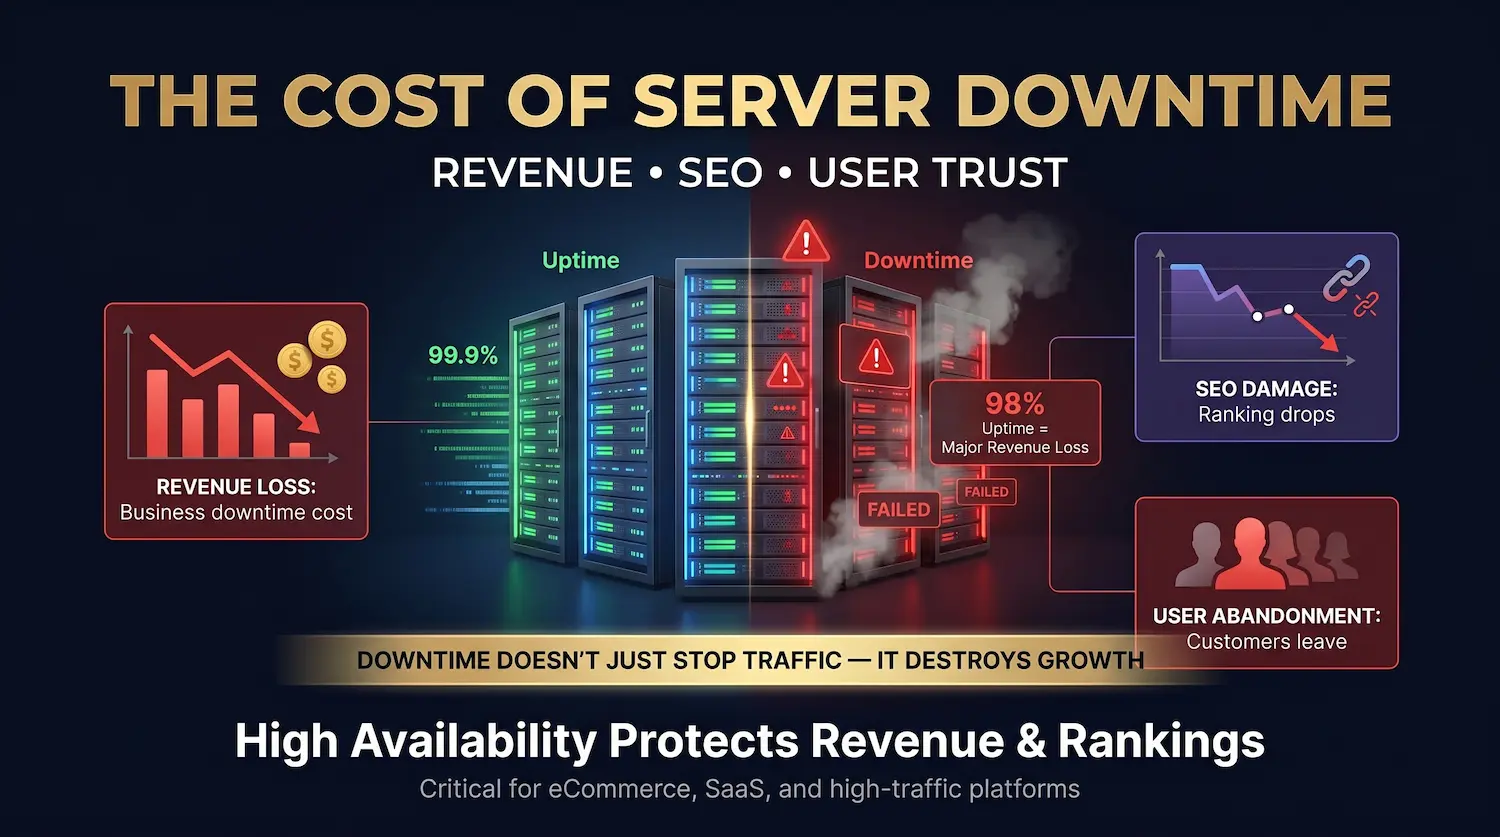
Server-Ausfallzeiten verursachen direkt schwerwiegende finanzielle Verluste und Einsturz von Suchmaschinen-Rankings. Ein Unternehmen, das jährlich zehn Millionen Dollar generiert, verliert ungefähr 1 Tp4T192.066, das bei einer Uptime-Basislinie von 98 Prozent arbeitet. Erweiterte Ausfälle zwingen Suchmaschinen auch dazu, ihre Kriechrate zu begrenzen, wodurch Ihre digitale Sichtbarkeit dauerhaft geschädigt wird.
Die finanziellen Kosten eines Ausfalls gehen weit über die unmittelbaren Offline-Minuten hinaus. Daten zeigen, dass neun Prozent der Besucher eine Marke dauerhaft verlassen, nachdem sie eine heruntergekommene Website zugunsten eines Wettbewerbers erlebt haben. Wenn während der Hauptverkehrszeiten ein Ausfall auftritt, führt diese Abbruchrate zu Tausenden von verlorenen Kunden.
Auch Ihre Suchmaschinenoptimierung trifft direkt auf. Google möchte qualitativ hochwertige Links zu seinen Nutzern bereitstellen. Wenn Suchmaschinen-Bots auf Ihrem Server auf 500-Level-Fehler stoßen, registrieren sie eine schlechte Benutzererfahrung. Google wird versuchen, die Seiten später erneut zu crawlen. Wenn die Website nicht mehr reagiert, wird Google Ihre Seiten deindexieren und Sie verlieren Ihre Suchrankings.
So minimieren Sie die SEO-Auswirkungen von Ausfallzeiten
Sie können Ihre Suchmaschinen-Rankings während der geplanten Wartung mit einem nicht verfügbaren HTTP-Statuscode 503 schützen. Dieser spezielle Code teilt den Suchmaschinen-Bots mit, dass die Ausfallzeiten vorübergehend sind. Google pausiert das Crawlen und kehrt später zurück, ohne Ihre vorhandenen Suchrankings zu bestrafen.
Bereiten Sie während der Wartung niemals eine Standard-200-OK-Fehlerseite oder einen Bildschirm 404 nicht gefunden auf. Sie müssen eine benutzerdefinierte 503-Seite einrichten, die einen Wiederholungs-After-Header enthält. Dieser Header gibt der Suchmaschine eine bestimmte Zeit, um wiederzukommen. Sie sollten auch Ihre robots.txt-Datei aktiv halten, damit Crawler den 503-Status genau lesen können.
Einige Webmaster versuchen, die Crawling-Rate in der Google Search Console zu begrenzen, um Probleme beim Laden von Servern zu beheben. Diese Einstellung sollten Sie ganz vermeiden. Sie sollten das Crawl-Limit-Tool nur verwenden, wenn der Googlebot-Traffic Ihren Server physisch abstürzt. Wenn der Standard-Bot-Verkehr Ihr System überfordert, müssen Sie Ihre Hosting-Infrastruktur aktualisieren, anstatt die Suchmaschine zu blockieren.
Häufige Ausfallursachen in modernen Rechenzentren
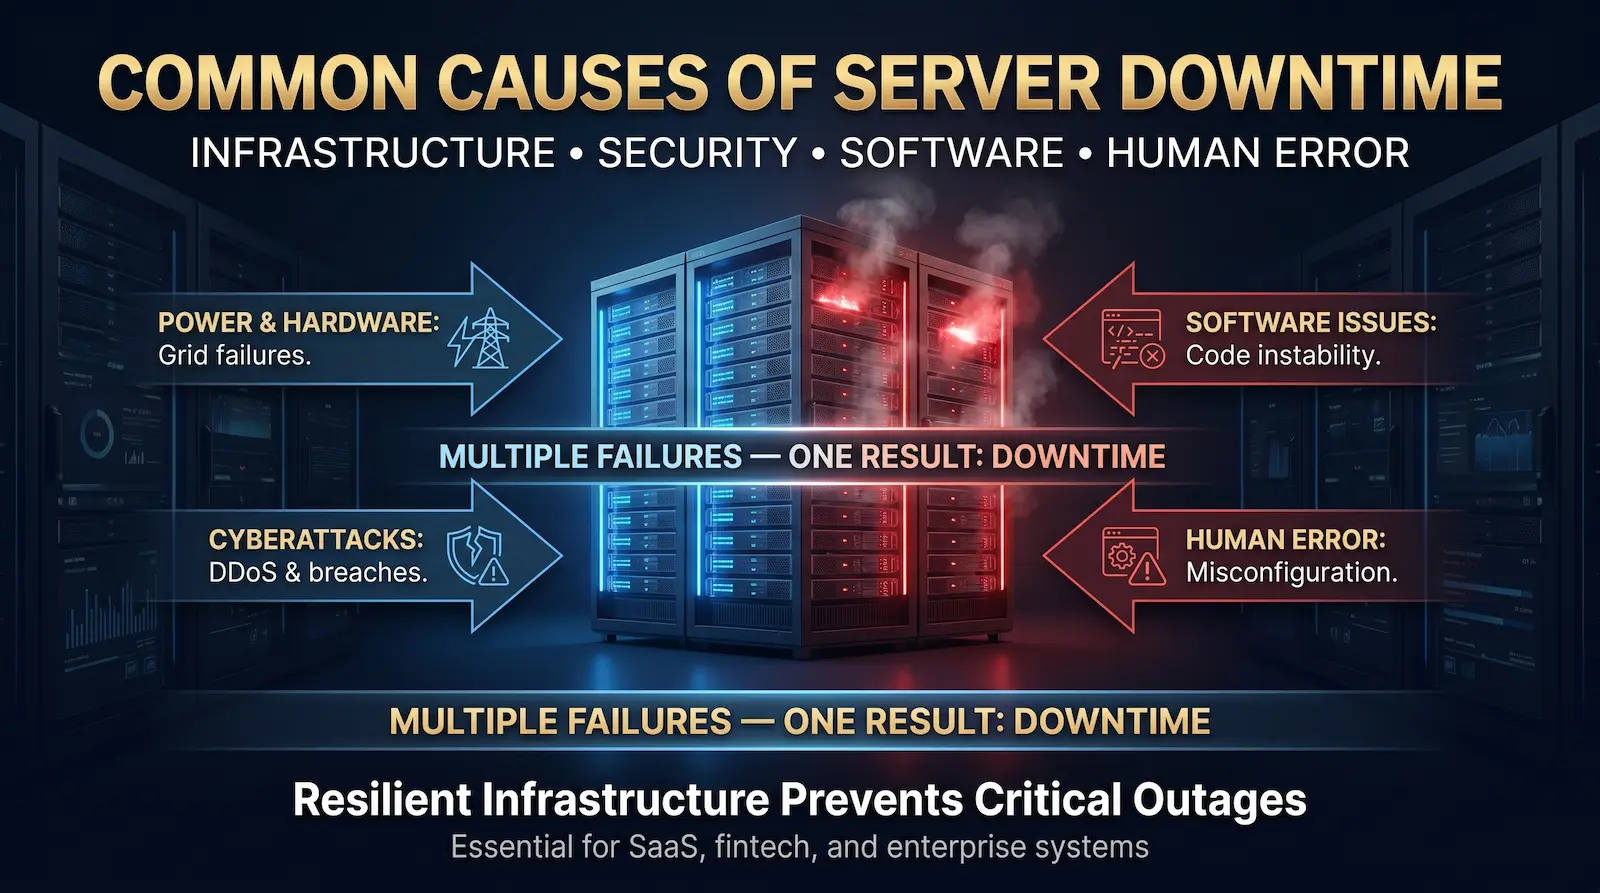
Moderne Systemausfälle sind auf schwere kommunale Stromnetze, physische Hardware-Pannen und ausgefeilte Cyberangriffe zurückzuführen. Nicht gepflegte Software-Plugins und administrative Überwachungen führen auch zu sofortigen Dienstunterbrechungen. IT-Führungskräfte müssen redundante Architektur einsetzen, um diese physischen und digitalen Bedrohungen zu überleben und die kontinuierliche Verfügbarkeit aufrechtzuerhalten.
Hardwarefehler und Netzspannung
Physische Hardwarekomponenten scheitern, aber die makroökonomischen Leistungsbeschränkungen stellen eine größere Bedrohung dar. Hochdichte künstliche Intelligenz-Computing entleert die kommunalen Stromnetze weltweit stark. Rechenzentren sind mit massiven Kühl-Engpässen konfrontiert. Server werden bei lokalen Netzfehlern dunkel, es sei denn, die Einrichtungen verwenden unabhängige Mikronetze und erweiterte Failover-Systeme.
Sicherheitsverletzungen und Verkehrsüberlastungen
Gezielte Sicherheitsverletzungen zwingen hochstabile Systeme offline. Angreifer setzen verteilte Denial-of-Service-Taktiken ein, um die Netzwerkkapazität zu überfordern und Serverressourcen zu erschöpfen. Advanced Cyber-Bedrohungen zielen auch auf DNS-Routing und Manipulation von SSL-Zertifikaten ab, wodurch längere Serviceausfälle erzwungen werden, während Sicherheitsteams die gefährdete Infrastruktur abräumen.
Softwareprobleme und Codeinstabilität
Internal software issues frequently crash healthy hardware environments. Das Drücken von nicht getestetem Code in eine Produktionsumgebung führt zu einer sofortigen Systeminstabilität. Veraltete Plugin-Probleme stellen eine massive strukturelle Schwachstelle für Content-Management-Systeme dar. Eine einzige schlecht codierte Erweiterung erschöpft den Serverspeicher leicht und löst einen vollständigen Anwendungsabsturz aus.
Verwaltungsaufsicht und menschliches Versagen
Grundlegende administrative Fehler brechen leicht die gesamte digitale Abhängigkeitskette. Menschliches Versagen verursacht einen massiven Prozentsatz stark vermeidbarer Netzwerkausfälle. Mitarbeiter überspringen etablierte Verfahren oder falsche Konfiguration von Firewalls zerstören die Systemverfügbarkeit. Eine einfache verfallene Domainregistrierung entfernt Ihre Webadresse vollständig aus der globalen Registrierung.
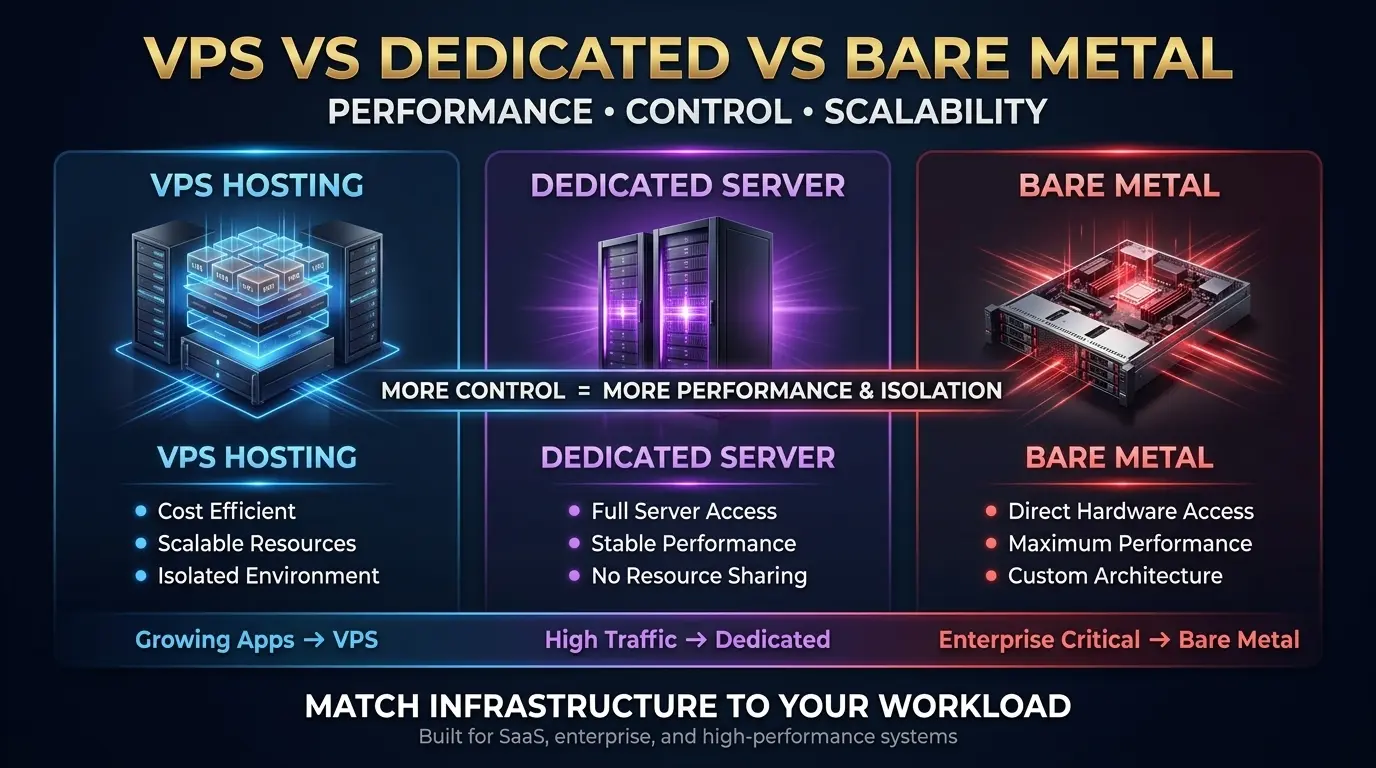
Auswahl der richtigen Infrastruktur: VPS, Dedicated und Bare Metal
Die Auswahl der richtigen Hosting-Umgebung bestimmt direkt Ihre Systemstabilität. Unternehmen mit hohem Datenverkehr erfordern die absolute Ressourcenisolation, die von einem dedizierten Bare-Metal-Server bereitgestellt wird, um Ressourcen zu verhindern, die lauter Nachbarszenarien ablaufen, und maximale Leistung bei Spitzennetzlasten sicherzustellen.
Günstiges Hosting bleibt eine der Hauptursachen für Systemfehler. Sie müssen Ihren Hardwaretyp an der erforderlichen Verfügbarkeitsnorm abstimmen. Premium-Anbieter wie Atal Networks Engineering-Umgebungen, die speziell für maximale Verfügbarkeit und Netzwerksicherheit entwickelt wurden.
Wenn Sie eine schnell wachsende Anwendung ausführen, Beste VPS Bietet dedizierte Ressourcen in einer gemeinsamen physischen Umgebung. Das Hosting von Virtual Server nutzt die Virtualisierung, um Ihre Daten von anderen Benutzern zu isolieren. Dies schafft einen stabilen Mittelweg zwischen Kosten und Leistung.
Unternehmensorganisationen, die unter strengen Service-Level-Vereinbarungen arbeiten, erfordern die Isolation der physischen Hardware. Die besten dedizierten Server Gewährt Ihrem Engineering-Team direkten Zugriff auf die physische Hardware ohne Hypervisor-Ebene. Dies beseitigt das Risiko, dass andere Mieter Ihre Rechenleistung verbrauchen. Wenn Sie die Hardware vollständig steuern, können Sie benutzerdefinierte Failover-Protokolle erstellen, die freigegebene Umgebungen einfach nicht unterstützen können.
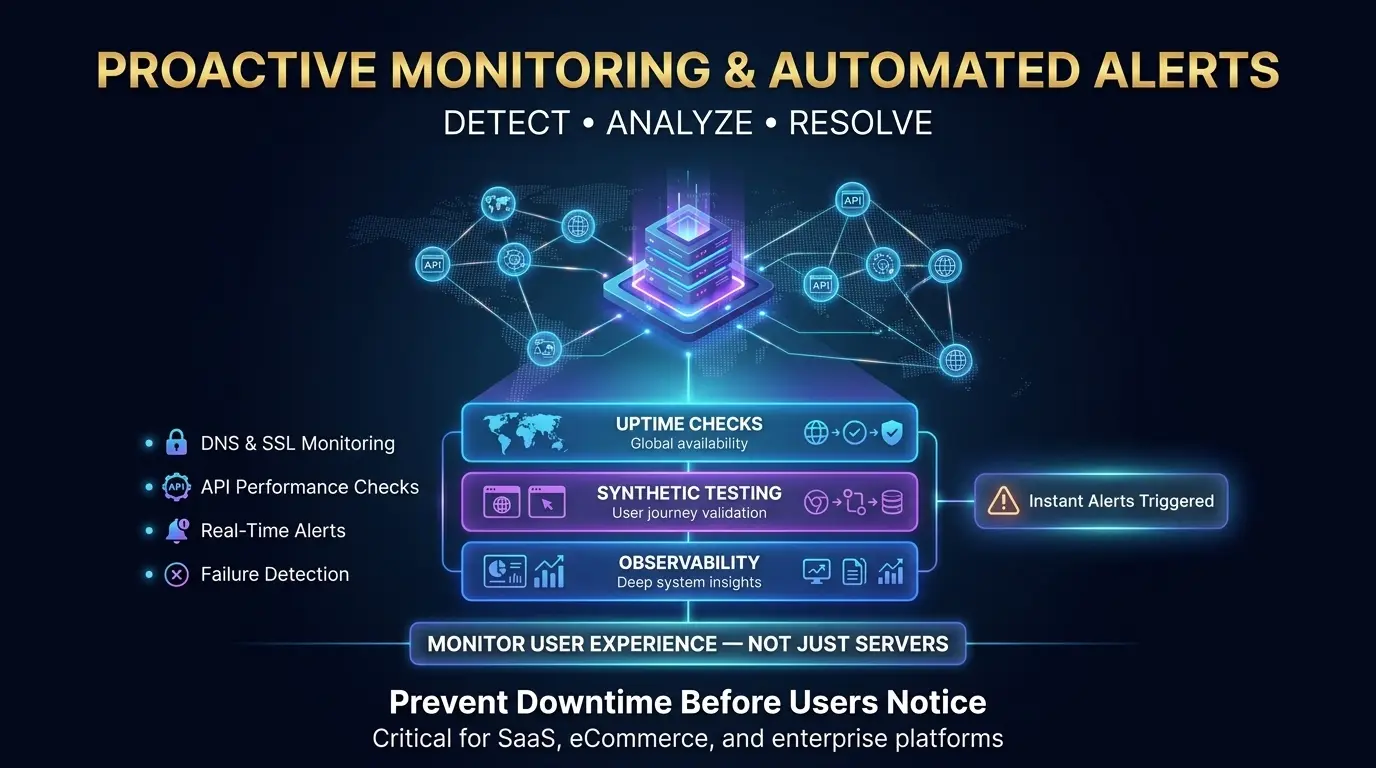
Proaktive Überwachung und automatisierte Warnungen
Moderne proaktive Überwachung erfordert eine kontinuierliche Überwachung der digitalen Erfahrung. Anstatt einfach Hardware zu pingen, verwendet diese Strategie globale synthetische Prüfpunkte, um DNS-Einträge, SSL-Handshakes und API-Funktionalitäten zu überprüfen. Auf diese Weise können Teams automatisierte Warnungen auslösen und Fehler beheben, bevor Benutzer Probleme bemerken.
Die Ära des Pingen einer Server-IP-Adresse, um auf Strom zu überprüfen, ist vorbei. Unternehmen müssen Überwachungsarchitekturen bereitstellen, die die tatsächliche Kundenreise verfolgen. Wenn Ihre Payment Gateway-API fehlschlägt, bleibt Ihr Server technisch hoch, aber Ihr Unternehmen bleibt finanziell ab.
Eine effektive Infrastrukturüberwachung erfolgt auf drei verschiedenen Ebenen:
- Einfache Verfügbarkeitsprüfungen: Das Überprüfen der Site wird von mehreren globalen Standorten schnell geladen.
- Synthetische Transaktionstests: Ausführen automatisierter Bots durch kritische Benutzerabläufe, z. B. das Hinzufügen eines Artikels zu einem Warenkorb oder das Ausfüllen eines Logins, um sicherzustellen, dass die Anwendung tatsächlich funktioniert.
- Vollständige Unternehmensbeobachtbarkeit: Integration von Serverprotokollen, CPU-Telemetrie und Anwendungsleistungsmetriken zur Diagnose der Ursache eines Problems, bevor es einen Ausfall auslöst.
Häufig gestellte Fragen (FAQ)
Was genau bedeutet Server-Uptime?
Die Server-Uptime stellt die kontinuierliche Dauer dar, die ein digitaler Dienst erfolgreich ausgeführt und den Benutzern zugänglich bleibt. IT-Teams verfolgen diese Metrik als Prozentsatz über ein festgelegtes Zeitfenster. Die Aufrechterhaltung der Hochverfügbarkeit garantiert einen reibungslosen Traffic Ihrer Anwendung. Diese Stabilität schützt Ihren monatlichen Umsatz direkt.
Gibt es einen Unterschied zwischen Ausfallzeiten und Ausfallzeiten?
Die Begriffe Ausfallzeit und Ausfallzeit bedeuten genau das Gleiche beim Rechnen. Beide Phrasen beschreiben einen Zustand, in dem ein Netzwerk für Benutzer vollständig nicht verfügbar wird. Enterprise-Infrastrukturteams verwenden die Einzelwort-Ausfallzeit als Standard-Industriebegriff, um Systemausfälle zu protokollieren und digitale Ausfälle zu verfolgen.
Woher weiß ich, ob meine Website oben oder unten ist?
Sie verfolgen die Website-Funktionalität genau, indem Sie automatisierte Tools zur Überwachung von digitalen Erlebnissen bereitstellen. Diese synthetischen Tracking-Plattformen führen kontinuierliche globale Überprüfungen Ihrer Webanwendungen durch. Das Überwachungssystem sendet eine automatische Warnung direkt an Ihr Engineering-Team, wenn Ihr Server nicht mehr reagiert oder Ihre Sicherheitszertifikate ausfallen.
Gibt es Standards für einen guten Prozentsatz der Serverbetriebsdauer?
Ein Standard-Server-Uptime-Prozentsatz beginnt bei modernen Unternehmensanwendungen bei 99,99 Prozent. Branchenprofis nennen diese Stufe vier neun der Zuverlässigkeit. Diese spezifische Metrik erlaubt nur zweiundfünfzig Minuten Gesamt-Offline-Zeit pro Jahr. Missionskritische Systeme zielen auf fünf Neunen ab, um jährliche Fehler auf nur fünf Minuten zu reduzieren.
Referenzen und Changelog
Zuletzt aktualisiert: 16. April 2026
Offizielle Referenzen:
- Betriebszeitinstitut: Jährlicher Ausfallanalysebericht
- Amazon Web Services (AWS): Berechnen Sie Service Level Agreements
- Google Search Central: Umgang mit HTTP-Netzwerkfehlern und 503 Statuscodes
- World Wide Web-Konsortium (W3C): Richtlinien zur Barrierefreiheit von Webinhalten (WCAG) 2.2