 Ga naar de inhoud



Wat is server uptime en downtime: een complete gids
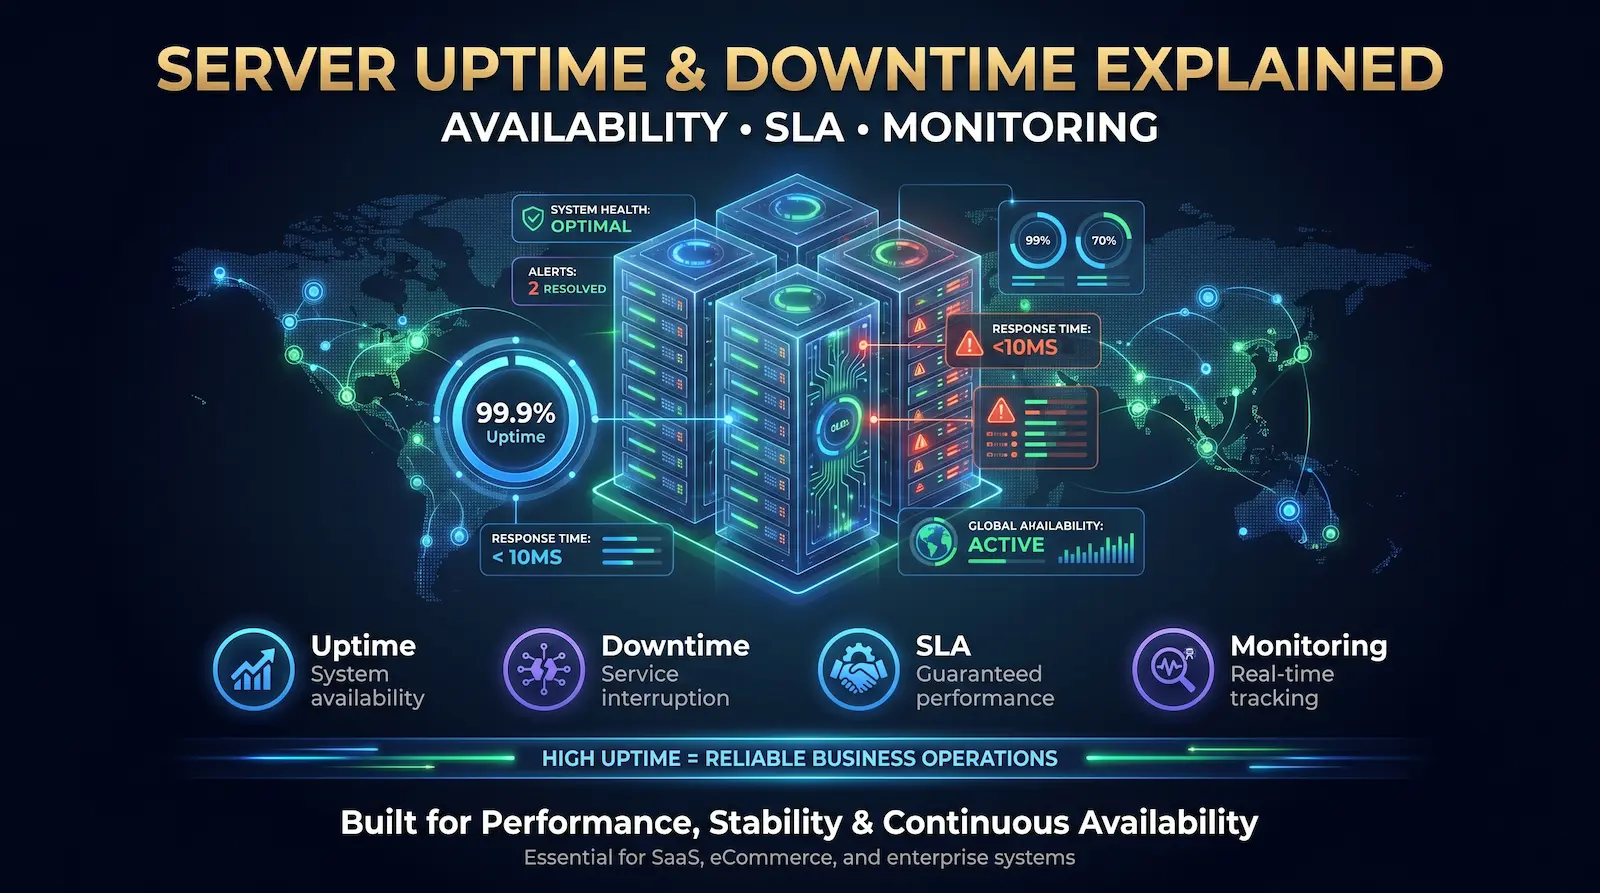
Server uptime is de totale tijd die een systeem met succes zijn beoogde services levert. Serverdowntime treedt op wanneer infrastructuur volledig ontoegankelijk wordt voor gebruikers. Deze continue beschikbaarheid heeft een directe invloed op de omzet van ondernemingen, de zichtbaarheid van SEO en merkvertrouwen. Kleine storingen veroorzaken ernstig potentieel inkomstenverlies.
Serveruptime definiëren
Server uptime meet de continue duur die een machine met succes bedient en vervult zijn primaire functies. Het teams volgen deze statistiek als een percentage over een gedefinieerd tijdvenster. Deze uptime-definitie van apparatuur meet strikt de hardware- en netwerkbetrouwbaarheid en vormt uw digitale basis.
Elke minuut dat een server online blijft, creëert een ononderbroken service voor gebruikers en naadloze bedrijfsvoering. IT-leiders moeten er rekening mee houden dat de uptime van de onbewerkte server alleen de fysieke hardwarestatus meet. Het bevestigt de bare metal server of VPS Heeft stroom- en netwerkconnectiviteit, maar het garandeert niet dat de applicatie het verkeer daadwerkelijk voor de klant correct routeert.
Serverdowntime definiëren
Serverdowntime vertegenwoordigt de tegengestelde staat waar een systeem volledig onreageerd of onbereikbaar wordt. Deze downtime betekent dat de infrastructuur zijn primaire functies niet kan vervullen. Dit veroorzaakt onmiddellijke onderbrekingen in de service en resulteert vaak in HTTP 500-bereikfouten, zoals een 503 Service niet beschikbaar Status.
Downtime staat voor een harde breuk in de continuïteit. Het resultaat blijft hetzelfde, of u nu te maken krijgt met een totale systeemstoring of subtiel, intermitterend pakketverlies: de omgeving is niet toegankelijk voor gebruikers. Systeemdowntime komt voort uit fysieke hardwarestoringen, code-implementatiefouten, gerichte DDoS-cyberaanvallen of gespannen gemeentelijke elektriciteitsnetten. Naast de onmiddellijke technische verstoring, vertaalt Enterprise Downtime zich direct in vastgelopen werknemersproductiviteit, gedaalde zoekmachineranglijsten en blijvende merkschade.
Uptime versus beschikbaarheid: het watermeloeneffect
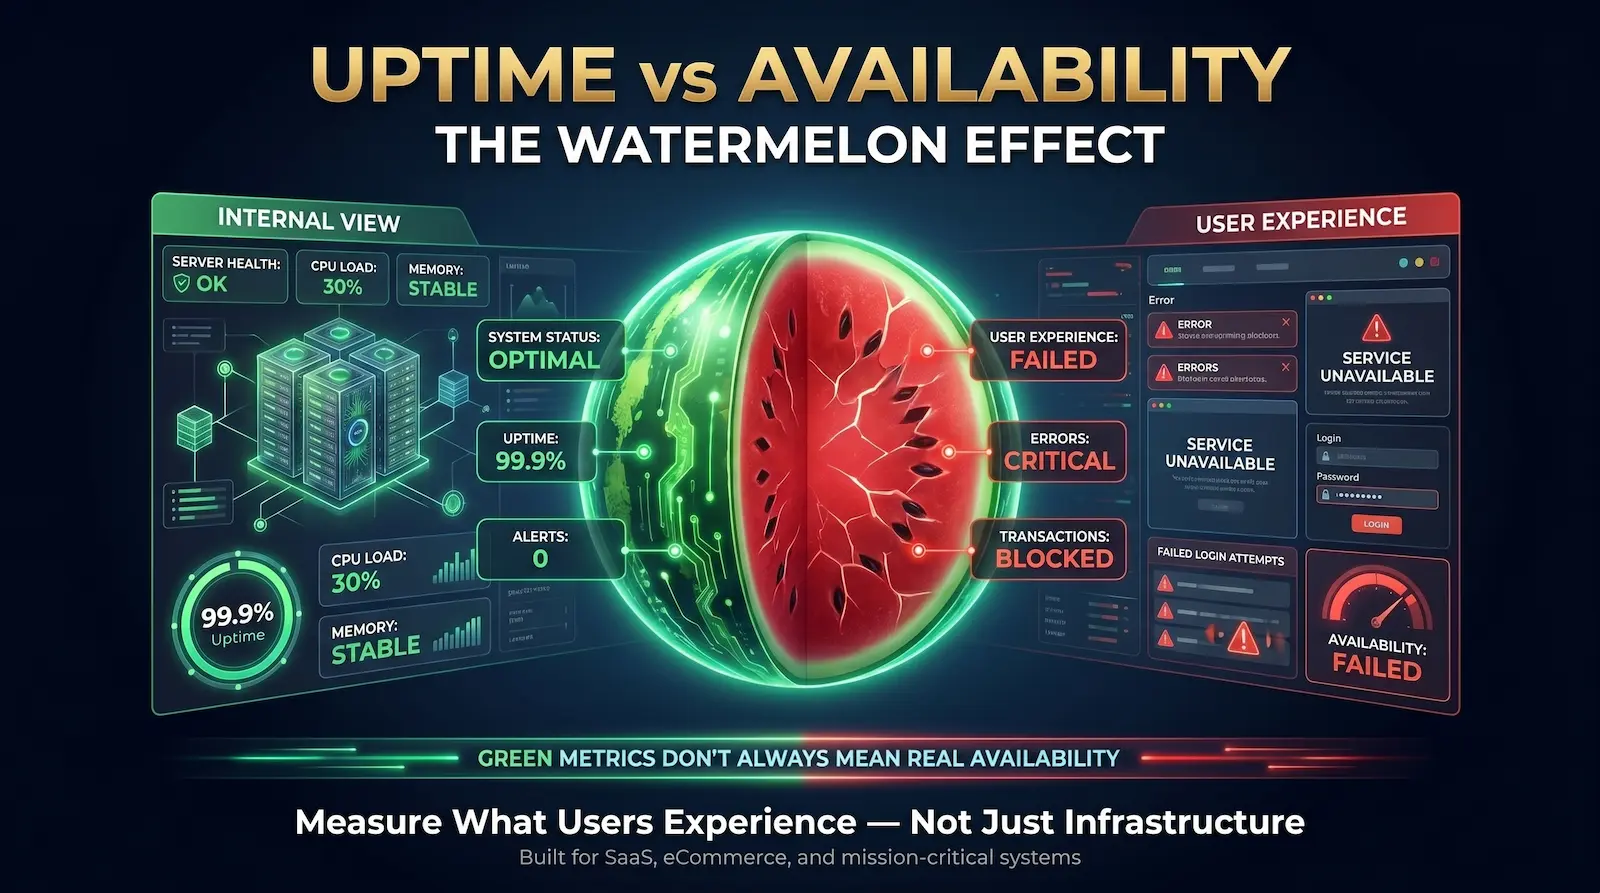
Server uptime meet strikt de fysieke betrouwbaarheid van een enkele machine of infrastructuurcomponent. Servicebeschikbaarheid vertegenwoordigt het werkelijke deel van de tijd dat een systeem toegankelijk blijft voor de eindgebruiker. Een server kan perfecte uptime tonen, terwijl de gehoste applicatie volledig niet beschikbaar blijft voor klanttransacties.
IT-teams verwarren deze twee statistieken vaak tijdens het reageren op incidenten. Ingenieurs kijken naar interne monitoringdashboards en zien bevredigende groene lichten. De hardware werkt prima en de netwerkservice functioneert correct. Gebruikers aan de buitenkant ondervinden nog steeds negatieve problemen omdat een afhankelijkheidslaag mislukte.
Experts uit de industrie noemen dit het watermeloeneffect. De statistieken van het serviceniveau zien er aan de buitenkant groen uit, maar de werkelijke klantervaring is rood en onbevredigend aan de binnenkant.
tracé Uptime versus beschikbaarheid dwingt technische teams om zich te concentreren op de eindgebruiker. U moet de hele klantreis meten met behulp van continue digitale ervaringsbewaking in plaats van afzonderlijke hardwarecomponenten te controleren. Het maakt klanten niet uit of een datacenter online blijft. Ze geven er alleen om als ze uw producten kunnen kopen. Het opbouwen van uw interne serviceniveaudoelstellingen rond echte beschikbaarheid beschermt uw inkomsten en bouwt op de lange termijn klantvertrouwen op.
De financiële en SEO-impact van serverdowntime
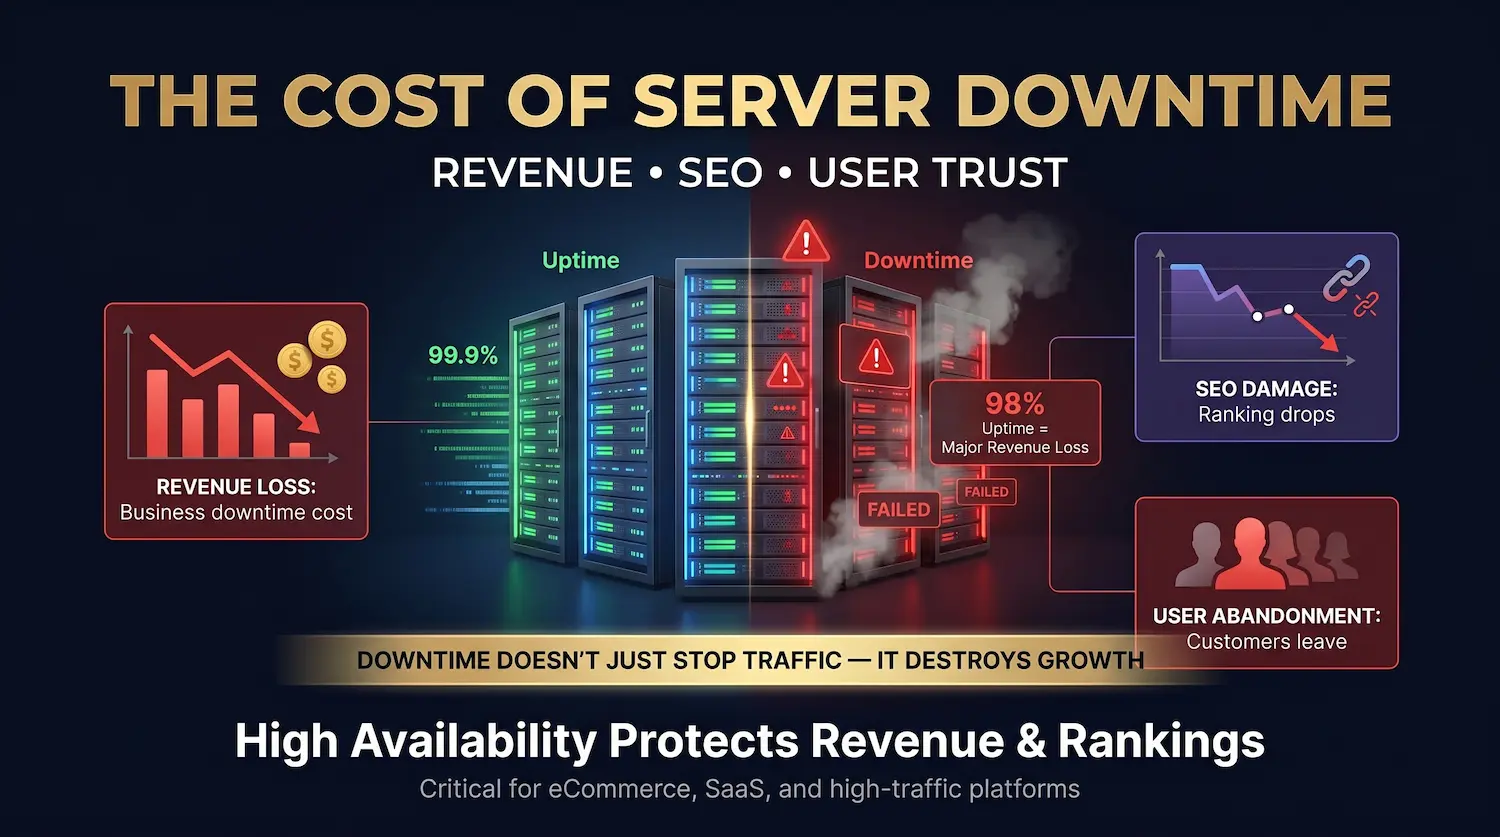
Serverdowntime veroorzaakt direct ernstige financiële verliezen en dalingen van de zoekmachinerangschikking. Een bedrijf dat jaarlijks tien miljoen dollar genereert, verliest ongeveer $192.066 op een uptime-basislijn van 98 procent. Uitgebreide storingen dwingen ook zoekmachines om hun crawlsnelheid te beperken, waardoor uw digitale zichtbaarheid permanent wordt beschadigd.
De financiële kosten van een storing reiken veel verder dan de onmiddellijke offline minuten. Uit gegevens blijkt dat negen procent van de bezoekers een merk permanent verlaten na het ervaren van een neergestorte site in het voordeel van een concurrent. Als er een storing optreedt tijdens piekuren, vertaalt dit verlatingspercentage zich in duizenden verloren klanten.
Uw zoekmachineoptimalisatie krijgt ook een directe hit. Google wil links van hoge kwaliteit aanbieden aan zijn gebruikers. Als zoekmachinebots fouten op 500 niveaus op uw server hebben bereikt, registreren ze een slechte gebruikerservaring. Google zal later proberen de pagina's opnieuw te crawlen. Als de site niet meer reageert, zal Google uw pagina's deindexeren en verliest u uw zoekrangschikking.
Hoe de SEO-impact van downtime te minimaliseren
U kunt de ranglijst van uw zoekmachine beschermen tijdens gepland onderhoud door een 503-service niet-beschikbare HTTP-statuscode te gebruiken. Deze specifieke code vertelt dat zoekmachinebots de downtime tijdelijk is. Google pauzeert het crawlen en keert later terug zonder uw bestaande zoekrangschikkingen te straffen.
Serveer nooit een standaard 200 OK-foutpagina of een 404 niet-scherm tijdens onderhoud. U moet een aangepaste 503-pagina instellen met een retry-na-header. Deze header geeft de zoekmachine een specifieke tijd om terug te komen. U moet ook uw robots.txt-bestand actief houden, zodat crawlers de 503-status nauwkeurig kunnen lezen.
Sommige webmasters proberen de crawlsnelheid te beperken in de Google Search Console om problemen met de laadruimte van de server op te lossen. U moet deze instelling volledig vermijden. Gebruik de tool voor het crawlen van limieten alleen als Googlebot-verkeer fysiek uw server crasht. Als standaard botverkeer uw systeem overweldigt, moet u uw hostinginfrastructuur upgraden in plaats van de zoekmachine te blokkeren.
Veelvoorkomende oorzaken van downtime in moderne datacenters
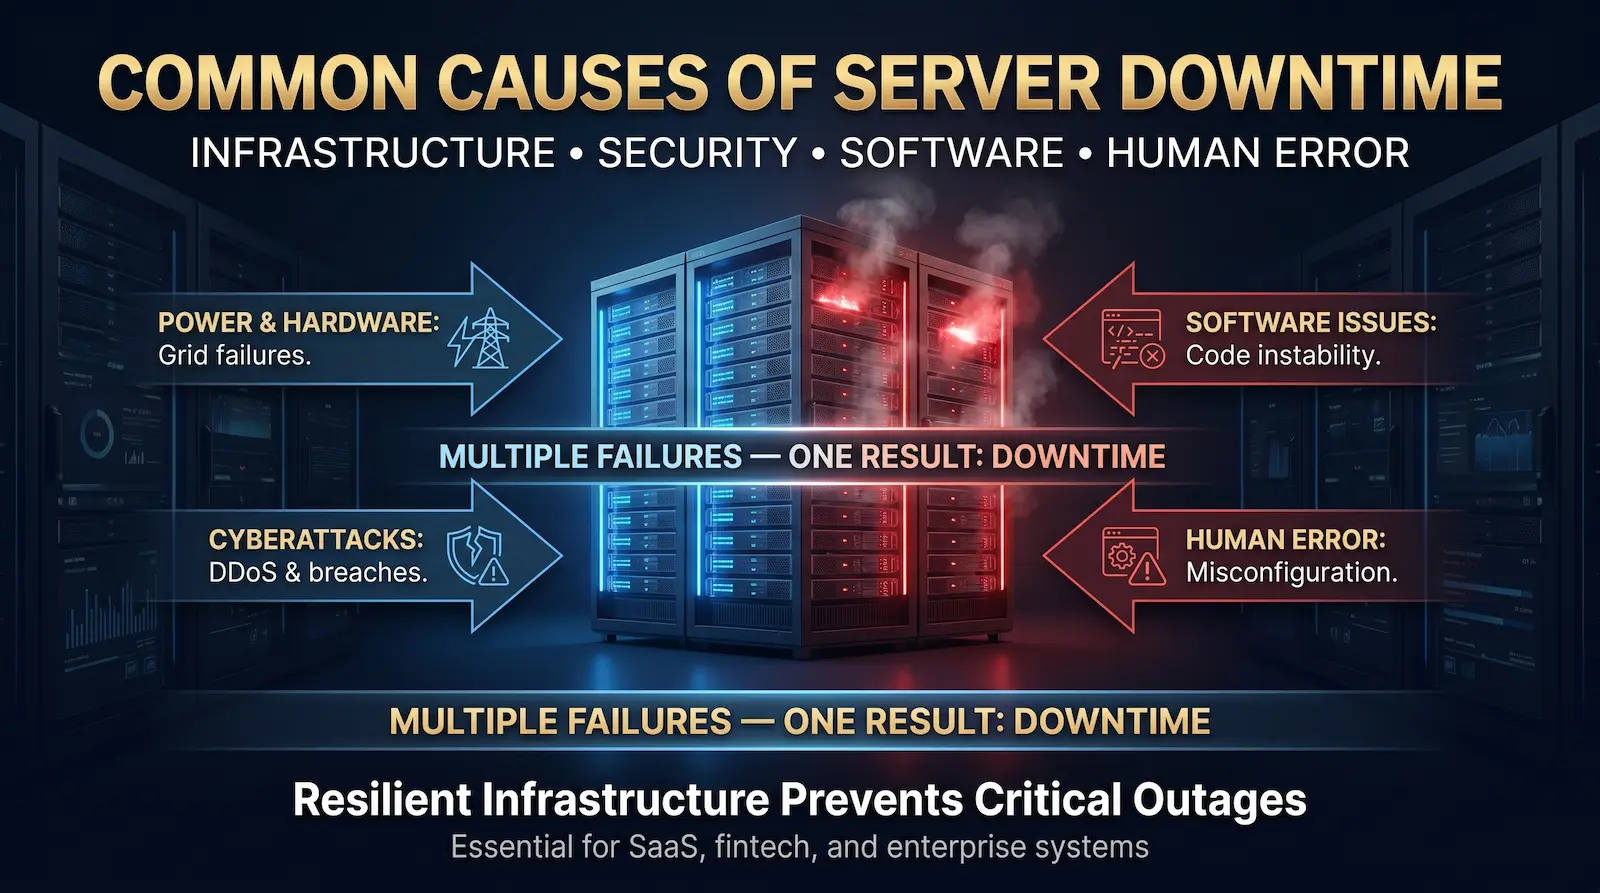
Moderne systeemstoringen vloeien voort uit ernstige belasting van het elektriciteitsnet, fysieke hardwarestoringen en geavanceerde cyberaanvallen. Niet-onderhouden softwareplug-ins en administratief toezicht zorgen ook voor onmiddellijke serviceonderbrekingen. IT-leiders moeten overbodige architectuur inzetten om deze fysieke en digitale bedreigingen te overleven en de continue beschikbaarheid te behouden.
Hardwarestoringen en spanning van het elektriciteitsnet
Fysieke hardwarecomponenten mislukken, maar macro-economische vermogensbeperkingen vormen een grotere bedreiging. Kunstmatige intelligentie met hoge dichtheid draineert gemeentelijke elektriciteitsnetten wereldwijd ernstig. Datacenters hebben te maken met enorme afkoelingsknelpunten. Servers worden donker tijdens lokale stroomstoringen, tenzij faciliteiten onafhankelijke microgrids en geavanceerde failoversystemen gebruiken.
Beveiligingsinbreuken en overbelasting van het verkeer
Gerichte beveiligingsinbreuken dwingen zeer stabiele systemen offline af. Aanvallers implementeren gedistribueerde denial of service-tactieken om netwerkcapaciteit te overweldigen en resources van de server uit te putten. Geavanceerde cyberdreigingen richten zich ook op DNS-routering en manipuleren SSL-certificaten, waardoor uitgebreide servicestoringen worden afgedwongen terwijl beveiligingsteams de gecompromitteerde infrastructuur schrobben.
Softwareproblemen en code-instabiliteit
Interne softwareproblemen crashen vaak gezonde hardwareomgevingen. Het pushen van niet-geteste code naar een productieomgeving veroorzaakt onmiddellijke systeeminstabiliteit. Verouderde problemen met plug-ins vormen een enorme structurele kwetsbaarheid voor contentbeheersystemen. Een enkele slecht gecodeerde extensie put gemakkelijk het servergeheugen uit en veroorzaakt een volledige applicatiecrash.
Administratief toezicht en menselijke fouten
Basisbeheerfouten doorbreken gemakkelijk de hele digitale afhankelijkheidsketen. Menselijke fouten veroorzaakt een enorm percentage van zeer vermijdbare netwerkstoringen. Medewerkers die gevestigde procedures overslaan of firewalls verkeerd configureren, vernietigen de beschikbaarheid van het systeem. Een eenvoudige vervallen domeinregistratie verwijdert uw webadres volledig uit het globale register.
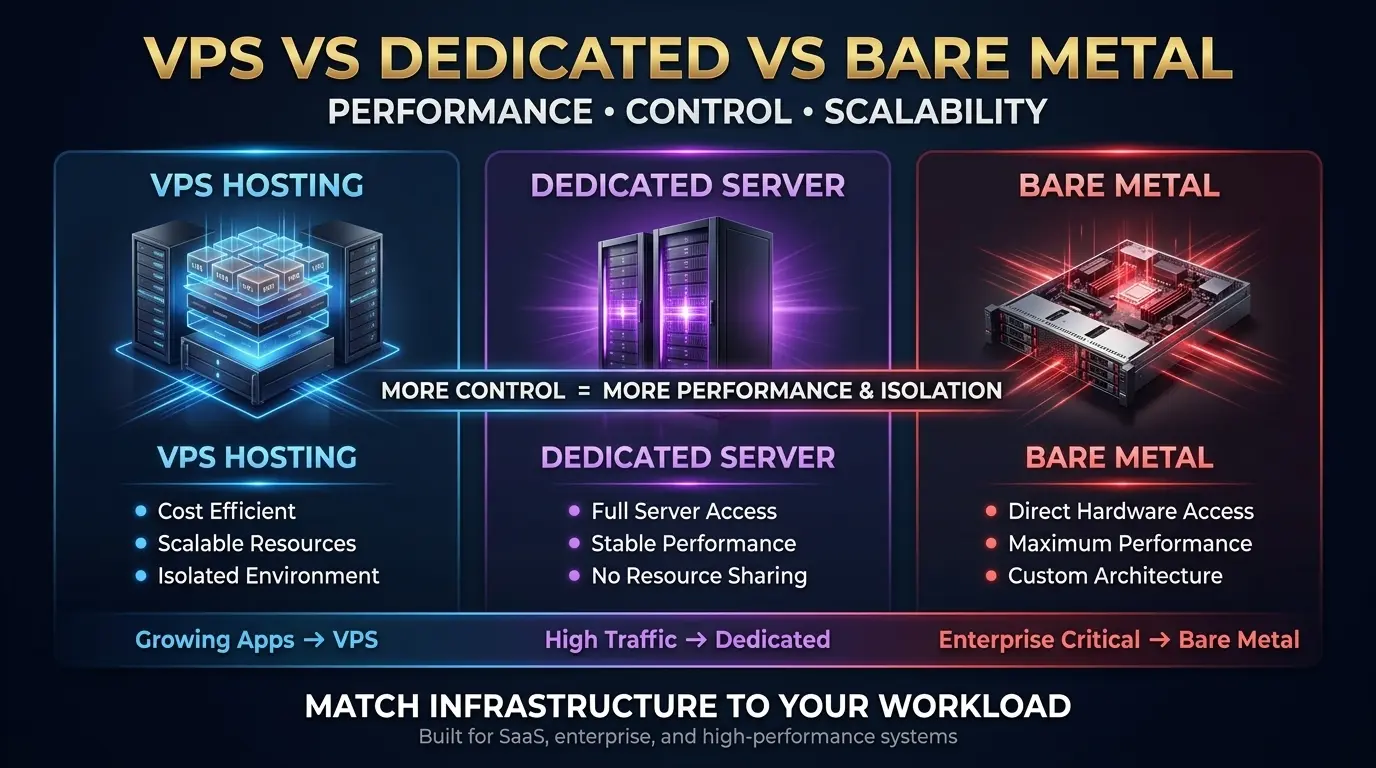
De juiste infrastructuur kiezen: VPS, dedicated en bare metal
Het selecteren van de juiste hostingomgeving dicteert rechtstreeks uw systeemstabiliteit. Enterprise-systemen met veel verkeer vereisen de absolute isolatie van hulpbronnen die wordt geboden door een bare metal-dedicated server om scenario's voor het doorlaten van hulpbronnen te voorkomen en maximale prestaties te garanderen tijdens pieknetwerkbelastingen.
Goedkope hosting blijft een primaire oorzaak van systeemstoringen. U moet uw hardwaretype afstemmen op uw vereiste beschikbaarheidsnorm. Premium aanbieders zoals Atal Networks Engineering-omgevingen die speciaal zijn ontworpen voor maximale uptime en netwerkbeveiliging.
Als u een snelgroeiende applicatie uitvoert, Beste VPS Biedt toegewijde bronnen binnen een gedeelde fysieke omgeving. Virtual Server Hosting maakt gebruik van virtualisatie om uw gegevens te isoleren van andere gebruikers. Dit zorgt voor een stabiele middenweg tussen kosten en prestaties.
Enterprise-organisaties die onder strikte service level-overeenkomsten werken, vereisen fysieke isolatie van hardware. De beste dedicated server Geeft uw technische team directe toegang tot de fysieke hardware zonder een hypervisorlaag. Dit verwijdert het risico dat andere huurders uw rekenkracht verbruiken. Wanneer u de hardware volledig bestuurt, kunt u aangepaste failoverprotocollen maken die gedeelde omgevingen eenvoudigweg niet kunnen ondersteunen.
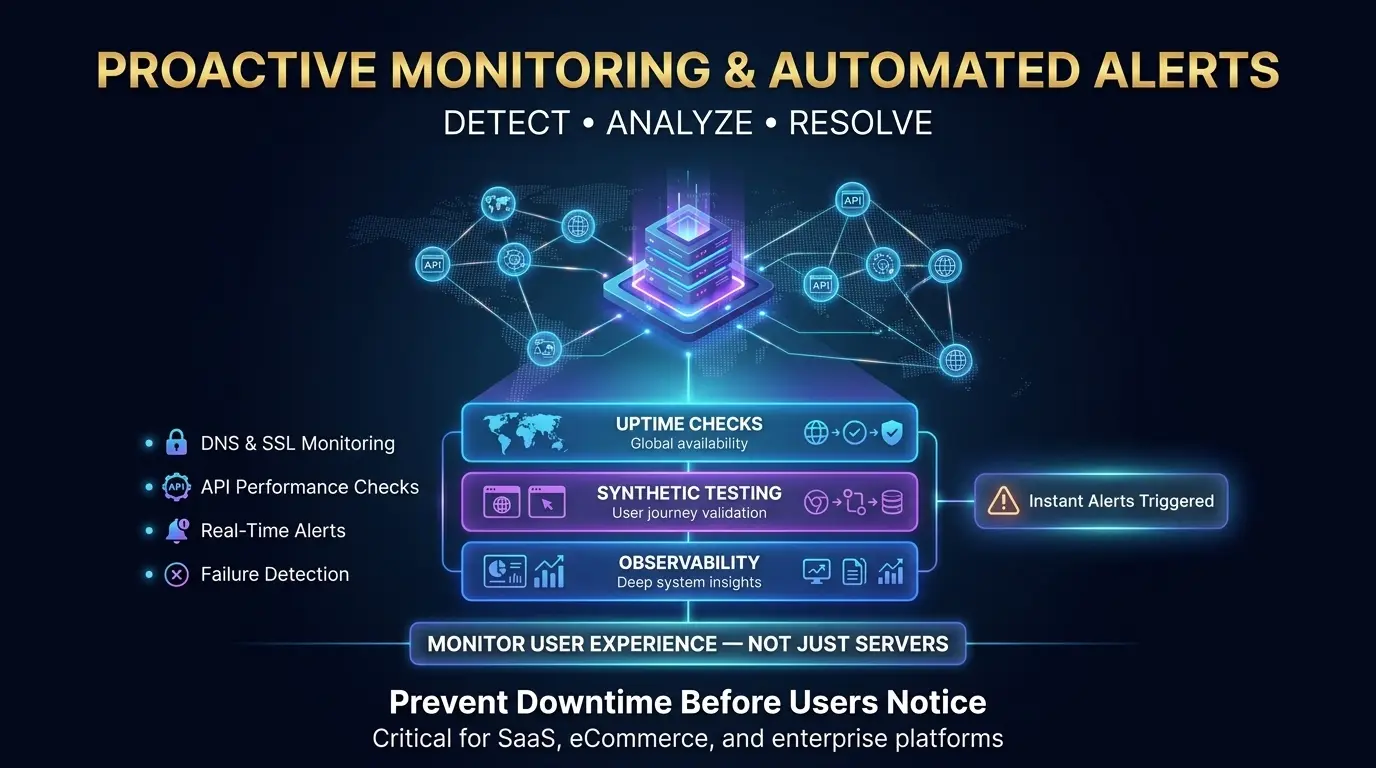
Proactieve monitoring en geautomatiseerde waarschuwingen
Moderne proactieve monitoring vereist continue monitoring van de digitale ervaring. In plaats van simpelweg hardware te pingen, maakt deze strategie gebruik van wereldwijde synthetische checkpoints om DNS-records, SSL-handshakes en API-functionaliteiten te verifiëren. Hierdoor kunnen teams geautomatiseerde waarschuwingen activeren en storingen oplossen voordat gebruikers problemen opmerken.
Het tijdperk van het pingen van een server-IP-adres om te controleren op stroom is voorbij. Bedrijven moeten monitoringarchitecturen inzetten die de daadwerkelijke klantreis volgen. Als uw betalingsgateway-API uitvalt, blijft uw server technisch opstaan, maar uw bedrijf blijft financieel laag.
Effectieve infrastructuurmonitoring werkt op drie verschillende lagen:
- Eenvoudige uptime-controles: Het verifiëren van de site laadt snel vanaf meerdere globale locaties.
- Synthetische transactietests: Het uitvoeren van geautomatiseerde bots door kritieke gebruikersstromen, zoals het toevoegen van een item aan een winkelwagentje of het voltooien van een login, om ervoor te zorgen dat de applicatie echt werkt.
- Volledige waarneming van ondernemingen: Serverlogboeken, CPU-telemetrie en prestatiestatistieken voor applicaties integreren om de hoofdoorzaak van een probleem te diagnosticeren voordat het een storing veroorzaakt.
Veelgestelde vragen (FAQ)
Wat betekent server uptime precies?
Server uptime vertegenwoordigt de continue duur die een digitale service met succes opereert en blijft toegankelijk voor gebruikers. Het teams volgen deze statistiek als een percentage over een ingesteld tijdvenster. Het handhaven van hoge beschikbaarheid garandeert dat uw toepassingsverkeer soepel verloopt. Deze stabiliteit beschermt direct uw maandelijkse inkomsten.
Is er een verschil tussen downtime en downtime?
De termen downtime en downtime betekenen precies hetzelfde bij computergebruik. Beide zinnen beschrijven een staat waarin een netwerk volledig niet beschikbaar wordt voor gebruikers. Enterprise-infrastructuurteams gebruiken de downtime met één woord als de standaardterm voor de industrie om systeemstoringen te loggen en digitale storingen bij te houden.
Hoe weet ik of mijn site omhoog of omlaag is?
Je volgt de functionaliteit van de site nauwkeurig door geautomatiseerde digitale ervaringsbewakingstools in te zetten. Deze synthetische trackingplatforms voeren continue wereldwijde controles uit op uw webapplicaties. Het bewakingssysteem stuurt een geautomatiseerd alarm rechtstreeks naar uw engineeringteam als uw server niet meer reageert of uw beveiligingscertificaten mislukken.
Zijn er standaarden voor een goed serveruptimepercentage?
Een standaard uptime-percentage voor servers begint bij 99,99 procent voor moderne enterprise-applicaties. Professionals uit de industrie noemen dit niveau vier negens van betrouwbaarheid. Deze specifieke statistiek staat slechts tweeënvijftig minuten totale offline tijd per jaar toe. Missie-kritische systemen richten zich op vijf negens om jaarlijkse mislukkingen terug te brengen tot slechts vijf minuten.
Referenties en changelog
Laatst bijgewerkt: 16 april 2026
Officiële referenties:
- Uptime-instituut: Jaarlijks storingsanalyserapport
- Amazon Web Services (AWS): Bereken service level overeenkomsten
- Google Zoeken Centraal: Verwerking van HTTP-netwerkfouten en 503 statuscodes
- World Wide Web Consortium (W3C): Web Content Accessibility Guidelines (WCAG) 2.2
