


ECC RAM est le choix le plus sûr pour la plupart des serveurs de production, car il peut corriger les erreurs de mémoire à un seul bit courants avant qu'une application n'utilise les données endommagées. Les bases de données, les hôtes de virtualisation, les serveurs de stockage, les systèmes financiers et les emplois de calcul de longue durée en bénéficient le plus. La RAM non-ECC peut toujours convenir aux systèmes de test jetables, aux laboratoires à domicile à faible risque et aux charges de travail qui peuvent être reconstruites rapidement.
Le choix dépend de plus que le prix des modules de mémoire. Le processeur, la carte mère, le micrologiciel et le type DIMM doivent prendre en charge ECC en tant que système complet. Les acheteurs doivent également tenir compte de la valeur de leurs données, du coût des temps d'arrêt, de la taille du pool de mémoire et du nombre de services pris en charge par un serveur.
Ce guide explique comment fonctionne ECC, où sa protection s'arrête et comment décider quel type de mémoire convient à votre serveur.
La plupart des serveurs de production doivent utiliser la RAM ECC
Choisissez ECC RAM lorsqu'une valeur incorrecte, un enregistrement corrompu, un travail a échoué ou un redémarrage du serveur peut affecter les clients ou les opérations commerciales. ECC est fortement recommandé pour les serveurs de base de données, les VM hôtes, le stockage ZFS ou Ceph, les applications en mémoire et les systèmes qui traitent des données précieuses.
La RAM non-ECC peut être acceptable lorsque tous les éléments suivants sont vrais :
- La charge de travail ne contient aucune donnée faisant autorité ou irremplaçable.
- Le serveur peut être reconstruit sans coût sérieux.
- Une défaillance affecte peu d'utilisateurs ou de services.
- Les sauvegardes testées couvrent toutes les données persistantes.
- Le coût de la plate-forme plus faible a une valeur réelle pour le projet.
ECC réduit une classe de risque matériel. Il ne remplace pas les RAID, les sommes de contrôle, la réplication, la surveillance ou les sauvegardes.
ECC vs RAM non-ECC en un coup d'œil
| Facteur | RAM ECC | RAM non-ECC |
|---|---|---|
| Nom complet | Mémoire de code de correction d'erreurs | Mémoire sans correction d'erreur au niveau du système |
| Erreurs à un seul bit | Les implémentations SECDED courantes les corrigent | Aucune couche ECC ne les corrige |
| Erreurs à double bit | Les implémentations SECDED courantes les détectent mais ne les corrigent pas | Aucune détection ECC au niveau du système de mémoire |
| Rapport d'erreur | Peut signaler des événements corrigés et non corrigés via le micrologiciel, un contrôleur de gestion de base de base ou le système d'exploitation | Ne fournit généralement aucune télémétrie de correction équivalente |
| Data integrity | Réduit le risque de corruption de mémoire non détectée | Laisse les applications exposées à des valeurs de mémoire endommagées |
| Support de plateforme | Nécessite la prise en charge du processeur, du contrôleur de mémoire, de la carte mère et du micrologiciel | Prise en charge par la plupart des plateformes grand public |
| Choix de modules | Peut utiliser ECC UDIMM, RDIMM ou LRDIMM, sous réserve des règles de la plate-forme | Utilise couramment des modules DIMM non tamponnés dans les systèmes de classe de bureau |
| Mise à l'échelle des capacités | Les plates-formes de serveurs prennent souvent en charge des pools de mémoire plus importants via des RDIMM ou des LRDIMM | Les plateformes grand public prennent généralement en charge des capacités maximales inférieures |
| Performance | Dépend de la vitesse de mémoire, des timings, des canaux, des rangs, de la population et de la charge de travail | Peut offrir des taux d'horloge élevés et de larges options de réglage sur les systèmes grand public |
| Coût | Peut nécessiter une plate-forme de classe serveur ainsi que différents modules DIMM | Réduit généralement le coût initial du matériel |
| usage courant | Serveurs de production, bases de données, virtualisation, stockage, recherche et systèmes d'entreprise | PC grand public, systèmes de jeu, laboratoires jetables et machines de test à faible risque |
Pourquoi les erreurs de mémoire sont importantes sur un serveur
La RAM contient des instructions et des données actives pour le système d'exploitation et chaque application en cours d'exécution. Une erreur de mémoire peut modifier un ou plusieurs bits pendant l'utilisation de ces informations. Le résultat dépend de ce que représentent les bits affectés.
Une valeur endommagée peut entraîner l'arrêt d'une application. Cela peut déclencher une panique du noyau ou un redémarrage inattendu. Il peut également rester caché. Le serveur peut continuer à travailler avec une valeur incorrecte et écrire ultérieurement cette valeur dans une base de données, un fichier, une réplique ou une sauvegarde.
Ce dernier cas est une corruption silencieuse des données. Un crash visible crée un événement sur lequel les administrateurs peuvent enquêter. Une corruption silencieuse peut passer par le traitement normal et apparaître beaucoup plus tard sous la forme d'un index endommagé, d'un calcul non valide, d'un fichier modifié ou d'une transaction incohérente.
Erreurs douces et erreurs strictes
Les défauts de mémoire se répartissent généralement en deux grands groupes.
Erreurs douces sont temporaires. Le bruit électrique, les changements de tension, le rayonnement, la température ou un autre événement court peuvent modifier un bit stocké sans endommager de façon permanente la cellule de mémoire. Le même emplacement peut fonctionner normalement après l'événement.
Erreurs dures proviennent d'un problème matériel répétable. Une cellule endommagée, une puce défaillante, une connexion défectueuse ou un composant vieillissant peuvent provoquer des erreurs au même endroit ou sur le même module DIMM. Le nombre d'erreurs corrigées aide souvent les opérateurs à trouver ces défauts de développement avant que le système n'enregistre un événement non corrigible.
Une grande étude de Google Fleet publiée en 2009 a révélé que les erreurs de DRAM étaient plus courantes que les estimations de laboratoire précédentes et que les erreurs strictes ont joué un rôle majeur. L'étude a examiné les générations de mémoire plus anciennes et un parc de serveurs spécifique, de sorte que ses chiffres ne doivent pas être utilisés comme une prévision de panne actuelle pour un serveur moderne. Sa leçon durable est plus simple : des erreurs de mémoire se produisent dans des systèmes de production réels et le rapport d'erreurs a une valeur opérationnelle.
L'exposition du serveur modifie le risque
Un bureau utilisé pendant quelques heures par jour et un serveur avec des centaines de gigaoctets de RAM en cours d'exécution toute l'année n'ont pas la même exposition. Plusieurs facteurs augmentent le coût pratique d'un défaut de mémoire :
- Plus de mémoire installée crée plus d'emplacements où une panne peut se produire.
- Le fonctionnement continu augmente le temps d'exposition.
- Une utilisation élevée permet de garder plus de données actives en mémoire.
- Un hôte de virtualisation peut transmettre une erreur matérielle à de nombreux systèmes invités.
- Une base de données peut écrire une valeur en mémoire incorrecte dans le stockage persistant.
- Un long travail de calcul peut perdre des heures ou des jours avant que quiconque ne trouve un mauvais résultat.
- Un service de production partagé peut affecter de nombreux clients à la fois.
Cela ne signifie pas que chaque grand serveur subira une corruption de mémoire. Cela signifie que l'impact possible augmente à mesure que le système transporte plus de données, plus de charges de travail et davantage de responsabilités commerciales.
Comment fonctionne la RAM ECC
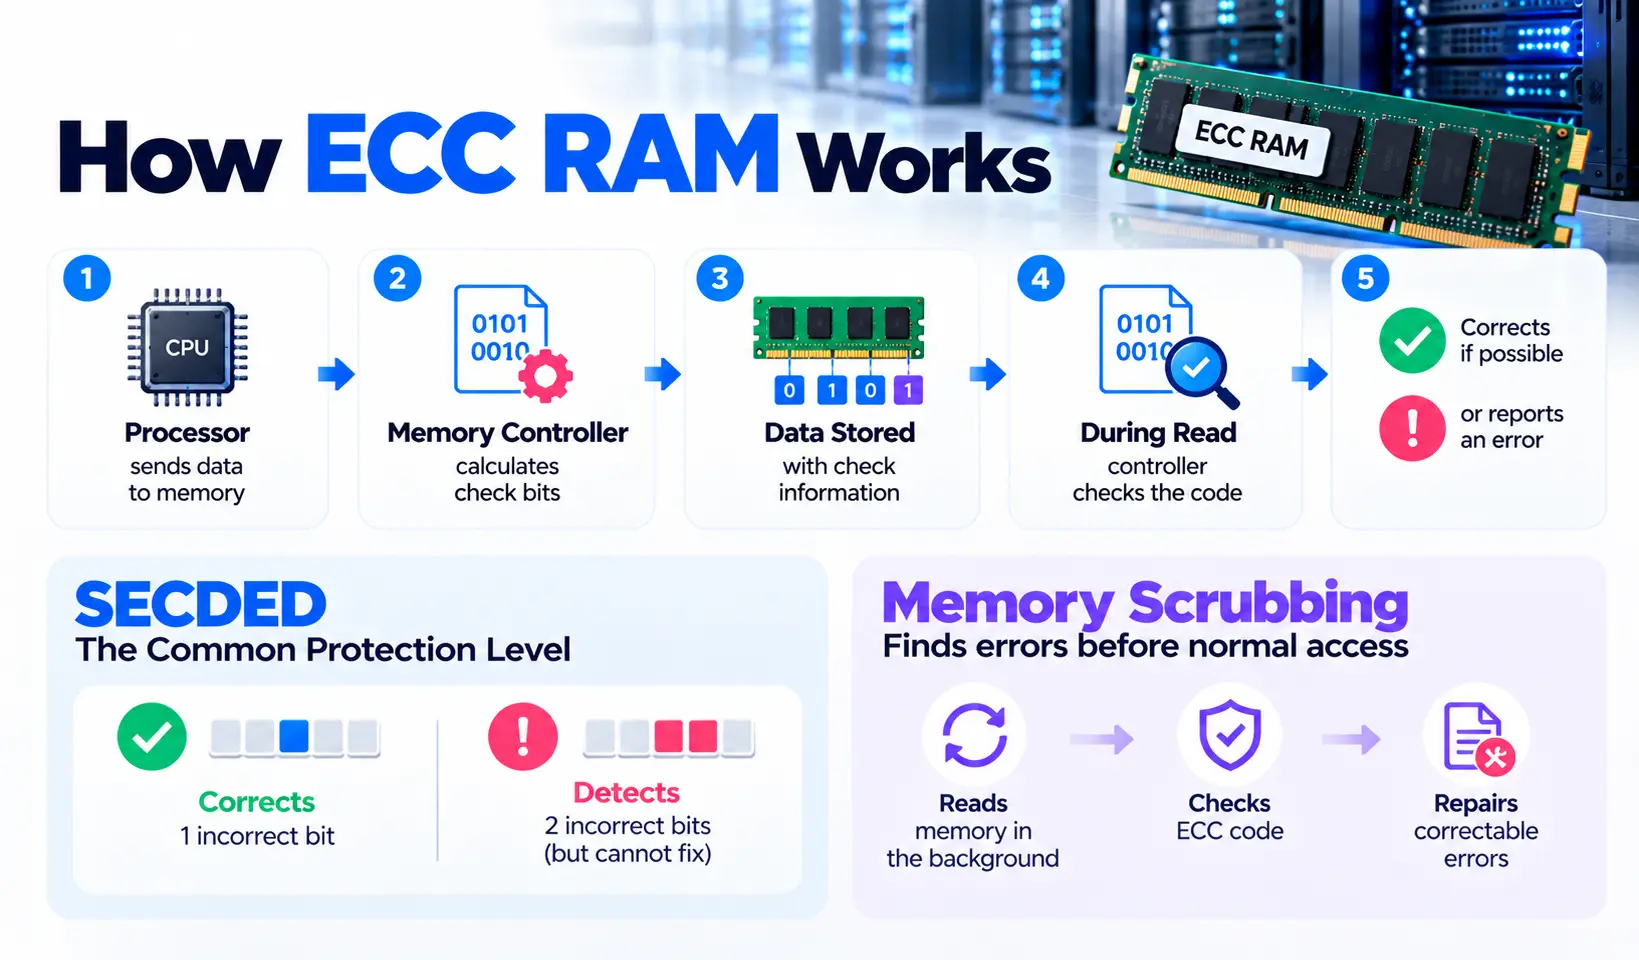
La mémoire ECC stocke des informations de contrôle supplémentaires avec chaque unité de données protégée. Lorsque le système écrit des données dans la mémoire, le contrôleur de mémoire calcule un code à partir des bits de données. Il stocke ce code avec les données. Lorsque le système lit les données, le contrôleur calcule à nouveau le code et compare le résultat.
Si les valeurs correspondent, la lecture continue. S'ils ne correspondent pas, le modèle peut identifier certaines erreurs. Le système peut corriger les données avant que le processeur ne les utilise, enregistrer l'événement ou arrêter le système lorsque la correction sécurisée n'est pas possible.
Le flux de base est :
- Le processeur envoie des données à la mémoire.
- Le contrôleur de mémoire calcule les bits de contrôle.
- Le module stocke les données et vérifie les informations.
- Le contrôleur vérifie le code lors d'une lecture ultérieure.
- Le système corrige une erreur prise en charge ou signale un événement non corrigible.
SECDED explique le niveau de protection commun
De nombreuses plates-formes de serveurs utilisent la correction d'erreurs simples, la détection de double erreur, connue sous le nom de SECDED. Dans sa forme commune, SECDED peut corriger un bit incorrect dans un mot de mémoire protégé. Il peut détecter deux bits incorrects dans ce mot mais ne peut pas reconstruire la valeur d'origine avec certitude.
La différence entre la détection et la correction est importante. Un événement unique corrigé peut permettre au service de continuer. Un événement à double bit détecté peut entraîner une vérification de la machine, un retrait de la page, une défaillance de processus ou un arrêt du système, selon le matériel et le système d'exploitation.
ECC n'est donc pas une promesse que chaque défaut de mémoire peut être réparé. Il s'agit d'un mécanisme de protection défini avec des limites de correction et de détection.
Le nettoyage de la mémoire révèle des erreurs avant l'accès normal
Une erreur de mémoire peut rester dans un emplacement inutilisé jusqu'à ce que le logiciel lit cette adresse. Le nettoyage de la mémoire réduit ce risque en lisant la mémoire en arrière-plan, en vérifiant le code ECC et en réécrivant les données corrigées lorsque la plate-forme prend en charge cette action.
Les fournisseurs de serveurs peuvent appeler ce scrub de patrouille, un gommage d'arrière-plan, un gommage à la demande ou un autre nom spécifique à la plate-forme. Le contrôleur de gestion de la base de base, souvent appelé le BMC, peut également enregistrer le DIMM, le canal, le rang ou l'adresse qui a produit un événement.
Le frottement aide de deux manières. Il peut réparer un défaut corrigeable avant qu'un autre bit ne change dans le même mot protégé. Il produit également des preuves que les administrateurs peuvent utiliser pour planifier la maintenance.
Une protection avancée des serveurs peut aller plus loin
Certaines plates-formes de serveurs offrent des fonctionnalités de fiabilité, de disponibilité et de facilité d'entretien plus fortes. Ceux-ci peuvent inclure le chipkill, la correction des données d'un seul appareil, la mise en miroir de la mémoire, les rangs de réserve, l'arrêt de la page et la retraite des périphériques de mémoire.
Le comportement exact dépend du processeur, du contrôleur de mémoire, de la disposition DIMM, du micrologiciel et du modèle de serveur. Une étiquette générique « prise en charge d'ECC » ne prouve pas que toutes les fonctionnalités avancées sont présentes.
Que se passe-t-il avec la RAM non-ECC ?
La RAM non-ECC stocke et renvoie des données sans le même processus de correction au niveau du système. Si un bit change, le processeur peut recevoir la valeur modifiée comme si elle était correcte.
Plusieurs résultats sont possibles :
- La valeur affectée n'est jamais utilisée.
- Une application produit un résultat incorrect.
- Un processus s'arrête avec une erreur.
- Le système d'exploitation échoue.
- Un fichier, une page de base de données, une archive ou une sauvegarde reçoit des données endommagées.
- Une valeur sensible à la sécurité, telle qu'un indicateur d'autorisation, change.
- Le serveur se comporte de manière imprévisible et le défaut est difficile à reproduire.
La mémoire non ECC n'est pas une mémoire défectueuse. La plupart des ordinateurs grand public fonctionnent avec lui avec succès. La différence est la réponse du système lorsqu'un défaut de mémoire se produit. Un serveur de production a souvent besoin d'une gestion plus solide car l'impact est plus important et la charge de travail s'exécute pendant de plus longues périodes.
ECC ou RAM non-ECC : différences de serveurs principales
Intégrité et disponibilité des données
ECC peut corriger les événements à un seul bit commun avant que l'application ne voie les données modifiées. Il peut également transformer certains défauts cachés en événements matériels enregistrés. Ce rapport donne aux opérateurs une chance de localiser un DIMM défaillant et de le remplacer lors de la maintenance planifiée.
Les systèmes non ECC manquent généralement de cette voie de correction et de rapport. Une panne matérielle peut apparaître en premier lieu comme un problème d'application, une mauvaise sortie ou un plantage inexpliqué. Le dépannage peut prendre plus de temps car l'équipe du logiciel a peu de preuves que la mémoire a causé l'événement.
Performance
La mémoire ECC est souvent décrite comme plus lente, mais l'étiquette ECC seule ne prédit pas les performances de l'application. Plusieurs facteurs peuvent avoir un effet plus important :
- Génération de mémoire et taux de transfert
- Horaires primaires et secondaires
- Nombre de canaux de mémoire actifs
- Nombre de modules DIMM par canal
- Plan de classement
- Conception du contrôleur de mémoire CPU
- Placement NUMA sur les serveurs multi-sockets
- Comportement RDIMM ou LRDIMM
- Modèle d'accès à la charge de travail
Une comparaison équitable nécessite des processeurs appariés, une capacité égale, une population de canaux équivalente, des vitesses de mémoire alignées, le même firmware et la même charge de travail. Une plate-forme grand public avec une mémoire non-ECC réglée et une plate-forme de serveur avec des RDIMM diffèrent à bien des égards. Un benchmark entre eux ne peut pas attribuer toute la différence à la vérification ECC.
Pour la plupart des acheteurs de production, la capacité, l'équilibre des canaux et la charge de travail sont plus importants qu'un petit coût ECC théorique. Utilisez des tests mesurés à partir de la plate-forme exacte lorsque la latence ou la bande passante peut affecter une cible de service.
Coût et coût total de possession
La décision ECC comprend plus que le prix DIMM. Un processeur compatible ECC, une carte mère, un châssis de serveur, un système de gestion à distance et une classe de modules pris en charge peuvent modifier le coût initial.
L'autre côté du calcul comprend :
- Temps d'arrêt et transactions perdues
- Données endommagées ou douteuses
- Échec des travaux de calcul
- Ingénieur du temps passé à tracer des défauts aléatoires
- Entretien d'urgence
- Impact client
- Travaux de récupération et de vérification
Un modèle de décision de base est :
Coût de la défaillance de la mémoire attendue = Estimation de la probabilité d'incident × Impact commercial
Cette formule est une aide à la planification. Ce n'est pas une prévision mesurée. Si un mauvais résultat ou une défaillance de l'hôte peut coûter plus cher que la différence de plate-forme, ECC est généralement le bon choix.
Capacité et mise à l'échelle
Les grands serveurs utilisent souvent des modules DIMM enregistrés ou des modules DIMM réduits en charge. Signaux de commande et d'adresse de tampon RDIMMS. Les LRDIMM réduisent davantage la charge électrique. Ces conceptions peuvent prendre en charge plus de modules et des capacités totales plus élevées sur les plates-formes compatibles.
ECC et la mémoire enregistrée décrivent différentes propriétés :
- eccle Décrit la détection et la correction d'erreurs.
- udim Décrit un module non tamponné.
- rdimm Décrit un module avec des signaux de commande et d'adresse enregistrés.
- LRDIMM Décrit un module conçu pour réduire davantage le chargement électrique.
Un UDIMM ECC est à la fois non tamponné et corrigeant les erreurs. Un RDIMM de serveur inclut généralement ECC, mais "enregistré" et "ECC" ne doit pas être utilisé comme termes interchangeables.
Compatibilité
Un module ECC ne peut pas créer de support ECC par lui-même. Les parties suivantes doivent convenir :
- Processeur et contrôleur de mémoire intégré
- Carte mère et chipset
- BIOS ou micrologiciel UEFI
- Génération DDR
- Classe de modules, comme ECC UDIMM, RDIMM ou LRDIMM
- Supported capacity and rank layout
- Vitesse et tension de la mémoire
- Modèle de population de machines à sous
Certaines cartes mères acceptent les UDIMM ECC mais les font fonctionner sans correction. D'autres systèmes refusent de démarrer avec un module non pris en charge. Les RDIMM DDR4 peuvent s'adapter physiquement à une prise DDR4 UDIMM mais restent électriquement incompatibles. DDR5 utilise des différences de saisie supplémentaires dans certaines classes de modules.
Vérifiez toujours la liste de mémoire manuelle et qualifiée pour le modèle de serveur exact. L'ajustement physique n'est pas la preuve d'un soutien fonctionnel.
DDR5 On-Die ECC n'est pas un serveur ECC
DDR5 a introduit un ECC On-Die à l'intérieur de chaque puce DRAM. La fonctionnalité corrige certaines erreurs de cellule interne avant que les données ne quittent la puce. Il aide les fabricants à gérer des conceptions de mémoire plus denses et une géométrie de processus plus petite.
On-DIE ECC n'offre pas la même protection qu'un sous-système de mémoire ECC de serveur. Il ne protège pas toutes les erreurs qui peuvent se produire entre la puce DRAM, le module, le bus mémoire, le contrôleur de mémoire et le processeur. Il n'y a pas non plus le même chemin de création de rapports au niveau de l'hôte que celui utilisé pour la surveillance des erreurs de serveur.
Cette distinction crée une erreur d'achat courante. Un module DDR5 grand public standard peut contenir un ECC sur le fil tout en étant vendu et utilisé comme mémoire système non-ECC.
Pour l'ECC de serveur complet, recherchez tous ces éléments :
- Un processeur et un contrôleur de mémoire compatibles ECC
- Une carte mère et un micrologiciel qui permettent de corriger
- Un ECC UDIMM, RDIMM ou LRDIMM pris en charge
- Preuve de micrologiciel ou de système d'exploitation que l'ECC est actif
- Compteurs d'erreurs ou journaux matériels que les administrateurs peuvent surveiller
Kingston décrit DDR5 On-Die ECC comme une protection au sein de la puce DRAM et indique qu'il ne corrige pas les erreurs en dehors de la puce ou sur le bus. Synopsys sépare également l'ECC On-Die de l'ECC à bande latérale utilisé pour une protection plus large de la mémoire du serveur.
Votre serveur a-t-il besoin de RAM ECC ?
La charge de travail détermine le risque de mémoire qu'un serveur peut accepter.
Bases de données de production et systèmes de transactions
Production Serveurs de base de données Devrait utiliser la RAM ECC. Les bases de données contiennent des pages de données, des index, des résultats de requête, des enregistrements de transaction et des caches en mémoire. Une valeur modifiée peut produire un résultat incorrect ou atteindre un stockage persistant lors d'une écriture.
Les sommes de contrôle de la base de données et les contrôles de transaction restent utiles, mais ils ne couvrent pas tous les points où la mémoire endommagée peut affecter le traitement. ECC ajoute une protection avant que le moteur de base de données utilise la valeur.
Hôtes de virtualisation et plates-formes de conteneurs
Un hôte de virtualisation doit utiliser ECC car une panne matérielle peut affecter de nombreux systèmes invités. L'hôte peut exécuter des bases de données, des applications Web, des panneaux de commande, des pare-feu et des services clients dans le même pool de mémoire.
L'impact commercial est donc plus important que l'échec d'un serveur d'applications jetable. Les rapports ECC aident également les administrateurs à distinguer un problème de matériel hôte des problèmes logiciels invités distincts.
La même logique s'applique à Proxmox VE, VMware ESXi, Hyper-V, KVM et d'autres plates-formes de calcul partagées.
ZFS, Ceph, NAS et serveurs de stockage
ZFS ne nécessite pas de RAM ECC comme condition logicielle stricte. De nombreux systèmes domestiques exécutent ZFS avec une mémoire non ECC. ECC est toujours le choix préféré lorsque le serveur de stockage contient des données précieuses ou difficiles à recréer.
ZFS Checksums peut détecter et réparer de nombreuses erreurs de chemin de stockage lorsque des données redondantes sont disponibles. ECC adresse un point différent dans le chemin. Si la mémoire change de données avant le calcul d'une nouvelle somme de contrôle, la pile de stockage peut accepter et stocker la valeur modifiée avec une somme de contrôle correspondante.
Ceph, RAID logiciel, RAID matériel et systèmes de fichiers ordinaires ont la même limite générale. La protection de stockage ne peut pas corriger toutes les erreurs qui commencent dans la RAM du système.
AI, apprentissage automatique, HPC et charges de travail scientifiques
ECC convient aux travaux de calcul longs et aux résultats sensibles à la précision. Une tâche de formation, de simulation, de rendu ou d'analyse peut contenir un grand ensemble de travail en mémoire pendant de nombreuses heures. Une valeur intermédiaire endommagée peut affecter les calculs ultérieurs ou forcer une rediffusion coûteuse.
La mémoire du système CPU et la mémoire du GPU sont des zones distinctes. Un serveur doté d'un système de mémoire RAM ECC peut toujours utiliser un GPU sans protection ECC. Les acheteurs doivent vérifier les deux spécifications lorsque le chemin de calcul complet doit être corrigé.
Systèmes financiers, de santé et réglementés
Les systèmes qui traitent les paiements, les dossiers financiers, les informations de santé ou les données commerciales réglementées doivent utiliser ECC dans le cadre d'un plan d'intégrité plus large. Le plan doit également inclure le contrôle d'accès, la journalisation, la protection du stockage, les sauvegardes, les tests de récupération et la gestion des modifications.
ECC seul ne crée pas de conformité réglementaire. Cela réduit un risque matériel spécifique qui peut affecter la précision des données et la disponibilité des services.
Serveurs Web, SaaS, jeux et streaming
La réponse dépend du rôle du serveur.
ECC est le choix le plus fort lorsque le système stocke les comptes d'utilisateurs, les enregistrements de facturation, l'état de l'application, les autorisations, les inventaires de jeux ou d'autres données faisant autorité. Cela a également du sens lorsqu'une machine sert de nombreux utilisateurs ou fournit plusieurs services virtuels.
Un cache de bord remplaçable, un travailleur de transcodage temporaire, une instance de test de jeu jetable ou un nœud Web de développement peuvent accepter plus de risques. Le facteur décisif est de savoir si la charge de travail peut récupérer proprement sans perdre de données ou provoquer une longue panne.
Laboratoires d'accueil et serveurs de développement
La RAM non-ECC peut être raisonnable pour un laboratoire à domicile conçu pour l'apprentissage, les tests, la lecture de médias ou les machines virtuelles de courte durée. Un matériel grand public à moindre coût peut permettre au propriétaire d'acheter plus de capacité ou un processeur plus rapide.
ECC devient de plus en plus utile lorsque cette même machine stocke des photos de famille, des fichiers commerciaux, des mots de passe, des sauvegardes ou des services à domicile qui doivent rester disponibles. Une étiquette « laboratoire » ne rend pas les données irremplaçables moins précieuses.
Cinq questions qui décident si vous avez besoin d'ECC
Utilisez ces questions avant de choisir un serveur :
- Une mauvaise valeur serait-elle pire qu'un accident visible ? ECC peut empêcher les défauts courants d'un seul bit de devenir des erreurs cachées.
- Le serveur contient-il des données faisant autorité ou difficiles à recréer ? Les enregistrements de base de données, les données des clients, les résultats de recherche et les fichiers originaux favorisent ECC.
- Le serveur fonctionnera-t-il continuellement avec un grand pool de mémoire ? Une plus grande capacité et une plus longue durée d'exécution augmentent l'exposition.
- Un défaut d'hôte pourrait-il affecter de nombreuses charges de travail ? Les hôtes VM et les systèmes de stockage partagé ont un impact élevé sur les défaillances.
- La récupération coûterait-elle plus cher que la plate-forme compatible ECC ? Inclure les temps d'arrêt, le temps du personnel, la perte de travail et l'impact des clients.
| Profil de charge de travail | Impact d'erreur | Coût de récupération | Choix recommandé |
|---|---|---|---|
| Base de données de production ou système de paiement | Élevé | Élevé | eccle |
| Hôte de virtualisation avec de nombreux invités | Élevé | Élevé | eccle |
| Stockage NAS ou ZFS d'entreprise | Élevé | Moyen à élevé | eccle |
| Long emploi scientifique ou IA | Moyen à élevé | Élevé | eccle |
| Web de production ou serveur SaaS | Moyen à élevé | Moyen à élevé | eccle |
| Cache ou nœud de travail remplaçable | Faible à moyen | Faible | Dépend de la conception de la flotte |
| Serveur de développement jetable | Faible | Faible | Non-CEC peut être acceptable |
| Laboratoire à domicile sans données uniques | Faible | Faible | Non-CEC peut être acceptable |
Vérifiez la compatibilité ECC avant de commander
Le mot "ECC" sur une liste DIMM n'est que la première vérification.
Confirmer le support du processeur
Lisez la spécification du modèle de processeur exact. Ne vous fiez pas uniquement à un nom de famille. Le support peut différer selon les générations, les modèles, les chipsets et les segments de marché.
Les processeurs de serveur tels qu'Intel Xeon et AMD EPYC prennent généralement en charge ECC, mais la classe de modules et la capacité maximales peuvent varier. Certains processeurs de postes de travail et de bureau prennent également en charge ECC dans des conditions spécifiques de la carte mère.
Confirmer le support de la carte mère et du micrologiciel
Lisez le manuel du serveur et la liste de mémoire qualifiée. Vérifiez si la carte permet une correction réelle ou accepte simplement un module compatible ECC en mode non-ECC.
Consultez les paramètres du BIOS ou de l'UEFI pour les ECC, les mémoires RAS, les gommages de patrouille, les rangs de réserve, la mise en miroir ou l'injection d'erreurs. Les paramètres disponibles varient selon la plate-forme.
correspondre à la classe DIMM
Identifiez le type de module requis avant l'achat :
- ECC UDIMM
- rdimm
- LRDIMM
- DDR4 ou DDR5
- vitesse prise en charge
- Nombre de rangs pris en charge
- Capacité maximale par emplacement
Ne mélangez pas les UDIMM avec les RDIMM. Ne présumez pas que les RDIMM et LRDIMM peuvent fonctionner ensemble. Suivez les règles de population du fournisseur de serveurs lors du remplissage des canaux de mémoire.
Une disposition de canal équilibrée offre souvent une meilleure bande passante et un comportement plus prévisible qu'un arrangement inégal. Le remplissage de plus de modules DIMM par canal peut également réduire le taux de transfert pris en charge.
Poser des questions directes au fournisseur d'hébergement
Avant de commander un serveur dédié, demandez :
- Cette configuration exacte utilise-t-elle la mémoire ECC ?
- La correction ECC est-elle activée dans le micrologiciel ?
- Le système utilise-t-il des UDIMM, des RDIMM ou des LRDIMM ECC ?
- Quelle génération et quel taux de transfert DDR sont installés ?
- Le BMC peut-il signaler des erreurs de mémoire corrigées et non corrigées ?
- Le fournisseur surveille-t-il les erreurs corrigées répétées ?
- Quel est le processus de remplacement DIMM ?
- La capacité de la RAM peut-elle augmenter sans changer de classe de module ou réduire l'équilibre des canaux ?
Des réponses claires empêchent un acheteur de payer pour un système « compatible ECC » qui n'utilise pas de correction active.
Comment confirmer que l'ECC est actif et surveillez les erreurs
Les modules ECC installés ne prouvent pas que le système complet fonctionne en mode ECC. Vérifiez plus d'une source lorsque cela est possible.
BIOS, UEFI et BMC
Commencez par le micrologiciel du serveur ou l'interface de gestion à distance. Recherchez :
- ECC activé ou statut actif
- Nombre d'erreurs corrigé
- Nombre d'erreurs non corrigé
- DIMM Health par slot
- Santé du canal mémoire
- Configuration des gommages de patrouille
- Entrées du journal des événements système
Les interfaces Dell iDRAC, HPE iLO, IPMI et d'autres plates-formes BMC peuvent exposer ces informations. Les noms de menu exacts dépendent de la génération de serveur.
Linux
Linux fournit le sous-système de détection et de correction d'erreurs, appelé EDAC. Selon la distribution et le matériel, les administrateurs peuvent consulter les informations du micrologiciel, les messages du noyau, les compteurs EDAC et les événements RAS.
Les outils utiles peuvent inclure :
sudo dmidecode --type memory
sudo dmesg | grep -i -E 'edac|ecc|mce|memory error'
sudo ras-mc-ctl --status
sudo ras-mc-ctl --errors
code DMIDE Rapports les informations fournies par SMBiOS. Une étiquette telle que "ECC unique" aide, mais les données du micrologiciel peuvent être incomplètes. Associez-le à l'état BMC, à la sortie du noyau EDAC ou rasdaemon enregistrements.
La documentation du noyau Linux identifie les erreurs corrigables et les erreurs non corrigibles comme des événements de mémoire primaire collectés via EDAC. Les événements corrigables ne signifient pas que les données de l'application ont été endommagées, mais des événements répétés peuvent indiquer un problème matériel de développement.
Windows Server
Architecture d'erreur matérielle Windows, ou WHEA, enregistre les informations d'erreur matérielle dans l'Observateur d'événements. Les systèmes pris en charge peuvent signaler des événements de mémoire corrigés et des événements de vérification des machines fatales.
Microsoft documente également l'analyse des pannes prédictives pour la mémoire ECC. Sur le matériel compatible, Whea peut suivre les erreurs répétées sur les pages mémoire et mettre une page hors ligne après un seuil configuré.
Vérifiez le journal du système Windows pour les événements WHEA. Comparez ensuite l'événement avec le journal BMC et les outils de diagnostic du fournisseur de serveurs.
hyperviseurs
Pour VMware ESXi, Proxmox VE et Hyper-V, vérifiez l'hôte physique. Une machine virtuelle invitée ne peut généralement pas voir les données complètes de santé DIMM.
Utilisez les outils BMC, les journaux du noyau hôte, le service de santé du matériel et les outils de gestion des fournisseurs. Mappez l'emplacement ou le canal signalé au module physique avant le remplacement.
Répondre aux erreurs corrigées
Un événement corrigé ne nécessite pas toujours un remplacement immédiat. Un décompte croissant, des erreurs répétées à la même adresse ou des erreurs liées à un module DIMM nécessitent une enquête.
Enregistrer :
- Modèle de serveur et version du micrologiciel
- Fente et canal DIMM
- Numéro de pièce du module
- Nombres corrigés et non corrigés
- Horodatages d'erreur
- Événements de température et de puissance
- Conditions de charge de travail
- Modifications matérielles récentes
Suivez les seuils de maintenance du fournisseur de serveurs. Réinstallez ou remplacez le matériel uniquement dans le cadre d'un processus de maintenance approuvé. Continuez à regarder les compteurs après le changement.
ECC ne remplace pas le RAID, les sommes de contrôle ou les sauvegardes
La fiabilité du serveur nécessite plusieurs contrôles, car chacun gère un type de défaillance différent.
| couche de protection | travail principal | Ce qu'il ne couvre pas |
|---|---|---|
| RAM ECC | Corrige ou détecte les erreurs de mémoire spécifiées | Fichiers supprimés, lecteurs défectueux, bogues d'application ou perte de serveur complète |
| Systèmes de fichiers ou somme de contrôle des applications | Détecte les changements sélectionnés dans les données stockées ou transmises | Chaque erreur qui se produit avant la création de la somme de contrôle est |
| Raid | Conserve un ensemble de stockage en fonctionnement après des pannes de disque sélectionnées | Suppression accidentelle, toutes corruptions, logiciels malveillants ou reprise après sinistre |
| réplication | conserve une autre copie de données ou de service | Mauvaises écritures, erreurs de l'opérateur ou défauts copiés dans la réplique |
| instantané | Conserve les états de point dans le temps | Récupération indépendante après la perte du même système de stockage |
| sauvegarde | Restaure les données après une perte ou une corruption | Continuité immédiate et récupération garantie sans tests de restauration |
Une conception de production peut combiner ECC, la suppression de la mémoire, les sommes de contrôle de stockage, le RAID, la réplication, les sauvegardes hors serveur, la surveillance et la restauration des tests. Ces contrôles fonctionnent ensemble car aucune couche unique ne couvre chaque chemin de défaillance.
Choisir un serveur Atal Networks avec la bonne mémoire
Chez Atal Networks, nous vous recommandons de sélectionner d'abord la protection de la mémoire et la capacité à partir du risque de charge de travail. Une base de données, un hôte de virtualisation ou un serveur de stockage d'entreprise a généralement besoin d'ECC et d'une plate-forme qui signale la santé de la mémoire. Un nœud de développement temporaire peut accorder plus de valeur à un coût initial inférieur.
Passez en revue notre Spécifications du serveur en métal nu Pour dimensionner le processeur, la RAM, le stockage et le réseau ensemble. Notre Guide de l'UC du serveur Peut également vous aider à faire correspondre la classe de processeur avec la capacité de mémoire et les besoins de charge de travail.
Confirmez l'état ECC exact, la classe DIMM, la capacité, la disposition des canaux et le chemin de mise à niveau pour la configuration sélectionnée. Si vous planifiez une base de données, un cluster de stockage, un environnement virtualisé ou une application à mémoire élevée, discutez des exigences avec notre équipe d'infrastructure avant le déploiement.
Questions fréquemment posées
La RAM ECC peut-elle corriger chaque erreur de mémoire ?
Non. Mémoire SECDED commune Corrige une erreur à un seul bit et détecte une erreur de double bit dans un mot protégé. Il ne peut pas corriger chaque défaut multi-bits, adresse, bus, contrôleur ou périphérique. Certaines plates-formes de serveurs ajoutent du chipkill, du SDDC, de la mise en miroir de la mémoire ou de l'épargne pour une protection plus large.
ECC RAM peut-il fonctionner sur une carte mère non-ECC ?
Cela dépend du module et de la plate-forme. Certaines cartes mères ne démarreront pas. Certains acceptent un ECC UDIMM mais l'utilisent sans correction active. Vérifiez la spécification du processeur, le manuel de la carte mère, le support du micrologiciel et la liste de mémoire qualifiée.
Puis-je mélanger ECC et RAM non-ECC ?
Évitez de les mélanger. De nombreux systèmes rejettent des configurations mixtes ou désactivent la correction. Les fournisseurs de serveurs restreignent également le mélange des UDMM, des RDIMM et des LRDIMM. Utilisez une classe de modules pris en charge et suivez les règles de population documentées.
La RAM ECC est-elle plus lente que la RAM non-ECC ?
La vérification ECC peut ajouter du travail, mais les performances de l'application dépendent de la plate-forme de mémoire complète. La vitesse, les horaires, le nombre de canaux, les classements, la population de modules, la conception des processeurs et le comportement de la charge de travail peuvent avoir plus d'importance. Utilisez des tests de système apparié pour une réponse numérique.
DDR5 a-t-il un ECC intégré ?
La DRAM DDR5 comprend un ECC On-Die qui protège certains défauts à l'intérieur de chaque puce de mémoire. Le DDR5 grand public standard est toujours non-ECC au niveau du système. Le serveur ECC complet a besoin d'un processeur, d'une carte mère, d'un micrologiciel et d'un module ECC pris en charge.
ZFS nécessite-t-il une RAM ECC ?
Non. ZFS peut fonctionner sans ECC. ECC est toujours recommandé lorsque le serveur contient des données précieuses car il protège contre certaines erreurs de mémoire que les sommes de contrôle de stockage ne peuvent pas empêcher à chaque étape.
Un serveur domestique a-t-il besoin de RAM ECC ?
Un laboratoire domestique jetable peut utiliser une mémoire non-ECC. Un serveur domestique qui stocke des photos d'origine, des fichiers professionnels, des informations d'identification ou des sauvegardes bénéficie d'ECC. Basez le choix sur la valeur des données et le coût de récupération au lieu de l'étiquette « serveur domestique ».
La RAM enregistrée est-elle toujours ECC ?
La signalisation enregistrée et l'ECC sont des propriétés distinctes. Les RDIMM du serveur fournissent généralement ECC, mais "enregistré" décrit la mise en mémoire tampon sur le module. Vérifiez la spécification du module et la prise en charge de la plate-forme.
Comment savoir si ECC fonctionne ?
Vérifiez le BIOS ou l'UEFI, l'état du matériel BMC et les interfaces d'erreur du système d'exploitation. Sous Linux, passez en revue EDAC ou rasdaemon données. Sur Windows Server, passez en revue les événements WHEA. Ne vous fiez pas uniquement à l'étiquette DIMM.
ECC remplace-t-il RAID ou sauvegardes ?
Non. ECC protège les opérations de mémoire sélectionnées. RAID résout les pannes de disque sélectionnées. Les sauvegardes prennent en charge la récupération après une suppression, une corruption, un logiciel malveillant ou une perte de système. Un serveur de production a souvent besoin des trois contrôles.
décision définitive
Utilisez la mémoire RAM ECC pour les bases de données de production, les hôtes de virtualisation, le stockage d'entreprise, les charges de travail réglementées, les travaux de calcul longs et les systèmes où des données ou des temps d'arrêt incorrects ont un coût de matériau.
La RAM non ECC peut desservir des environnements de développement jetables et des laboratoires à faible risque lorsque le propriétaire accepte le risque de mémoire supplémentaire et maintient des sauvegardes testées pour les données persistantes.
Avant de commander, confirmez que le processeur, la carte mère, le micrologiciel et les DIMM prennent en charge la correction ECC active. Vérifiez ensuite que le système d'exploitation ou le BMC peut signaler des erreurs de mémoire. Cette vérification transforme une étiquette ECC en un contrôle de fiabilité opérationnelle.
Références et sources de données
- Recherche Google, Erreurs DRAM dans la nature : une étude de terrain à grande échelle
- Documentation du noyau Linux, Error Detection and Correction Devices
- Documentation du noyau Linux, Fiabilité, disponibilité et service
- Microsoft apprend, Analyse de défaillance prédictive pour la mémoire ECC
- Technologie de Kingston, Mémoire DDR5 Aperçu standard
- synopsie, Code de correction d'erreur dans les mémoires DDR