 Ir al contenido



ECC RAM es la opción más segura para la mayoría de los servidores de producción porque puede corregir errores comunes de memoria de un solo bit antes de que una aplicación utilice los datos dañados. Las bases de datos, los hosts de virtualización, los servidores de almacenamiento, los sistemas financieros y los trabajos de computación de larga duración se benefician más. La RAM que no es ECC aún puede adaptarse a sistemas de prueba desechables, laboratorios domésticos de bajo riesgo y cargas de trabajo que se pueden reconstruir rápidamente.
La elección depende de más que el precio de los módulos de memoria. El procesador, la placa base, el firmware y el tipo DIMM deben admitir ECC como sistema completo. Los compradores también deben considerar el valor de sus datos, el costo del tiempo de inactividad, el tamaño del grupo de memoria y la cantidad de servicios que admite un servidor.
Esta guía explica cómo funciona ECC, dónde se detiene su protección y cómo decidir qué tipo de memoria se ajusta a su servidor.
La mayoría de los servidores de producción deberían usar ECC RAM
Elija ECC RAM cuando un valor incorrecto, un registro dañado, un trabajo fallido o un reinicio del servidor podrían afectar a los clientes o las operaciones comerciales. Se recomienda encarecidamente ECC para servidores de bases de datos, hosts de VM, almacenamiento de ZFS o Ceph, aplicaciones en memoria y sistemas que procesan datos valiosos.
La RAM que no es ECC puede ser aceptable cuando todo lo siguiente es cierto:
- La carga de trabajo no contiene datos autorizados o insustituibles.
- El servidor se puede reconstruir sin un costo serio.
- Una falla afecta a pocos usuarios o servicios.
- Las copias de seguridad probadas cubren cualquier dato persistente.
- El menor costo de la plataforma tiene un valor real para el proyecto.
ECC reduce una clase de riesgo de hardware. No reemplaza RAID, sumas de verificación, replicación, monitoreo o copias de seguridad.
ECC vs Non-ECC RAM de un vistazo
| Factor | RAM ECC | RAM sin ECC |
|---|---|---|
| Nombre completo | Memoria de código de corrección de errores | Memoria sin corrección de errores a nivel de sistema |
| Errores de un solo bit | Las implementaciones comunes de SECDED las corrigen | Ninguna capa ECC los corrige |
| Errores de doble bit | Las implementaciones comunes de SECEDED las detectan pero no las corrigen | No hay detección de ECC a nivel de sistema de memoria |
| Informes de errores | Puede informar eventos corregidos y no corregidos a través de firmware, un controlador de administración de zócalo o el sistema operativo | Por lo general, no proporciona telemetría de corrección equivalente |
| integridad de los datos | Reduce el riesgo de corrupción de memoria no detectada | Deja las aplicaciones expuestas a valores de memoria corruptos |
| Soporte de plataforma | Requiere soporte del procesador, controlador de memoria, placa base y firmware | Apoyado por la mayoría de las plataformas de consumidores |
| Opciones de módulo | Puede usar ECC UDIMM, RDIMM o LRDIMM, sujeto a las reglas de la plataforma | Comúnmente utiliza DIMM sin búfer en sistemas de clase de escritorio |
| Escala de capacidad | Las plataformas de servidores a menudo admiten grupos de memoria más grandes a través de RDIMM o LRDIMM | Las plataformas de consumidores suelen soportar capacidades máximas más bajas |
| Rendimiento | Depende de la velocidad de la memoria, los tiempos, los canales, los rangos, la población y la carga de trabajo | Puede ofrecer altas tasas de reloj y amplias opciones de ajuste en los sistemas de consumo |
| Costo | Puede requerir una plataforma de clase de servidor, así como diferentes DIMM | Por lo general, reduce el costo inicial del hardware |
| uso común | Servidores de producción, bases de datos, virtualización, almacenamiento, investigación y sistemas comerciales | PCs de consumo, sistemas de juegos, laboratorios desechables y máquinas de prueba de bajo riesgo |
Por qué los errores de memoria son importantes en un servidor
RAM contiene instrucciones y datos activos para el sistema operativo y cada aplicación en ejecución. Un error de memoria puede cambiar uno o más bits mientras esa información está en uso. El resultado depende de lo que representan los bits afectados.
Un valor dañado puede hacer que una aplicación se detenga. Podría desencadenar un pánico del kernel o un reinicio inesperado. También puede permanecer oculto. El servidor puede continuar trabajando con un valor incorrecto y luego escribir ese valor en una base de datos, archivo, réplica o copia de seguridad.
Ese último caso es la corrupción silenciosa de datos. Un bloqueo visible crea un evento que los administradores pueden investigar. La corrupción silenciosa puede pasar a través del procesamiento normal y aparecer mucho más tarde como un índice dañado, un cálculo no válido, un archivo alterado o una transacción inconsistente.
Errores suaves y errores duros
Las fallas de memoria generalmente se dividen en dos grupos amplios.
errores suaves son temporales. El ruido eléctrico, los cambios de voltaje, la radiación, la temperatura u otro evento corto pueden cambiar un bit almacenado sin causar daño permanente a la celda de memoria. La misma ubicación puede funcionar normalmente después del evento.
Errores duros provienen de un problema de hardware repetible. Una celda dañada, un chip defectuoso, una conexión defectuosa o un componente de envejecimiento pueden causar errores en la misma ubicación o en el mismo DIMM. Los recuentos de errores corregidos a menudo ayudan a los operadores a encontrar estas fallas en desarrollo antes de que el sistema registre un evento incorregible.
Un gran estudio de la flota de Google publicado en 2009 encontró que los errores de DRAM eran más comunes que las anteriores estimaciones de laboratorio y que los errores rígidos jugaron un papel importante. El estudio examinó las generaciones de memoria más antiguas y una flota de servidores específica, por lo que sus cifras no deben usarse como un pronóstico de falla actual para un servidor moderno. Su lección duradera es más simple: los errores de memoria ocurren en los sistemas de producción real y el informe de errores tiene valor operativo.
La exposición al servidor cambia el riesgo
Un escritorio utilizado durante unas pocas horas al día y un servidor con cientos de gigabytes de RAM funcionando durante todo el año no tienen la misma exposición. Varios factores aumentan el costo práctico de una falla de memoria:
- Más memoria instalada Crea más ubicaciones donde se puede producir una falla.
- La operación continua aumenta el tiempo de exposición.
- La alta utilización mantiene más datos activos en la memoria.
- Un host de virtualización puede pasar una falla de hardware a muchos sistemas invitados.
- Una base de datos puede escribir un valor en memoria incorrecto en el almacenamiento persistente.
- Un trabajo de cómputo largo puede desperdiciar horas o días antes de que alguien encuentre un mal resultado.
- Un servicio de producción compartido puede afectar a muchos clientes a la vez.
Esto no significa que todos los servidores grandes sufrirán corrupción de memoria. Significa que el posible impacto crece a medida que el sistema lleva más datos, más cargas de trabajo y más responsabilidad comercial.
Cómo funciona la RAM ECC
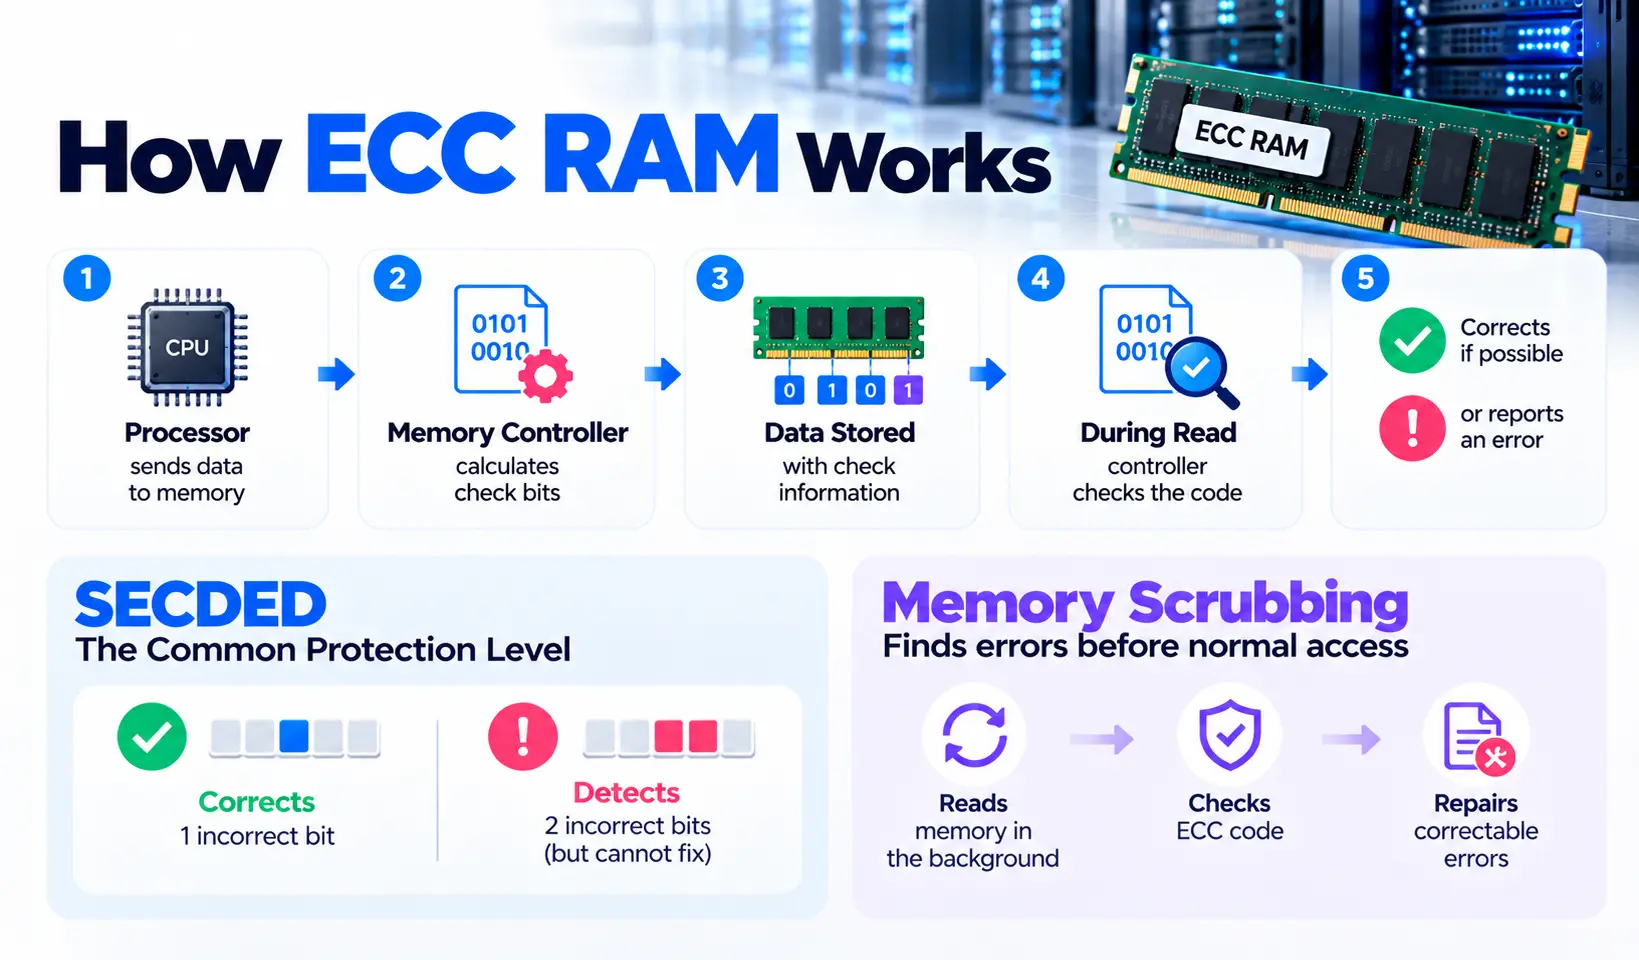
La memoria ECC almacena información de cheques adicional con cada unidad de datos protegida. Cuando el sistema escribe datos en la memoria, el controlador de memoria calcula un código a partir de los bits de datos. Almacena ese código con los datos. Cuando el sistema lee los datos, el controlador vuelve a calcular el código y compara el resultado.
Si los valores coinciden, la lectura continúa. Si no coinciden, el patrón puede identificar ciertos errores. El sistema puede corregir los datos antes de que el procesador los use, registrar el evento o detener el sistema cuando no sea posible una corrección segura.
El flujo básico es:
- El procesador envía datos a la memoria.
- El controlador de memoria calcula los bits de control.
- El módulo almacena los datos y la información de verificación.
- El controlador verifica el código durante una lectura posterior.
- El sistema corrige un error admitido o informa de un evento incorregible.
SECDED Explica el nivel de protección común
Muchas plataformas de servidor utilizan la corrección de un solo error, detección de doble error, conocida como SECDED. En su forma común, SECDED puede corregir un bit incorrecto en una palabra de memoria protegida. Puede detectar dos bits incorrectos en esa palabra, pero no puede reconstruir el valor original con certeza.
La diferencia entre la detección y la corrección importa. Un evento de un solo bit corregido puede permitir que el servicio continúe. Un evento de doble bit detectado puede provocar una comprobación de la máquina, la jubilación de la página, la falla del proceso o la parada del sistema, según el hardware y el sistema operativo.
Por lo tanto, ECC no es una promesa de que cada falla de memoria pueda ser reparada. Es un mecanismo de protección definido con límites de corrección y detección.
El lavado de memoria encuentra errores antes del acceso normal
Un error de memoria puede permanecer en una ubicación no utilizada hasta que el software lea esa dirección. El lavado de memoria reduce este riesgo al leer la memoria en segundo plano, verificar el código ECC y volver a escribir datos corregidos cuando la plataforma admite esa acción.
Los proveedores de servidores pueden llamar a este patrullero, exfoliante de fondo, exfoliante de demanda u otro nombre específico de la plataforma. El controlador de gestión de zócalo, a menudo llamado BMC, también puede registrar qué DIMM, canal, rango o dirección produjo un evento.
El fregado ayuda de dos maneras. Puede reparar un error corregible antes de que cambie otro bit en la misma palabra protegida. También produce evidencia que los administradores pueden usar para programar el mantenimiento.
La protección avanzada del servidor puede ir más allá
Algunas plataformas de servidores proporcionan características de fiabilidad, disponibilidad y capacidad de servicio. Estos pueden incluir chipkill, corrección de datos de un solo dispositivo, duplicación de memoria, rangos de reserva, desvinculación de páginas y jubilación de dispositivos de memoria.
El comportamiento exacto depende del procesador, el controlador de memoria, el diseño de DIMM, el firmware y el modelo de servidor. Una etiqueta genérica "compatible con ECC" no prueba que todas las funciones avanzadas estén presentes.
¿Qué sucede con la RAM no ECC?
La RAM que no es ECC almacena y devuelve datos sin el mismo proceso de corrección a nivel de sistema. Si cambia un bit, el procesador puede recibir el valor cambiado como si fuera correcto.
Son posibles varios resultados:
- El valor afectado nunca se utiliza.
- Una aplicación produce un resultado incorrecto.
- Un proceso se detiene con un error.
- El sistema operativo falla.
- Un archivo, una página de base de datos, un archivo o una copia de seguridad recibe datos dañados.
- Un valor sensible a la seguridad, como un indicador de permiso, cambia.
- El servidor se comporta de manera impredecible y la falla es difícil de reproducir.
La memoria no ECC no es una memoria defectuosa. La mayoría de las computadoras de consumo funcionan con él con éxito. La diferencia es la respuesta del sistema cuando se produce una falla de memoria. Un servidor de producción a menudo necesita un manejo más sólido porque el impacto es mayor y la carga de trabajo se ejecuta durante períodos más largos.
ECC vs Non-ECC RAM: principales diferencias de servidor
Integridad y disponibilidad de los datos
ECC puede corregir eventos comunes de un solo bit antes de que la aplicación vea los datos modificados. También puede convertir algunas fallas ocultas en eventos de hardware registrados. Ese informe brinda a los operadores la oportunidad de localizar un DIMM defectuoso y reemplazarlo durante el mantenimiento planificado.
Los sistemas que no son de ECC generalmente carecen de esta ruta de corrección y de informes. Un error de hardware puede aparecer primero como un problema de aplicación, una salida incorrecta o un bloqueo inexplicable. La resolución de problemas puede llevar más tiempo porque el equipo de software tiene poca evidencia de que la memoria causó el evento.
Rendimiento
La memoria ECC a menudo se describe como más lenta, pero la etiqueta ECC por sí sola no predice el rendimiento de la aplicación. Varios factores pueden tener un efecto mayor:
- Tasa de generación y transferencia de memoria
- Horarios primarios y secundarios
- Número de canales de memoria activa
- Número de DIMM por canal
- Disposición de rango
- Diseño de controlador de memoria de CPU
- Colocación NUMA en servidores multisocket
- Comportamiento RDIMM o LRDIMM
- Patrón de acceso a la carga de trabajo
Una comparación justa requiere procesadores emparejados, igual capacidad, población de canales equivalente, velocidades de memoria alineadas, el mismo firmware y la misma carga de trabajo. Una plataforma de consumidores con memoria sintonizada no ECC y una plataforma de servidor con RDIMM difieren en muchos aspectos. Un punto de referencia entre ellos no puede asignar la diferencia completa a la comprobación de ECC.
Para la mayoría de los compradores de producción, la capacidad, el equilibrio del canal y el ajuste de la carga de trabajo importan más que un pequeño costo teórico de ECC. Use pruebas medidas desde la plataforma exacta cuando la latencia o el ancho de banda puedan afectar a un objetivo de servicio.
Costo y costo total de propiedad
La decisión ECC incluye más del precio DIMM. Un procesador con capacidad ECC, una placa base, un chasis de servidor, un sistema de administración remota y una clase de módulo compatible pueden cambiar el costo inicial.
El otro lado del cálculo incluye:
- Tiempo de inactividad y transacciones perdidas
- Datos dañados o cuestionables
- Trabajos de cálculo fallidos
- Tiempo de ingeniero dedicado a rastrear fallas aleatorias
- mantenimiento de emergencia
- Impacto del cliente
- Trabajos de recuperación y verificación
Un modelo de decisión básico es:
Costo esperado de falla de memoria = Probabilidad de incidente estimada × Impacto comercial
Esta fórmula es una ayuda de planificación. No es un pronóstico medido. Si un mal resultado o una falla del host podría costar más que la diferencia de la plataforma, ECC suele ser la opción de sonido.
Capacidad y escalado
Los servidores grandes a menudo usan DIMM registrados o DIMM de carga. Señales de comando y dirección del búfer rdimms. Los LRDIMM reducen aún más la carga eléctrica. Estos diseños pueden soportar más módulos y mayores capacidades totales en plataformas compatibles.
ECC y la memoria registrada describen diferentes propiedades:
- CE Describe la detección y corrección de errores.
- udimm Describe un módulo sin búfer.
- exigencia Describe un módulo con señales de comando y dirección registradas.
- dinero Describe un módulo diseñado para reducir aún más la carga eléctrica.
Un ECC UDIMM es a la vez no búfer y correctivo de errores. Un RDIMM de servidor comúnmente incluye ECC, pero "registrado" y "ECC" no debe usarse como términos intercambiables.
Compatibilidad
Un módulo ECC no puede crear soporte ECC por sí mismo. Las siguientes partes deben estar de acuerdo:
- Procesador y controlador de memoria integrado
- Motherboard y chipset
- Firmware BIOS o UEFI
- Generación DDR
- Clase de módulo, como ECC UDIMM, RDIMM o LRDIMM
- Capacidad admitida y diseño de rango
- Velocidad y voltaje de la memoria
- Patrón de población de ranuras
Algunas placas base aceptan ECC UDIMM pero las operan sin corrección. Otros sistemas se niegan a arrancar con un módulo no compatible. Los RDIMM DDR4 pueden ajustarse físicamente a un zócalo DDR4 UDIMM pero permanecen eléctricamente incompatibles. DDR5 utiliza diferencias de clave adicionales en algunas clases de módulos.
Compruebe siempre la lista de memoria manual y calificada para el modelo de servidor exacto. El ajuste físico no es una prueba de soporte funcional.
ddr5 en-die ECC no es el servidor ECC
DDR5 introdujo ECC en el troquel dentro de cada chip DRAM. La función corrige ciertos errores de celda internos antes de que los datos dejen el chip. Ayuda a los fabricantes a administrar diseños de memoria más densos y una geometría de proceso más pequeña.
On-Die ECC no proporciona la misma protección que un subsistema de memoria ECC de servidor. No protege todos los errores que puedan ocurrir entre el chip DRAM, el módulo, el bus de memoria, el controlador de memoria y el procesador. También carece de la misma ruta de informes a nivel de host utilizada para la supervisión de errores del servidor.
Esta distinción crea un error de compra común. Un módulo DDR5 estándar para el consumidor puede contener ECC en el troquel mientras se vende y funciona como memoria del sistema que no es de ECC.
Para el ECC completo del servidor, busque todos estos elementos:
- Un procesador y controlador de memoria con capacidad ECC
- Una placa base y firmware que permiten la corrección
- Un ECC UDIMM, RDIMM o LRDIMM compatibles explícitamente
- Evidencia de firmware o sistema operativo de que ECC está activo
- Contadores de errores o registros de hardware que los administradores pueden monitorear
Kingston describe DDR5 en el ECC de troquel como protección dentro del chip DRAM y afirma que no corrige errores fuera del chip o del bus. Synopsys también separa el ECC en el troquel de la ECC de banda lateral que se utiliza para una protección de memoria de servidor más amplia.
¿Su servidor necesita RAM ECC?
La carga de trabajo decide cuánto riesgo de memoria puede aceptar un servidor.
Bases de datos de producción y sistemas de transacciones
Producción database servers Debería usar ECC RAM. Las bases de datos contienen páginas de datos, índices, resultados de consulta, registros de transacciones y cachés en la memoria. Un valor modificado puede producir un resultado incorrecto o alcanzar un almacenamiento persistente durante una escritura.
Las sumas de verificación de la base de datos y los controles de transacciones siguen siendo útiles, pero no cubren todos los puntos en los que la memoria dañada puede afectar el procesamiento. ECC agrega protección antes de que el motor de base de datos utilice el valor.
Hosts de virtualización y plataformas de contenedores
Un host de virtualización debe usar ECC porque una falla de hardware puede afectar a muchos sistemas invitados. El host puede ejecutar bases de datos, aplicaciones web, paneles de control, firewalls y servicios al cliente en el mismo grupo de memoria.
Por lo tanto, el impacto comercial es mayor que el fallo de un servidor de aplicación desechable. Los informes de ECC también ayudan a los administradores a distinguir un problema de hardware del host de los problemas de software de los huéspedes separados.
La misma lógica se aplica a Proxmox VE, VMware ESXi, Hyper-V, KVM y otras plataformas de computación compartidas.
Servidores ZFS, Ceph, NAS y almacenamiento
ZFS no requiere ECC RAM como una condición de software estricta. Muchos sistemas domésticos ejecutan ZFS con memoria no ECC. ECC sigue siendo la opción preferida cuando el servidor de almacenamiento contiene datos valiosos o difíciles de recrear.
Las sumas de comprobación de ZFS pueden detectar y reparar muchos errores de ruta de almacenamiento cuando hay datos redundantes disponibles. ECC aborda un punto diferente en la ruta. Si la memoria cambia los datos antes de calcular una nueva suma de verificación, la pila de almacenamiento puede aceptar y almacenar el valor modificado con una suma de verificación coincidente.
Ceph, Software RAID, Hardware RAID y Sistemas de archivos ordinarios tienen el mismo límite general. La protección de almacenamiento no puede corregir todos los errores que se inician en la memoria RAM del sistema.
AI, Machine Learning, HPC y cargas de trabajo científicas
ECC se adapta a trabajos de cómputo largos y resultados sensibles a la precisión. Una ejecución de entrenamiento, simulación, trabajo de renderizado o tarea de análisis puede tener un gran conjunto de trabajo en la memoria durante muchas horas. Un valor intermedio dañado puede afectar los cálculos posteriores o forzar una repetición costosa.
La memoria del sistema de la CPU y la memoria GPU son áreas separadas. Un servidor con ECC System RAM todavía puede usar una GPU sin protección ECC. Los compradores deben verificar ambas especificaciones cuando la ruta completa de cálculo necesita una corrección de errores.
Sistemas financieros, sanitarios y regulados
Los sistemas que procesan pagos, registros financieros, información de salud o datos comerciales regulados deben utilizar ECC como parte de un plan de integridad más amplio. El plan también debe incluir control de acceso, registro, protección de almacenamiento, copias de seguridad, pruebas de recuperación y gestión de cambios.
ECC por sí solo no crea el cumplimiento normativo. Reduce un riesgo de hardware específico que puede afectar la precisión de los datos y la disponibilidad del servicio.
Servidores web, SaaS, juegos y streaming
La respuesta depende de la función del servidor.
ECC es la opción más fuerte cuando el sistema almacena cuentas de usuario, registros de facturación, estado de la aplicación, permisos, inventarios de juegos u otros datos autorizados. También tiene sentido cuando una máquina sirve a muchos usuarios o lleva varios servicios virtuales.
Un caché de borde reemplazable, un trabajador de transcodificación temporal, una instancia de prueba de juego desechable o un nodo web de desarrollo pueden aceptar más riesgos. El factor decisivo es si la carga de trabajo puede recuperarse limpiamente sin perder datos ni causar una larga interrupción.
Laboratorios domésticos y servidores de desarrollo
La RAM que no es ECC puede ser razonable para un laboratorio doméstico creado para el aprendizaje, las pruebas, la reproducción de medios o las máquinas virtuales de corta duración. El hardware de consumo de menor costo puede permitir al propietario comprar más capacidad o un procesador más rápido.
ECC se vuelve más valioso cuando esa misma máquina almacena fotos familiares, archivos comerciales, contraseñas, copias de seguridad o servicios domésticos que deben permanecer disponibles. Una etiqueta de "lab" no hace que los datos irremplazables sean menos valiosos.
Cinco preguntas que deciden si necesita ECC
Utilice estas preguntas antes de elegir un servidor:
- ¿Sería peor un valor incorrecto que un choque visible? ECC puede evitar que las fallas comunes de un solo bit se conviertan en errores ocultos.
- ¿El servidor contiene datos autorizados o difíciles de recrear? Los registros de la base de datos, los datos de los clientes, los resultados de la investigación y los archivos originales favorecen a ECC.
- ¿Se ejecutará el servidor continuamente con un gran grupo de memorias? Mayor capacidad y mayor tiempo de ejecución aumentan la exposición.
- ¿Podría una falla del host afectar muchas cargas de trabajo? Los hosts de VM y los sistemas de almacenamiento compartido tienen un alto impacto de falla.
- ¿La recuperación costaría más que la plataforma con capacidad ECC? Incluya el tiempo de inactividad, el tiempo del personal, el trabajo perdido y el impacto del cliente.
| Perfil de carga de trabajo | Impacto de error | Costo de recuperación | Elección recomendada |
|---|---|---|---|
| Base de datos de producción o sistema de pago | Alto | Alto | CE |
| Host de virtualización con muchos invitados | Alto | Alto | CE |
| Almacenamiento comercial NAS o ZFS | Alto | De medio a alto | CE |
| Trabajo científico largo o de IA | De medio a alto | Alto | CE |
| Web de producción o servidor SaaS | De medio a alto | De medio a alto | CE |
| Caché reemplazable o nodo de trabajador | Bajo a medio | Bajo | Depende del diseño de la flota |
| Servidor de desarrollo desechable | Bajo | Bajo | No-ECC puede ser aceptable |
| Laboratorio doméstico sin datos únicos | Bajo | Bajo | No-ECC puede ser aceptable |
Verifique la compatibilidad de ECC antes de realizar el pedido
La palabra "ECC" en una lista de DIMM es solo el primer cheque.
Confirmar soporte de procesador
Lea la especificación para el modelo de procesador exacto. No confíes solo en un apellido. El soporte puede diferir entre generaciones, modelos, conjuntos de chips y segmentos de mercado.
Los procesadores de servidor como Intel Xeon y AMD EPYC suelen admitir ECC, pero la clase de módulo compatible y la capacidad máxima pueden variar. Algunas estaciones de trabajo y procesadores de escritorio también son compatibles con ECC en condiciones específicas de la placa base.
Confirme la compatibilidad con la placa base y el firmware
Lea el manual del servidor y la lista de memoria calificada. Compruebe si la placa permite la corrección real o simplemente acepta un módulo con capacidad ECC en modo no ECC.
Revise la configuración de BIOS o UEFI para ECC, memoria RAS, patrullaje, rangos de repuesto, duplicación o inyección de errores. Los ajustes disponibles varían según la plataforma.
Coincidir con la clase DIMM
Identifique el tipo de módulo requerido antes de la compra:
- ECC UDIMM
- exigencia
- dinero
- DDR4 o DDR5
- Velocidad soportada
- Recuento de rangos compatible
- Capacidad máxima por ranura
No mezcle UDIMM con RDIMM. No asuma que RDIMM y LRDIMM pueden operar juntos. Siga las reglas de población del proveedor del servidor al llenar los canales de memoria.
Un diseño de canal equilibrado a menudo proporciona un mejor ancho de banda y un comportamiento más predecible que un arreglo desigual. Poblar más DIMM por canal también puede reducir la tasa de transferencia admitida.
Haga preguntas directas al proveedor de alojamiento
Antes de pedir un servidor dedicado, pregunte:
- ¿Esta configuración exacta utiliza memoria ECC?
- ¿Está habilitada la corrección ECC en el firmware?
- ¿El sistema utiliza ECC UDIMM, RDIMM o LRDIMM?
- ¿Qué tasa de generación y transferencia de DDR están instaladas?
- ¿Puede el BMC informar errores de memoria corregidos y no corregidos?
- ¿El proveedor monitorea los errores corregidos repetidos?
- ¿Cuál es el proceso de reemplazo de DIMM?
- ¿Puede aumentar la capacidad de la RAM sin cambiar la clase del módulo o reducir el equilibrio del canal?
Las respuestas claras impiden que un comprador pague por un sistema "compatible con ECC" que no utiliza la corrección activa.
Cómo confirmar que ECC está activo y monitorear los errores
Los módulos ECC instalados no prueban que el sistema completo funcione en modo ECC. Compruebe más de una fuente cuando sea posible.
BIOS, UEFI y BMC
Comience con el firmware del servidor o la interfaz de administración remota. buscar:
- ECC habilitado o estado activo
- Recuento de errores corregido
- Recuento de errores no corregido
- Salud DIMM por ranura
- Salud del canal de memoria
- Configuración de patrullaje
- Entradas de registro de eventos del sistema
Dell iDRAC, HPE iLO, interfaces IPMI y otras plataformas BMC pueden exponer esta información. Los nombres de menú exactos dependen de la generación del servidor.
Linux
Linux proporciona el subsistema de detección y corrección de errores, conocido como EDAC. Dependiendo de la distribución y el hardware, los administradores pueden revisar la información del firmware, los mensajes del kernel, los contadores EDAC y los eventos RAS.
Las herramientas útiles pueden incluir:
sudo dmidecode --type memory
sudo dmesg | grep -i -E 'edac|ecc|mce|memory error'
sudo ras-mc-ctl --status
sudo ras-mc-ctl --errors
Código DMIDE Informes de información suministrada a través de SMBIOS. Una etiqueta como "ECC de un solo bit" ayuda, pero los datos de firmware pueden estar incompletos. Emparejarlo con el estado de BMC, la salida EDAC del kernel o Rasdamonio Registros.
La documentación del kernel de Linux identifica errores corregibles y errores incorregibles como eventos de memoria principal recopilados a través de EDAC. Los eventos corregibles no significan que los datos de la aplicación se hayan dañado, pero los eventos repetidos pueden indicar un problema de hardware en desarrollo.
Windows Server
Arquitectura de error de hardware de Windows, o WHEA, registra la información de error de hardware en el visor de eventos. Los sistemas compatibles pueden informar eventos de memoria corregidos y eventos de verificación de máquina fatal.
Microsoft también documenta el análisis de fallas predictivas para la memoria ECC. En el hardware compatible, WHEA puede rastrear errores repetidos en las páginas de memoria y desconectar una página después de un umbral configurado.
Compruebe el registro del sistema de Windows para los eventos de WHEA. Luego compare el evento con el registro de BMC y las herramientas de diagnóstico del proveedor del servidor.
hipervisores
Para VMware ESXi, Proxmox VE y Hyper-V, compruebe el host físico. Por lo general, una máquina virtual invitada no puede ver los datos completos de DIMM Health.
Utilice el BMC, los registros del kernel de host, el servicio de salud de hardware y las herramientas de administración de proveedores. Asigne la ranura o el canal informado al módulo físico antes de reemplazarlo.
Responder a errores corregidos
Un evento corregido no siempre requiere reemplazo inmediato. Un recuento ascendente, errores repetidos en la misma dirección o errores vinculados a un DIMM necesita investigación.
Registro:
- Modelo de servidor y versión de firmware
- Ranura y canal DIMM
- Número de pieza del módulo
- Recuentos corregidos y no corregidos
- Marcas de tiempo de error
- Eventos de temperatura y potencia
- Condiciones de carga de trabajo
- Cambios de hardware recientes
Siga los umbrales de mantenimiento del proveedor del servidor. Vuelva a colocar o reemplace el hardware solo bajo un proceso de mantenimiento aprobado. Continúe observando los contadores después del cambio.
ECC no reemplaza RAID, sumas de verificación o copias de seguridad
La confiabilidad del servidor necesita varios controles porque cada uno maneja un tipo de falla diferente.
| capa de protección | trabajo principal | lo que no cubre |
|---|---|---|
| RAM ECC | Corrige o detecta errores de memoria especificados | Archivos eliminados, unidades fallidas, errores de la aplicación o pérdida completa del servidor |
| Sumas de verificación del sistema de archivos o de la aplicación | Detecta los cambios seleccionados en los datos almacenados o transmitidos | Cada error que ocurre antes de que se cree la suma de comprobación |
| Incursión | Mantiene un conjunto de almacenamiento en funcionamiento después de fallas de unidad seleccionadas | Eliminación accidental, toda corrupción, malware o recuperación ante desastres |
| Replicación | Mantiene otra copia de datos o servicio | Malas escrituras, errores de operador o fallos copiados a la réplica |
| instantáneas | Mantiene estados puntuales | Recuperación independiente después de la pérdida del mismo sistema de almacenamiento |
| respaldo | Restaura los datos después de la pérdida o la corrupción | Continuidad inmediata y recuperación garantizada sin pruebas de restauración |
Un diseño de producción puede combinar ECC, fregado de memoria, sumas de verificación de almacenamiento, RAID, replicación, copias de seguridad fuera del servidor, monitoreo y pruebas de restauración. Estos controles funcionan juntos porque ninguna capa cubre cada ruta de falla.
Elegir un servidor Atal Networks con la memoria correcta
En Atal Networks, recomendamos seleccionar primero la protección de la memoria y la capacidad del riesgo de carga de trabajo. Una base de datos, un host de virtualización o un servidor de almacenamiento empresarial generalmente necesita ECC y una plataforma que informe el estado de la memoria. Un nodo de desarrollo temporal puede dar más valor al menor costo inicial.
Revise nuestro Especificaciones del servidor de metal desnudo Para dimensionar el procesador, la RAM, el almacenamiento y la red juntos. Nuestro Guía de CPU del servidor También puede ayudarlo a hacer coincidir la clase de procesador con la capacidad de memoria y las necesidades de carga de trabajo.
Confirme el estado exacto de ECC, la clase DIMM, la capacidad, el diseño del canal y la ruta de actualización para la configuración seleccionada. Si está planeando una base de datos, un clúster de almacenamiento, un entorno virtualizado o una aplicación de alta memoria, analice los requisitos con nuestro equipo de infraestructura antes de la implementación.
Preguntas frecuentes
¿Puede ECC RAM corregir cada error de memoria?
No. La memoria seccionada común corrige un error de un solo bit y detecta un error de doble bit dentro de una palabra protegida. No puede corregir todos los fallos de varios bits, direcciones, bus, controlador o dispositivo. Algunas plataformas de servidor agregan chipkill, SDDC, duplicación de memoria o espacio para una protección más amplia.
¿Puede funcionar ECC RAM en una placa base que no es de ECC?
Depende del módulo y de la plataforma. Algunas placas base no arrancan. Algunos aceptan un ECC UDIMM pero lo usan sin corrección activa. Compruebe la especificación del procesador, el manual de la placa base, el soporte de firmware y la lista de memoria calificada.
¿Puedo mezclar ECC y RAM no ECC?
Evite mezclarlos. Muchos sistemas rechazan configuraciones mixtas o deshabilitan la corrección. Los proveedores de servidores también restringen la mezcla de UDIMM, RDIMM y LRDIMM. Utilice una clase de módulo compatible y siga las reglas de población documentadas.
¿Es ECC RAM más lento que la RAM que no es ECCC?
La verificación de ECC puede agregar algo de trabajo, pero el rendimiento de la aplicación depende de la plataforma de memoria completa. La velocidad, los tiempos, el conteo de canales, los rangos, la población de módulos, el diseño del procesador y el comportamiento de la carga de trabajo pueden importar más. Utilice pruebas de sistema coincidentes para una respuesta numérica.
¿DDR5 tiene ECC incorporado?
DDR5 DRAM incluye ECC en el troquel que protege ciertas fallas dentro de cada chip de memoria. El DDR5 estándar del consumidor todavía no es ECC a nivel del sistema. El servidor completo ECC necesita un procesador, placa base, firmware y módulo ECC compatible.
¿ZFS requiere RAM ECC?
No. ZFS puede operar sin ECC. Todavía se recomienda ECC cuando el servidor contiene datos valiosos porque protege contra errores de memoria seleccionados que las sumas de verificación de almacenamiento no pueden evitar en cada etapa.
¿Un servidor doméstico necesita RAM ECC?
Un laboratorio doméstico desechable puede utilizar memoria no ECC. Un servidor doméstico que almacena fotos originales, archivos comerciales, credenciales o copias de seguridad se beneficia de ECC. Base la elección en el valor de los datos y el costo de recuperación en lugar de la etiqueta "Servidor doméstico".
¿La RAM registrada siempre es ECC?
La señalización registrada y ECC son propiedades separadas. Los RDIMM de servidor comúnmente proporcionan ECC, pero "registrado" describe el almacenamiento en búfer en el módulo. Verifique tanto la especificación del módulo como la compatibilidad con la plataforma.
¿Cómo puedo saber si ECC está funcionando?
Compruebe el BIOS o UEFI, el estado del hardware de BMC y las interfaces de error del sistema operativo. En Linux, revise EDAC o Rasdamonio datos En Windows Server, revise los eventos WHEA. No confíe solo en la etiqueta DIMM.
¿ECC reemplaza RAID o copias de seguridad?
No. ECC protege las operaciones de memoria seleccionadas. Direcciones RAID Fallas de unidad seleccionadas. Las copias de seguridad admiten la recuperación después de la eliminación, la corrupción, el malware o la pérdida del sistema. Un servidor de producción a menudo necesita los tres controles.
decisión final
Utilice ECC RAM para bases de datos de producción, hosts de virtualización, almacenamiento empresarial, cargas de trabajo reguladas, trabajos de cómputo largos y sistemas donde los datos o el tiempo de inactividad incorrectos tienen un costo material.
La RAM que no es ECC puede atender entornos de desarrollo desechables y laboratorios domésticos de bajo riesgo cuando el propietario acepta el riesgo de memoria añadido y mantiene copias de seguridad comprobadas de datos persistentes.
Antes de realizar el pedido, confirme que el procesador, la placa base, el firmware y los DIMM admiten la corrección de ECC activa. A continuación, confirme que el sistema operativo o BMC puede informar errores de memoria. Esa verificación convierte una etiqueta ECC en un control de confiabilidad operativa.
Referencias y fuentes de datos
- investigación de google, Errores DRAM en la naturaleza: un estudio de campo a gran escala
- Documentación del kernel de Linux, Dispositivos de detección y corrección de errores
- Documentación del kernel de Linux, Fiabilidad, disponibilidad y capacidad de servicio
- Microsoft aprende, Análisis de falla predictiva para la memoria ECC
- Tecnología Kingston, Descripción general del estándar de memoria DDR5
- sinopsis, Código de corrección de errores en memorias DDR
