 Zum Inhalt springen



Ein Cyberangriff wartet nicht darauf, dass Sie bereit sind. Es trifft schnell, breitet sich schnell und kostet schnell. IBMs 2024 Kosten für einen Datenverstoßbericht Es wurde festgestellt, dass Organisationen mit einem formellen Reaktionsplan und einem geschulten Team durchschnittlich 1 TP4T473.706 pro Verstoß im Vergleich zu denen ohne einen sparten.
Diese Lücke ist kein Zufall. Dies ist das Ergebnis von klaren Reaktionsverfahren für Vorfälle, bevor der Verstoß stattfindet - nicht zu erfinden, während die Systeme brennen.
Dieser Leitfaden deckt alles ab: Welche Vorfallsreaktionsverfahren tatsächlich sind, die aktualisierten NIST SP 800-61 Rev 3 Framework veröffentlicht im April 2025, eine schrittweise Aufschlüsselung aller sechs Phasen und etwas, das kein anderer Leitfaden behandelt. Dies sollte Ihr Hosting-Infrastrukturanbieter in dem Moment tun, in dem ein Vorfall bestätigt wird.
Wenn Sie Ihr Unternehmen auf einem VPS, einem dedizierten Server oder einem Bare-Metal-Server betreiben, ist die Infrastrukturebene Teil Ihrer Incident Response. Dieser Leitfaden behandelt es so.
Inhaltsverzeichnis
- Was ist ein Vorfallreaktionsverfahren?
- NIST SP 800-61 Rev 3: Was sich im April 2025 geändert hat
- NIST vs Sans: Auswahl des richtigen Frameworks
- Die 6 Phasen der Einfallsreaktion
- Was Ihr Hosting-Anbieter während eines Vorfalls tun sollte
- Aufbau Ihres Incident-Response-Teams (CSIRT)
- IR-Verfahren für gängige Angriffstypen
- Vorfallreaktion und Einhaltung
- Checkliste für die Reaktion auf Vorfälle
- Häufig gestellte Fragen
Was ist ein Vorfallreaktionsverfahren?
Ein Vorfall-Response-Verfahren ist eine dokumentierte, schrittweise Reihe von Aktionen, die Ihr Team bei einem Sicherheitsvorfall durchführt. Es sagt den Menschen genau, wer was, in welcher Reihenfolge und mit welcher Autorität tut.
Drei Begriffe werden ständig verwirrt. Hier der Unterschied:
| Begriff | Was ist es |
| IR-Rahmen | Das strategische Modell. NIST und SANS veröffentlichen beide diese. Es ist die „Konstitution“ - Prinzipien und Phasen auf hoher Ebene. |
| Incident Response Plan (IRP) | Das taktische Dokument für Ihre Organisation. Es nennt Ihr Team, Ihre Tools, Ihre Kommunikationswege und Ihre Eskalationsschwellen. |
| IR-Spielbuch | Das operative Skript für einen bestimmten Angriffstyp. Eine für Ransomware, eine für DDoS, eine für Datenverletzung. In dem Moment, in dem dieser Vorfall bestätigt wurde, aus dem Regal gezogen. |
Die meisten Organisationen haben einen Plan. Weit weniger haben Spielbücher. Fast keiner hat sie getestet.
Was zählt als Sicherheitsvorfall?
NIST SP 800-61 Rev 3 definiert einen Cybersicherheitsvorfall als Verletzung oder eine unmittelbare Androhung von Verletzungen, von Computersicherheitsrichtlinien, Richtlinien für akzeptable Nutzung oder Standardsicherheitspraktiken.
In der Praxis umfasst dies:
- Ransomware oder Malware-Infektion
- Unbefugter Zugriff auf Systeme oder Daten
- Datenexfiltration (bestätigt oder vermutet)
- DDoS-Angriffe stören die Verfügbarkeit des Dienstes
- Insider-Bedrohungsaktivität
- Phishing-Angriffe, die zu einem Kompromiss für Anmeldeinformationen führen
- Kompromisse der Lieferkette
- Denial-of-Service auf der Netzwerk- oder Anwendungsschicht
Nicht jeder Alarm ist ein Vorfall. Ein Teil eines starken IR-Verfahrens ist der Triage-Prozess, der falsche positive Ergebnisse von echten Sicherheitsereignissen trennt, die eine Antwort erfordern.
NIST SP 800-61 Rev 3: Was sich im April 2025 geändert hat
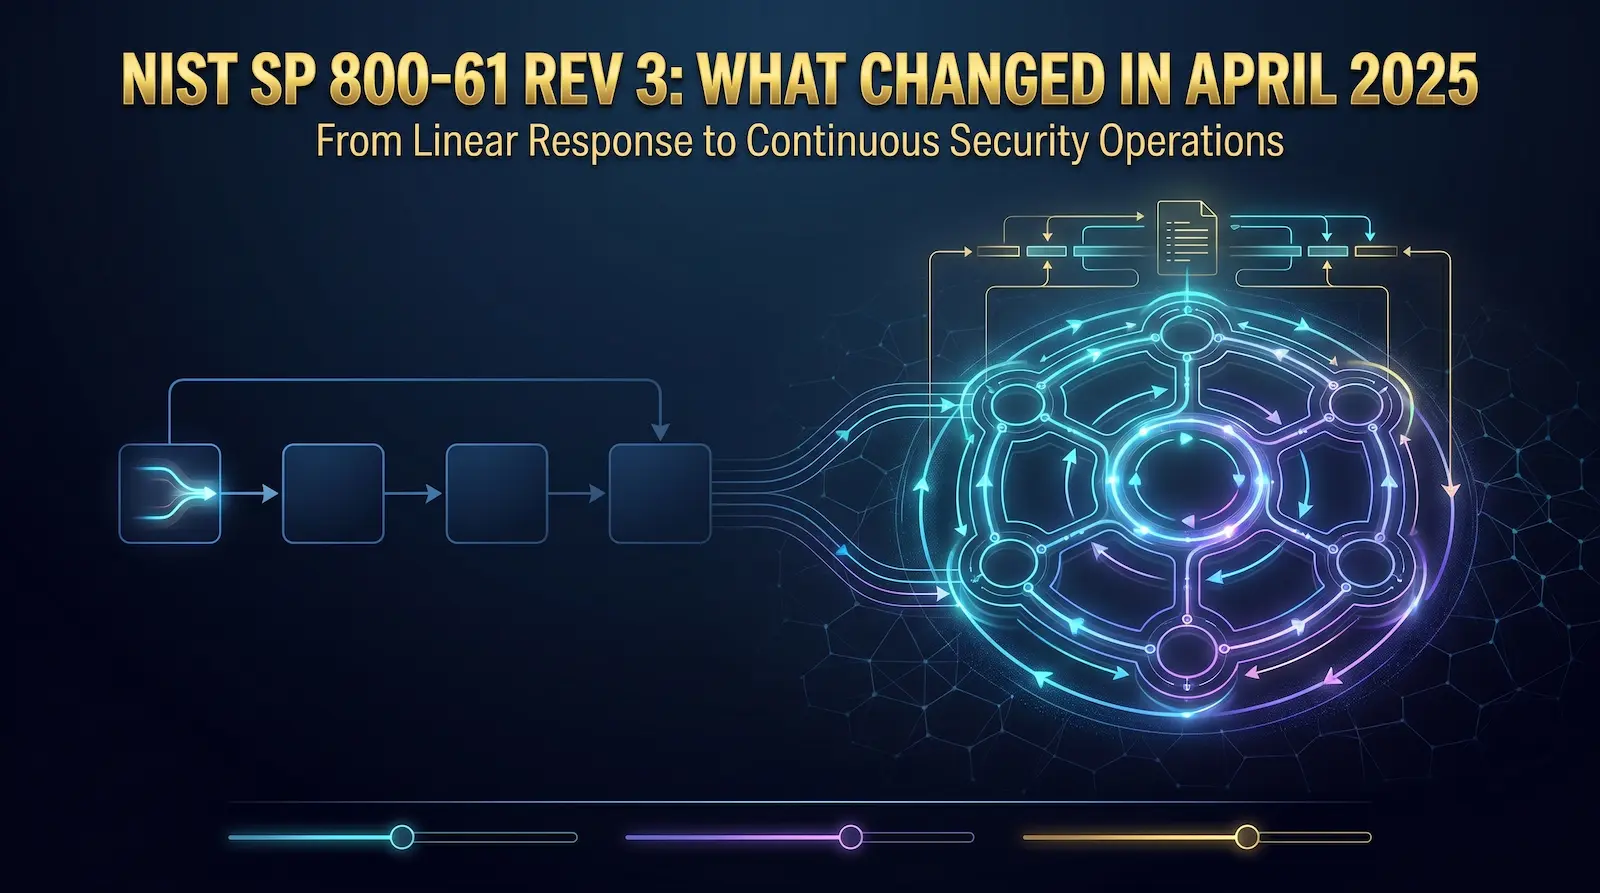
Im April 2025 veröffentlichte das National Institute of Standards and Technology (NIST) die endgültige Version von Sonderpublikation 800-61 Revision 3 - Das wichtigste Update der Leitlinien zur Reaktion auf Vorfälle seit über einem Jahrzehnt.
Die vorherige Version (Rev 2, veröffentlicht im Jahr 2012) behandelte die Reaktion auf einfallende, lineare vier Phasen. Sie erkennen einen Vorfall, reagieren, Sie erholen sich, Sie schreiben einen Lektionsbericht. fertig
Rev 3 ändert dieses Modell grundlegend.
Schlüsseländerungen in SP 800-61 Rev 3
- Integration mit CSF 2.0 Rev 3 ist keine eigenständige Veröffentlichung mehr. Es wird als Community-Profil innerhalb des NIST Cybersecurity Framework 2.0 erstellt. Dies bedeutet, dass die Reaktion auf die Vorfälle jetzt in alle sechs CSF-Funktionen eingebunden ist: Regieren, Identifizieren, Schützen, Erkennen, Reagieren und Wiederherstellen.
- Die kontinuierliche Verbesserung ist jetzt explizit Das alte Modell endete mit „Lessons Learned“. Rev 3 behandelt kontinuierliche Verbesserung als erstklassige Anforderung, nicht als nachträgliche Idee. Von Unternehmen wird erwartet, dass sie ihre IR-Funktionen nicht nur nach Vorfällen laufend testen, aktualisieren und weiterentwickeln.
- Dokumentationsanforderungen erweitert Rev 3 legt stärkeren Wert auf schriftliche Spielbücher, Rollenzuweisungen und vorautorisierte Entscheidungsbäume. Ziel ist es, während eines aktiven Vorfalls die Echtzeit-Improvisation zu eliminieren.
- Das technische Detail ist ausgezogen Da sich die Besonderheiten der IR-Änderung in verschiedenen Technologien und Umgebungen schnell ändern, hat Rev 3 absichtlich die granulare technische Anleitung auf zusätzliche Ressourcen umgestellt. Die Veröffentlichung selbst konzentriert sich auf Risikomanagementprinzipien, die in allen Umgebungen gelten.
Wenn Ihr Incident-Response-Plan gegen die Version 2012 geschrieben wurde, muss eine Überprüfung durchgeführt werden. Die Kernphasen sind ähnlich, aber das Governance-Modell und die Anforderungen für die kontinuierliche Verbesserung sind wesentlich unterschiedlich.
NIST vs Sans: Auswahl des richtigen Frameworks
Sowohl NIST als auch Sans sind weithin respektiert. Beide sind richtig. Der Unterschied hängt davon ab, wie sie die Phasen teilen und für welche Organisationen sie am besten geeignet sind.
Side-by-Side-Vergleich
| Phase | NIST SP 800-61 Rev 3 | Handbuch für Vorfallhandler |
| 1 | Vorbereitung | Vorbereitung |
| 2 | Erkennung und Analyse | Identifizierung |
| 3 | Eindämmung, Ausrottung und Wiederherstellung | Eindämmung |
| 4 | Aktivität nach dem Vorfall | Ausrottung |
| 5 | — | Erholung |
| 6 | — | Lektionen gelernt |
Der praktische Unterschied: NIST-Gruppen-Eindämmung, -ausrottung und -wiederherstellung in einer einzigen Phase, da sich die Arbeit häufig überschneidet - Sie sollten nicht warten, bis die Eindämmung 1001 tp3t abgeschlossen ist, bevor Sie mit der Beseitigung bestätigter Bedrohungen beginnen. SANS unterteilt sie in drei verschiedene Phasen für Teams, die eine klare Übergabe zwischen den Aktionen bevorzugen.
Welches zu verwenden:
- NIST Funktioniert besser für Organisationen, die den US-amerikanischen Compliance-Anforderungen unterliegen, größere Unternehmen mit definierten Governance-Strukturen und Teams, die unter formalen Risikomanagement-Rahmen arbeiten.
- Sans Funktioniert besser für kleinere Sicherheitsteams, Organisationen, die klare Checklisten für Stufen benötigen, und Teams, die ihr erstes IR-Programm erstellen.
Die ehrliche Antwort ist, dass beide das gleiche Ergebnis erzielen, wenn sie richtig ausgeführt werden. Wählen Sie eine aus, dokumentieren Sie sie und schulen Sie Ihr Team darauf.
Die 6 Phasen der Einfallsreaktion
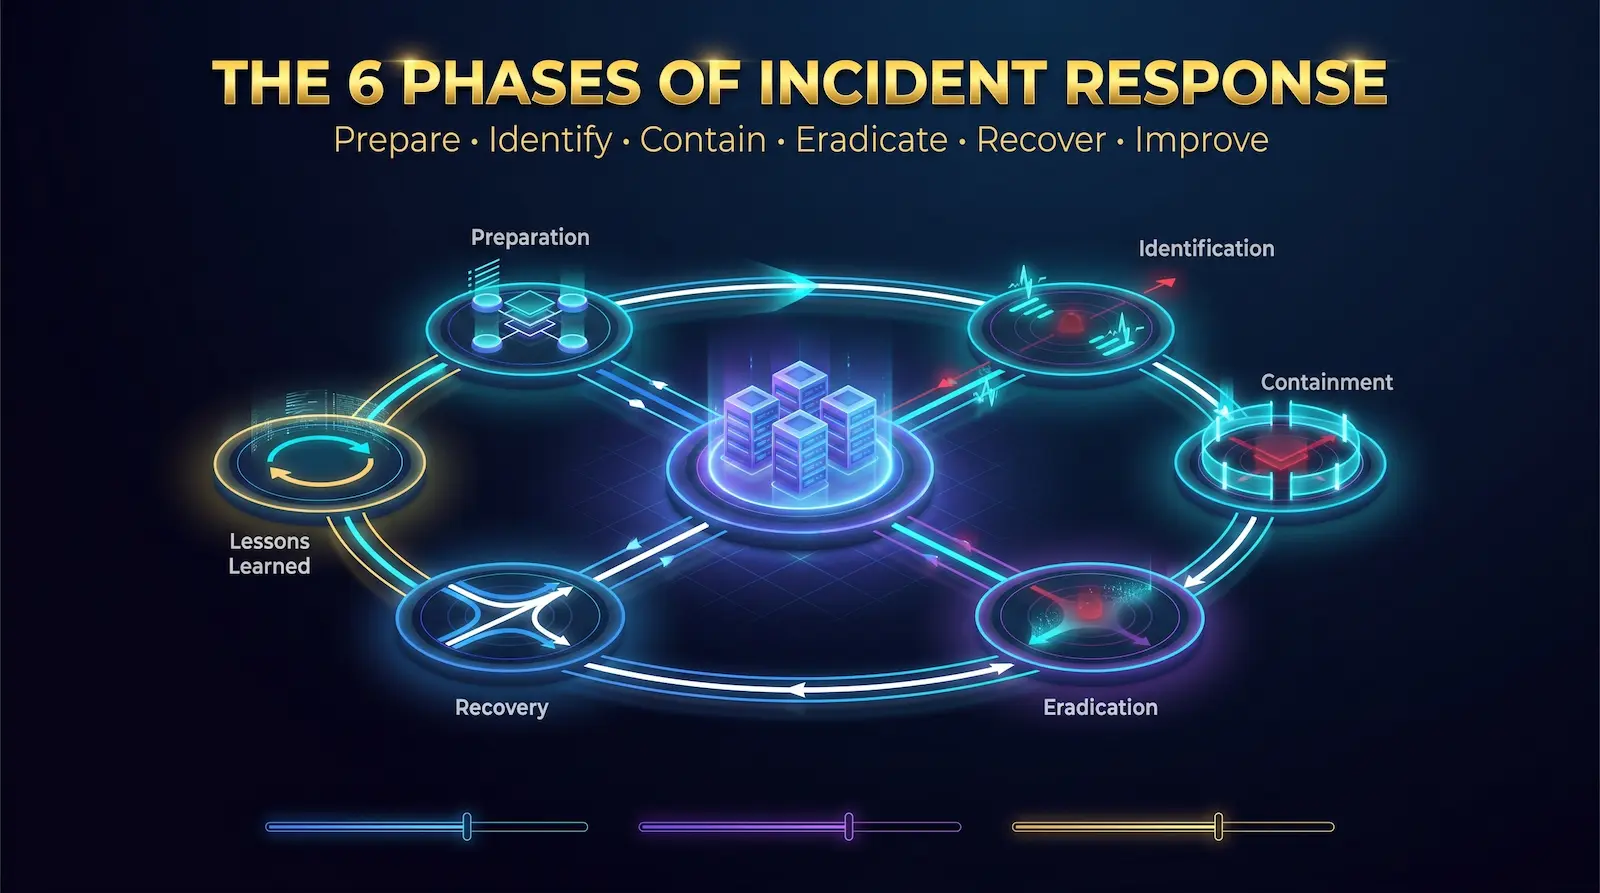
Die folgenden sechs Phasen folgen dem Handbuch für den Vorfall-Handler Modell, weil es die klarste operative Trennung zwischen Aktionen bietet. Die NIST CSF 2.0-Ausrichtung wird gegebenenfalls notiert.
Phase 1: Vorbereitung
Direkte Antwort: Die Vorbereitung ist alles, was Sie tun, bevor ein Vorfall auftritt, um sicherzustellen, dass Sie effektiv reagieren können, wenn Sie dies tun.
Die Vorbereitung ist die wichtigste Phase und diejenige, in die die meisten Organisationen nicht investieren. Sie umfasst:
Team und Struktur:
- Definieren Sie Ihr Cybersicherheits-Incident Response Team (CSIRT) Rollen (im Detail unten beschrieben)
- Weisen Sie einen Incident Manager, einen Tech Lead und einen Communications Manager zu
- Dokumentieren Sie die Autoritätsmatrix: Wer kann das Systemabfahren autorisieren, wer benachrichtigt die Aufsichtsbehörden, wer spricht mit der Presse?
Tools und Zugriff:
- Bereitstellen von Überwachungstools: SIEM-, EDR-, UEBA- und Netzwerkverkehrsanalyse
- Bestätigen Sie, dass Ihr Team Out-of-Band-Kommunikationskanäle bereit hat - eine separate verschlüsselte Messaging-Plattform, ein Telefonbaum oder ein physischer Meetpoint, wenn die Primärsysteme ausfallen
- Pflegen Sie ein aktuelles Asset-Inventar, damit Sie wissen, was Sie schützen
Dokumentation:
- Schreiben Sie Ihr IRP und lassen Sie es von Rechts-, Personal- und Führungskräften überprüfen
- Schreiben Sie Playbooks für Ihre Szenarien mit dem höchsten Risiko: Ransomware, DDoS, Data Breach, Insider Threat
- Bewahren Sie gedruckte Kopien an einem sicheren, Offline-Ort auf
Testen:
- Führen Sie Tischübungen mindestens vierteljährlich durch. Eine Tischplatte ist eine Rollenspielsitzung, in der ein Moderator ein Angriffsszenario präsentiert und das Team durch seine Antwort spricht.
- Führen Sie Penetrationstests durch, um Lücken zu finden, bevor Angreifer dies tun
- Time Ihre Response bohrt und notieren Sie die Metriken – dies wird zu Ihrer Basis für die Messung von Verbesserungen
Hosting-spezifische Vorbereitung (kritisch und übersehen):
- Kennen Sie den Kontaktprozess Ihres Hosting-Providers, bevor Sie ihn benötigen
- Bestätigen Sie, was Ihr Hosting-SLA abdeckt: Netzwerkisolierung, IP-Zuweisung, Protokollzugriff und Out-of-Band-Kommunikation während eines größeren Vorfalls
- Bei Atal Networks ist unser 24/7-Support-Team bei einem Server-Sicherheitsvorfall sofort erreichbar. Kontaktieren Sie unser Support-Team hier.
Phase 2: Identifizierung
Direkte Antwort: Identifizierung ist der Prozess, um einen möglichen Vorfall zu erkennen, Beweise zu sammeln und zu bestätigen, ob ein echtes Sicherheitsereignis eingetreten ist.
Nicht jeder Alarm ist ein Vorfall. Diese Phase existiert, um diese Bestimmung genau und schnell zu machen.
Erkennungsauslöser fallen in zwei Kategorien:
Frontgeladen (Frühwarnung): Threat Intelligence-Feeds, Honeypot-Warnungen, anomale Anmeldeversuche, ungewöhnliche Netzwerkverkehrsmuster oder SIEM-Korrelationsregeln, die vor dem Auftreten des Schadens ausgelöst werden. Diese fangen mehr falsche Positive an, stoppen aber frühere Angriffe.
Zurückgeladen (sichtbarer Schaden): Benutzer, die Leistungsprobleme, nicht verfügbare Daten, Lösegeldscheine oder externe Forscher melden, die einen Verstoß melden. Es ist wahrscheinlicher, dass es sich um echte Vorfälle handelt, die jedoch nach dem Beginn des Schadens eintreffen.
Der Triage-Prozess:
- Sammeln Sie alle verfügbaren Daten: Protokolle, Warnungen, Benutzerberichte und Netzwerkerfassungen
- Bestimmen Sie, ob es sich bei dem Ereignis um einen falsch positiven oder einen wahren Vorfall handelt
- Wenn ein wahrer Vorfall, klassifizieren Sie ihn nach Schweregrad (P1/Critical, P2/High, P3/Medium, P4/Low)
- Aktivieren Sie das entsprechende Playbook
Schlüsselprinzip: Protokollieren Sie alles von diesem Punkt nach vorn. Jede Aktion, jede Entscheidung, jeder Zeitstempel. Dieses Protokoll ist Ihr Rechtsprotokoll, Ihre Versicherungsdokumentation und Ihr Unterrichtsmaterial.
Phase 3: Eindämmung
Direkte Antwort: Die Eindämmung begrenzt den Umfang des Vorfalls, um die Verbreitung auf zusätzliche Systeme oder Daten zu verhindern.
Containment hat zwei Stufen:
Kurzfristige Eindämmung passiert sofort. Das Ziel ist es, die Blutung schnell zu stoppen. Zu den Aktionen gehören das Isolieren des betroffenen Systems aus dem Netzwerk, das Blockieren der IP-Adressen des Angreifers, das Deaktivieren von gefährdeten Benutzerkonten und die Aktivierung der DDoS-Filterung bei einem Volumenangriff.
Langfristige Eindämmung passiert, während die Ausrottung vorbereitet wird. Die betroffenen Systeme werden in einer isolierten Umgebung fortgesetzt (oder wiederhergestellt), damit die forensische Untersuchung fortgesetzt werden kann.
Containment auf Serverebene – was das in der Praxis bedeutet:
Für VPS-Umgebungen, Containment bedeutet oft, einen Schnappschuss der betroffenen Instanz zu machen und einen sauberen Ersatz zu drehen. Der kompromittierte Snapshot wird für die forensische Analyse beibehalten, aber offline und außerhalb des Netzwerks gehalten.
Für dedizierte ServerDie Eindämmung erfordert möglicherweise ein Herunterfahren auf Netzwerkebene auf der Switch-Port- oder Firewall-Regelebene. Ihr Hosting-Anbieter kann dies auf der Infrastrukturebene implementieren, schneller als die meisten internen Teams handeln können.
Für Bare-Metal-Server, Es kann eine vollständige physische Isolation erforderlich sein. Dies bedeutet, dass die IP des Servers auf BGP-Ebene null-routed wird - der Server wird aus dem öffentlichen Internet unerreichbar, während Ihr Team dies untersucht.
Bewahren Sie die forensische Integrität während der Eindämmung. Wischen Sie die Systeme nicht ab, bevor Sie Beweise erfassen. Speicher-Dumps, laufende Prozesslisten, Netzwerkverbindungszustände und vollständige Festplatten-Images sollten vor Beginn einer Sanierung erfasst werden.
Phase 4: Ausrottung
Direkte Antwort: Durch die Beseitigung werden alle Spuren des Angriffs aus Ihrer Umgebung entfernt - Malware, Backdoors, kompromittierte Anmeldeinformationen und die ausnutzen Schwachstellen.
Die Ausrottung muss gründlich sein oder der Angreifer kommt zurück. Das häufigste Versagen bei IR ist, dass eine Umgebung sauber ist, wenn noch ein Backdoor oder ein ruhendes Implantat vorhanden ist.
Ausrottungsschritte:
- Führen Sie eine Ursachenanalyse (RCA) durch, um genau zu identifizieren, wie der Angreifer hineingekommen ist
- Entfernen Sie alle Malware, Ransomware-Nutzlasten und schädliche Skripte
- Untersuchen und schließen Sie die ausgenutzte Sicherheitsanfälligkeit (Patch, Konfigurationsänderung oder Zugriffswiderruf)
- Entfernen Sie alle vom Angreifer hinzugefügten Administratorkonten und SSH-Schlüssel
- Bauen Sie beschädigte oder manipulierte Systeme aus einer bekannten Grundlinie wieder auf
- Aktualisieren Sie Firewall-Regeln und DNS-Filterrichtlinien
- Erzwingen Sie ein vollständiges Zurücksetzen des Passworts für alle Konten im Explosionsradius - und für privilegierte Konten im gesamten Unternehmen vorsorglich
- Drehen Sie API-Schlüssel, Anmeldeinformationen für das Dienstkonto und möglicherweise verfügbare Zertifikate
Die Entscheidung zum Wiederherstellen vs. Der Wiederaufbau von Grund auf dauert länger, garantiert aber ein sauberes System. Die Wiederherstellung aus dem Backup ist schneller, aber nur dann sicher, wenn das Backup vor der Verletzung und das Backup selbst nicht kompromittiert wurde. Bei Vorfällen mit hoher Schwere wieder aufbauen.
Phase 5: Wiederherstellung
Direkte Antwort: Die Wiederherstellung stellt die betroffenen Systeme sicher, schrittweise und mit Überwachung wieder in den normalen Betrieb zurück, um zu bestätigen, dass die Bedrohung verschwunden ist.
Wiederherstellung ist keine einzige Aktion. Es ist ein kontrollierter, stufenloser Prozess.
Wiederherstellungsprinzipien:
- Wiederherstellung von Systemen in der Reihenfolge der Geschäftskritik
- Beeil dich nicht. Wenn Sie ein kompromittiertes oder instabiles System wieder online bringen, wird der Vorfall verlängert.
- Implementieren Sie die erweiterte Überwachung auf jedem wiederhergestellten System für mindestens 30 Tage
- Definieren Sie explizite Go/No-Go-Kriterien, bevor Sie jedes System live bringen – bestätigen Sie keine verdächtigen Aktivitäten, keine unerwarteten Netzwerkverbindungen, keine nicht autorisierten Prozesse
Erholungsphasen:
- Wiederherstellen von verifiziertem, sauberem Backup oder neu erstelltem Image
- Wenden Sie alle Sicherheitspatches an, bevor Sie eine Verbindung zum Netzwerk herstellen
- Bringen Sie Systeme zuerst in einer inszenierten, überwachten Umgebung online
- Überprüfen Sie die Funktionalität mit einer Teilmenge von Benutzern vor dem vollständigen Produktionsverkehr
- Skalieren Sie auf die volle Produktion, sobald die Stabilität bestätigt ist
Für Serverumgebungen: Die Rolle Ihres Hosting-Anbieters bei der Wiederherstellung umfasst die Bestätigung der Reputation über saubere IP-Adressen (kein Auflisten des Vorfalls), die Wiederherstellung des BGP-Routings und die Überprüfung der Überwachung auf Netzwerkebene. Bei Atal Networks arbeitet unser Infrastrukturteam während der Wiederherstellungsphase mit Ihrem Sicherheitsteam zusammen, um zu bestätigen, dass die Netzwerkschicht sauber ist, bevor der volle Datenverkehr wiederhergestellt wird.
Phase 6: Lektionen gelernt
Direkte Antwort: Lessons Learned ist eine strukturierte Überprüfung des Vorfalls, die innerhalb von 14 Tagen nach vollständiger Wiederherstellung durchgeführt wird, um herauszufinden, was funktioniert, was fehlgeschlagen ist und was sich ändern muss.
NIST SP 800-61 Rev 3 verlangt ausdrücklich, dass dies ein tadelloser Prozess ist. Die Menschen werden keine ehrlichen Beobachtungen über Misserfolge teilen, wenn sie die Bestrafung befürchten. Das Ziel ist es, das System zu verbessern, nicht Einzelpersonen zu bestrafen.
Die Überprüfung nach dem Vorfall umfasst:
- Eine vollständige Zeitleiste des Vorfalls vom ersten Indikator bis zur vollständigen Wiederherstellung
- Welche Erkennung funktionierte und was fehlte
- ob die Eskalationsprotokolle richtig funktionierten
- Ob die Kommunikation (intern und extern) klar und zeitnah war
- Ob die IRP und die Playbooks genau das widerspiegeln, was das Team tun musste
- wo Ressourcen (Personen, Werkzeuge, Zugang) nicht ausreichten
Ausgaben:
- Aktualisierte IRP und Playbooks
- Neue oder überarbeitete Erkennungsregeln
- Patch- oder Konfigurationsänderungen während der RCA identifiziert
- Schulungsempfehlungen für bestimmte Teammitglieder oder Abteilungen
- Ein schriftlicher Bericht für Führungskräfte, rechtliche und (falls erforderlich) Regulierungsbehörden
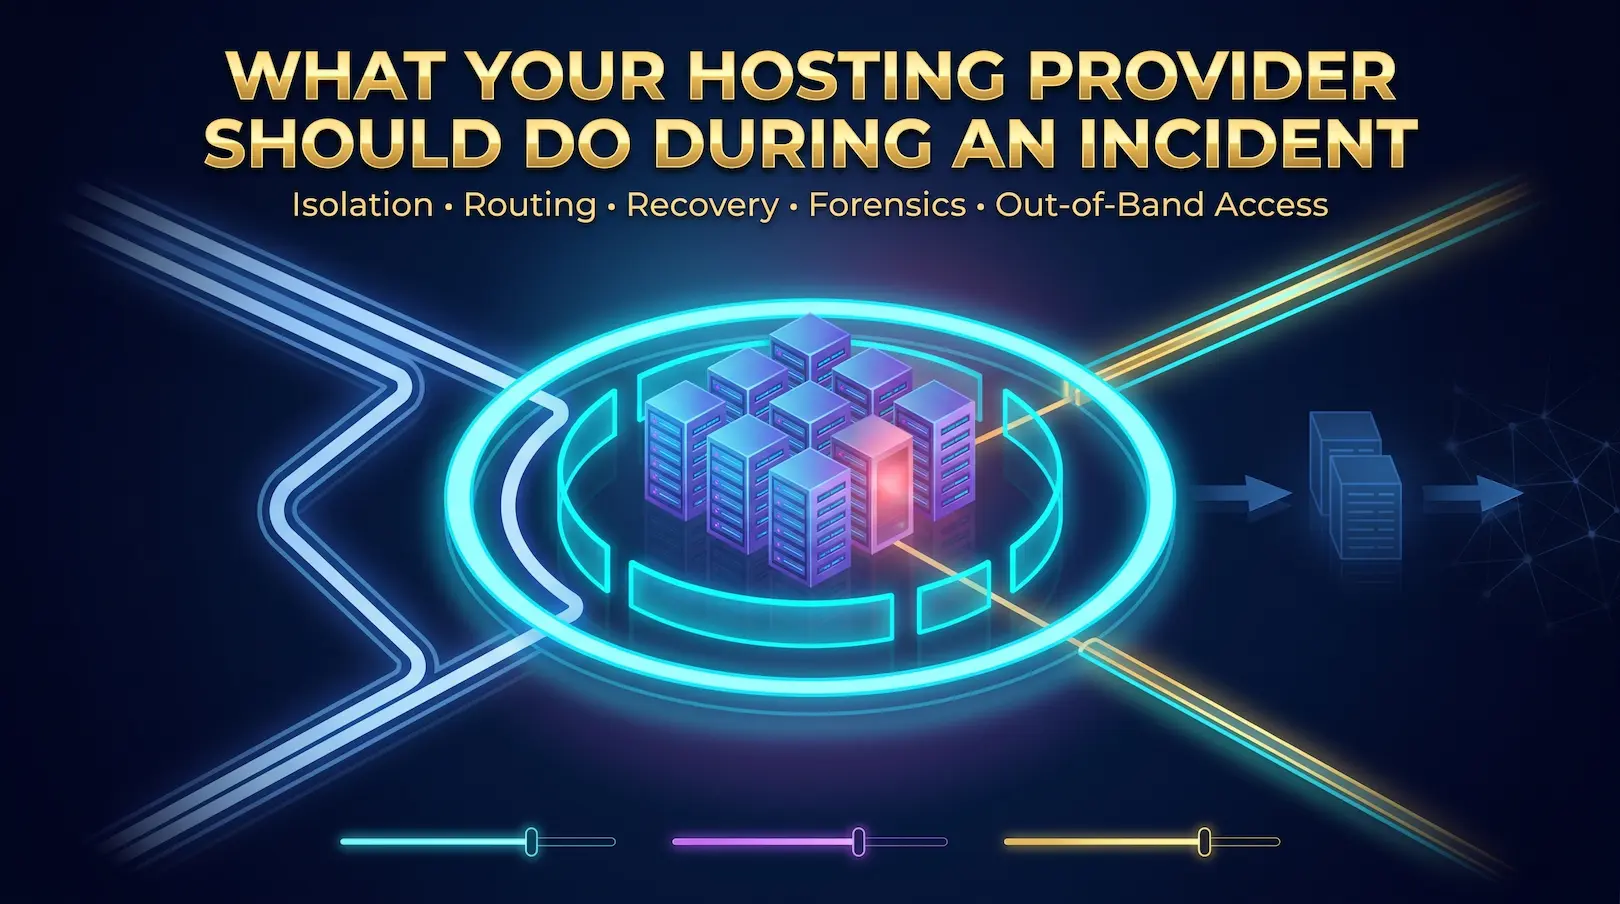
Was Ihr Hosting-Anbieter während eines Vorfalls tun sollte
Dies ist der Abschnitt, den keine anderen IR-Leitfäden abdecken. Es ist auch der Abschnitt, der am wichtigsten ist, wenn Ihr Unternehmen auf Cloud, VPS oder dedizierter Serverinfrastruktur läuft.
Ihr Hosting-Anbieter ist während eines Sicherheitsvorfalls kein passiver Zuschauer. Sie steuern Ihren Netzwerkzugriff, Ihr IP-Routing, Ihre Server-Hardware und in vielen Fällen Ihre Out-of-Band-Kommunikationskanäle. Ein fähiger Hosting-Anbieter ist Teil Ihres Incident-Response-Teams.
Hier ist genau das, was Ihr Anbieter tun sollte:
Isolation auf Netzwerkebene
Wenn ein Server als kompromittiert bestätigt wird, müssen Sie ihn sofort vom Rest des Internets abschneiden. Ein guter Hosting-Anbieter kann:
- Implementieren Sie eine Null-Route auf BGP-Ebene, wodurch die IP des Servers von außen nicht erreichbar ist
- Anwenden von Firewall-Regeln am Netzwerkrand, nicht nur auf der Serverebene, um die seitliche Bewegung zu blockieren
- Weisen Sie Ihre IP-Adressen neu zu, wenn sie aufgrund von ausgehendem Spam oder Angriffsverkehr vom kompromittierten Server auf die schwarze Liste gesetzt werden
Bei Atal Networks kann die Isolation auf Netzwerkebene sofort über unser Support-Team aktiviert werden. Wir betreiben über 213+ Rechenzentren mit BGP-Redundanz durch Simply Transit, was bedeutet, dass Isolations- und Routing-Änderungen auf der Infrastrukturebene wirksam werden, nicht nur auf der Betriebssystemebene.
Servertyp zählt: Eindämmung nach Infrastruktur
Unterschiedliche Servertypen erfordern unterschiedliche Containment-Ansätze. Ihr IRP sollte dokumentieren, welchen Typ Sie ausführen und die genauen Eindämmungsschritte für jeden. Sie sind sich nicht sicher, welcher Servertyp zu Ihrer Workload passt? siehe unsere Dedicated Servers vs. VPS-Hosting-Vergleich.
| Servertyp | Eindämmungsansatz | Anbieteraktion |
| VPS | Snapshot der Instanz, Reinigen Ersatz | Der Anbieter macht einen Snapshot auf Hypervisor-Ebene, isoliert die virtuelle Netzwerkschnittstelle der VM |
| Dedizierter Server | Herunterfahren am Switch-Port oder auf der Firewall-Ebene | Der Anbieter wendet die Zugriffskontrollliste (ACL) am Switch an, trennt die Verbindung von der Netzwerkstruktur |
| Blankes Metall | Volle IP-Null-Route + Out-of-Band-Konsolenzugriff | Provider null-routes BGP, bietet IPMI/iDRAC-Zugriff für Fernuntersuchungen |
| Kolokation | Koordination des physischen Zugangs | Provider steuert Netzwerkverbindungen, koordiniert den Zugriff für Ihr Team oder IR-Firma von Drittanbietern |
Out-of-Band-Kommunikation während eines Vorfalls
Dies ist die am meisten übersehene IR-Planung. Wenn Ihre primären Systeme ausgefallen sind - E-Mail ist ausgefallen, Slack ist ausgefallen, Ihr VPN ist ausgefallen - wie kommuniziert und koordiniert Ihr Team?
Ein seriöser Hosting-Anbieter bietet Ihnen Out-of-Band-Zugang über:
- IPMI (Intelligente Plattform-Management-Schnittstelle): Zugriff auf Konsolenebene auf Ihre Server-Hardware unabhängig vom Betriebssystem. Wenn das Betriebssystem kompromittiert ist, können Sie immer noch sehen, was passiert, und Befehle ausgeben.
- iDRAC / iLO: Remote-Management-Karten auf Herstellerebene, die auch funktionieren, wenn der Server ausgeschaltet ist oder das Betriebssystem abgestürzt ist.
- Dedizierter Support-Kanal: Eine Telefonnummer oder ein Notfall-Ticketsystem, das die Standard-Ticket-Warteschlangen während eines bestätigten Vorfalls umgeht.
Wenn Ihr Hosting-Anbieter keinen Out-of-Band-Zugriff auf Ihre Server bieten kann, ist dies eine schwerwiegende Lücke in der Reaktionsfähigkeit Ihrer Vorfälle.
Protokollspeicherung und forensische Daten
Nach einem Vorfall benötigen Sie Protokolle. Netzwerkverkehrsprotokolle, Zugriffsprotokolle, Authentifizierungsprotokolle, DNS-Abfrageprotokolle. Ihr Hosting-Anbieter enthält möglicherweise Protokolle auf Infrastrukturebene, die Ihre internen Systeme nicht erfassen.
Bevor ein Vorfall passiert, bestätigen Sie mit Ihrem Hosting-Anbieter:
- Welche Protokolle werden auf Infrastrukturebene aufbewahrt?
- Wie weit geht das Retentionsfenster zurück (30 Tage, 90 Tage, länger)
- In welchem Format werden Protokolle für die forensische Analyse ausgeliefert
Bei Atal Networks behalten wir Protokolle auf Infrastrukturebene und können diese Kunden während eines bestätigten Sicherheitsvorfalls zur Verfügung stellen. Unser Support-Team koordiniert direkt mit Ihrem IR-Team oder Ihrer externen IR-Firma.
So benachrichtigen Sie Ihren Hosting-Anbieter
Sobald Sie einen Sicherheitsvorfall bestätigen, der sich auf Ihre gehostete Infrastruktur auswirkt, öffnen Sie sofort ein Support-Ticket und markieren Sie es als Sicherheitsnotfall. Warten Sie nicht, bis die Eindämmung abgeschlossen ist.
Informationen, die in Ihre Benachrichtigung aufgenommen werden sollen:
- Bestätigung, dass ein Sicherheitsvorfall im Gange ist
- Welche Server oder IPs sind betroffen?
- Egal, ob Sie Netzwerkisolierung, Protokollzugriff oder Out-of-Band-Konsolenzugriff benötigen
- Ihre Kontaktdaten für die Dauer des Vorfalls
Kontakt Atal Networks 24/7 Support kontaktieren — Unser Team ist rund um die Uhr verfügbar und behandelt Sicherheitsvorfälle als vorrangige Eskalationen.
Aufbau Ihres Incident-Response-Teams (CSIRT)
Ein Cybersecurity Incident Response Team (CSIRT) ist die Gruppe, die für die Ausführung Ihres IR-Plans bei Auftreten eines Vorfalls verantwortlich ist. Jedes Mitglied hat eine definierte Rolle, bevor der Vorfall passiert.
Kernrollen
Incident Manager (IM) Das IM führt die Antwort an. Sie verwalten Kommunikationsflüsse, aktualisieren Stakeholder, delegieren Aufgaben an andere Teammitglieder und verfolgen die Uhr. Entscheidend ist, dass das IM während des Vorfalls keine technischen Arbeiten ausführt. Ihre Aufgabe ist Koordination und Entscheidungsfindung. In einer Krise ist die Zeitdilatation real - die Menschen verlieren den Überblick darüber, wie lange die Dinge dauern. Der IM überwacht die Uhr und hält das Team auf dem richtigen Weg.
Tech Lead (TL) Die TL fungiert als Fachexperte. Sie lenken Eindämmungs-, Ausrottungs- und Wiederherstellungsmaßnahmen, holen nach Bedarf zusätzliche technische Spezialisten ein und fordern den Aufruf zu Wiederaufbau- und Wiederherstellungsentscheidungen. Die TL koordiniert mit dem Infrastrukturteam Ihres Hosting-Anbieters.
Kommunikationsmanager (cm) Das CM verwaltet während des Vorfalls die gesamte interne und externe Kommunikation. Interne Aktualisierung der Mitarbeiter und Führungskräfte. Externe Kommunikation mit Kunden, Regulierungsbehörden und Medien. Das CM bereitet auch im Voraus Erklärungen vor - vorab genehmigte Sprache für Szenarien wie einen Reporter, der einen mutmaßlichen Verstoß anspricht.
Rechtsberatung Legal muss ab dem Zeitpunkt der Bestätigung eines Verstoßes einbezogen werden, insbesondere dann, wenn personenbezogene Daten einbezogen werden können. Sie beraten zu regulatorischen Benachrichtigungsfristen (DSGVO: 72 Stunden, HIPAA: 60 Tage), Anforderungen an die Evidenzhandhabung und was kann und kann nicht extern geteilt werden.
Executive Sponsor Ein leitender Angestellter mit der Befugnis, während eines Vorfalls Entscheidungen auf Geschäftsebene zu treffen. Dazu gehört die Genehmigung von Systemabschaltungen, die sich auf den Umsatz auswirken, die Kommunikation zu genehmigen und die Entscheidung über die Einbeziehung von Strafverfolgungsbehörden.
Wann externe IR-Firmen einbringen
Externe IR-Firmen bringen vorgefertigte Playbooks, erfahrene Responder und forensische Tools, die die meisten internen Teams nicht haben. Erwägen Sie, wenn:
- Der Schweregrad des Vorfalls ist P1 (Ransomware, Datenexfiltration, Kompromisse bei Komplettsystemen)
- Ihrem internen Team fehlen Erfahrung mit dem spezifischen Angriffstyp
- Sie benötigen unabhängige forensische Beweise für rechtliche oder versicherungstechnische Zwecke
- Der Vorfall ist groß genug, um Ihre interne Kapazität zu überfordern
Wählen Sie Ihre externe IR-Firma aus, bevor ein Vorfall passiert. Die Vorverhandlung eines Retainers ist weitaus besser als die Suche nach einem Unternehmen, während er angegriffen wird.
Ausführen einer Tischübung
Eine Tabletop-Übung ist eine Rollenspiel-Sitzung, bei der ein Moderator ein Angriffsszenario präsentiert und das Team über seine Antwort in Echtzeit spricht. Es sind keine tatsächlichen Systeme beteiligt. Der Wert liegt darin, Lücken in Ihrem Plan und Ihrer Entscheidungsfindung zu finden, bevor sie wichtig sind.
Ein grundlegendes Tischformat:
- Facilitator präsentiert Szenario: „Ihr Überwachungssystem hat gerade ungewöhnlichen ausgehenden Datenverkehr von drei Servern markiert. Es ist 2 Uhr morgens an einem Sonntag.“
- Das Team bespricht: Wer zuerst angerufen wird, welche Maßnahmen ergriffen werden, welche Informationen werden benötigt
- Facilitator bringt neue Entwicklungen ein: „Die Server sind kompromittiert. Ransomware wurde eingesetzt.“
- Team setzt Antwort fort
- Nachbesprechung nach dem Training: Was funktionierte, was nicht, welche Lücken wurden gefunden
Führen Sie Tischplatten mindestens zweimal im Jahr aus. Führen Sie sie nach jedem bedeutenden Vorfall oder größeren Infrastrukturwechsel aus.
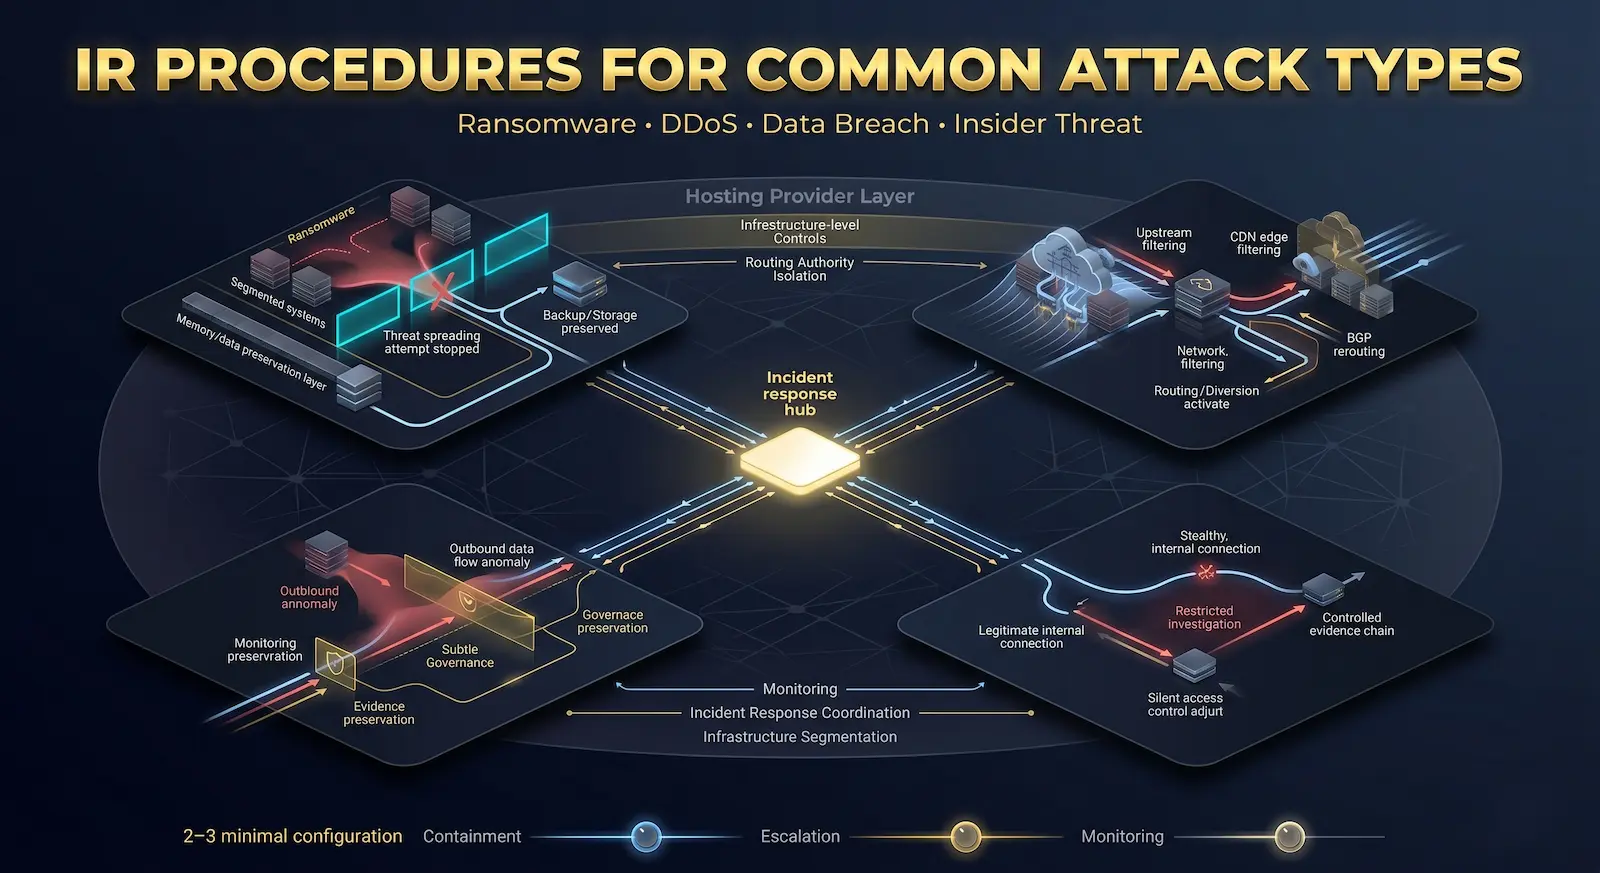
IR-Verfahren für gängige Angriffstypen
Ihr allgemeines IRP deckt die sechs Phasen ab. Ihre Spielbücher decken bestimmte Angriffstypen ab. Hier sind die wichtigsten Entscheidungen und Maßnahmen für die vier häufigsten Szenarien.
Ransomware
Ransomware ist für die meisten Organisationen der Typ mit der höchsten Priorität. Die Geschwindigkeit der Eindämmung bestimmt direkt, wie viele Daten verschlüsselt werden.
Die Entscheidung über die Zahlung oder Nichtzahlung: Strafverfolgungsbehörden, einschließlich des FBI, empfehlen, kein Lösegeld zu zahlen. Die Zahlung garantiert nicht die Datenwiederherstellung, die kriminellen Operationen und kann gegen OFAC-Sanktionen verstoßen, wenn sich der Bedrohungsakteur auf einer Sperrliste befindet. Die bessere Position ist eine getestete, segmentierte Backup-Strategie, die die Zahlung überflüssig macht.
Kritische Aktionen:
- Isolieren Sie betroffene Systeme sofort auf Netzwerkebene (Ihr Hosting-Anbieter kann dies tun)
- Betroffene Systeme nicht neu starten – Memory Forensics zeigen möglicherweise die Tools des Angreifers an
- Identifizieren Sie die Ransomware-Variante, um festzustellen, ob ein freier Entschlüsselungsschlüssel vorhanden ist (Check nomoreransom.org)
- Benachrichtigen Sie Ihren Cyber-Versicherungsträger sofort
- Strafverfolgungsbehörden engagieren - die Internet-Kriminalbeschwerdezentrum des FBI (IC3) Sammelt Ransomware-Berichte und verfügt möglicherweise über Informationen über den spezifischen Bedrohungsakteur
DDoS-Angriffe
Distributed Denial of Service attacks target availability. Die Antwort befindet sich auf der Netzwerkebene, wodurch Ihr Hosting-Anbieter zu einem primären Responder und nicht nur zu einer Support-Ressource wird.
Hosting-Anbieter-Antwortaktionen:
- Aktivieren Sie DDoS-Filterung und Traffic-Scrubbing am Netzwerkrand
- Wenden Sie die Ratenbegrenzung und die Verkehrsgestaltung an, um das Angriffsvolumen zu absorbieren oder umzuleiten
- Implementieren Sie IP-basierte Blockierung für bestätigte Angriffsquellen
- Engagieren Sie vorgelagerte Transitanbieter für Traffic Blackholing, wenn der Angriff die Scheuerkapazität überschreitet
Interne Aktionen:
- Aktivieren Sie die DDoS-Schutzschicht Ihres CDN
- Aktivieren Sie die Anwendungsebenenratenbegrenzung auf Ihren Webservern
- Kommunizieren Sie die geschätzte Dienstwiederherstellungszeit an betroffene Kunden
- Protokollieren Sie den gesamten Angriffsverkehr für die Analyse nach dem Vorfall
Bei Atal Networks verfügt unser BGP-Netzwerk mit Simply Transit-Routing über DDoS-Minderungsfunktionen. See our bare metal server infrastructure Einzelheiten zu den Informationen auf Infrastrukturebene.
Datenschutzverletzung
Wenn möglicherweise personenbezogene Daten offengelegt wurden, beginnt die Uhr für die Benachrichtigung.
Benachrichtigungszeiten:
- DSGVO: 72 Stunden nach Bekanntwerden der Verletzung der zuständigen Aufsichtsbehörde
- hipaa: 60 Tage nach der Entdeckung, um das HHS-Büro für Bürgerrechte zu benachrichtigen
- Gesetzesverstöße (USA): Variieren Sie je nach Bundesstaat zwischen 30 und 90 Tagen
Kritische Aktionen:
- Bewahren Sie alle Beweise vor jeder Sanierung auf
- Bestimmen Sie den Expositionsumfang: Welche Daten, wie viele Personen, welche Kategorien
- Engagieren Sie sich sofort
- Entwurf von Kunden- und behördlichen Benachrichtigungen - Nicht ohne rechtliche Überprüfung versenden
- Dokumentieren Sie alle Maßnahmen mit Zeitstempel für die behördliche Berichterstattung
Insider-Bedrohung
Insider-Bedrohungen gehören zu den am schwersten zu erkennenden und am empfindlichsten zu handhaben, da sie Mitarbeiter, Auftragnehmer oder Partner einbeziehen.
Hauptunterschiede in der Antwort:
- HR und Legal müssen ab der ersten Angabe einbezogen werden
- Die Beweiserhebung muss für mögliche Gerichtsverfahren ordnungsgemäße Verfahren der Verwahrung einhalten.
- Die Kommunikation über die Untersuchung beschränkt sich auf eine Need-to-Know-Gruppe
- Der Zugriffsrücktritt muss sorgfältig koordiniert werden, um das Thema zu vermeiden, bevor die Beweise gesichert sind
Vorfallreaktion und Einhaltung
Regulatorische Compliance-Frameworks empfehlen nicht nur IR-Pläne. Mehrere verlangen sie explizit mit spezifischen Dokumentations- und Prüfpflichten.
| Rahmen | IR-Anforderung |
| NIST CSF 2.0 | Respond- und Recover-Funktionen erfordern dokumentierte IR-Funktionen Hinweise zur Reaktion auf das Vorfall |
| ISO 27035 | Internationaler Standard speziell für das Management von Informationssicherheitsvorfällen |
| DSGVO | Artikel 33: Benachrichtigung über Verstöße innerhalb von 72 Stunden, dokumentierte Verfahren erforderlich |
| hipaa | Sicherheitsregel erfordert dokumentierte Vorfallsreaktionsverfahren und Personalschulung |
| PCI DSS | Anforderung 12.10: Dokumentierter IR-Plan, jährliche Prüfung, 24/7-Reaktionsfähigkeit |
| SOC 2 | Incident Response ist ein Kriterium der Verfügbarkeit und des Sicherheits-Vertrauensdienstes |
Für Organisationen, die mehreren Frameworks unterliegen, deckt ein einziger gut dokumentierter IRP, der an NIST SP 800-61 REV 3 ausgerichtet ist, die meisten Anforderungen ab. Der Schlüssel ist die Dokumentation, das Testen von Beweisen und regelmäßige Aktualisierungen.
Checkliste für die Reaktion auf Vorfälle
Verwenden Sie diese Checkliste während eines aktiven Vorfalls. Drucken Sie es aus und halten Sie eine Kopie offline.
Vorbereitung (Vorfall)
- [ ] IRP dokumentiert und von Rechts-, Personal- und Führungskräften dokumentiert
- [ ] CSIRT-Rollen mit benannten Sicherungen für jede Rolle
- [ ] Playbooks für Ransomware, DDoS, Data Breach und Insider-Bedrohung geschrieben
- [ ] Out-of-Band-Kommunikationskanäle getestet und bestätigt
- [ ] Der Notfall-Sicherheitskontakt des Hosting-Anbieters wurde bestätigt und offline gespeichert
- [ ] Backup-Integrität verifiziert — Letzter Testtermin: ___________
- [ ] Tischübung abgeschlossen — Letztes Datum: ___________
- [ ] Externer IR-Firmenhalter (falls zutreffend): ___________
Erkennung und Identifizierung
- [ ] Erhaltener Alarm oder gemeldeter Vorfall: Zeit: ___________
- [ ] Erste Triage abgeschlossen — Falsch positiver oder wahrer Vorfall bestätigt
- [ ] Klassifizierter Schweregrad: P1 / P2 / P3 / P4
- [ ] Incident-Manager benachrichtigt: Zeit: ___________
- [ ] Vorfallprotokoll geöffnet und ausgeführt
- [ ] Passendes Playbook aktiviert
Eindämmung
- [ ] Betroffene Systeme identifiziert und inventarisiert
- [ ] Netzwerkisolation implementiert (intern + Provider-Ebene)
- [ ] Kompromittierte Konten deaktiviert
- [ ] Forensische Beweise, die vor Beginn der Sanierung erfasst wurden
- [ ] Hosting-Provider benachrichtigt (wenn die Serverinfrastruktur betroffen ist): Zeit: ___________
- [ ] Strafverfolgungsbehörden (falls erforderlich): Zeit: ___________
- [ ] Rechtsbeistand engagiert: Zeit: ___________
Ausrottung
- [ ] Ursachenanalyse abgeschlossen
- [ ] Alle Malware und nicht autorisierten Zugriffstools entfernt
- [ ] Ausnutzen der Sicherheitslücke gepatcht oder gemildert
- [ ] Nicht autorisierte Konten und Anmeldeinformationen entfernt
- [ ] Das Zurücksetzen des Passworts für betroffene Konten wurde eingeleitet
Erholung
- [ ] Wiederherstellungsplan mit priorisierter Systemliste dokumentiert
- [ ] Die Sicherungsintegrität vor der Wiederherstellung überprüft
- [ ] Systeme wiederhergestellt und validiert, bevor sie zur Produktion zurückkehren
- [ ] Erweiterte Überwachung aktiv auf wiederhergestellten Systemen
- [ ] Hosting-Anbieter bestätigte saubere IP-Reputation und Netzwerk-Routing
Nachfall
- [ ] Unterrichtsstunde geplant (innerhalb von 14 Tagen): Datum: ___________
- [ ] IRP und Playbooks aktualisiert basierend auf den Ergebnissen
- [ ] Behördliche Benachrichtigungen gesendet (falls erforderlich): Datum: ___________
- [ ] Vorstand und Vorstandsbesprechung abgeschlossen
- [ ] Vorfallbericht beim Versicherungsträger eingereicht (falls zutreffend)
Fallstudie aus der realen Welt: St. Paul Ransomware-Angriff (2025)
Im Juli 2025 wurde die Stadt St. Paul, Minnesota, von einem koordinierten Ransomware-Angriff getroffen, der die Regierungsdienste in der ganzen Stadt störte. Die Antwort zeigte sowohl, was funktioniert als auch was Organisationen bei Vorfällen mit hohem Schweregrad vorbereiten sollten.
Die Zeitleiste:
- 25. Juli: Verdächtige Aktivitäten in Stadtnetzen festgestellt. Das IT-Team beginnt sofort mit der Ermittlungs-Triage.
- 27. Juli: Böswilliges Verhalten bestätigt. City Es schaltet alle Informationssysteme proaktiv ab, um eine weitere Ausbreitung zu verhindern.
- Folgende Tage: FBI für Eindämmung und forensische Untersuchung beauftragt. Cyber-Assets der Minnesota National Guard, die vom Gouverneur aktiviert wurden.
Was funktionierte:
- Früherkennung: Die erste Warnung am 25. Juli gab dem Team zwei Tage vor der Entscheidung für die Abschaltung. Dieses Erkennungsfenster war kritisch.
- Isolation vor Zahlung: St. Paul entschied sich dafür, das Lösegeld nicht zu bezahlen. Stattdessen implementierten sie eine defensive Isolation und eine systematische Wiederherstellung, die den finanziellen Verlust begrenzten und den Anreiz für zukünftige Angriffe verringerten.
- Regierungspartnerschaften: Die Einbindung des FBI und der Nationalgarde brachte Ressourcen und forensische Fähigkeiten mit sich, die das interne Team der Stadt allein nicht bieten konnte.
- Groß angelegte Anmeldeinformationen zurücksetzen: Im Rahmen der Wiederherstellung wurden ungefähr 3.500 Mitarbeiterkonten zurückgesetzt, was eine physische Koordination erfordert, um den Prozess sicher zu verwalten.
Die Lektion: Keine Organisation ist zu groß oder zu gut, um getroffen zu werden. Der Unterschied zwischen einem überschaubaren und einem katastrophalen Fall besteht in der Existenz eines getesteten IR-Plans, einer klaren Handlungsbefugnis und der Beziehungen (zum Strafverfolgungsbehörde, zu Ihrem Hosting-Anbieter, zu einer externen IR-Firma), die vor dem Eintreffen des Angriffs hergestellt werden.
Wie KI im Jahr 2026 die Reaktion auf das Ereignis verändert
Künstliche Intelligenz verändert IR in zwei Richtungen gleichzeitig: Sie beschleunigt die automatische Erkennung und Reaktion und macht Angriffe komplexer und schwerer zu fangen.
KI-gestützte Erkennung und SOAR
Sicherheits-Orchestrierungs-, Automatisierungs- und Antwortplattformen (SOAR) verwenden jetzt maschinelles Lernen, um Warnungen über mehrere Sicherheitstools hinweg zu korrelieren, echte Bedrohungen zu priorisieren und vorab genehmigte Antwortaktionen automatisch auszuführen – ohne darauf zu warten, dass ein Mensch jede Warnung überprüft.
UEBA-Plattformen (User and Entity Behaviour Analytics) erstellen Basismodelle für normales Verhalten für jeden Benutzer und Gerät in Ihrem Netzwerk. Abweichungen von dieser Grundlinie - Ein Benutzer, der um 3 Uhr morgens 50 GB herunterlädt, ein Dienstkonto, das es nie berührt hat - löst Warnungen aus, die regelbasierte Systeme vollständig übersehen.
XDR-Plattformen (Extended Detection and Response) konsolidieren Endpoint-, Netzwerk-, Identitäts- und Cloud-Telemetrie auf einer einzigen Erkennungsfläche, wodurch IR-Teams Sichtbarkeit ohne mehrere separate Tools ermöglicht.
Das falsch positive Problem
KI-gesteuerte Erkennung erzeugt mehr Warnungen. Mehr Warnungen bedeuten mehr Triage-Arbeit. Die Belastung der menschlichen IR-Teams hat erheblich zugenommen, da die KI-Tools empfindlicher werden.
Ein ausgereiftes IR-Programm im Jahr 2026 investiert genauso viel in die Reduktion von falsch positiven wie in die Erkennungsfähigkeit. Schlecht abgestimmte Erkennungsregeln, die auf gutartige Aktivitäten feuern, verschwenden die Reaktionskapazität und - gefährlicher - Teams, um Warnungen zu ignorieren. Das ist genau das Muster, das echte Vorfälle durchschlüpfen lässt.
KI-getriebene Angriffe
Die gleichen KI-Funktionen, die Verteidigern zur Verfügung stehen, stehen Angreifern zur Verfügung. KI wird verwendet, um überzeugendere Phishing-E-Mails zu schreiben, Ziele effizienter zu identifizieren, Malware anzupassen, um der Erkennung zu entgehen und die Aufklärung zu automatisieren. Die Raffinesse von Angriffen nimmt schneller zu, als sich die meisten IR-Programme weiterentwickeln.
Die praktische Implikation: IR-Pläne müssen einen schnelleren Angriffsfortschritt erklären. Das Fenster zwischen anfänglichem Zugriff und vollem Kompromiss ist kürzer als vor zwei Jahren. Erkennungsgeschwindigkeit und Eindämmungsgeschwindigkeit sind mehr denn je wichtig.
Häufig gestellte Fragen
Was sind die 6 Schritte der Vorfallantwort?
Die sechs Schritte der Reaktion auf Vorfälle sind: (1) Vorbereitung - Erstellen Ihres Teams, Tools und Plänen, bevor ein Vorfall eintritt; (2) Identifizierung - Erkennung und Bestätigung, dass ein Sicherheitsvorfall stattgefunden hat; (3) Eindämmung - Isolierung der betroffenen Systeme, um die Ausbreitung des Vorfalls zu verhindern; (4) Ausrottung - Entfernen aller Spuren des Angreifers und Schließen ausgenutzter Schwachstellen; (5) Wiederherstellung — Wiederherstellung der Systeme in den normalen Betrieb sicher und mit Überwachung; (6) Lessons Learned - Durchführen einer Überprüfung nach dem Vorfall innerhalb von 14 Tagen, um Ihre Prozesse zu verbessern.
Was ist der Unterschied zwischen NIST- und SANS-Response-Frameworks?
NIST SP 800-61 konsolidiert die Eindämmung, Ausrottung und Wiederherstellung in einer einzigen Phase, da sich die Arbeit häufig überlappt. SANS unterteilt sie in drei verschiedene Phasen für Teams, die klare stufenweise Handoffs bevorzugen. Beide Frameworks decken die gleichen Kernaktivitäten ab. NIST ist besser geeignet für Organisationen unter US-Bundes-Compliance-Anforderungen oder mit formalen Governance-Strukturen. SANS funktioniert besser für kleinere Teams, die ihr erstes IR-Programm aufbauen.
Wie lange sollte ein Vorfall-Reaktionsplan dauern?
Ein IRP sollte lang genug sein, um vollständig und kurz genug zu sein, um unter Druck gelesen zu werden. Die effektivsten IRPs sind 10 bis 30 Seiten für das Kerndokument mit separaten Playbooks für jeden Angriffstyp. Ein Plan, den niemand während einer Krise liest, ist kein Plan - er ist ein Dokument. Halten Sie das IRP-Kern prägnant und fügen Sie die operativen Details in die Playbooks ein.
Was macht ein Hosting-Provider während eines Server-Sicherheitsvorfalls?
Ein leistungsfähiger Hosting-Anbieter kann während eines Sicherheitsvorfalls mehrere kritische Maßnahmen ergreifen: Implementieren der Isolation auf Netzwerkebene durch Null-Routing der IP Ihres Servers auf BGP-Ebene, Bereitstellung von Out-of-Band-Konsolenzugriff (IPMI/iDRAC) zur Untersuchung eines kompromittierten Servers, ohne sich auf die kompromittierten zu verlassen. Betriebssystem, Aktivieren der DDoS-Filterung und Traffic-Scrubbing, Bereitstellung von Protokollen auf Infrastrukturebene für forensische Analysen und Koordinierung der Wiederherstellung der IP-Reputation während der Wiederherstellung. Bei Atal Networks behandelt unser 24/7-Support-Team Sicherheitsvorfälle als vorrangige Eskalationen und koordiniert direkt mit Ihrem IR-Team oder externen IR-Unternehmen. Kontaktieren Sie unser Team hier.
Wie oft sollten Sie Ihren Vorfallreaktionsplan testen?
Ihr IRP sollte mindestens einmal pro Jahr überprüft und aktualisiert werden. Tabletop-Übungen sollten mindestens zweimal pro Jahr durchgeführt werden - und unmittelbar nach einem signifikanten Vorfall oder einer großen Infrastrukturänderung. Volle simulierte Übungen (rotes Team gegen blaues Team oder Penetrationstests gegen bestimmte Angriffsszenarien) sollten mindestens jährlich ausgeführt werden. Das Ziel ist es niemals, Ihr IRP zu einem Dokument werden zu lassen, das nur auf Papier existiert.
Was ist NIST SP 800-61 Rev 3?
NIST SP 800-61 Revision 3 ist die aktuelle Version des im April 2025 veröffentlichten Dokuments zur Reaktion auf die Reaktion des National Institute of Standards and Technology. Es aktualisiert die vorherige Version 2012 (Rev 2) durch die Integration von Incident Response in das NIST Cybersecurity Framework 2.0, Einführung eines neuen Community-Profils für das Risikomanagement von Cyber-Vorfällen und stärkerer Wert auf kontinuierliche Verbesserung, Dokumentation und Governance. Es ist das am weitesten verbreitete Framework für Incident Response in US-Bundes- und Unternehmensumgebungen.
letztes Wort
Vorfallsreaktionsverfahren sind kein Compliance-Kontrollkästchen. Sie sind der Unterschied zwischen einem Sicherheitsvorfall, der Sie einige Stunden kostet, und einem, der Sie Millionen von Dollar kostet, Kundenvertrauen und monatelange Wiederherstellungsarbeit.
Die Organisationen, die Vorfälle gut behandeln, sind nicht diejenigen mit den besten Werkzeugen. Sie sind diejenigen, die vor dem Angriff vorbereitet, dokumentiert, trainiert und getestet wurden.
Und noch etwas: Ihre Hosting-Infrastruktur ist Teil Ihres IR-Plans, ob Sie so darüber nachgedacht haben oder nicht. Ein Anbieter, der einen kompromittierten Server auf Netzwerkebene isolieren, Ihnen Zugriff auf die Konsolenkonsole gewähren und um 2 Uhr morgens mit Ihrem Team koordinieren kann, ist es wert, darüber nachzudenken, bevor Sie ihn benötigen.
Bei Atal Networks laufen wir VPS-Server, dedizierte Serverund Bare-Metal-Infrastruktur Über 213+ Rechenzentren weltweit. Unser Team steht rund um die Uhr für Sicherheitsvorfälle zur Verfügung. Wenn Sie Ihren IR-Plan überprüfen und verstehen möchten, wie Ihre Hosting-Infrastruktur dazu passt, Wenden Sie sich an unser Support-Team - Wir gehen gerne durch Ihr Setup.
Veröffentlicht von Atal Networks - Globaler Hosting-Provider, der mehr als 36.000 Kunden in 196 Ländern mit dedizierten Servern, VPS-Hosting, Bare-Metal-Infrastruktur und 24/7-Experten-Support bedient.
