


Un ciberataque no espera a que estés listo. Golpea rápido, se propaga rápido y cuesta rápidamente. IBM Costo 2024 de un informe de violación de datos encontró que las organizaciones con un plan formal de respuesta a incidentes y un equipo capacitado ahorraron un promedio de $473,706 por incumplimiento en comparación con aquellos sin uno.
Esa brecha no es una coincidencia. Es el resultado de tener procedimientos claros de respuesta a incidentes antes de que ocurra la violación, no luchar por inventarlos mientras los sistemas se están quemando.
Esta guía lo cubre todo: qué procedimientos de respuesta a incidentes son en realidad, la actualización NIST SP 800-61 Rev 3 Framework Publicado en abril de 2025, un desglose paso a paso de las seis fases y algo que ninguna otra guía cubre, que es lo que su proveedor de infraestructura de alojamiento debería estar haciendo en el momento en que se confirma un incidente.
Si ejecuta su negocio en un servidor VPS, dedicado o servidor de metal desnudo, la capa de infraestructura es parte de su respuesta a incidentes. Esta guía lo trata de esa manera.
índice
- ¿Qué es un procedimiento de respuesta a incidentes?
- NIST SP 800-61 Rev 3: Lo que cambió en abril de 2025
- NIST vs SANS: Elegir el marco correcto
- Las 6 fases de la respuesta a incidentes
- Qué debe hacer su proveedor de alojamiento durante un incidente
- Construyendo su Equipo de Respuesta a Incidentes (CSIRT)
- Procedimientos IR para tipos de ataques comunes
- Respuesta y cumplimiento de incidentes
- Lista de verificación de respuesta a incidentes
- Preguntas frecuentes
¿Qué es un procedimiento de respuesta a incidentes?
Un procedimiento de respuesta a incidentes es un conjunto de acciones paso a paso documentado que su equipo realiza cuando ocurre un incidente de seguridad. Le dice a la gente exactamente quién hace qué, en qué orden y con qué autoridad.
Tres términos se confunden constantemente. Aquí está la diferencia:
| Término | Qué es |
| Marco IR | El modelo estratégico. NIST y SANs publican estos. Es la “constitución” — principios y fases de alto nivel. |
| Plan de respuesta a incidentes (IRP) | El documento táctico para su organización. Nombra a su equipo, sus herramientas, sus rutas de comunicación y sus umbrales de escalada. |
| libro de jugadas | El script operativo para un tipo de ataque específico. Uno para ransomware, uno para DDoS, otro para violación de datos. Sacado del estante en el momento en que se confirma ese incidente. |
La mayoría de las organizaciones tienen un plan. Mucho menos tienen libros de jugadas. Casi ninguno los ha probado.
¿Qué cuenta como un incidente de seguridad?
NIST SP 800-61 Rev 3 Define un incidente de ciberseguridad como una violación o una amenaza inminente de violación de políticas de seguridad informática, políticas de uso aceptable o prácticas de seguridad estándar.
En términos prácticos, esto incluye:
- Infección de ransomware o malware
- Acceso no autorizado a sistemas o datos
- Exfiltración de datos (confirmado o sospechado)
- DDoS Ataques que interrumpen la disponibilidad del servicio
- Actividad de amenazas internas
- Ataques de phishing que resultan en un compromiso de credenciales
- Supply chain compromise
- Denegación de servicio en la red o capa de aplicación
No todas las alertas son un incidente. Parte de un procedimiento IR sólido es el proceso de triaje que separa los falsos positivos de los verdaderos eventos de seguridad que requieren una respuesta.
NIST SP 800-61 Rev 3: Lo que cambió en abril de 2025
En abril de 2025, el Instituto Nacional de Normas y Tecnología (NIST) publicó la versión final de Publicación especial 800-61 Revisión 3 — Su actualización más significativa de la orientación de respuesta a incidentes en más de una década.
La versión anterior (Rev 2, publicada en 2012) trató la respuesta a incidentes como un conjunto lineal acotado de cuatro fases. Detectes un incidente, respondes, te recuperas, escribes un informe de lecciones aprendidas. hecho
Rev 3 cambia ese modelo fundamentalmente.
Cambios clave en SP 800-61 Rev 3
- Integración con CSF 2.0 Rev 3 ya no es una publicación independiente. Se construye como un perfil comunitario dentro del NIST CyberSecurity Framework 2.0. Esto significa que la respuesta a incidentes ahora está entretejida en las seis funciones de CSF: Gobernar, identificar, proteger, detectar, responder y recuperar.
- La mejora continua ahora es explícita El viejo modelo terminó en “Lecciones aprendidas”. Rev 3 trata la mejora continua como un requisito de primera clase, no como una ocurrencia tardía. Se espera que las organizaciones prueben, actualicen y desarrollen sus capacidades de IR de manera continua, no solo después de los incidentes.
- Requisitos de documentación ampliados Rev 3 pone más énfasis en los libros de jugadas, las asignaciones de roles y los árboles de decisión preautorizados. El objetivo es eliminar la improvisación en tiempo real durante un incidente activo.
- El detalle técnico se movió Debido a que los detalles de cómo realizar un cambio de IR rápidamente en diferentes tecnologías y entornos, Rev 3 movió deliberadamente una guía técnica granular a los recursos suplementarios. La propia publicación se centra en los principios de gestión de riesgos que se aplican en todos los entornos.
Si su plan de respuesta a incidentes fue escrito contra la versión 2012, necesita una revisión. Las fases centrales son similares, pero el modelo de gobernanza y los requisitos de mejora continua son materialmente diferentes.
NIST vs SANS: Elegir el marco correcto
Tanto NIST como SAN son ampliamente respetados. Ambos son correctos. La diferencia se reduce a cómo dividen las fases y para qué organizaciones son las más adecuadas.
Comparación lado a lado
| Fase | NIST SP 800-61 Rev 3 | Manual del manipulador de incidentes sin |
| 1 | Preparación | Preparación |
| 2 | Detección y análisis | Identificación |
| 3 | Contención, erradicación y recuperación | Contención |
| 4 | Actividad post-incidente | Erradicación |
| 5 | — | Recuperación |
| 6 | — | Lecciones aprendidas |
La diferencia práctica: NIST agrupa la contención, la erradicación y la recuperación en una sola fase porque el trabajo a menudo se superpone; no debe esperar hasta que se complete la contención antes de comenzar a erradicar las amenazas confirmadas. Sans los separa en tres fases distintas para los equipos que prefieren un claro traspaso entre acciones.
Cuál usar:
- NISTA Funciona mejor para las organizaciones sujetas a los requisitos de cumplimiento federal de EE. UU., empresas más grandes con estructuras de gobernanza definidas y equipos que operan bajo marcos formales de gestión de riesgos.
- nombre de Funciona mejor para equipos de seguridad más pequeños, organizaciones que desean listas de verificación claras, etapa por etapa y equipos que están creando su primer programa de IR.
La respuesta honesta es que ambos producen el mismo resultado cuando se ejecutan correctamente. Elija uno, documéntelo y capacita a su equipo en él.
Las 6 fases de la respuesta a incidentes
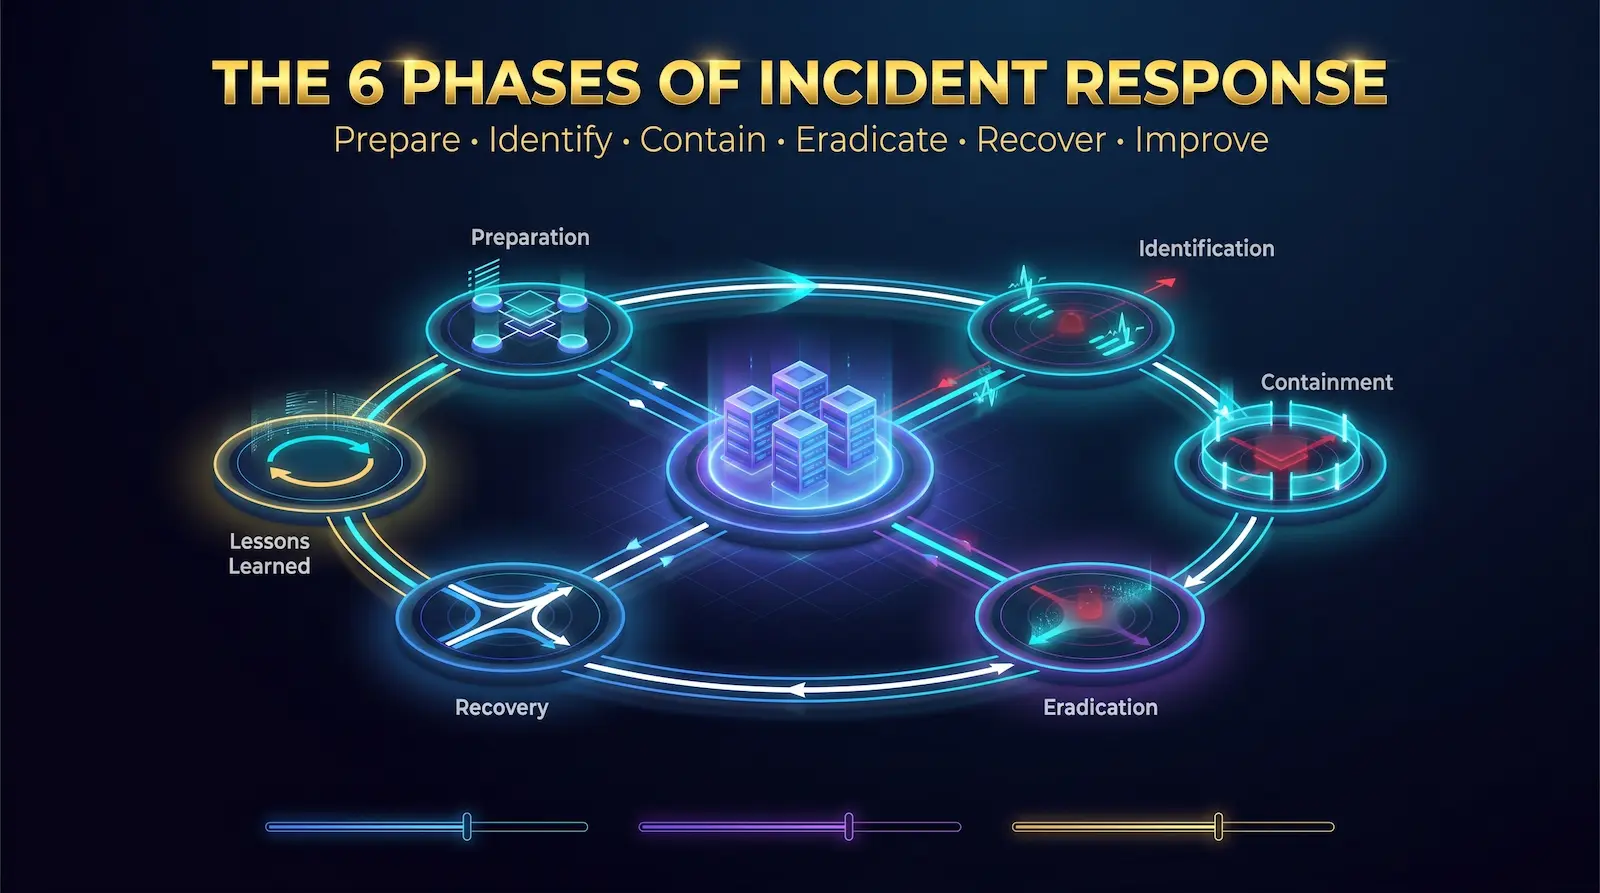
Las seis fases siguientes siguen la Manual del manipulador de incidentes sin modelo porque da la más clara separación operativa entre acciones. La alineación NIST CSF 2.0 se observa cuando sea relevante.
Fase 1: Preparación
Respuesta directa: La preparación es todo lo que hace antes de que ocurra un incidente para garantizar que pueda responder de manera efectiva cuando lo haga.
La preparación es la fase más importante y la que más organizaciones invierten. Cubre:
Equipo y estructura:
- Defina los roles de su Equipo de Respuesta a Incidentes de Ciberseguridad (CSIRT) (cubierto en detalle a continuación)
- Asigne un administrador de incidentes, un líder tecnológico y un gerente de comunicaciones
- Documente la matriz de autoridad: quién puede autorizar el cierre del sistema, quién notifica a los reguladores, quién habla a la prensa
Herramientas y acceso:
- Implementar herramientas de monitoreo: SIEM, EDR, UEBA y análisis de tráfico de red
- Confirme que su equipo tiene canales de comunicación fuera de banda listos: una plataforma de mensajería cifrada separada, un árbol de teléfono o un punto de encuentro físico para cuando los sistemas primarios se caigan
- Mantenga un inventario de activos actualizado para que sepa lo que está protegiendo
Documentación:
- Escriba su IRP y hágalo revisar por Legal, RRHH y Liderazgo Ejecutivo
- Escriba libros de jugadas para sus escenarios de mayor riesgo: ransomware, DDoS, violación de datos, amenaza interna
- Almacene copias impresas en una ubicación segura y sin conexión
Prueba:
- Ejecute los ejercicios de mesa al menos trimestralmente. Una mesa es una sesión de juego de rol donde un facilitador presenta un escenario de ataque y el equipo habla a través de su respuesta.
- Realice pruebas de penetración para encontrar brechas antes de que los atacantes lo hagan
- cronometrar su respuesta y registrar las métricas: esta se convierte en su línea de base para medir la mejora
Preparación específica de hosting (crítica y pasada por alto):
- Conozca el proceso de contacto de incidentes de seguridad de su proveedor de alojamiento antes de que lo necesite
- Confirme lo que cubre su SLA de alojamiento: aislamiento de red, reasignación de IP, acceso a registros y comunicación fuera de banda durante un incidente importante
- En Atal Networks, se puede contactar a nuestro equipo de soporte 24/7 inmediatamente durante un incidente de seguridad del servidor. Póngase en contacto con nuestro equipo de soporte.
Fase 2: Identificación
Respuesta directa: La identificación es el proceso de detectar un incidente potencial, recopilar evidencia y confirmar si se ha producido un verdadero evento de seguridad.
No todas las alertas son un incidente. Esta fase existe para hacer esa determinación con precisión y rapidez.
Los desencadenadores de detección se dividen en dos categorías:
Cargado frontal (advertencia temprana): Fuentes de inteligencia de amenazas, alertas de honeypot, intentos de inicio de sesión anómalos, patrones de tráfico de red inusuales o reglas de correlación de SIEM que se disparan antes de que se produzcan daños. Estos atrapan más falsos positivos pero detienen los ataques antes.
Retrocargado (daño visible): Los usuarios que informan problemas de rendimiento, datos que no están disponibles, notas de rescate o investigadores externos que informan una violación. Es más probable que estos sean incidentes reales, pero llegan después de que el daño haya comenzado.
El proceso de triaje:
- Recopilar todos los datos disponibles: registros, alertas, informes de usuarios y capturas de red
- Determine si el evento es un falso positivo o un incidente verdadero
- Si es un incidente verdadero, clasifíquelo por gravedad (P1/Crítico, P2/Alto, P3/Medio, P4/Bajo)
- Activar el libro de jugadas correspondiente
Principio clave: Registre todo desde este punto en adelante. Cada acción, cada decisión, cada marca de tiempo. Este registro es su registro legal, su documentación de seguro y su material aprendiendo lecciones.
Fase 3: Contención
Respuesta directa: La contención limita el alcance del incidente para evitar que se propague a sistemas o datos adicionales.
La contención tiene dos etapas:
Contención a corto plazo sucede inmediatamente. El objetivo es detener el sangrado rápido. Las acciones incluyen aislar el sistema afectado de la red, bloquear las direcciones IP del atacante, deshabilitar las cuentas de usuario comprometidas y activar el filtrado DDoS si está bajo un ataque volumétrico.
contención a largo plazo sucede mientras se prepara la erradicación. Los sistemas afectados se mantienen funcionando (o se restauran a una imagen limpia) en un entorno aislado para que pueda continuar la investigación forense.
Contención a nivel de servidor: lo que esto significa en la práctica:
Para Entornos VPS, la contención a menudo significa tomar una instantánea de la instancia afectada y girar un reemplazo limpio. La instantánea comprometida se conserva para el análisis forense, pero se mantiene fuera de línea y fuera de la red.
Para servidores dedicados, la contención puede requerir un apagado a nivel de red en el puerto del conmutador o en el nivel de regla del cortafuegos. Su proveedor de alojamiento puede implementar esto en la capa de infraestructura, más rápido de lo que la mayoría de los equipos internos pueden actuar.
Para servidores bare metal, puede ser necesario un aislamiento físico completo. Esto significa que enruta la IP del servidor en el nivel de BGP: el servidor se vuelve inalcanzable desde Internet público mientras su equipo investiga.
Conservar la integridad forense durante la contención. No limpie los sistemas antes de capturar evidencia. Los volcados de memoria, las listas de procesos en ejecución, los estados de conexión de red y las imágenes de disco completo deben capturarse antes de que comience cualquier remediación.
Fase 4: Erradicación
Respuesta directa: La erradicación elimina todos los rastros del ataque de su entorno: malware, puertas traseras, credenciales comprometidas y las vulnerabilidades que se explotaron.
La erradicación debe ser completa o el atacante regresa. La falla más común en IR es creer que un entorno está limpio cuando todavía hay un implante inactivo o inactivo.
Pasos de erradicación:
- Realice un análisis de causa raíz (RCA) para identificar exactamente cómo entró el atacante
- Elimine todos los malwares, las cargas útiles de ransomware y los scripts malintencionados
- Investigar y cerrar la vulnerabilidad explotada (parche, cambio de configuración o revocación de acceso)
- Elimine todas las cuentas de administrador no autorizadas y las claves SSH agregadas por el atacante
- Reconstruir sistemas corruptos o manipulados a partir de una línea base de buena conocida
- Actualizar reglas de firewall y políticas de filtrado de DNS
- Forzar un restablecimiento completo de contraseña para todas las cuentas en el radio de explosión, y para cuentas privilegiadas en toda la organización como precaución
- Gire las claves de la API, las credenciales de la cuenta de servicio y los certificados que pueden haber sido expuestos
La decisión de reconstrucción vs restauración: Reconstruir desde cero lleva más tiempo pero garantiza un sistema limpio. Restaurar desde la copia de seguridad es más rápido pero solo seguro si la copia de seguridad anterior a la violación y la copia de seguridad en sí no se ha visto comprometida. Para incidentes de alta severidad, reconstruya.
Fase 5: Recuperación
Respuesta directa: La recuperación restaura los sistemas afectados a las operaciones normales de forma segura, gradualmente y con el monitoreo establecido para confirmar que la amenaza ha desaparecido.
La recuperación no es una sola acción. Es un proceso controlado y por etapas.
Principios de recuperación
- Restaurar sistemas en orden de criticidad empresarial
- No te apresures. Llevar un sistema comprometido o inestable de nuevo en línea extiende el incidente.
- Implementar un monitoreo mejorado en cada sistema restaurado durante al menos 30 días
- Defina criterios explícitos de ir/no ir antes de poner en marcha cada sistema: no confirme ninguna actividad sospechosa, no haya conexiones de red inesperadas, no haya procesos no autorizados
Etapas de recuperación:
- Restaurar desde una copia de seguridad limpia verificada o una imagen reconstruida
- Aplique todos los parches de seguridad antes de conectarse a la red
- Ponga los sistemas en línea en un entorno escenificado y monitoreado primero
- Validar la funcionalidad con un subconjunto de usuarios antes del tráfico de producción completo
- Escala a plena producción una vez que se confirme la estabilidad
Para entornos de servidor: El papel de su proveedor de alojamiento en la recuperación incluye confirmar la reputación de IP limpia (sin incluir la lista negra del incidente), la restauración del enrutamiento de BGP y verificar que esté activo el monitoreo a nivel de red. En Atal Networks, nuestro equipo de infraestructura trabaja junto con su equipo de seguridad durante la fase de recuperación para confirmar que la capa de red está limpia antes de que se restaure el tráfico completo.
Fase 6: Lecciones aprendidas
Respuesta directa: Lecciones aprendidas es una revisión estructurada del incidente, realizada dentro de los 14 días posteriores a la recuperación completa, para identificar qué funcionó, qué falló y qué necesita cambiar.
NIST SP 800-61 Rev 3 requiere explícitamente que este sea un proceso inocente. Las personas no compartirán observaciones honestas sobre los fracasos si temen el castigo. El objetivo es mejorar el sistema, no castigar a las personas.
La revisión posterior al incidente cubre:
- Un cronograma completo del incidente desde el primer indicador hasta la recuperación total
- qué detección funcionó y qué se perdió
- Si los protocolos de escalada funcionaron correctamente
- si la comunicación (interna y externa) fue clara y oportuna
- si el IRP y los libros de jugadas reflejaron con precisión lo que el equipo necesitaba hacer
- donde los recursos (personas, herramientas, acceso) eran insuficientes
Salidas:
- IRP actualizado y libros de jugadas
- Reglas de detección nuevas o revisadas
- Cambios de configuración o parches identificados durante RCA
- Recomendaciones de capacitación para miembros o departamentos específicos del equipo
- Un informe escrito para los reguladores de liderazgo ejecutivo, legales y (si es necesario)
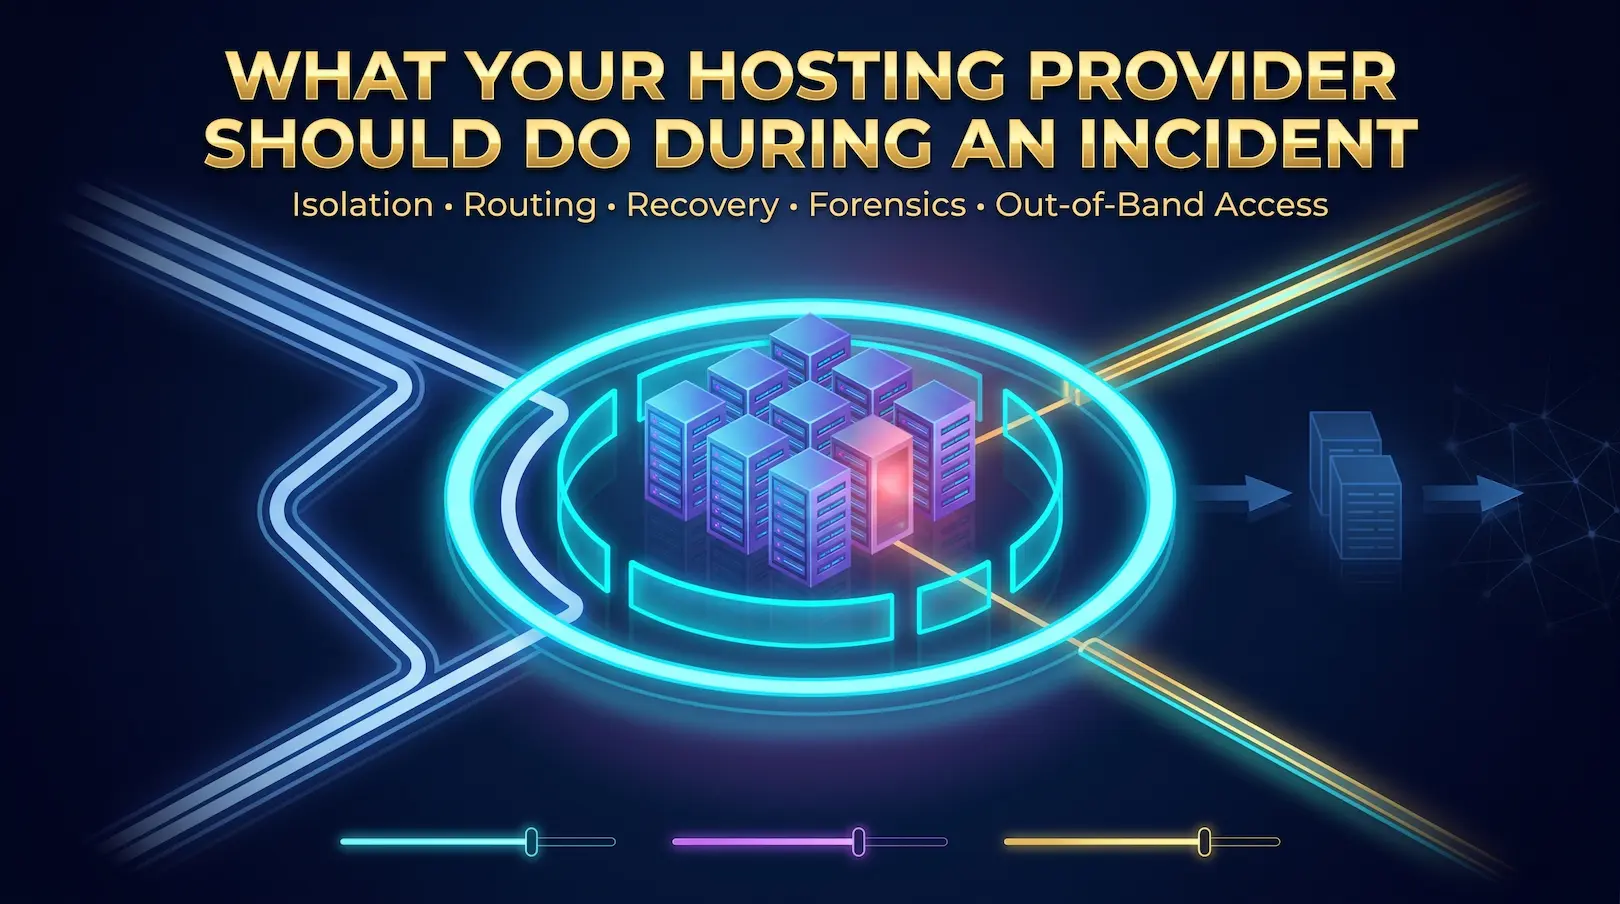
Qué debe hacer su proveedor de alojamiento durante un incidente
Esta es la sección No hay otras cubiertas de guía IR. También es la sección que más importa si su negocio se ejecuta en la nube, VPS o infraestructura de servidores dedicados.
Su proveedor de alojamiento no es un transeúnte pasivo durante un incidente de seguridad. Controlan su acceso a la red, su enrutamiento IP, su hardware de servidor y, en muchos casos, sus canales de comunicación fuera de banda. Un proveedor de alojamiento capaz es parte de su equipo de respuesta a incidentes.
Esto es exactamente lo que su proveedor debería poder hacer:
Aislamiento a nivel de red
Cuando se confirma que un servidor está comprometido, necesita que se corte del resto de Internet de inmediato. Un buen proveedor de alojamiento puede:
- Implemente una ruta nula en el nivel de BGP, haciendo que la IP del servidor sea inalcanzable desde el exterior
- Aplique reglas de firewall en el borde de la red, no solo en el nivel del servidor, para bloquear el movimiento lateral
- Reasigne sus direcciones IP si están en la lista negra debido al spam saliente o al tráfico de ataque desde el servidor comprometido
En Atal Networks, el aislamiento a nivel de red se puede activar de inmediato a través de nuestro equipo de soporte. Operamos en más de 213 centros de datos con redundancia BGP a través de Simply Transit, lo que significa que los cambios de aislamiento y enrutamiento surten efecto en la capa de infraestructura, no solo en el nivel del sistema operativo.
El tipo de servidor importa: Contención por infraestructura
Diferentes tipos de servidores requieren diferentes enfoques de contención. Su IRP debe documentar qué tipo ejecuta y los pasos de contención exactos para cada uno. ¿No está seguro de qué tipo de servidor se ajusta a su carga de trabajo? ver nuestro Comparación de hosting de servidores dedicados vs VPS.
| Tipo de servidor | Enfoque de contención | Acción del proveedor |
| VPS | Instantánea la instancia, girar el reemplazo limpio | El proveedor toma una instantánea a nivel de hipervisor, aísla la interfaz de red virtual de la VM |
| Servidor dedicado | Apagar a nivel de puerto de conmutador o cortafuegos | El proveedor aplica la lista de control de acceso (ACL) en el conmutador, se desconecta de la estructura de red |
| metal desnudo | Complete IP Null-Route + Acceso a la consola fuera de banda | Proveedor Null-Routes BGP, proporciona acceso IPMI/IDRAC para la investigación remota |
| Colocación | Coordinación de acceso físico | El proveedor controla las interconexiones de la red, coordina el acceso para su equipo o la empresa de IR de terceros |
Comunicación fuera de banda durante un incidente
Esta es la pieza de planificación de IR más pasada por alto. Si sus sistemas principales están inactivos: el correo electrónico está caído, Slack está caído, su VPN está baja. ¿Cómo se comunica y coordina su equipo?
Un proveedor de alojamiento serio le brinda acceso fuera de banda a través de:
- IPMI (interfaz de administración de plataforma inteligente): Acceso a nivel de consola al hardware de su servidor independientemente del sistema operativo. Si el sistema operativo está comprometido, aún puede ver lo que está sucediendo y emitir comandos.
- IDRAC / OIT: Tarjetas de administración remota a nivel de fabricante que funcionan incluso cuando el servidor está apagado o el sistema operativo se ha bloqueado.
- Canal de soporte dedicado: Un número de teléfono o un sistema de tickets de emergencia que omite las colas de boletos estándar durante un incidente confirmado.
Si su proveedor de alojamiento no puede ofrecer acceso fuera de banda a sus servidores, esa es una gran brecha en su capacidad de respuesta a incidentes.
Retención de registros y datos forenses
Después de un incidente, necesitará registros. Registros de tráfico de red, registros de acceso, registros de autenticación, registros de consulta de DNS. Su proveedor de alojamiento puede contener registros a nivel de infraestructura que sus sistemas internos no capturan.
Antes de que ocurra un incidente, confirme con su proveedor de alojamiento:
- Qué registros se conservan a nivel de infraestructura
- Qué tan atrás va la ventana de retención (30 días, 90 días, más)
- ¿En qué formato se entregan los registros para el análisis forense?
En Atal Networks, retenemos registros a nivel de infraestructura y podemos proporcionarlos a los clientes durante un incidente de seguridad confirmado. Nuestro equipo de soporte coordina directamente con su equipo de IR o con su empresa IR externa.
Cómo notificar a su proveedor de alojamiento
En el momento en que confirme un incidente de seguridad que afecte a su infraestructura alojada, abra un ticket de soporte inmediatamente y márquelo como una emergencia de seguridad. No espere hasta que se complete la contención.
Información para incluir en su notificación:
- Confirmación de que un incidente de seguridad está en curso
- qué servidores o IP se ven afectados
- Ya sea que necesite aislamiento de red, acceso a registros o acceso a la consola fuera de banda
- Sus datos de contacto de guardia durante la duración del incidente
Contacto Atal Networks Soporte 24/7 — Nuestro equipo está disponible las 24 horas del día y trata los incidentes de seguridad como escalaciones prioritarias.
Construyendo su Equipo de Respuesta a Incidentes (CSIRT)
Un equipo de respuesta a incidentes de ciberseguridad (CSIRT) es el grupo responsable de ejecutar su plan IR cuando ocurre un incidente. Cada miembro tiene un rol definido antes de que ocurra el incidente.
Funciones centrales
Administrador de incidentes (IM) El IM lidera la respuesta. Gestionan los flujos de comunicación, actualizan las partes interesadas, delegan tareas a otros miembros del equipo y rastrean el reloj. Críticamente, el IM no realiza trabajos técnicos durante el incidente. Su trabajo es la coordinación y la toma de decisiones. En una crisis, la dilatación del tiempo es real: la gente pierde la noción de cuánto tiempo están tomando las cosas. El IM monitorea el reloj y mantiene al equipo encaminado.
Líder tecnológico (TL) El TL es el experto en materia técnica. Dirigen las acciones de contención, erradicación y recuperación, traen a especialistas técnicos adicionales según sea necesario y toman decisiones sobre reconstrucción frente a decisiones de restauración. El TL coordina con el equipo de infraestructura de su proveedor de alojamiento.
Gerente de Comunicaciones (CM) El CM gestiona todas las comunicaciones internas y externas durante el incidente. Actualizaciones internas a los empleados y al liderazgo ejecutivo. Comunicaciones externas a clientes, reguladores y medios de comunicación. El CM también prepara las declaraciones de retención por adelantado: un lenguaje preaprobado para escenarios como un reportero que llama sobre una infracción sospechosa.
abogado Legal debe estar involucrado desde el momento en que se confirma un incumplimiento, especialmente cuando se pueden involucrar datos personales. Asesoran sobre los plazos de notificación regulatoria (GDPR: 72 horas, HIPAA: 60 días), requisitos de manejo de evidencia y lo que puede y no puede compartirse externamente.
patrocinador ejecutivo Un alto ejecutivo con autoridad para tomar decisiones a nivel empresarial durante un incidente. Esto incluye la autorización de los cierres del sistema que afectan los ingresos, la aprobación de las comunicaciones y la decisión de contratar a las fuerzas del orden.
Cuándo traer empresas externas de IR
Las empresas de IR externas traen libros de jugadas prefabricados, respondedores experimentados y herramientas forenses que la mayoría de los equipos internos no tienen. Considere contratar uno cuando:
- La gravedad del incidente es P1 (ransomware, filtración de datos, compromiso completo del sistema)
- Su equipo interno carece de experiencia con el tipo de ataque específico
- Necesita evidencia forense independiente para fines legales o de seguro
- el incidente es lo suficientemente grande como para abrumar su capacidad interna
Seleccione su empresa de IR externa antes de que ocurra un incidente. Negociar previamente a un retenedor es mucho mejor que buscar una empresa mientras está bajo ataque.
Ejecución de un ejercicio de mesa
Un ejercicio de mesa es una sesión de juego de rol donde un facilitador presenta un escenario de ataque y el equipo habla a través de su respuesta en tiempo real. No hay sistemas reales involucrados. El valor está en encontrar lagunas en su plan y la toma de decisiones antes de que importen.
Un formato de mesa básico:
- El facilitador presenta el escenario: "Su sistema de monitoreo acaba de marcar el tráfico de salida inusual desde tres servidores. Son las 2 a.m. de un domingo".
- El equipo discute: quién se llama primero, qué acciones se toman, qué información se necesita
- El facilitador inyecta nuevos desarrollos: "Los servidores se confirman comprometidos. Se ha implementado ransomware".
- El equipo continúa la respuesta
- Informe posterior al ejercicio: qué funcionó, qué no, qué brechas se encontraron
Ejecute las mesas al menos dos veces al año. ejecutarlos después de cada incidente significativo o cambio de infraestructura importante.
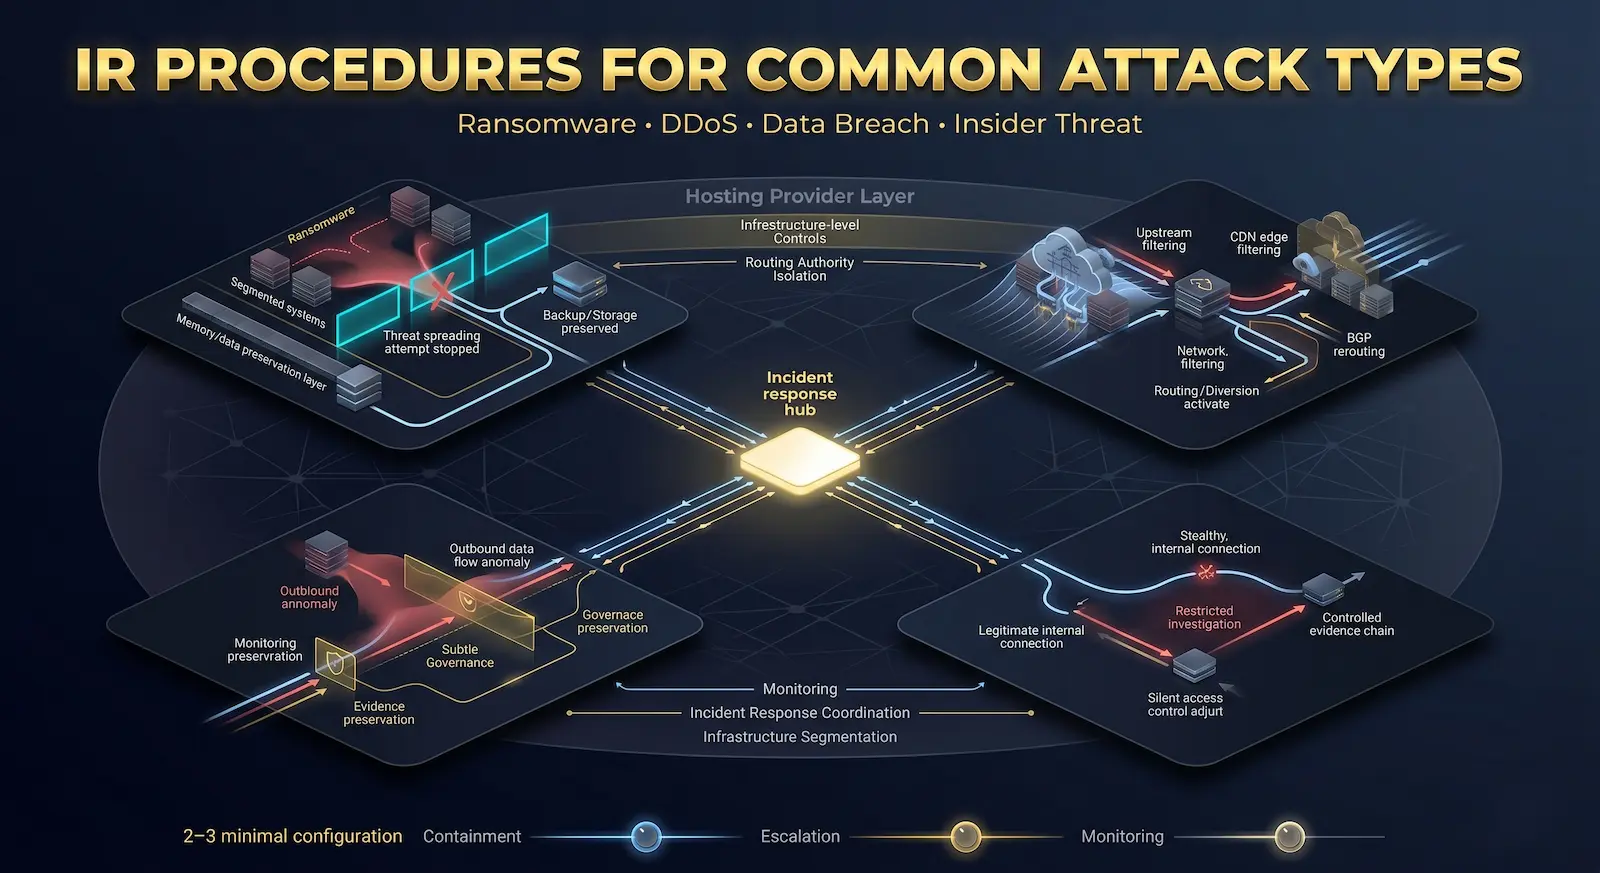
Procedimientos IR para tipos de ataques comunes
Su IRP general cubre las seis fases. Tus libros de jugadas cubren tipos de ataques específicos. Estas son las decisiones y acciones clave para los cuatro escenarios más comunes.
ransomware
El ransomware es el tipo de incidente de mayor prioridad para la mayoría de las organizaciones. La velocidad de contención determina directamente la cantidad de datos encriptados.
La decisión de pago o no pago: Las agencias de aplicación de la ley, incluido el FBI, recomiendan no pagar rescates. El pago no garantiza la recuperación de datos, financia operaciones criminales y puede violar las sanciones de la OFAC si el actor de amenaza está en una lista bloqueada. La mejor posición es una estrategia de respaldo segmentada y probada que hace innecesario el pago.
Acciones críticas:
- Aísle los sistemas afectados inmediatamente a nivel de red (su proveedor de alojamiento puede hacerlo)
- No reinicie los sistemas afectados: los forenses de memoria pueden revelar las herramientas del atacante
- Identifique la variante de ransomware para determinar si existe una clave de descifrado gratuita (comprobar nomoreransom.org)
- Notifique a su operador de seguro cibernético de inmediato
- Involucrar a la aplicación de la ley — Centro de Quejas de Delitos en Internet del FBI (IC3) Recopila informes de ransomware y puede tener inteligencia sobre el actor de amenaza específico
Ataques DDoS
Ataques de denegación de servicio distribuidos Disponibilidad de destino. La respuesta es en la capa de red, lo que convierte a su proveedor de alojamiento en un respondedor principal, no solo en un recurso de soporte.
Acciones de respuesta de hosting-proveedor:
- Activar el filtrado DDoS y el lavado de tráfico en el borde de la red
- Aplicar limitación de velocidad y modelado de tráfico para absorber o redirigir el volumen de ataque
- Implementar bloqueo basado en IP para fuentes de ataque confirmadas
- Involucrar a los proveedores de tránsito ascendente para el tráfico negro si el ataque excede la capacidad de limpieza
Acciones internas:
- Active la capa de protección DDoS de su CDN
- Habilite la limitación de tasas de capa de aplicación en sus servidores web
- Comunicar el tiempo estimado de restauración del servicio a los clientes afectados
- Registre todo el tráfico de ataque para el análisis posterior al incidente
En Atal Networks, nuestra red BGP con simplemente enrutamiento de tránsito incluye capacidades de mitigación DDoS. Vea nuestra infraestructura de servidores desnudos Para obtener detalles sobre lo que se cubre a nivel de infraestructura.
violación de datos
Cuando los datos personales pueden haber sido expuestos, el reloj comienza para la notificación regulatoria.
Cronologías de notificación:
- RGPD: 72 horas para notificar a la autoridad de control correspondiente después de conocer el incumplimiento
- HIPA: 60 días desde el descubrimiento para notificar a la Oficina de Derechos Civiles del HHS
- Leyes de Incumplimiento de Estado (EE. varían según el estado, que van desde 30 a 90 días
Acciones críticas:
- Conservar todas las pruebas antes de cualquier remediación
- Determine el alcance de la exposición: qué datos, cuántos individuos, qué categorías
- contratar asesoría legal de inmediato
- Borrador de notificaciones de clientes y regulaciones: no enviar sin revisión legal
- Documente cada acción tomada con marcas de tiempo para informes regulatorios
Amenaza interna
Las amenazas internas se encuentran entre las más difíciles de detectar y las más sensibles de manejar porque involucran a empleados, contratistas o socios.
Diferencias clave en la respuesta:
- RRHH y LEGAL deben estar involucrados desde la primera indicación
- La recopilación de pruebas debe seguir los procedimientos adecuados de la cadena de custodia para los posibles procedimientos legales
- La comunicación sobre la investigación está restringida a un grupo de necesidad de saber
- La revocación de acceso debe coordinarse cuidadosamente para evitar alertar al sujeto antes de que se asegure la evidencia.
Respuesta y cumplimiento de incidentes
Los marcos de cumplimiento normativo no solo recomiendan los planes IR. Varios los requieren explícitamente, con documentación específica y obligaciones de prueba.
| Marco de referencia | Requisito |
| NIST CSF 2.0 | Las funciones de respuesta y recuperación requieren capacidades IR documentadas. Guía de respuesta a incidentes del NIST |
| ISO 27035 | Estándar internacional específicamente para la gestión de incidentes de seguridad de la información |
| RGPD | Artículo 33: Notificación de incumplimiento dentro de las 72 horas, se requieren procedimientos documentados |
| HIPAA | La regla de seguridad requiere procedimientos documentados de respuesta a incidentes y capacitación de la fuerza laboral |
| PCI DSS | Requisito 12.10: Plan IR documentado, pruebas anuales, capacidad de respuesta 24/7 |
| SOC 2 | La respuesta a incidentes es un criterio central de servicio de confianza de disponibilidad y seguridad |
Para las organizaciones sujetas a múltiples marcos, un solo IRP bien documentado alineado con NIST SP 800-61 Rev 3 cubre la mayoría de los requisitos. La clave es la documentación, pruebas de pruebas y actualizaciones periódicas.
Lista de verificación de respuesta a incidentes
Utilice esta lista de verificación durante un incidente activo. Imprime y mantén una copia sin conexión.
Preparación (pre-incidente)
- [ ] IRP documentado y aprobado por el liderazgo legal, de recursos humanos y ejecutivo
- [ ] Funciones CSIRT asignadas con copias de seguridad con nombre para cada rol
- [ ] Libros de jugadas escritos para ransomware, DDoS, violación de datos y amenaza interna
- [ ] Canales de comunicación fuera de banda probados y confirmados de trabajo
- [ ] Contacto de seguridad de emergencia del proveedor de alojamiento confirmado y almacenado sin conexión
- [ ] Integridad de copia de seguridad verificada — Última fecha de prueba: __________
- [ ] Ejercicio de mesa completado — Última fecha: __________
- [ ] Retenedor de la empresa IR externo en su lugar (si corresponde): ___________
Detección e identificación
- [ ] Alerta recibida o incidente reportado: Hora: __________
- [ ] Triaje inicial completado — Falso positivo o verdadero incidente confirmado
- [ ] Gravedad del incidente Clasificado: P1 / P2 / P3 / P4
- [ ] Administrador de incidentes Notificado: Hora: __________
- [ ] Registro de incidentes abierto y en ejecución
- [ ] Libro de jugadas apropiado activado
Contención
- [ ] Sistemas afectados identificados e inventariados
- [ ] Aislamiento de red implementado (interno + nivel de proveedor)
- [ ] Cuentas comprometidas discapacitadas
- [ ] Evidencia forense capturada antes de que comience la remediación
- [ ] Proveedor de hosting notificado (si la infraestructura del servidor se ve afectada): Hora: ___________
- [ ] Notificado de la policía (si es necesario): Hora: __________
- [ ] Asesor legal contratado: Tiempo: __________
Erradicación
- [ ] Análisis de causa raíz completado
- [ ] Se eliminan todas las herramientas de malware y acceso no autorizado
- [ ] Vulnerabilidad explotada parcheada o mitigada
- [ ] Cuentas y credenciales no autorizadas eliminadas
- [ ] restablecimiento de contraseña iniciado para las cuentas afectadas
Recuperación
- [ ] Plan de recuperación documentado con lista de sistemas priorizados
- [ ] Integridad de respaldo verificada antes de la restauración
- [ ] Sistemas restaurados y validados antes de volver a la producción
- [ ] Monitoreo mejorado activo en sistemas restaurados
- [ ] Proveedor de alojamiento confirmado Reputación IP limpia y enrutamiento de red
post-incidente
- [ ] Reunión aprendida de lecciones programada (dentro de 14 días): Fecha: ___________
- [ ] IRP y libros de jugadas actualizados en base a hallazgos
- [ ] Notificaciones regulatorias enviadas (si es necesario): Fecha: __________
- [ ] Se ha completado la información ejecutiva y de la junta
- [ ] Informe de incidente presentado ante la compañía de seguros (si corresponde)
Estudio de caso del mundo real: ataque de ransomware de St. Paul (2025)
En julio de 2025, la ciudad de St. Paul, Minnesota, fue golpeada por un ataque coordinado de ransomware que interrumpió los servicios gubernamentales en toda la ciudad. La respuesta demostró lo que funciona y lo que las organizaciones deben prepararse en incidentes de alta severidad.
La línea de tiempo:
- 25 de julio: actividad sospechosa detectada en redes de ciudades. El equipo de TI comienza el triaje de investigación de inmediato.
- 27 de julio: Comportamiento malicioso confirmado. Ciudad Cierra todos los sistemas de información de manera proactiva para evitar una mayor propagación.
- Días siguientes: FBI contratado para la contención y la investigación forense. Activos cibernéticos de la Guardia Nacional de Minnesota activados por el gobernador.
Lo que funcionó:
- Detección temprana: la alerta inicial del 25 de julio le dio al equipo dos días antes de tomar la decisión de apagado. Esa ventana de detección fue fundamental.
- Aislamiento sobre el pago: San Pablo optó por no pagar el rescate. En cambio, implementaron el aislamiento defensivo y la recuperación sistemática, lo que limitó la pérdida financiera y redujo el incentivo para futuros ataques.
- Alianzas gubernamentales: la participación del FBI y la Guardia Nacional trajo recursos y capacidad forense que el equipo interno de la ciudad no pudo proporcionar.
- Restablecimiento de credenciales a gran escala: se restablecieron aproximadamente 3500 cuentas de empleados como parte de la recuperación, lo que requirió coordinación física para administrar el proceso de forma segura.
La lección: Ninguna organización es demasiado grande o tiene demasiados recursos para ser golpeada. La diferencia entre un incidente manejable y uno catastrófico es la existencia de un plan IR probado, una autoridad clara para actuar y las relaciones (con la aplicación de la ley, con su proveedor de alojamiento, con una firma de IR externa) establecidas antes de que llegue el ataque.
Cómo la IA está cambiando la respuesta a incidentes en 2026
La inteligencia artificial está cambiando IR en dos direcciones simultáneamente: está haciendo que la detección y la respuesta automatizadas sean más rápidas, y está haciendo que los ataques sean más sofisticados y difíciles de atrapar.
Detección y SOAR con IA
Las plataformas de orquestación, automatización y respuesta (SOAR) de seguridad ahora utilizan el aprendizaje automático para correlacionar alertas en múltiples herramientas de seguridad, priorizar amenazas genuinas y ejecutar acciones de respuesta previamente aprobadas automáticamente, sin esperar a que un humano revise cada alerta.
Las plataformas UEBA (Analytics de comportamiento de usuario y entidad) crean modelos de línea de base de comportamiento normal para cada usuario y dispositivo de su red. Las desviaciones de esa línea de base: un usuario que descarga 50 GB a las 3 a. m., una cuenta de servicio que accede a los sistemas que nunca ha tocado, desencadenan alertas que los sistemas basados en reglas fallan por completo.
Las plataformas XDR (detección y respuesta extendidas) consolidan el punto final, la red, la identidad y la telemetría en la nube en una sola superficie de detección, lo que brinda a los equipos de IR una visibilidad que antes era imposible sin múltiples herramientas separadas.
El problema falso positivo
La detección impulsada por IA genera más alertas. Más alertas significa más trabajo de triaje. La carga de triaje en los equipos humanos de IR ha aumentado significativamente a medida que las herramientas de IA se vuelven más sensibles.
Un programa de IR maduro en 2026 invierte tanto en reducción de falsos positivos como en capacidad de detección. Las reglas de detección mal ajustadas que disparan contra la capacidad de respuesta desperdician la actividad benigna y, lo que es más peligroso, entrenan a los equipos para ignorar las alertas. Ese es exactamente el patrón que permite que los incidentes reales se deslicen.
Ataques impulsados por IA
Las mismas capacidades de IA disponibles para los defensores están disponibles para los atacantes. La IA se está utilizando para escribir correos electrónicos de phishing más convincentes, identificar objetivos de manera más eficiente, adaptar el malware para evadir la detección y automatizar el reconocimiento. La sofisticación de los ataques está aumentando más rápido de lo que están evolucionando la mayoría de los programas de IR.
La implicación práctica: los planes de IR deben dar cuenta de una progresión de ataque más rápida. La ventana entre el acceso inicial y el compromiso total es más corta de lo que era hace dos años. La velocidad de detección y la velocidad de contención importan más que nunca.
Preguntas frecuentes
¿Cuáles son los 6 pasos de la respuesta a incidentes?
Los seis pasos de la respuesta a incidentes son: (1) preparación: construir su equipo, herramientas y planes antes de que ocurra un incidente; (2) Identificación: detectar y confirmar que se ha producido un incidente de seguridad; (3) Contención: aislar los sistemas afectados para detener la propagación del incidente; (4) Erradicación: eliminar todos los rastros del atacante y cerrar las vulnerabilidades explotadas; (5) Recuperación — Restauración de sistemas a la operación normal de forma segura y con monitoreo en su lugar; (6) Lecciones aprendidas: realizar una revisión posterior al incidente dentro de los 14 días para mejorar sus procesos.
¿Cuál es la diferencia entre los marcos de respuesta a incidentes NIST y SANS?
NIST SP 800-61 consolida la contención, la erradicación y la recuperación en una sola fase porque el trabajo a menudo se superpone. Sans los separa en tres fases distintas para los equipos que prefieren los traspasos claros etapa por etapa. Ambos marcos cubren las mismas actividades básicas. NIST es más adecuado para organizaciones bajo los requisitos de cumplimiento federal de EE. UU. o con estructuras de gobierno formales. SANS funciona mejor para equipos más pequeños que construyen su primer programa de IR.
¿Cuánto tiempo debe ser un plan de respuesta a incidentes?
Un IRP debe ser lo suficientemente largo para ser completo y lo suficientemente corto como para ser leído bajo presión. Los IRP más efectivos son de 10 a 30 páginas para el documento principal, con libros de jugadas separados para cada tipo de ataque. Un plan que nadie lee durante una crisis no es un plan, es un documento. Mantenga el IRP central conciso y coloque los detalles operativos en los playbooks.
¿Qué hace un proveedor de alojamiento durante un incidente de seguridad del servidor?
Un proveedor de hosting capaz puede realizar varias acciones críticas durante un incidente de seguridad: Implementar el aislamiento a nivel de red mediante el enrutamiento nulo de la IP de su servidor en el nivel de BGP, proporcionando acceso a la consola fuera de banda (IPMI/IDRAC) para investigar un servidor comprometido sin depender de lo comprometido SO, activación de filtrado DDoS y limpieza de tráfico, proporcionando registros a nivel de infraestructura para análisis forense y coordinación de restauración de reputación de IP durante la recuperación. En Atal Networks, nuestro equipo de soporte 24/7 trata los incidentes de seguridad como escalaciones prioritarias y coordina directamente con su equipo de IR o su empresa de IR externa. Contacte a nuestro equipo aquí.
¿Con qué frecuencia debe probar su plan de respuesta a incidentes?
Su IRP debe ser revisado y actualizado al menos una vez al año. Los ejercicios de mesa deben realizarse al menos dos veces al año, e inmediatamente después de cualquier incidente significativo o cambio importante de infraestructura. Los ejercicios simulados completos (Equipo rojo contra equipo azul o pruebas de penetración contra escenarios de ataque específicos) deben ejecutarse al menos una vez al año. El objetivo es nunca dejar que su IRP se convierta en un documento que solo existía en papel.
¿Qué es NIST SP 800-61 Rev 3?
NIST SP 800-61 La revisión 3 es la versión actual del documento de orientación de respuesta a incidentes del Instituto Nacional de Estándares y Tecnología, publicado en abril de 2025. Actualiza la versión anterior de 2012 (Rev 2) al integrar la respuesta de incidentes en la ciberseguridad del NIST Marco 2.0, introduciendo un nuevo perfil comunitario para la gestión de riesgos de incidentes cibernéticos y poniendo mayor énfasis en la mejora continua, la documentación y la gobernanza. Es el marco de respuesta a incidentes más referenciado en los entornos federales y empresariales de EE. UU.
última palabra
Los procedimientos de respuesta a incidentes no son una casilla de verificación de cumplimiento. Son la diferencia entre un incidente de seguridad que le cuesta unas pocas horas y uno que le cuesta millones de dólares, confianza del cliente y meses de trabajo de recuperación.
Las organizaciones que manejan bien los incidentes no son las que tienen las mejores herramientas. Ellos son los que prepararon, documentaron, entrenaron y probaron antes de que llegara el ataque.
Y una cosa más: su infraestructura de alojamiento es parte de su plan IR, ya sea que lo haya pensado de esa manera o no. Vale la pena pensar en un proveedor que puede aislar un servidor comprometido a nivel de red, brindarle acceso fuera de banda y coordinar con su equipo a las 2 a.m. antes de necesitarlo.
En Atal Networks, ejecutamos Servidores VPS, servidores dedicadosy infraestructura bare metal en más de 213 centros de datos en todo el mundo. Nuestro equipo está disponible 24/7 para incidentes de seguridad. Si está revisando su plan IR y desea comprender cómo encaja su infraestructura de alojamiento, Comuníquese con nuestro equipo de soporte — Nos complace recorrer su configuración.
Publicado por Atal Networks — Proveedor de hosting global que atiende a más de 36.000 clientes en 196 países con servidores dedicados, alojamiento VPS, infraestructura de metal simple y soporte experto 24/7.