


Une cyberattaque n'attend pas que vous soyez prêt. Il frappe rapidement, se propage rapidement et coûte rapidement. IBM 2024 Coût d'un rapport de violation de données ont constaté que les organisations dotées d'un plan formel de réponse aux incidents et d'une équipe formée ont économisé en moyenne 1 TP4T473 706 par infraction par rapport à celles qui n'en ont pas.
Cet écart n'est pas une coïncidence. C'est le résultat d'avoir des procédures claires de réponse aux incidents avant que la violation ne se produise - sans se démener pour les inventer pendant que les systèmes brûlent.
Ce guide couvre tout : quelles sont les procédures de réponse aux incidents, la mise à jour NIST SP 800-61 REV 3 Framework publié en avril 2025, une ventilation étape par étape des six phases, et quelque chose qu'aucun autre guide ne couvre, ce que votre fournisseur d'infrastructure d'hébergement devrait faire au moment où un incident est confirmé.
Si vous exécutez votre entreprise sur un VPS, un serveur dédié ou un serveur Bare Metal, la couche d'infrastructure fait partie de votre réponse aux incidents. Ce guide le traite de cette façon.
Table des matières
- What Is an Incident Response Procedure?
- NIST SP 800-61 REV 3 : ce qui a changé en avril 2025
- NIST vs SANS : Choisir le bon framework
- Les 6 phases de réponse aux incidents
- Ce que votre fournisseur d'hébergement doit faire lors d'un incident
- Construire votre équipe de réponse aux incidents (CSIRT)
- Procédures IR pour les types d'attaque courant
- Réponse aux incidents et conformité
- Incident Response Checklist
- Questions fréquemment posées
What Is an Incident Response Procedure?
Une procédure de réponse aux incidents est un ensemble documenté, étape par étape, d'actions que votre équipe entreprend lorsqu'un incident de sécurité se produit. Il dit aux gens qui fait quoi, dans quel ordre et avec quelle autorité.
Trois termes deviennent constamment confus. Voici la différence :
| Terme | Ce que c'est |
| Cadre IR | Le modèle stratégique. NIST et SANS publient ces deux éléments. Il s'agit de la « Constitution » — principes et phases de haut niveau. |
| Plan de réponse aux incidents (IRP) | Le document tactique pour votre organisation. Il nomme votre équipe, vos outils, vos chemins de communication et vos seuils d'escalade. |
| Livre de jeu IR | Le script opérationnel pour un type d'attaque spécifique. Un pour les ransomwares, un pour DDoS, un pour la violation de données. J'ai retiré l'étagère au moment où l'incident est confirmé. |
La plupart des organisations ont un plan. Beaucoup moins ont des playbooks. Presque aucun ne les a testés.
Qu'est-ce qui compte comme un incident de sécurité ?
NIST SP 800-61 REV 3 définit un incident de cybersécurité comme une violation ou une menace imminente de violation, des politiques de sécurité informatique, des politiques d'utilisation acceptables ou des pratiques de sécurité standard.
Concrètement, cela comprend :
- Infection de ransomware ou de logiciel malveillant
- Accès non autorisé aux systèmes ou aux données
- Exfiltration de données (confirmée ou suspectée)
- Attaques DDoS perturbant la disponibilité des services
- Activité de menace interne
- Attaques de phishing qui entraînent un compromis d'identification
- Supply chain compromise
- Déni de service sur le réseau ou la couche d'application
Toutes les alertes ne sont pas un incident. Une partie d'une procédure IR solide est le processus de triage qui sépare les faux positifs des véritables événements de sécurité qui nécessitent une réponse.
NIST SP 800-61 REV 3 : ce qui a changé en avril 2025
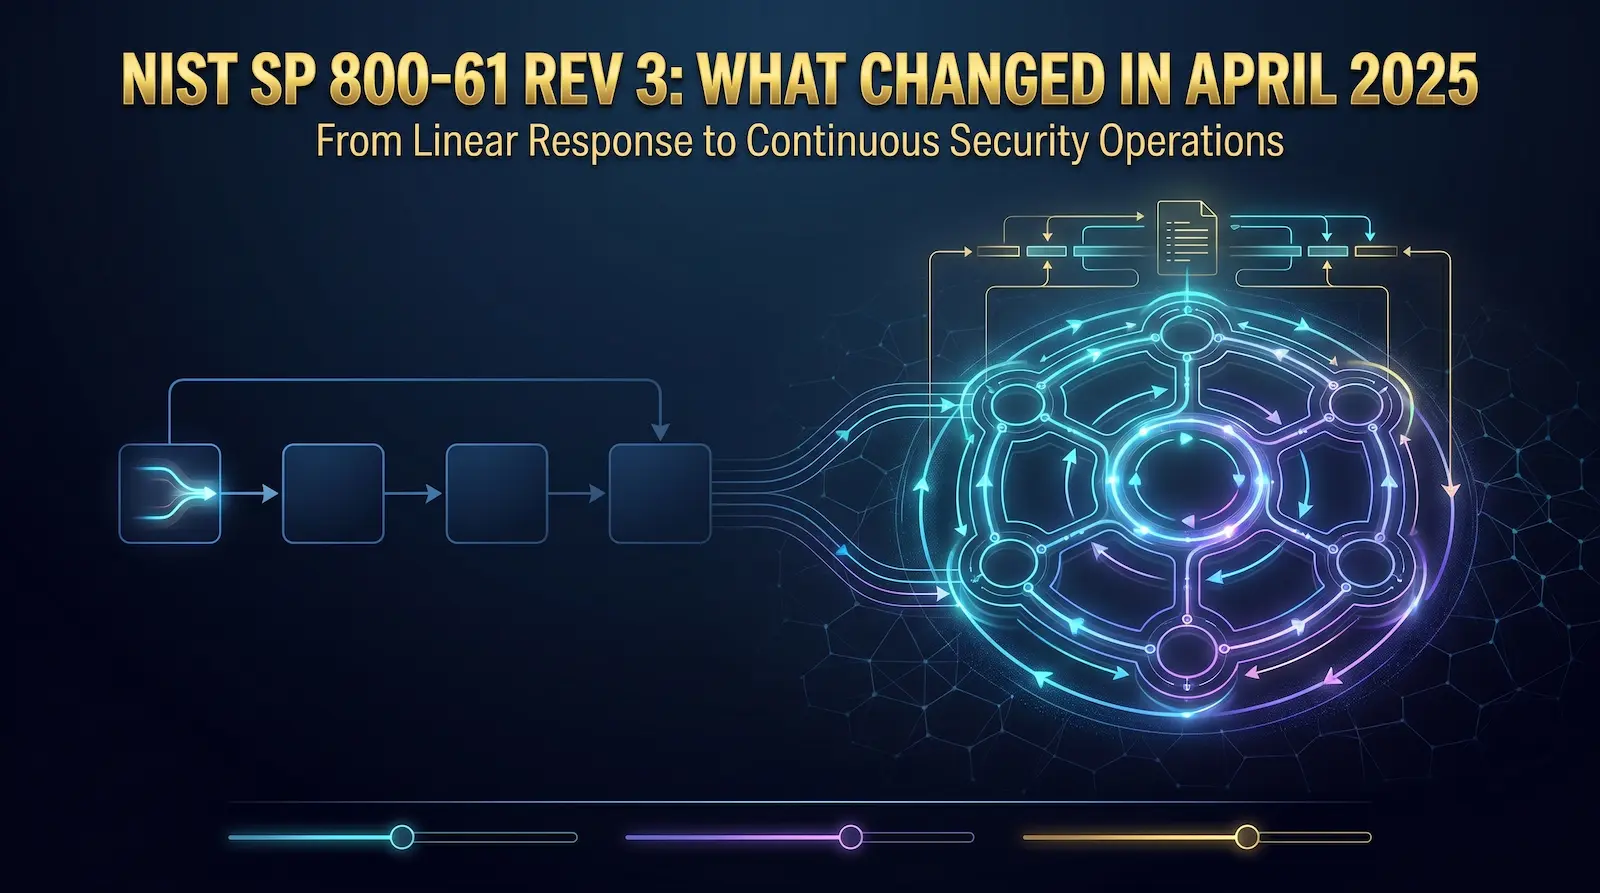
En avril 2025, le National Institute of Standards and Technology (NIST) a publié la version finale de Publication spéciale 800-61 Révision 3 — Sa mise à jour la plus importante concernant les directives de réponse aux incidents depuis plus d'une décennie.
La version précédente (Rev 2, publiée en 2012) a traité la réponse aux incidents comme un ensemble borné et linéaire de quatre phases. Vous détectez un incident, vous répondez, vous récupérez, vous rédigez un rapport appris. Terminé.
La rév 3 change fondamentalement ce modèle.
Principaux changements dans SP 800-61 REV 3
- Intégration avec CSF 2.0 La Rév. 3 n'est plus une publication autonome. Il est construit comme un profil de communauté dans le cadre du NIST Cybersecurity Framework 2.0. Cela signifie que la réponse aux incidents est désormais intégrée dans les six fonctions du LCR : régir, identifier, protéger, détecter, répondre et récupérer.
- L'amélioration continue est désormais explicite L'ancien modèle s'est terminé à "Leçons apprises". La Rev 3 traite l'amélioration continue comme une exigence de première classe, et non une réflexion après coup. Les organisations doivent tester, mettre à jour et faire évoluer leurs capacités en continu sur une base continue, pas seulement après les incidents.
- Exigences de documentation développées La Rév. 3 met davantage l'accent sur les livres de jeu écrits, les affectations de rôle et les arbres de décision préautorisés. L'objectif est d'éliminer l'improvisation en temps réel lors d'un incident actif.
- Le détail technique a déménagé Étant donné que les spécificités de la façon d'effectuer une IR changent rapidement dans les différentes technologies et environnements, la réf. 3 a délibérément déplacé les conseils techniques granulaires vers les ressources supplémentaires. La publication elle-même se concentre sur les principes de gestion des risques qui s'appliquent à tous les environnements.
Si votre plan de réponse aux incidents a été rédigé par rapport à la version 2012, il a besoin d'un examen. Les phases de base sont similaires, mais le modèle de gouvernance et les exigences d'amélioration continue sont sensiblement différents.
NIST vs SANS : Choisir le bon framework
Le NIST et le SAN sont largement respectés. Les deux sont corrects. La différence se résume à la façon dont ils divisent les phases et à quelles organisations ils conviennent le mieux.
Comparaison côte à côte
| Phase | NIST SP 800-61 REV 3 | Manuel du gestionnaire d'incident sans incident |
| 1 | Préparation | Préparation |
| 2 | Détection et analyse | Identification |
| 3 | Confinement, éradication et récupération | Endiguement |
| 4 | Activité post-incident | Éradication |
| 5 | — | Récupération |
| 6 | — | Leçons apprises |
La différence pratique : Le confinement, l'éradication et la récupération des groupes NIST en une seule phase, car le travail se chevauche souvent - vous ne devez pas attendre que le confinement soit terminé 100% avant de commencer à éradiquer les menaces confirmées. SANS les sépare en trois phases distinctes pour les équipes qui préfèrent un transfert clair entre les actions.
Lequel utiliser :
- niste Fonctionne mieux pour les organisations soumises aux exigences fédérales américaines, les grandes entreprises avec des structures de gouvernance définies et les équipes qui opèrent dans des cadres formels de gestion des risques.
- sans Fonctionne mieux pour les petites équipes de sécurité, les organisations qui souhaitent des listes de vérifications claires, étape par étape, et les équipes qui créent leur premier programme IR.
La réponse honnête est que les deux produisent le même résultat lorsqu'ils sont exécutés correctement. Choisissez-en un, documentez-le et formez votre équipe.
Les 6 phases de réponse aux incidents
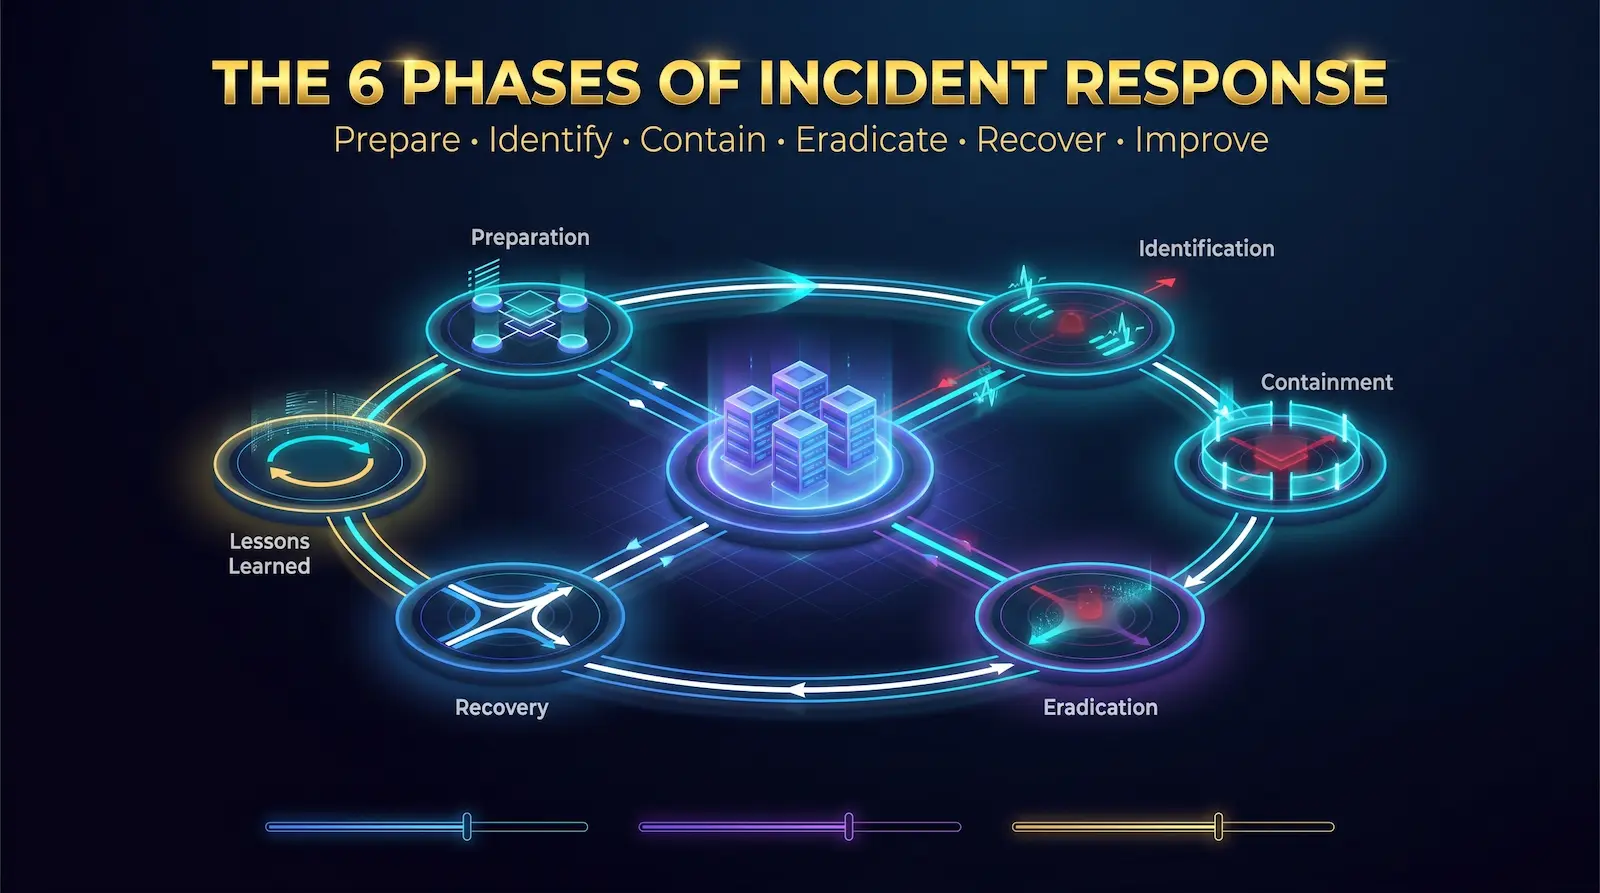
Les six phases ci-dessous suivent la Manuel du gestionnaire d'incidents sans incident modèle car il donne la séparation opérationnelle la plus claire entre les actions. L'alignement NIST CSF 2.0 est noté le cas échéant.
Phase 1 : préparation
Réponse directe : La préparation est tout ce que vous faites avant qu'un incident ne se produise pour vous assurer de pouvoir réagir efficacement lorsque vous le faites.
La préparation est la phase la plus importante et la plus importante des organisations sous-investies. Elle couvre :
Équipe et structure :
- Définissez les rôles de votre équipe de réponse aux incidents de cybersécurité (CSIRT) (couverts en détail ci-dessous)
- Attribuer un responsable des incidents, un responsable technique et un responsable des communications
- Documenter la matrice des autorités : qui peut autoriser l'arrêt du système, qui informe les régulateurs, qui s'adresse à la presse
Outils et accès :
- Déployez des outils de surveillance : SIEM, EDR, UEBA et analyse du trafic réseau
- Confirmez que votre équipe dispose de canaux de communication hors bande prêts : une plate-forme de messagerie cryptée distincte, une arborescence téléphonique ou un point de rencontre physique lorsque les systèmes primaires tombent en panne.
- Maintenez un inventaire d'actifs à jour afin de savoir ce que vous protégez
Documentation :
- Rédigez votre IRP et faites-le réviser par le leadership juridique, RH et exécutif
- Rédigez des playbooks pour vos scénarios les plus risqués : ransomware, DDoS, violation de données, menace d'initié
- Stockez des copies papier dans un emplacement sécurisé et hors connexion
Test :
- Exécutez des exercices de table au moins un trimestre. Un plateau est une session de jeu de rôle où un facilitateur présente un scénario d'attaque et l'équipe parle de sa réponse.
- Exécutez des tests de pénétration pour trouver des lacunes avant que les attaquants ne le fassent
- Chronométrez votre réponse et enregistrez les mesures - cela devient votre base de données pour mesurer l'amélioration
Préparation spécifique à l'hébergement (critique et négligé):
- Connaissez le processus de contact avec les incidents de sécurité de votre fournisseur d'hébergement avant d'en avoir besoin
- Confirmez ce que couvre votre SLA d'hébergement : isolation réseau, réaffectation IP, accès au journal et communication hors bande lors d'un incident majeur
- Chez Atal Networks, notre équipe d'assistance 24h/24 et 7j/7 peut être contactée immédiatement lors d'un incident de sécurité de serveur. Contactez notre équipe d'assistance ici.
Phase 2 : Identification
Réponse directe : L'identification est le processus de détection d'un incident potentiel, de collecte de preuves et de confirmation de l'apparition d'un véritable événement de sécurité.
Toutes les alertes ne sont pas un incident. Cette phase existe pour faire cette détermination avec précision et rapidité.
Les déclencheurs de détection se répartissent en deux catégories :
Chargement frontal (avertissement précoce): Flux de renseignements sur les menaces, alertes de pots de miel, tentatives de connexion anormales, modèles de trafic réseau inhabituels ou règles de corrélation SIEM qui se déclenchent avant que des dommages ne se produisent. Ceux-ci captent plus de faux positifs mais arrêtent les attaques plus tôt.
Remontée (dégâts visibles) : Les utilisateurs signalent des problèmes de performances, des données non disponibles, des notes de rançon ou des chercheurs externes signalant une violation. Ceux-ci sont plus susceptibles d'être des incidents réels mais arrivent après que les dommages ont commencé.
Le processus de triage :
- Collectez toutes les données disponibles : journaux, alertes, rapports d'utilisateurs et captures réseau
- Déterminer si l'événement est un faux positif ou un véritable incident
- Si un véritable incident, classez-le par gravité (P1/critique, P2/élevé, P3/moyen, P4/faible)
- Activer le livre de jeu approprié
Principe clé : Enregistrez tout à partir de ce moment. Chaque action, chaque décision, chaque horodatage. Ce journal est votre dossier légal, votre documentation d'assurance et votre matériel appris.
Phase 3 : Confinement
Réponse directe : Le confinement limite la portée de l'incident afin de l'empêcher de se propager à d'autres systèmes ou données.
Le confinement comporte deux étapes :
Confinement à court terme arrive immédiatement. Le but est d'arrêter le saignement rapidement. Les actions comprennent l'isolement du système affecté du réseau, le blocage des adresses IP de l'attaquant, la désactivation des comptes d'utilisateurs compromis et l'activation du filtrage DDoS si l'on fait l'objet d'une attaque volumétrique.
Confinement à long terme se produit pendant que l'éradication est en cours de préparation. Les systèmes affectés sont maintenus en cours d'exécution (ou restaurés à une image propre) dans un environnement isolé afin que l'enquête médico-légale puisse se poursuivre.
Confinement au niveau du serveur : ce que cela signifie en pratique :
Pour Environnements VPS, le confinement signifie souvent prendre un instantané de l'instance concernée et faire tourner un remplacement propre. L'instantané compromis est préservé pour l'analyse médico-légale, mais conservé hors connexion et hors réseau.
Pour serveurs dédiés, le confinement peut nécessiter un arrêt au niveau du réseau au niveau du port de commutation ou du pare-feu. Votre fournisseur d'hébergement peut implémenter cela à la couche d'infrastructure, plus rapidement que la plupart des équipes internes ne peuvent agir.
Pour serveurs bare metal, une isolation physique complète peut être nécessaire. Cela signifie que le routage null de l'IP du serveur au niveau BGP - le serveur devient inaccessible à partir d'Internet public pendant que votre équipe enquête.
Préserver l'intégrité médico-légale pendant le confinement. N'essuyez pas les systèmes avant de saisir des preuves. Les vidages de mémoire, les listes de processus en cours d'exécution, les états de connexion réseau et les images de disques complets doivent tous être capturés avant le début de toute correction.
Phase 4 : Éradication
Réponse directe : L'éradication supprime toutes les traces de l'attaque de votre environnement : logiciels malveillants, portes dérobées, informations d'identification compromises et les vulnérabilités qui ont été exploitées.
L'éradication doit être approfondie ou l'attaquant revient. La défaillance la plus fréquente dans l'IR est de croire qu'un environnement est propre lorsqu'une porte dérobée ou un implant dormant est toujours présent.
Étapes d'éradication :
- Effectuer une analyse des causes profondes (RCA) pour identifier exactement comment l'attaquant est entré
- Supprimez tous les logiciels malveillants, les charges utiles de ransomware et les scripts malveillants
- Rechercher et fermer la vulnérabilité exploitée (patch, modification de la configuration ou révocation d'accès)
- Supprimez tous les comptes administrateurs et clés SSH non autorisés ajoutés par l'attaquant
- Reconstruire des systèmes corrompus ou manipulés à partir d'une ligne de base connue et bonne
- Mettre à jour les règles de pare-feu et les règles de filtrage DNS
- Forcer une réinitialisation complète du mot de passe pour tous les comptes dans le rayon de souffle — et pour les comptes privilégiés de toute l'organisation par précaution
- Faites pivoter les clés d'API, les informations d'identification du compte de service et les certificats qui peuvent avoir été exposés
La décision de reconstruction ou de restauration : La reconstruction à partir de zéro prend plus de temps mais garantit un système propre. La restauration à partir de la sauvegarde est plus rapide mais uniquement sûre si la sauvegarde est antérieure à la violation et que la sauvegarde elle-même n'a pas été compromise. Pour les incidents de haute gravité, reconstruisez.
Phase 5 : Récupération
Réponse directe : La récupération restaure les systèmes affectés en fonctionnement normal en toute sécurité, graduellement et avec une surveillance en place pour confirmer que la menace a disparu.
La récupération n'est pas une action unique. Il s'agit d'un processus contrôlé et mis en scène.
Principes de récupération :
- Restaurer les systèmes par ordre de criticité commerciale
- Ne vous précipitez pas. La mise en ligne d'un système compromis ou instable prolonge l'incident.
- Mettre en œuvre une surveillance améliorée sur chaque système restauré pendant au moins 30 jours
- Définissez des critères de départ/non-going explicites avant de mettre en service chaque système. Confirmez aucune activité suspecte, aucune connexion réseau inattendue, aucun processus non autorisé
Étapes de récupération :
- Restaurer à partir d'une sauvegarde propre vérifiée ou d'une image reconstruite
- Appliquer tous les correctifs de sécurité avant de se connecter au réseau
- Mettre les systèmes en ligne dans un environnement organisé et surveillé en premier
- Valider la fonctionnalité avec un sous-ensemble d'utilisateurs avant le trafic de production complet
- Échelle de production complète une fois la stabilité confirmée
Pour les environnements de serveurs : Le rôle de votre fournisseur d'hébergement dans la récupération comprend la confirmation de la propre réputation IP (aucune liste noire de l'incident), la restauration du routage BGP et la vérification de la surveillance au niveau du réseau. Chez Atal Networks, notre équipe d'infrastructure travaille aux côtés de votre équipe de sécurité pendant la phase de récupération pour confirmer que la couche réseau est propre avant que le trafic complet ne soit restauré.
Phase 6 : Leçons apprises
Réponse directe : Les leçons apprises sont un examen structuré de l'incident, mené dans les 14 jours suivant la récupération complète, afin d'identifier ce qui a fonctionné, ce qui a échoué et ce qui doit changer.
NIST SP 800-61 REV 3 exige explicitement qu'il s'agisse d'un processus irréprochable. Les gens ne partageront pas d'observations honnêtes sur les échecs s'ils craignent une punition. L'objectif est d'améliorer le système et non de punir les individus.
L'examen post-incident couvre :
- Une chronologie complète de l'incident, du premier indicateur à la récupération complète
- Quels détections ont fonctionné et ce qui a été manqué
- Si les protocoles d'escalade ont fonctionné correctement
- La communication (interne et externe) était-elle claire et opportune
- Si l'IRP et les playbooks reflétaient avec précision ce que l'équipe devait faire
- Lorsque les ressources (personnes, outils, accès) étaient insuffisantes
Sorties :
- Mise à jour de l'IRP et des livres de jeu
- Règles de détection nouvelles ou révisées
- Modifications de correctifs ou de configuration identifiées lors de la RCA
- Recommandations de formation pour des membres ou des départements spécifiques
- Un rapport écrit pour les autorités de direction, juridiques et (si nécessaire)
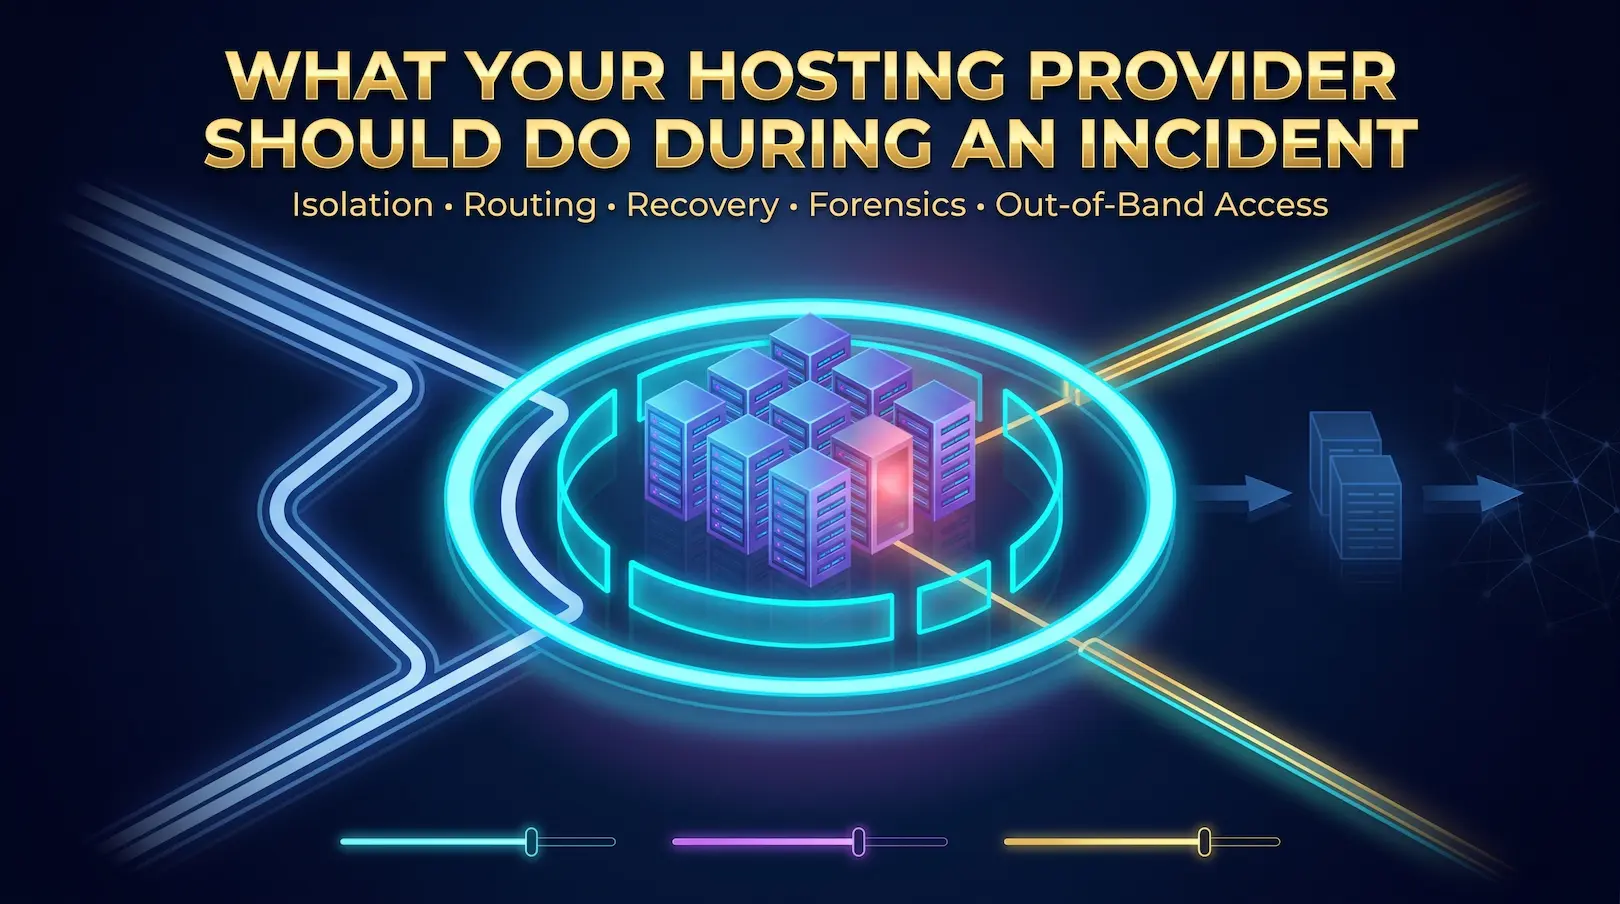
Ce que votre fournisseur d'hébergement doit faire lors d'un incident
Il s'agit de la section Aucun autre guide IR. C'est également la section qui compte le plus si votre entreprise s'exécute sur le cloud, le VPS ou l'infrastructure de serveurs dédiés.
Votre fournisseur d'hébergement n'est pas un spectateur passif lors d'un incident de sécurité. Ils contrôlent votre accès réseau, votre routage IP, votre matériel de serveur et, dans de nombreux cas, vos canaux de communication hors bande. Un fournisseur d'hébergement compétent fait partie de votre équipe de réponse aux incidents.
Voici exactement ce que votre fournisseur doit pouvoir faire :
Isolation au niveau du réseau
Lorsqu'un serveur est confirmé, vous devez le couper immédiatement du reste d'Internet. Un bon hébergeur peut :
- Implémentez une route nulle au niveau BGP, rendant l'IP du serveur inaccessible de l'extérieur
- Appliquer les règles de pare-feu à la périphérie du réseau, et non pas uniquement au niveau du serveur, pour bloquer les mouvements latéral
- Réaffectez vos adresses IP si elles sont sur la liste noire en raison du spam sortant ou du trafic d'attaque du serveur compromis
Chez Atal Networks, l'isolation au niveau du réseau peut être activée immédiatement par l'intermédiaire de notre équipe d'assistance. Nous opérons dans plus de 213 centres de données avec une redondance BGP via Simply Transit, ce qui signifie que les changements d'isolation et de routage prennent effet à la couche d'infrastructure, pas seulement au niveau du système d'exploitation.
Le type de serveur est important : confinement par l'infrastructure
Différents types de serveurs nécessitent des approches de confinement différentes. Votre IRP doit documenter le type que vous exécutez et les étapes de confinement exactes pour chacun. Vous ne savez pas quel type de serveur correspond à votre charge de travail ? Voir notre Comparaison des serveurs dédiés et des hébergements VPS.
| Type de serveur | Approche de confinement | Action du fournisseur |
| VPS | Snapshot l'instance, spin-up propre remplacement | Le fournisseur prend un snapshot de niveau hyperviseur, isole l'interface de réseau virtuel de la VM |
| Serveur dédié | Arrêt au niveau du port du commutateur ou du pare-feu | Le fournisseur applique la liste de contrôle d'accès (ACL) sur le commutateur, se déconnecte de Network Fabric |
| métal nu | Route nul IP complète + accès à la console hors bande | Le fournisseur null-routes BGP fournit un accès IPMI/iDRAC pour une enquête à distance |
| Colocation | Physical access coordination | Le fournisseur contrôle les interconnexions réseau, coordonne l'accès pour votre équipe ou une entreprise IR tiers. |
Communication hors bande lors d'un incident
Il s'agit de la planification IR la plus négligée. Si vos systèmes principaux sont en panne – les e-mails sont en panne, que Slack est en panne, votre VPN est en panne – comment votre équipe communique-t-elle et se coordonne-t-elle ?
Un fournisseur d'hébergement sérieux vous donne un accès hors bande via :
- IPMI (Interface de gestion de plate-forme intelligente): Accès au niveau de la console à votre matériel de serveur indépendamment du système d'exploitation. Si le système d'exploitation est compromis, vous pouvez toujours voir ce qui se passe et émettre des commandes.
- IDRAC / OIT : Les cartes de gestion à distance au niveau du fabricant qui fonctionnent même lorsque le serveur est éteint ou que le système d'exploitation est tombé en panne.
- Canal d'assistance dédié : Un numéro de téléphone ou un système de tickets d'urgence qui contourne les files d'attente standard lors d'un incident confirmé.
Si votre fournisseur d'hébergement ne peut pas offrir un accès hors bande à vos serveurs, cela représente une lacune importante dans votre capacité de réponse aux incidents.
Conservation des journaux et données médico-légales
Après un incident, vous aurez besoin de journaux. Journaux de trafic réseau, journaux d'accès, journaux d'authentification, journaux de requête DNS. Votre fournisseur d'hébergement peut contenir des journaux au niveau de l'infrastructure que vos systèmes internes ne capturent pas.
Avant qu'un incident ne se produise, confirmez auprès de votre fournisseur d'hébergement :
- Quels journaux sont conservés au niveau de l'infrastructure
- Jusqu'où remonte la fenêtre de rétention (30 jours, 90 jours, plus)
- Dans quel format les journaux sont fournis pour l'analyse médico-légale
Chez Atal Networks, nous conservons les journaux au niveau de l'infrastructure et pouvons les fournir aux clients lors d'un incident de sécurité confirmé. Notre équipe d'assistance se coordonne directement avec votre équipe IR ou votre entreprise externe IR.
Comment informer votre fournisseur d'hébergement
Au moment où vous confirmez un incident de sécurité affectant votre infrastructure hébergée, ouvrez immédiatement un ticket d'assistance et marquez-le comme une urgence de sécurité. N'attendez pas que le confinement soit terminé.
Informations à inclure dans votre notification :
- Confirmation qu'un incident de sécurité est en cours
- Quels serveurs ou adresses IP sont affectés
- Que vous ayez besoin d'une isolation réseau, d'un accès au journal ou d'un accès à la console hors bande
- Vos coordonnées de contact pour la durée de l'incident
Contactez le support Atal Networks 24h/24 et 7j/7 — Notre équipe est disponible 24 heures sur 24 et traite les incidents de sécurité comme des escalades prioritaires.
Construire votre équipe de réponse aux incidents (CSIRT)
Une équipe de réponse aux incidents de cybersécurité (CSIRT) est le groupe chargé d'exécuter votre plan IR lorsqu'un incident survient. Chaque membre a un rôle défini avant l'incident.
Rôles principaux
Gestionnaire d'incidents (IM) L'IM mène la réponse. Ils gèrent les flux de communication, mettent à jour les parties prenantes, délèguent des tâches à d'autres membres de l'équipe et suivent l'horloge. De manière critique, la GI n'effectue pas de travail technique pendant l'incident. Leur travail est la coordination et la prise de décision. En cas de crise, la dilatation du temps est réelle - les gens perdent de vue le temps que prennent les choses. L'IM surveille l'horloge et maintient l'équipe sur la bonne voie.
Responsable technique (TL) Le TL sert d'expert technique en la matière. Ils dirigent les actions de confinement, d'éradication et de récupération, font appel à des spécialistes techniques supplémentaires au besoin et font l'appel à la reconstruction ou à la restauration des décisions. Le TL se coordonne avec l'équipe d'infrastructure de votre fournisseur d'hébergement.
Responsable communication (CM) Le CM gère toutes les communications internes et externes lors de l'incident. Mises à jour internes des employés et de la direction. Communications externes aux clients, aux régulateurs et aux médias. Le CM prépare également des déclarations à l'avance, un langage pré-approuvé pour des scénarios comme un journaliste qui fait appel à une violation présumée.
juriste Légal doit être impliqué à partir du moment où une violation est confirmée, en particulier lorsque des données personnelles peuvent être impliquées. Ils donnent des conseils sur les délais de notification réglementaires (RGPD : 72 heures, HIPAA : 60 jours), les exigences de traitement des preuves et ce qui peut et ne peut pas être partagé en externe.
Commanditaire exécutif Un cadre supérieur ayant le pouvoir de prendre des décisions au niveau de l'entreprise lors d'un incident. Cela comprend l'autorisation des arrêts de système qui affectent les revenus, l'approbation des communications et la décision de s'engager dans l'application de la loi.
Quand faire appel à des entreprises IR externes
Les entreprises d'IR externes apportent des livres de jeu prédéfinis, des intervenants expérimentés et des outils médico-légaux que la plupart des équipes internes n'ont pas. Pensez à en engager un lorsque :
- La gravité des incidents est P1 (ransomware, exfiltration de données, compromis complet du système)
- Votre équipe interne manque d'expérience avec le type d'attaque spécifique
- Vous avez besoin de preuves médico-légales indépendantes à des fins légales ou d'assurance
- L'incident est suffisamment important pour submerger votre capacité interne
Sélectionnez votre entreprise IR externe avant qu'un incident ne se produise. La négociation d'un mandat est bien mieux que de rechercher une entreprise en étant sous attaque.
Exécution d'un exercice de table
Un exercice de table est une session de jeu de rôle où un animateur présente un scénario d'attaque et l'équipe parle de sa réponse en temps réel. Aucun système réel n'est impliqué. La valeur est de trouver des lacunes dans votre plan et votre prise de décision avant qu'elles ne comptent.
Un format de table de base :
- Le facilitateur présente le scénario : "Votre système de surveillance vient de signaler le trafic sortant inhabituel de trois serveurs. Il est 2 h du matin un dimanche."
- L'équipe discute : qui est appelé en premier, quelles mesures sont prises, quelles informations sont nécessaires
- Le facilitateur injecte de nouveaux développements : "Les serveurs sont confirmés compromis. Ransomware a été déployé."
- L'équipe continue la réponse
- Débrief après l'exercice : ce qui a fonctionné, ce qui n'a pas fonctionné, quelles lacunes ont été trouvées
Exécutez des tables de table au moins deux fois par an. Exécutez-les après chaque incident important ou changement d'infrastructure majeur.
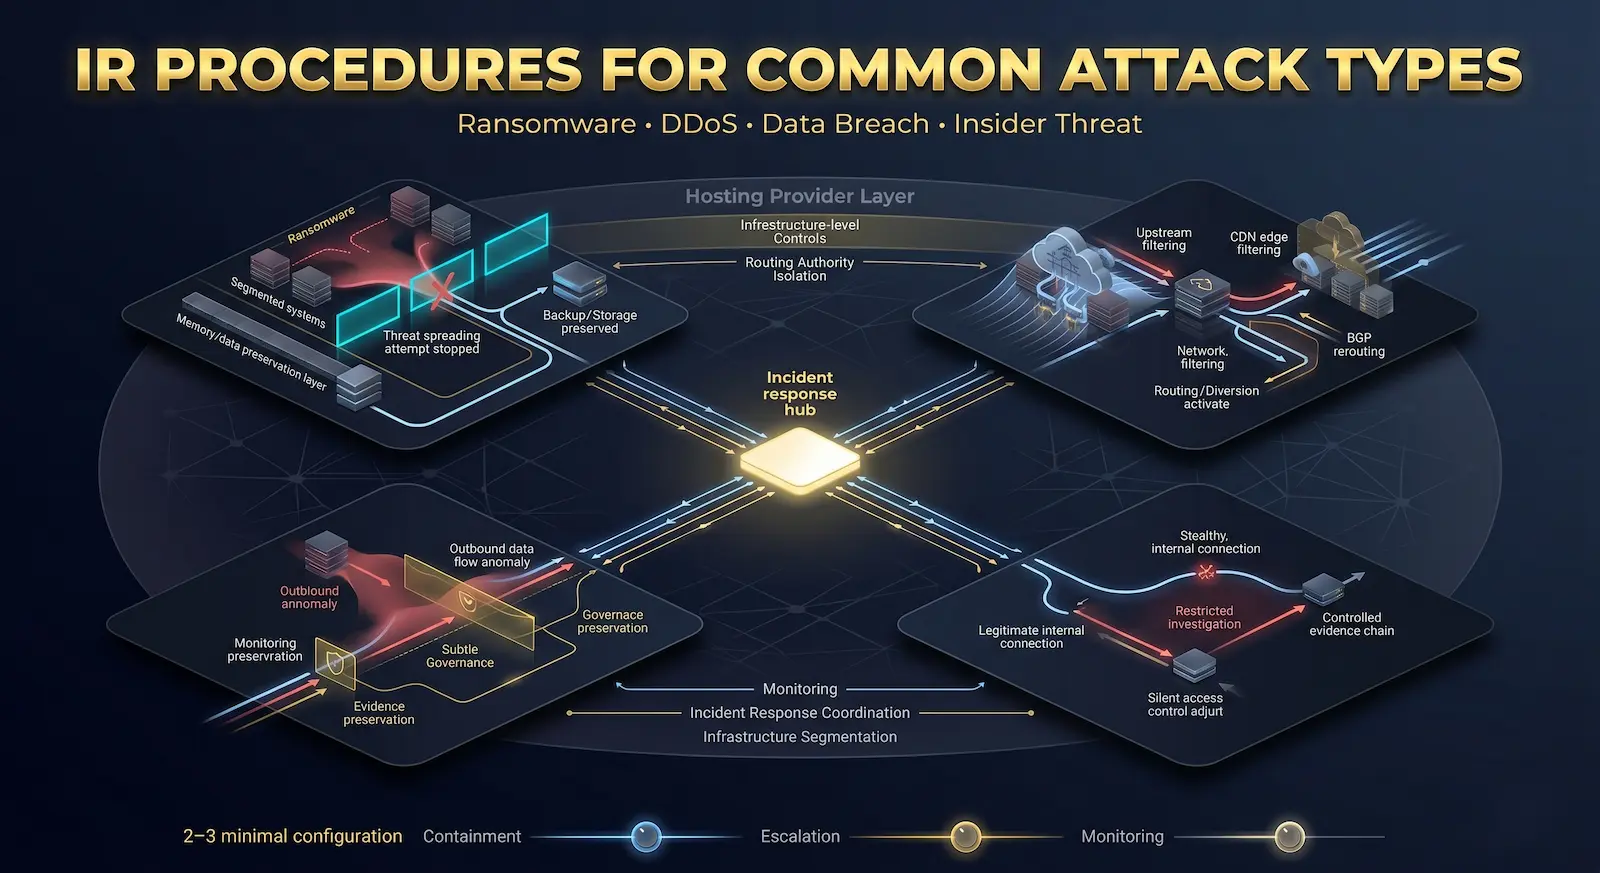
Procédures IR pour les types d'attaque courant
Votre IRP général couvre les six phases. Vos playbooks couvrent des types d'attaque spécifiques. Voici les principales décisions et actions pour les quatre scénarios les plus courants.
ransomware
Le ransomware est le type d'incident prioritaire le plus élevé pour la plupart des organisations. La vitesse de confinement détermine directement la quantité de données cryptées.
la décision de paiement ou de non-paiement : Les organismes d'application de la loi, dont le FBI, recommandent de ne pas payer de rançons. Le paiement ne garantit pas la récupération des données, finance des opérations criminelles et peut enfreindre les sanctions de l'AC si l'acteur de la menace figure sur une liste bloquée. La meilleure position est une stratégie de sauvegarde testée et segmentée qui rend le paiement inutile.
Actions critiques :
- Isolez les systèmes affectés immédiatement au niveau du réseau (votre fournisseur d'hébergement peut le faire)
- Ne redémarrez pas les systèmes concernés — Memory Forensic peut révéler les outils de l'attaquant
- Identifiez la variante de ransomware pour déterminer s'il existe une clé de déchiffrement libre (vérifier nomoreransom.org)
- Informez immédiatement votre compagnie de cyber-assurance
- Engage law enforcement — the Centre de plaintes contre la délinquance sur Internet (IC3) du FBI Collecte des rapports de ransomwares et peut avoir des renseignements sur l'acteur de menace spécifique
Attaques DDoS
Disponibilité des attaques par déni de service distribuée. La réponse se situe au niveau de la couche réseau, ce qui fait de votre fournisseur d'hébergement un intervenant principal, pas seulement une ressource de support.
Actions de réponse à l'hébergement-fournisseur :
- Activer le filtrage DDoS et la récurage du trafic à la périphérie du réseau
- Appliquer la limitation de la fréquence et le façonnage du trafic pour absorber ou rediriger le volume d'attaque
- Implémenter le blocage basé sur IP pour les sources d'attaque confirmées
- Engagez les fournisseurs de transport en commun en amont pour le trafic noir si l'attaque dépasse la capacité de récurage
Actions internes :
- Activez la couche de protection DDoS de votre CDN
- Activer la limitation du débit de la couche d'applications sur vos serveurs Web
- Communiquer le temps estimé de restauration du service aux clients concernés
- Enregistrez tout le trafic d'attaque pour une analyse post-incident
Chez Atal Networks, notre réseau BGP avec simple routage de transit comprend des capacités d'atténuation DDoS. Voir notre infrastructure de serveurs nus en métal Pour plus de détails sur ce qui est couvert au niveau de l'infrastructure.
violation de données
Lorsque des données personnelles peuvent avoir été exposées, l'horloge démarre pour une notification réglementaire.
Horaires des notifications :
- RGPD : 72 heures pour aviser l'autorité de surveillance compétente après avoir pris connaissance de la violation
- HIPAA : 60 jours à compter de la découverte pour aviser le bureau des droits civils du HHS
- Lois sur les violations des États varient selon l'état, allant de 30 à 90 jours
Actions critiques :
- Conserver toutes les preuves avant toute réparation
- Déterminer la portée de l'exposition : quelles données, combien d'individus, quelles catégories
- Engagez immédiatement un conseiller juridique
- Rédiger les notifications de clients et de réglementation — Ne pas envoyer sans examen légal
- Documentez toutes les mesures prises avec les horodatages pour les rapports réglementaires
Menace interne
Les menaces internes sont parmi les plus difficiles à détecter et les plus sensibles à gérer car elles impliquent des employés, des entrepreneurs ou des partenaires.
Principales différences de réponse :
- Les RH et juridiques doivent être impliquées dès la première indication
- La collecte de preuves doit suivre les procédures appropriées de chaîne de contrôle pour les procédures judiciaires potentielles
- La communication sur l'enquête est limitée à un groupe qui doit savoir
- La révocation de l'accès doit être coordonnée avec soin pour éviter d'alerter le sujet avant que la preuve ne soit obtenue.
Réponse aux incidents et conformité
Les cadres de conformité réglementaire ne recommandent pas seulement les plans IR. Plusieurs les exigent explicitement, avec une documentation spécifique et des obligations de test.
| Cadre | besoin en IR |
| NIST CSF 2.0 | Les fonctions de réponse et de récupération nécessitent des capacités IR documentées — voir Guide de réponse aux incidents du NIST |
| ISO 27035 | Norme internationale spécifiquement pour la gestion de la sécurité de l'information |
| normes du RGPD | Article 33: Notification de violation dans les 72 heures, procédures documentées requises |
| HIPAA | La règle de sécurité exige des procédures documentées de réponse aux incidents et une formation sur la main-d'œuvre |
| PCI DSS | Exigence 12.10 : Plan IR documenté, tests annuels, capacité de réponse 24/7 |
| SOC 2 | La réponse aux incidents est un critère de service de confiance et de disponibilité de base |
Pour les organisations soumises à plusieurs cadres, un IRP unique bien documenté aligné sur NIST SP 800-61 REV 3 couvre la plupart des exigences. La clé est la documentation, les preuves de test et les mises à jour régulières.
Incident Response Checklist
Utilisez cette liste de contrôle lors d'un incident actif. Imprimez-le et conservez une copie hors ligne.
Préparation (pré-incident)
- [ ] IRP documentée et approuvée par le leadership juridique, RH et exécutif
- [ ] Rôles CSIRT affectés avec des sauvegardes nommées pour chaque rôle
- [ ] Playbooks écrits pour Ransomware, DDoS, violation de données et menace d'initié
- [ ] Canaux de communication hors bande testés et confirmés
- [ ] Contact de sécurité d'urgence du fournisseur d'hébergement confirmé et stocké hors connexion
- [ ] Intégrité de la sauvegarde Vérifiée — Date du dernier test : __________
- [ ] Exercice de table terminé — Date limite : __________
- [ ] Retenue externe de l'entreprise IR (le cas échéant) : __________
Détection et identification
- [ ] Alerte reçue ou incident signalé : Heure : __________
- [ ] Triage initial terminé — Incident faux positif ou vrai confirmé
- [ ] Gravité des incidents classés : P1 / P2 / P3 / P4
- [ ] Gestionnaire des incidents Avertissement : __________
- [ ] Journal des incidents ouvert et en cours d'exécution
- [ ] Livre de jeu approprié activé
Endiguement
- [ ] Systèmes affectés identifiés et inventoriés
- [ ] Isolation réseau mise en œuvre (niveau interne + fournisseur)
- [ ] Comptes compromis désactivés
- [ ] Les preuves médico-légales capturées avant le début de l'assainissement
- [ ] Fournisseur d'hébergement notifié (si l'infrastructure du serveur est affectée) : Heure : ___________
- [ ] Les forces de l'ordre notifiées (si nécessaire) : Durée : __________
- [ ] Conseiller juridique engagé : __________
Éradication
- [ ] Analyse des causes profondes terminée
- [ ] Tous les logiciels malveillants et les outils d'accès non autorisés ont été supprimés
- [ ] Vulnérabilité exploitée Patchée ou atténuée
- [ ] Comptes et informations d'identification non autorisés supprimés
- [ ] Réinitialisation du mot de passe lancée pour les comptes concernés
Récupération
- [ ] Plan de récupération documenté avec une liste de systèmes prioritaires
- [ ] Intégrité de sauvegarde vérifiée avant la restauration
- [ ] Systèmes restaurés et validés avant de retourner en production
- [ ] Surveillance améliorée active sur les systèmes restaurés
- [ ] Le fournisseur d'hébergement a confirmé sa réputation de propreté IP et le routage réseau
après l'incident
- [ ] Réunion des leçons apprises prévue (dans les 14 jours) : __________
- [ ] IRP et playbooks mis à jour en fonction des résultats
- [ ] Notifications réglementaires envoyées (si nécessaire) : __________
- [ ] Briefing de la direction et du conseil d'administration terminé
- [ ] Rapport d'incident déposé auprès d'une compagnie d'assurance (le cas échéant)
Étude de cas dans le monde réel : Attaque de St. Paul Ransomware (2025)
En juillet 2025, la ville de St. Paul, Minnesota, a été touchée par une attaque coordonnée de ransomwares qui a perturbé les services gouvernementaux à travers la ville. La réponse a démontré à la fois ce qui fonctionne et ce à quoi les organisations devraient se préparer lors d'incidents de gravité élevée.
La chronologie :
- 25 juillet : activité suspecte détectée sur les réseaux de la ville. L'équipe informatique commence immédiatement le triage d'enquête.
- 27 juillet : Comportement malveillant confirmé. City IT ferme tous les systèmes d'information de manière proactive pour empêcher une nouvelle propagation.
- Les jours suivants : le FBI s'est engagé pour le confinement et l'enquête médico-légale. Cyber-actifs de la Garde nationale du Minnesota activés par le gouverneur.
Ce qui a fonctionné :
- Détection précoce : l'alerte initiale du 25 juillet a donné à l'équipe deux jours avant de prendre la décision d'arrêt. Cette fenêtre de détection était essentielle.
- Isolement sur le paiement : St. Paul a choisi de ne pas payer la rançon. Instead, they implemented defensive isolation and systematic recovery, which limited financial loss and reduced the incentive for future attacks.
- Partenariats gouvernementaux : engager le FBI et la Garde nationale a apporté des ressources et des capacités médico-légales que l'équipe interne de la ville ne pouvait à elle seule fournir.
- Réinitialisation des informations d'identification à grande échelle : environ 3 500 comptes d'employés ont été réinitialisés dans le cadre de la récupération, ce qui nécessite une coordination physique pour gérer le processus en toute sécurité.
La leçon : Aucune organisation n'est trop grande ou trop bien dotée pour être touchée. La différence entre un incident gérable et un incident catastrophique est l'existence d'un plan IR testé, d'une autorité claire pour agir et des relations (avec les forces de l'ordre, avec votre fournisseur d'hébergement, avec une entreprise IR externe) établies avant l'arrivée de l'attaque.
Comment l'IA modifie la réponse aux incidents en 2026
L'intelligence artificielle change simultanément l'IR dans deux directions : elle accélère la détection et la réponse automatisées, et rend les attaques plus sophistiquées et plus difficiles à capturer.
Détection et soar alimentés par l'IA
Les plates-formes d'orchestration, d'automatisation et de réponse (SOAR) utilisent désormais l'apprentissage automatique pour corréler les alertes entre plusieurs outils de sécurité, hiérarchiser les menaces authentiques et exécuter automatiquement des actions de réponse pré-approuvées, sans attendre qu'un humain examine chaque alerte.
Les plates-formes UEBA (User and Entity Behavior Analytics) créent des modèles de base de comportement normal pour chaque utilisateur et appareil de votre réseau. Les écarts par rapport à cette ligne de base - un utilisateur téléchargeant 50 Go à 3 AM, un compte de service accédant à des systèmes qu'il n'a jamais touchés - déclenche des alertes que les systèmes basés sur des règles manquent entièrement.
Les plates-formes XDR (Extended Detection and Response) consolident la télémétrie du point de terminaison, du réseau, de l'identité et du cloud dans une seule surface de détection, offrant une visibilité des équipes IR qui était auparavant impossible sans plusieurs outils distincts.
Le faux problème positif
La détection pilotée par l'IA génère davantage d'alertes. Plus d'alertes signifie plus de travail de triage. Le fardeau de triage des équipes IR humaines a considérablement augmenté à mesure que les outils d'IA deviennent plus sensibles.
Un programme IR mature en 2026 investit autant dans la réduction des faux positifs que dans la capacité de détection. Des règles de détection mal réglées qui se déclenchent sur la capacité de réponse aux déchets d'activité bénigne et, plus dangereusement, forment les équipes à ignorer les alertes. C'est exactement le modèle qui laisse passer les incidents réels.
Attaques alimentées par l'IA
Les mêmes capacités d'IA disponibles pour les défenseurs sont disponibles pour les attaquants. L'IA est utilisée pour rédiger des e-mails de phishing plus convaincants, identifier les cibles plus efficacement, adapter les logiciels malveillants pour éviter la détection et automatiser la reconnaissance. La sophistication des attaques augmente plus rapidement que la plupart des programmes IR évoluent.
L'implication pratique : les plans IR doivent tenir compte d'une progression d'attaque plus rapide. La fenêtre entre l'accès initial et le compromis complet est plus courte qu'il y a deux ans. La vitesse de détection et la vitesse de confinement importent plus que jamais.
Questions fréquemment posées
Quelles sont les 6 étapes de la réponse aux incidents ?
Les six étapes de la réponse aux incidents sont les suivantes : (1) la préparation - constituer votre équipe, vos outils et vos plans avant qu'un incident ne se produise ; (2) Identification — détectant et confirmant qu'un incident de sécurité a eu lieu; (3) Confinement — Isolement des systèmes affectés pour empêcher la propagation de l'incident ; (4) Éradication - suppression de toutes les traces de l'attaquant et fermeture des vulnérabilités exploitées ; (5) Récupération — restauration des systèmes en fonctionnement normal en toute sécurité et avec surveillance en place ; (6) Leçons apprises — Réalisation d'un examen post-incident dans les 14 jours pour améliorer vos processus.
Quelle est la différence entre les cadres de réponse aux incidents NIST et SANS ?
NIST SP 800-61 consolide le confinement, l'éradication et la récupération en une seule phase, car le travail se chevauche souvent. SANS les sépare en trois phases distinctes pour les équipes qui préfèrent les transferts clairs étape par étape. Les deux cadres couvrent les mêmes activités de base. Le NIST est mieux adapté aux organisations en vertu des exigences fédérales américaines ou avec des structures de gouvernance formelles. SANS fonctionne mieux pour les petites équipes qui construisent leur premier programme IR.
Combien de temps doit durer un plan de réponse aux incidents ?
Un IRP doit être suffisamment long pour être complet et suffisamment court pour être lu sous pression. Les IRP les plus efficaces sont de 10 à 30 pages pour le document de base, avec des playbooks séparés pour chaque type d'attaque. Un plan que personne ne lit pendant une crise n'est pas un plan, c'est un document. Gardez le cœur de l'IRP concis et mettez les détails opérationnels dans les playbooks.
Que fait un fournisseur d'hébergement lors d'un incident de sécurité de serveur ?
Un fournisseur d'hébergement compétent peut prendre plusieurs mesures critiques lors d'un incident de sécurité : implémenter une isolation au niveau du réseau en acheminant la NUL de l'IP de votre serveur au niveau BGP, fournissant un accès hors bande à la console (IPMI/iDRAC) pour enquêter sur un serveur compromis sans avoir recours à des compromis OS, activation du filtrage DDoS et nettoyage du trafic, fourniture de journaux au niveau de l'infrastructure pour l'analyse médico-légale et coordination de la restauration de la réputation IP lors de la récupération. Chez Atal Networks, notre équipe d'assistance 24h/24 et 7j/7 traite les incidents de sécurité comme des escalades prioritaires et se coordonne directement avec votre équipe IR ou votre entreprise IR externe. Contactez notre équipe ici.
À quelle fréquence devez-vous tester votre plan de réponse aux incidents ?
Votre IRP doit être révisé et mis à jour au minimum une fois par an. Les exercices de table doivent se dérouler au moins deux fois par an - et immédiatement après tout incident important ou changement d'infrastructure majeur. Les exercices simulés complets (équipe rouge vs équipe bleue, ou tests de pénétration contre des scénarios d'attaque spécifiques) doivent s'exécuter au moins une fois par an. Le but n'est jamais de laisser votre IRP devenir un document qui n'existait que sur papier.
Qu'est-ce que le NIST SP 800-61 REV 3 ?
La révision 3 du NIST SP 800-61 est la version actuelle du document d'orientation sur la réponse aux incidents du National Institute of Standards and Technology, publié en avril 2025. Il met à jour la version précédente de 2012 (Rev 2) en intégrant la réponse aux incidents dans le cadre de cybersécurité du NIST. 2.0, introduisant un nouveau profil de communauté pour la gestion des risques de cyber-incidents et mettant davantage l'accent sur l'amélioration continue, la documentation et la gouvernance. Il s'agit du cadre de réponse aux incidents le plus référencé dans les environnements fédéraux et d'entreprise américains.
dernier mot
Les procédures de réponse aux incidents ne sont pas une case à cocher de conformité. Ils font la différence entre un incident de sécurité qui vous coûte quelques heures et celui qui vous coûte des millions de dollars, la confiance des clients et des mois de travail de récupération.
Les organisations qui gèrent bien les incidents ne sont pas celles qui disposent des meilleurs outils. Ce sont eux qui ont préparé, documenté, entraîné et testé avant l'arrivée de l'attaque.
Et encore une chose : votre infrastructure d'hébergement fait partie de votre plan IR, que vous y ayez pensé ou non. Un fournisseur qui peut isoler un serveur compromis au niveau du réseau, vous donner un accès à la console hors bande et se coordonner avec votre équipe à 2 heures du matin vaut la peine d'être réfléchi avant d'en avoir besoin.
Chez Atal Networks, nous courons Serveurs VPS, serveurs dédiés, et infrastructure bare metal dans plus de 213 centres de données dans le monde. Notre équipe est disponible 24h/24 et 7j/7 pour les incidents de sécurité. Si vous examinez votre plan IR et que vous souhaitez comprendre comment votre infrastructure d'hébergement s'y intègre, Contactez notre équipe d'assistance — Nous sommes heureux de parcourir votre configuration.
Publié par Atal Networks — Fournisseur d'hébergement mondial desservant plus de 36 000 clients dans 196 pays avec des serveurs dédiés, un hébergement VPS, une infrastructure nue et un support d'experts 24/7.