 Ga naar de inhoud



Een cyberaanval wacht niet tot je klaar bent. Het slaat snel, verspreidt zich snel en kost snel. IBM's 2024 Kosten van een datalekrapport ontdekten dat organisaties met een formeel incidentresponsplan en een getraind team gemiddeld $473.706 per inbreuk hebben bespaard in vergelijking met degenen zonder.
Die kloof is geen toeval. Het is het resultaat van duidelijke procedures voor incidentrespons voordat de inbreuk plaatsvindt - niet klauteren om ze uit te vinden terwijl systemen branden.
Deze gids behandelt alles: wat procedures voor incidentrespons eigenlijk zijn, de bijgewerkte NIST SP 800-61 Rev 3 Framework gepubliceerd in april 2025, een stapsgewijze uitsplitsing van alle zes fasen, en iets dat geen enkele andere gids dekt, wat uw hostinginfrastructuurprovider zou moeten doen op het moment dat een incident wordt bevestigd.
Als u uw bedrijf runt op een VPS, dedicated server of bare metal server, maakt de infrastructuurlaag deel uit van uw incidentrespons. Deze gids behandelt het zo.
Inhoudsopgave
- Wat is een incidentresponsprocedure?
- NIST SP 800-61 Rev 3: Wat veranderde in april 2025
- NIST vs SANS: het kiezen van het juiste raamwerk
- De 6 fasen van incidentrespons
- Wat uw hostingprovider moet doen tijdens een incident
- Uw Incident Response Team (CSIRT) bouwen
- IR-procedures voor veelvoorkomende aanvalstypen
- Incidentrespons en naleving
- Checklist voor incidentreactie
- Veelgestelde vragen
Wat is een incidentresponsprocedure?
Een incidentresponsprocedure is een gedocumenteerde, stapsgewijze reeks acties die uw team onderneemt wanneer een beveiligingsincident plaatsvindt. Het vertelt mensen precies wie wat doet, in welke volgorde en met welke autoriteit.
Drie termen raken constant in de war. Hier is het verschil:
| Termijn | Wat het is |
| IR-kader | het strategische model. NIST en SANS publiceren deze beide. Het is de "grondwet" - principes en fasen op hoog niveau. |
| Incidentresponsplan (IRP) | Het tactische document voor uw organisatie. Het noemt uw team, uw tools, uw communicatiepaden en uw escalatiedrempels. |
| IR-speelboek | het operationele script voor een specifiek aanvalstype. Een voor ransomware, een voor DDoS, een voor datalekken. van de plank gehaald op het moment dat dat incident is bevestigd. |
De meeste organisaties hebben een plan. Veel minder hebben draaiboeken. Bijna niemand heeft ze getest.
Wat telt als een beveiligingsincident?
NIST SP 800-61 Rev 3 definieert een cyberbeveiligingsincident als een schending, of een dreigende schending, van computerbeveiligingsbeleid, acceptabel gebruiksbeleid of standaard beveiligingspraktijken.
In de praktijk omvat dit:
- Ransomware of malware-infectie
- Ongeautoriseerde toegang tot systemen of gegevens
- Data-exfiltratie (bevestigd of vermoed)
- DDoS-aanvallen die de beschikbaarheid van service verstoren
- Insider-bedreigingsactiviteit
- Phishing-aanvallen die resulteren in een credential compromis
- Supply chain compromise
- Denial of service op de netwerk- of applicatielaag
Niet elke waarschuwing is een incident. Een deel van een sterke IR-procedure is het triageproces dat valse positieven scheidt van echte beveiligingsgebeurtenissen die een reactie vereisen.
NIST SP 800-61 Rev 3: Wat veranderde in april 2025
In april 2025 publiceerde het National Institute of Standards and Technology (NIST) de definitieve versie van Speciale publicatie 800-61 Revisie 3 — de belangrijkste update van de richtlijnen voor incidentrespons in meer dan een decennium.
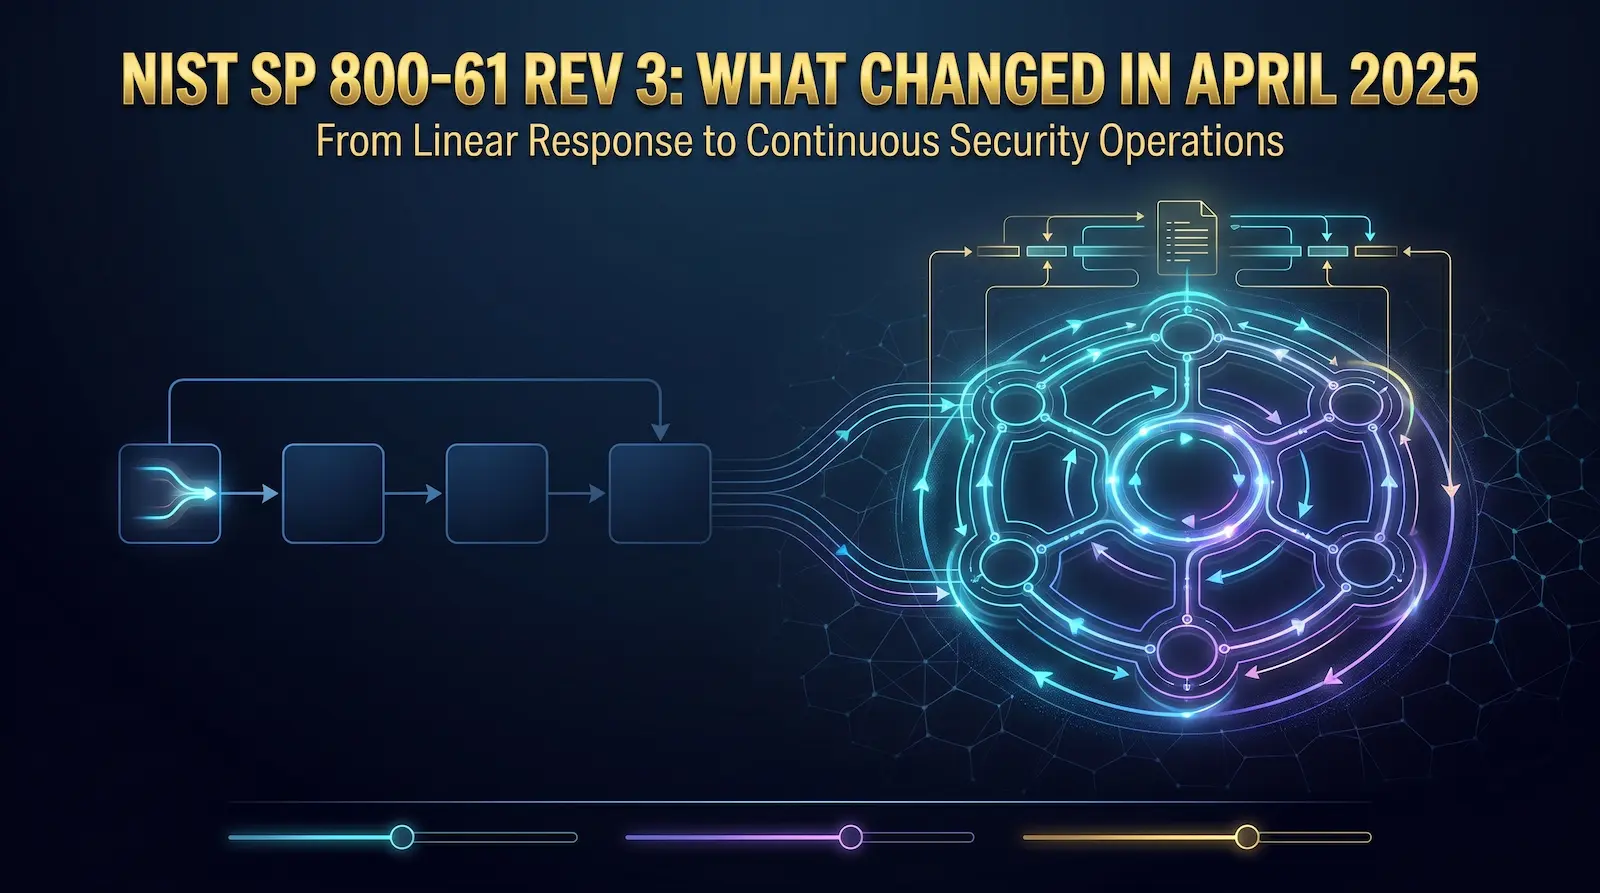
De vorige versie (rev 2, gepubliceerd in 2012) behandelde incidentrespons als een begrensde, lineaire reeks van vier fasen. Je detecteert een incident, je reageert, je herstelt, je schrijft een door lessen geleerd rapport. gedaan.
Rev 3 verandert dat model fundamenteel.
Belangrijkste wijzigingen in SP 800-61 Rev 3
- Integratie met CSF 2.0 Rev 3 is niet langer een op zichzelf staande publicatie. Het is gebouwd als een communityprofiel binnen het NIST Cybersecurity Framework 2.0. Dit betekent dat incidentrespons nu verweven is in alle zes CSF-functies: besturen, identificeren, beschermen, detecteren, reageren en herstellen.
- Continue verbetering is nu expliciet Het oude model eindigde bij 'Lessons Learned'. Rev 3 behandelt continue verbetering als een eersteklas vereiste, niet als een bijzaak. Van organisaties wordt verwacht dat ze hun IR-capaciteiten voortdurend testen, updaten en evolueren, niet alleen na incidenten.
- Documentatievereisten uitgebreid Rev 3 legt meer nadruk op geschreven playbooks, roltoewijzingen en vooraf geautoriseerde beslissingsbomen. Het doel is om realtime improvisatie tijdens een actief incident te elimineren.
- Het technische detail is verhuisd Omdat de bijzonderheden van het uitvoeren van IR snel veranderen in verschillende technologieën en omgevingen, heeft Rev 3 opzettelijk granulaire technische richtlijnen verplaatst naar aanvullende bronnen. De publicatie zelf richt zich op risicobeheerprincipes die in alle omgevingen van toepassing zijn.
Als uw Incident Response Plan is geschreven tegen de 2012-versie, moet het worden herzien. De kernfasen zijn vergelijkbaar, maar het bestuursmodel en de vereisten voor continue verbetering zijn wezenlijk verschillend.
NIST vs SANS: het kiezen van het juiste raamwerk
Zowel NIST als SANS worden alom gerespecteerd. Beide zijn correct. Het verschil komt neer op hoe ze de fasen verdelen en voor welke organisaties ze het meest geschikt zijn.
Vergelijking naast elkaar
| Fase | NIST SP 800-61 Rev 3 | Sans Incident Handler's Handbook |
| 1 | Voorbereiding | Voorbereiding |
| 2 | Detectie en analyse | Identificatie |
| 3 | Insluiting, uitroeiing en herstel | bedrog |
| 4 | Activiteit na het incident | Uitstraling |
| 5 | — | Herstel |
| 6 | — | Les geleerd |
Het praktische verschil: NIST-groepen Inperking, uitroeiing en herstel in een enkele fase omdat het werk vaak overlapt - u moet niet wachten tot insluiting 1001 TP3T is voltooid voordat u begint met het uitroeien van bevestigde bedreigingen. SANS scheidt ze in drie verschillende fasen voor teams die de voorkeur geven aan een duidelijke overdracht tussen acties.
Welke te gebruiken:
- tis- Werkt beter voor organisaties die onderworpen zijn aan de Amerikaanse federale nalevingsvereisten, grotere ondernemingen met gedefinieerde bestuursstructuren en teams die werken onder formele risicobeheerkaders.
- Zonder Werkt beter voor kleinere beveiligingsteams, organisaties die duidelijke checklists voor fase-voor-fase willen en teams die hun eerste IR-programma bouwen.
Het eerlijke antwoord is dat beide hetzelfde resultaat opleveren als ze correct worden uitgevoerd. Kies er een, documenteer het en train je team erop.
De 6 fasen van incidentrespons
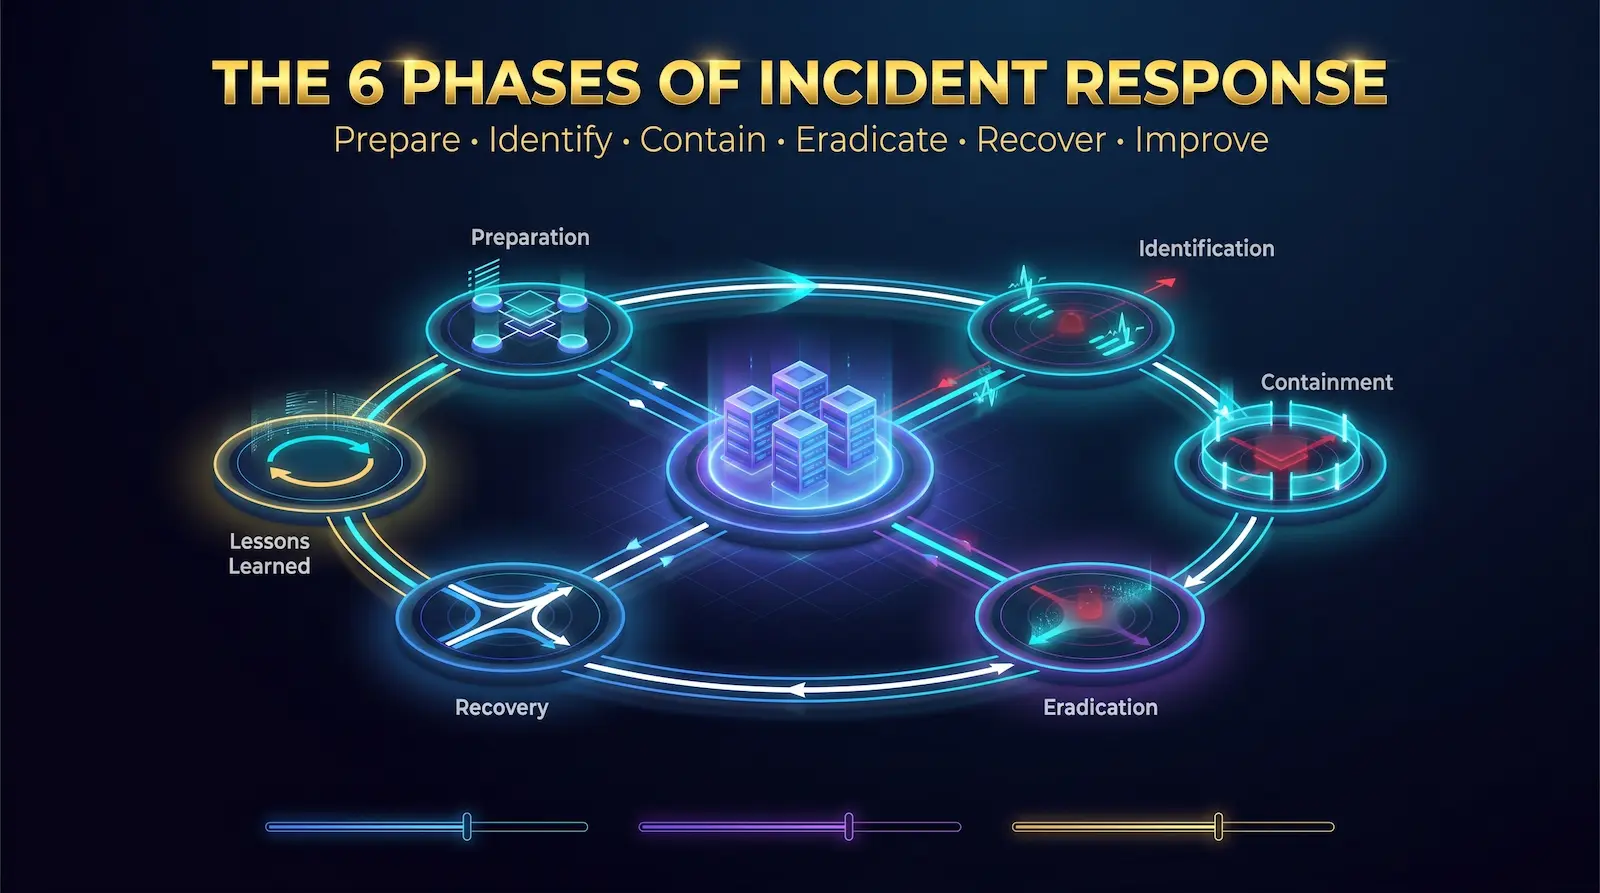
De zes onderstaande fasen volgen de Sans Incident Handler's Handbook model omdat het de duidelijkste operationele scheiding tussen acties geeft. De NIST CSF 2.0-uitlijning wordt waar relevant genoteerd.
Fase 1: Voorbereiding
Direct antwoord: Voorbereiding is alles wat u doet voordat een incident plaatsvindt om ervoor te zorgen dat u effectief kunt reageren wanneer u dat doet.
Voorbereiding is de belangrijkste fase en de meeste organisaties die te weinig investeren. Het omvat:
Team en structuur:
- Definieer uw rollen voor cybersecurity-incidentresponsteams (CSIRT) (hieronder in detail beschreven)
- Wijs een incidentmanager, een technische hoofdrol en een communicatiemanager toe
- Documenteer de autoriteitsmatrix: wie kan het afsluiten van het systeem autoriseren, die regelgevers op de hoogte stelt, die met de pers spreekt
Hulpmiddelen en toegang:
- Implementeer monitoringtools: SIEM, EDR, UEBA en analyse van netwerkverkeer
- Bevestig dat uw team out-of-band communicatiekanalen klaar heeft - een apart versleuteld berichtenplatform, een telefoonboom of een fysiek meetpunt voor wanneer primaire systemen uitvallen
- Zorg voor een up-to-date inventaris van activa, zodat u weet wat u beschermt
documentatie:
- Schrijf uw IRP en laat het beoordelen door Legal, HR en Executive Leadership
- Schrijf playbooks voor uw scenario's met de hoogste risico's: ransomware, DDoS, datalekken, insiderbedreigingen
- Bewaar papieren exemplaren op een veilige, offline locatie
Testen:
- Voer tafelbladoefeningen uit ten minste driemaandelijks. Een tafelblad is een rollenspelsessie waarbij een facilitator een aanvalsscenario presenteert en het team door zijn reactie praat.
- Voer penetratietests uit om hiaten te vinden voordat aanvallers dat doen
- tijd uw reactie boren en de statistieken vastleggen - dit wordt uw basislijn voor het meten van verbetering
Hosting-specifieke voorbereiding (kritisch en over het hoofd gezien):
- Ken het contactproces van het beveiligingsincident van uw hostingprovider voordat u het nodig heeft
- Bevestig wat uw hosting SLA dekt: netwerkisolatie, IP-hertoewijzing, logtoegang en out-of-band communicatie tijdens een groot incident
- Bij Atal Networks is ons 24/7 ondersteuningsteam onmiddellijk bereikbaar tijdens een serverbeveiligingsincident. Neem hier contact op met ons ondersteuningsteam.
Fase 2: identificatie
Direct antwoord: Identificatie is het proces van het detecteren van een mogelijk incident, het verzamelen van bewijs en het bevestigen of er een echte beveiligingsgebeurtenis heeft plaatsgevonden.
Niet elke waarschuwing is een incident. Deze fase bestaat om die beslissing nauwkeurig en snel te maken.
Detectie-triggers vallen in twee categorieën:
Voorgeladen (vroege waarschuwing): Threat Intelligence Feeds, honeypot-waarschuwingen, abnormale inlogpogingen, ongebruikelijke netwerkverkeerspatronen of SIEM-correlatieregels die brand voordat er schade optreedt. Deze vangen meer valse positieven, maar stoppen eerder aanvallen.
Teruggeladen (zichtbare schade): Gebruikers die prestatieproblemen melden, gegevens niet beschikbaar, losgeldnota's of externe onderzoekers die een inbreuk melden. Dit zijn meer kans op echte incidenten, maar komen aan nadat de schade is begonnen.
Het triageproces:
- Verzamel alle beschikbare gegevens: logboeken, waarschuwingen, gebruikersrapporten en netwerkopnames
- bepalen of de gebeurtenis een vals positief of een echt incident is
- Als het een echt incident is, classificeer het dan op ernst (P1/kritisch, P2/Hoog, P3/Medium, P4/Laag)
- Activeer het juiste draaiboek
Belangrijkste principe: log alles vanaf dit punt naar voren. Elke actie, elke beslissing, elke tijdstempel. Dit logboek is uw wettelijke dossier, uw verzekeringsdocumentatie en uw door lessen geleerd materiaal.
Fase 3: Insluiting
Direct antwoord: Inperking beperkt de omvang van het incident om te voorkomen dat het zich verspreidt naar aanvullende systemen of gegevens.
Containment heeft twee fasen:
Insluiting op korte termijn gebeurt onmiddellijk. Het doel is om het bloeden snel te stoppen. Acties omvatten het isoleren van het getroffen systeem van het netwerk, het blokkeren van de IP-adressen van de aanvaller, het uitschakelen van gecompromitteerde gebruikersaccounts en het activeren van DDoS-filtering als ze een volumetrische aanval ondergaan.
Langdurige insluiting gebeurt terwijl uitroeiing wordt voorbereid. De getroffen systemen worden in een geïsoleerde omgeving (of hersteld naar een schoon beeld) in een geïsoleerde omgeving gehouden, zodat forensisch onderzoek kan worden voortgezet.
Containment op serverniveau — Wat dit in de praktijk betekent:
Voor VPS-omgevingen, betekent inperking vaak dat u een momentopname van de getroffen instantie neemt en een schone vervanging draait. De gecompromitteerde momentopname blijft behouden voor forensische analyse, maar blijft offline en off-netwerk.
Voor dedicated servers, Containment kan een uitschakeling op netwerkniveau vereisen op het regelniveau van de switchpoort of firewall. Uw hostingprovider kan dit sneller implementeren op de infrastructuurlaag, sneller dan de meeste interne teams kunnen handelen.
Voor bare metal servers, kan een volledige fysieke isolatie nodig zijn. Dit betekent dat null-routing het IP-adres van de server op BGP-niveau - de server wordt onbereikbaar van het openbare internet terwijl uw team onderzoekt.
Behoud de forensische integriteit tijdens inperking. Veeg geen systemen af voordat u bewijsmateriaal vastlegt. Geheugendumps, lopende proceslijsten, netwerkverbindingsstatussen en volledige schijfafbeeldingen moeten allemaal worden vastgelegd voordat de herstel begint.
Fase 4: Uitroeiing
Direct antwoord: Eradication verwijdert alle sporen van de aanval uit uw omgeving - malware, achterdeurtjes, gecompromitteerde referenties en de kwetsbaarheden die zijn uitgebuit.
Uitroeiing moet grondig zijn, anders komt de aanvaller terug. De meest voorkomende storing in IR is dat een omgeving schoon is wanneer een achterdeur of een slapend implantaat nog steeds aanwezig is.
Uitroeiingsstappen:
- Voer een Root Cause Analysis (RCA) uit om precies te bepalen hoe de aanvaller binnenkwam
- Verwijder alle malware, ransomware payloads en kwaadaardige scripts
- Onderzoek en sluit de misbruikt kwetsbaarheid (patch, configuratiewijziging of intrekking van toegang)
- Verwijder alle niet-geautoriseerde beheerdersaccounts en SSH-sleutels die zijn toegevoegd door de aanvaller
- Herbouw beschadigde of gemanipuleerde systemen uit een bekende basislijn
- Update firewallregels en DNS-filterbeleid
- Forceer een volledige wachtwoordreset voor alle accounts in de explosieradius - en voor bevoorrechte accounts in de hele organisatie uit voorzorg
- Roteer API-sleutels, referenties voor serviceaccounts en certificaten die mogelijk zijn blootgesteld
De beslissing om te bouwen en te herstellen: Herbouwen vanaf nul duurt langer, maar garandeert een schoon systeem. Het herstellen van back-up is sneller, maar alleen veilig als de back-up dateert van vóór de inbreuk en de back-up zelf niet is gecompromitteerd. Voor incidenten met een hoge ernst, herbouw.
Fase 5: herstel
Direct antwoord: Herstel herstelt de getroffen systemen naar de normale werking veilig, geleidelijk en met de monitoring om te bevestigen dat de dreiging is verdwenen.
Herstel is geen enkele actie. Het is een gecontroleerd, geënsceneerd proces.
Herstelprincipes:
- Herstel systemen in volgorde van bedrijfskritiek
- Haast je niet. Door een gecompromitteerd of onstabiel systeem weer online te brengen, wordt het incident uitgebreid.
- Implementeer verbeterde monitoring op elk hersteld systeem gedurende ten minste 30 dagen
- Definieer expliciete GO/NO-GO-criteria voordat u elk systeem live brengt - bevestig geen verdachte activiteit, geen onverwachte netwerkverbindingen, geen ongeoorloofde processen
Herstelstadia:
- Herstellen van geverifieerde schone back-up of opnieuw opgebouwde afbeelding
- Pas alle beveiligingspatches toe voordat u verbinding maakt met het netwerk
- Breng systemen online in een gefaseerde, bewaakte omgeving
- Valideer functionaliteit met een subset van gebruikers vóór volledig productieverkeer
- Schaal naar volledige productie zodra de stabiliteit is bevestigd
Voor serveromgevingen: De rol van uw hostingprovider bij herstel omvat het bevestigen van schone IP-reputatie (geen zwarte lijst van het incident), het herstellen van BGP-routering en het verifiëren van bewaking op netwerkniveau is actief. Bij Atal Networks werkt ons infrastructuurteam samen met uw beveiligingsteam tijdens de herstelfase om te bevestigen dat de netwerklaag schoon is voordat het volledige verkeer wordt hersteld.
Fase 6: geleerde lessen
Direct antwoord: Geleerde lessen is een gestructureerde beoordeling van het incident, uitgevoerd binnen 14 dagen na volledig herstel, om te identificeren wat werkte, wat faalde en wat moet veranderen.
NIST SP 800-61 Rev 3 vereist expliciet dat dit een onberispelijk proces is. Mensen zullen geen eerlijke observaties over mislukkingen delen als ze bang zijn voor straf. Het doel is om het systeem te verbeteren, niet om individuen te straffen.
De beoordeling na de incidenten omvat:
- Een volledige tijdlijn van het incident van de eerste indicator tot volledig herstel
- Wat detectie werkte en wat werd gemist?
- of de escalatieprotocollen correct functioneerden
- of communicatie (intern en extern) duidelijk en tijdig was
- Of de IRP en de playbooks nauwkeurig weerspiegelden wat het team moest doen
- waar middelen (mensen, tools, toegang) onvoldoende waren
Uitgangen:
- Bijgewerkte IRP en draaiboeken
- Nieuwe of herziene detectieregels
- Patching of configuratiewijzigingen geïdentificeerd tijdens RCA
- Opleidingsaanbevelingen voor specifieke teamleden of afdelingen
- Een schriftelijk rapport voor uitvoerend leiderschap, juridische en (indien nodig) regelgevers
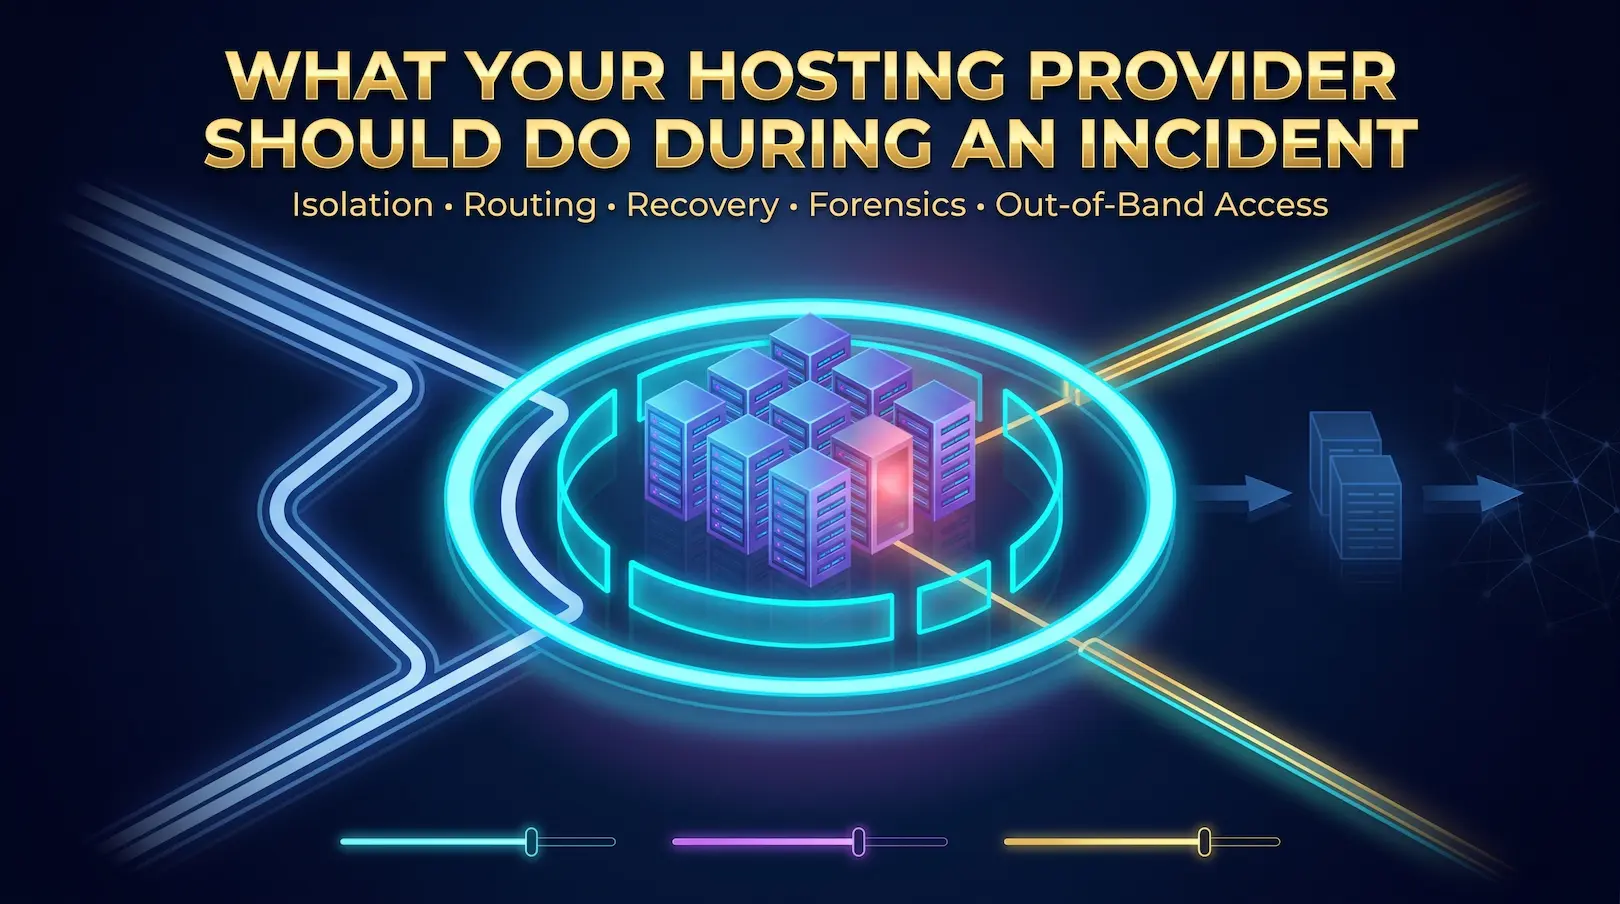
Wat uw hostingprovider moet doen tijdens een incident
Dit is de sectie die geen andere IR-gidsbekledingen behandelt. Het is ook de sectie die het belangrijkst is als uw bedrijf op cloud, VPS of dedicated serverinfrastructuur draait.
Uw hostingprovider is geen passieve omstander tijdens een beveiligingsincident. Ze beheren uw netwerktoegang, uw IP-routering, uw serverhardware en in veel gevallen uw out-of-band communicatiekanalen. Een capabele hostingprovider maakt deel uit van uw incidentresponsteam.
Dit is precies wat uw provider zou moeten kunnen doen:
Isolatie op netwerkniveau
Wanneer een server wordt bevestigd, moet u deze onmiddellijk van de rest van het internet afsnijden. Een goede hostingprovider kan:
- Implementeer een null-route op BGP-niveau, waardoor het IP-adres van de server van buitenaf onbereikbaar wordt
- Pas firewallregels toe aan de netwerkrand, niet alleen het serverniveau, om de zijwaartse beweging te blokkeren
- Wijs uw IP-adressen opnieuw toe als ze op de zwarte lijst staan vanwege uitgaande spam of aanvalsverkeer van de gecompromitteerde server
Bij Atal Networks kan isolatie op netwerkniveau onmiddellijk worden geactiveerd via ons ondersteuningsteam. We opereren in meer dan 213 datacenters met BGP-redundantie via Simply Transit, wat betekent dat isolatie- en routewijzigingen van kracht worden op de infrastructuurlaag, niet alleen op het OS-niveau.
Servertype is van belang: inperking per infrastructuur
Verschillende servertypen vereisen verschillende inperkingsbenaderingen. Uw IRP moet documenteren welk type u uitvoert en de exacte inperkingsstappen voor elk. Weet u niet zeker welk servertype past bij uw werkbelasting? ZIE ONZE Dedicated Servers versus VPS-hostingvergelijking.
| Servertype | insluitingsbenadering | Aanbieder actie |
| VPS | Snapshot de instantie, spin-up schone vervanging | Provider neemt momentopname op hypervisorniveau, isoleert de virtuele netwerkinterface van de VM |
| Dedicated server | Afsluiten op switchpoort of firewallniveau | Provider past toegangscontrolelijst (ACL) toe bij de switch, verbreekt de verbinding met Network Fabric |
| blank metaal | Volledige IP null-route + out-of-band console-toegang | Provider null-routes BGP, biedt IPMI/IDRAC-toegang voor onderzoek op afstand |
| het verzamelen | Physical access coordination | Aanbieder bestuurt netwerkverbindingen, coördineert toegang voor uw team of IR-bedrijf van derden |
Buitenbandcommunicatie tijdens een incident
Dit is het meest over het hoofd geziene stukje IR-planning. Als uw primaire systemen niet beschikbaar zijn - e-mail is niet beschikbaar, de speling is niet beschikbaar, uw VPN is niet beschikbaar - hoe communiceert en coördineert uw team?
Een serieuze hostingprovider geeft je out-of-band toegang via:
- IPMI (Intelligent Platform Management Interface): Toegang op consoleniveau tot uw serverhardware, onafhankelijk van het besturingssysteem. Als het besturingssysteem wordt gecompromitteerd, kunt u nog steeds zien wat er gebeurt en opdrachten geven.
- iDRAC / ILO: Beheerkaarten op fabrikantniveau die werken, zelfs wanneer de server is uitgeschakeld of het besturingssysteem is gecrasht.
- Toegewijd ondersteuningskanaal: een telefoonnummer of noodticketsysteem dat tijdens een bevestigd incident standaard ticketwachtrijen omzeilt.
Als uw hostingprovider geen out-of-band toegang tot uw servers kan bieden, is dat een serieus gat in uw incidentresponscapaciteit.
Logboekbewaring en forensische gegevens
Na een incident heb je logs nodig. Netwerkverkeerslogboeken, toegangslogboeken, authenticatielogboeken, DNS-querylogboeken. Uw hostingprovider kan logboeken op infrastructuurniveau bevatten die uw interne systemen niet vastleggen.
Bevestig voordat een incident zich voordoet met uw hostingprovider:
- Welke logboeken worden bewaard op infrastructuurniveau
- Hoe ver terug gaat het retentievenster (30 dagen, 90 dagen, langer)
- in welke indelingslogboeken worden afgeleverd voor forensische analyse
Bij Atal Networks bewaren we logboeken op infrastructuurniveau en kunnen we deze aan klanten leveren tijdens een bevestigd beveiligingsincident. Ons ondersteuningsteam coördineert rechtstreeks met uw IR-team of uw externe IR-firma.
Hoe u uw hostingprovider op de hoogte stelt
Op het moment dat u een beveiligingsincident bevestigt dat van invloed is op uw gehoste infrastructuur, opent u onmiddellijk een ondersteuningsticket en markeert het als een beveiligingsnoodgeval. Wacht niet tot de insluiting is voltooid.
informatie die u in uw melding moet opnemen:
- Bevestiging dat er een beveiligingsincident aan de gang is
- Welke servers of IP's worden beïnvloed
- Of u nu netwerkisolatie, logtoegang of out-of-band consoletoegang nodig heeft
- Uw oproepcontactgegevens voor de duur van het incident
Neem contact op met Atal Networks 24/7 ondersteuning — Ons team is de klok rond beschikbaar en behandelt beveiligingsincidenten als prioritaire escalaties.
Uw Incident Response Team (CSIRT) bouwen
Een Cybersecurity Incident Response Team (CSIRT) is de groep die verantwoordelijk is voor het uitvoeren van uw IR-plan wanneer zich een incident voordoet. Elk lid heeft een gedefinieerde rol voordat het incident plaatsvindt.
Kernrollen
Incidentmanager (IM) De IM leidt de reactie. Ze beheren communicatiestromen, updaten belanghebbenden, delegeren taken aan andere teamleden en volgen de klok. Kritisch is dat de IM tijdens het incident geen technische werkzaamheden uitvoert. Hun taak is coördinatie en besluitvorming. In een crisis is tijddilatatie echt - mensen verliezen uit het oog hoe lang dingen duren. Het IM bewaakt de klok en houdt het team op het goede spoor.
Technisch lood (TL) De TL dient als de technische materiedeskundige. Ze leiden inperking, uitroeiing en herstelacties, brengen waar nodig extra technische specialisten in en doen de beslissing om beslissingen te herbouwen en te herstellen. De TL coördineert met het infrastructuurteam van uw hostingprovider.
Communicatiemanager (CM) De CM beheert alle interne en externe communicatie tijdens het incident. Interne updates voor medewerkers en uitvoerend leiderschap. Externe communicatie naar klanten, toezichthouders en de media. De CM bereidt ook van tevoren holding-verklaringen voor - vooraf goedgekeurde taal voor scenario's zoals een verslaggever die belt over een vermoedelijke inbreuk.
Rechtsbijstand Juridisch moet worden betrokken vanaf het moment dat een inbreuk wordt bevestigd, vooral wanneer er persoonsgegevens kunnen worden betrokken. Ze adviseren over de tijdlijnen voor meldingsplichtige meldingen (AVG: 72 uur, HIPAA: 60 dagen), vereisten voor het afhandelen van bewijs en wat wel en niet extern kan worden gedeeld.
Uitvoerend sponsor Een senior executive met de autoriteit om beslissingen op zakelijk niveau te nemen tijdens een incident. Dit omvat het autoriseren van systeemshutdowns die van invloed zijn op de inkomsten, het goedkeuren van communicatie en het beslissen of ze een rechtshandhaving wil inschakelen.
Wanneer externe IR-bedrijven binnenhalen?
Externe IR-firma's brengen vooraf gebouwde playbooks, ervaren respondenten en forensische tooling die de meeste interne teams niet hebben. Overweeg om een aan te nemen wanneer:
- De ernst van het incident is P1 (ransomware, data-exfiltratie, volledig systeemcompromis)
- Je interne team mist ervaring met het specifieke aanvalstype
- U hebt onafhankelijk forensisch bewijs nodig voor juridische of verzekeringsdoeleinden
- Het incident is groot genoeg om uw interne capaciteit te overweldigen
Selecteer uw externe IR-firma voordat een incident plaatsvindt. Vooraf onderhandelen over een retainer is veel beter dan het zoeken naar een bedrijf tijdens een aanval.
Een tafelbladoefening uitvoeren
Een tafeloefening is een rollenspelsessie waarbij een facilitator een aanvalsscenario presenteert en het team in realtime door hun reactie praat. Er zijn geen echte systemen bij betrokken. De waarde zit in het vinden van hiaten in uw plan en besluitvorming voordat ze ertoe doen.
Een eenvoudig tafelbladformaat:
- Facilitator presenteert scenario: "Uw monitoringsysteem heeft zojuist ongewoon uitgaand verkeer van drie servers gemarkeerd. Het is 2 uur 's nachts op een zondag."
- Team bespreekt: wie wordt er eerst gebeld, welke acties worden ondernomen, welke informatie is nodig?
- Facilitator injecteert nieuwe ontwikkelingen: "De servers zijn gecompromitteerd. Ransomware is geïmplementeerd."
- Team vervolgt reactie
- Debriefing na de oefening: wat werkte, wat niet, welke hiaten werden gevonden
Run de tafelbladen minstens twee keer per jaar. Voer ze uit na elk belangrijk incident of grote wijziging van de infrastructuur.
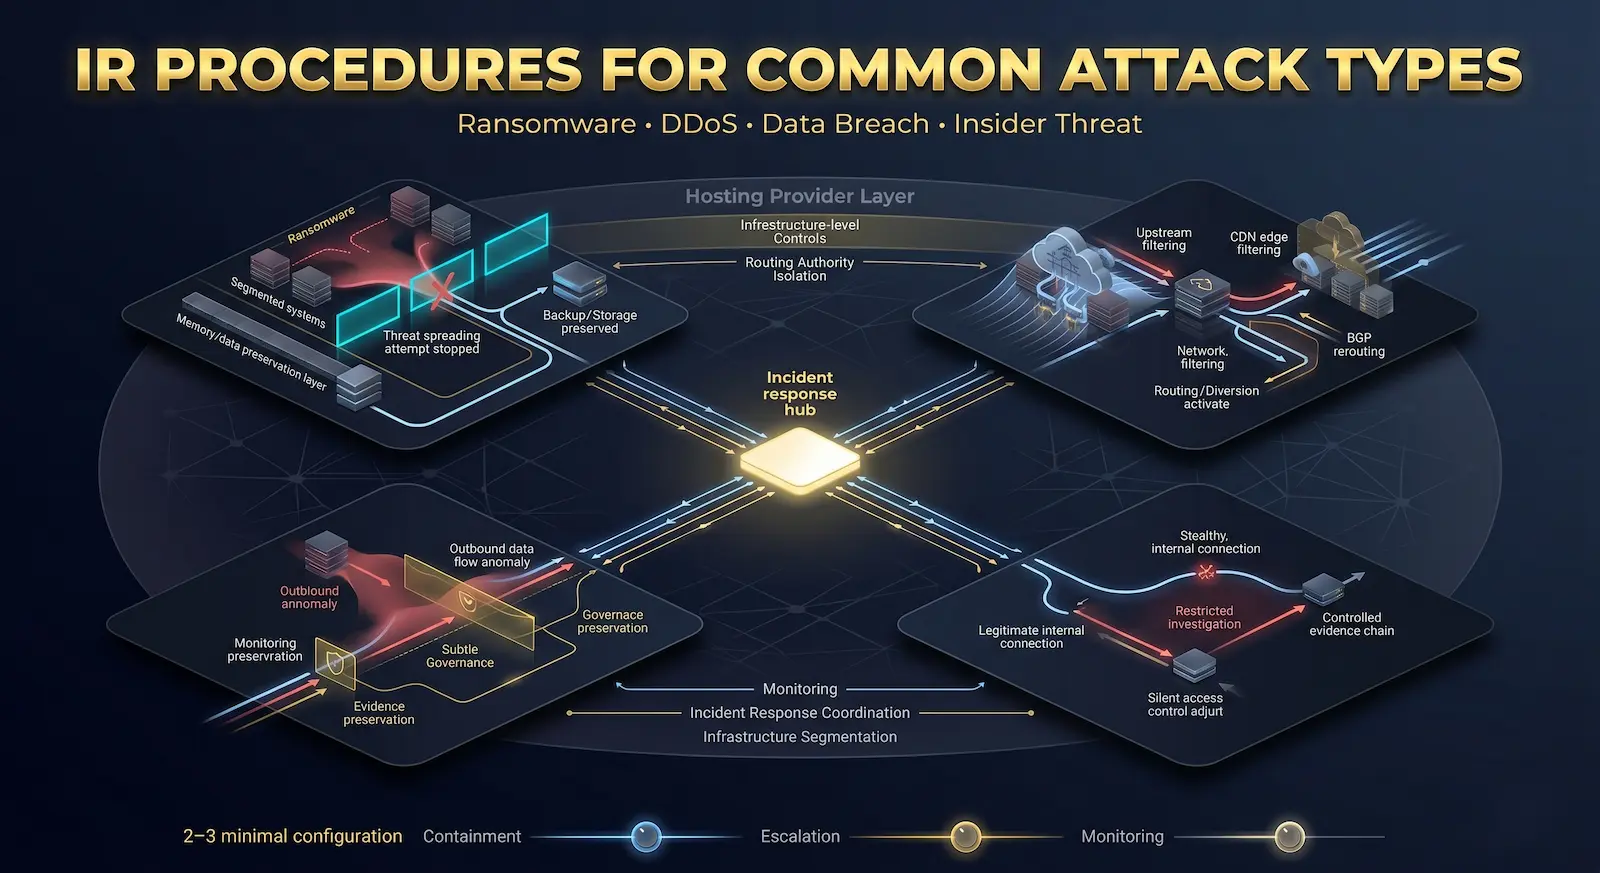
IR-procedures voor veelvoorkomende aanvalstypen
Uw algemene IRP behandelt de zes fasen. Je playbooks behandelen specifieke aanvalstypes. Hier zijn de belangrijkste beslissingen en acties voor de vier meest voorkomende scenario's.
ransomware
Ransomware is voor de meeste organisaties het type incident met de hoogste prioriteit. Snelheid van inperking bepaalt direct hoeveel gegevens worden versleuteld.
De beslissing om of niet te betalen: Wetshandhavingsinstanties, waaronder de FBI, bevelen aan om geen losgeld te betalen. Betaling garandeert geen gegevensherstel, financiert criminele operaties en kan OFAC-sancties schenden als de dreigingsactor op een geblokkeerde lijst staat. De betere positie is een geteste, gesegmenteerde back-upstrategie die betaling overbodig maakt.
Kritische acties:
- Isoleer de getroffen systemen onmiddellijk op netwerkniveau (uw hostingprovider kan dit doen)
- Herstart de getroffen systemen niet - geheugenforensisch onderzoek kan de tools van de aanvaller onthullen
- Identificeer de ransomware-variant om te bepalen of er een gratis decoderingssleutel bestaat (controleer nomoreransom.org)
- Breng uw cyberverzekeringsmaatschappij onmiddellijk op de hoogte
- de rechtshandhaving inschakelen - de FBI's Internet Crime Complaint Center (IC3) Verzamelt ransomware-rapporten en kan informatie hebben over de specifieke dreigingsactor
DDoS-aanvallen
Distributed Denial of Service valt de beschikbaarheid aan. Het antwoord bevindt zich op de netwerklaag, waardoor uw hostingprovider een primaire antwoordapparaat is, niet alleen een ondersteuningsresource.
Hosting-provider responsacties:
- Activeer DDoS-filtering en verkeersscrubbing aan de netwerkrand
- Pas snelheidsbeperking en verkeersvorming toe om aanvalsvolume te absorberen of om te leiden
- Implementeer IP-gebaseerde blokkering voor bevestigde aanvalsbronnen
- Betrek stroomopwaartse transitproviders voor verkeersblackholing als de aanval de schrobcapaciteit overschrijdt
Interne acties:
- Activeer de DDoS-beschermingslaag van uw CDN
- Schakel de snelheidsbeperking van de applicatielaag in op uw webservers
- Communiceer de geschatte servicehersteltijd aan de getroffen klanten
- Log al het aanvalsverkeer voor analyse na de incidenten vast
Bij Atal Networks omvat ons BGP-netwerk met Simply Transit-routering DDoS-beperkingsmogelijkheden. Bekijk onze Bare Metal Server-infrastructuur Voor meer informatie over wat er op infrastructuurniveau wordt behandeld.
datalek
Wanneer persoonlijke gegevens mogelijk zijn blootgesteld, begint de klok voor een melding van de regelgeving.
Tijdlijnen voor meldingen:
- AVG: 72 uur om de desbetreffende toezichthoudende autoriteit op de hoogte te stellen nadat hij op de hoogte is geraakt van de inbreuk
- hipa: 60 dagen na ontdekking om het HHS-kantoor voor burgerrechten op de hoogte te stellen
- Staatsovertredingswetten (VS): variëren per staat, variërend van 30 tot 90 dagen
Kritische acties:
- Bewaar al het bewijs vóór enige sanering
- Bepaal de omvang van de blootstelling: welke gegevens, hoeveel individuen, welke categorieën
- Schakel onmiddellijk juridisch adviseur in
- Ontwerpklanten en regelgevende meldingen - niet verzenden zonder juridische beoordeling
- Documenteer elke actie die wordt ondernomen met tijdstempels voor regelgevingsrapportage
Insider-dreiging
Insider-bedreigingen behoren tot de moeilijkst te detecteren en het meest gevoelig om te hanteren, omdat er werknemers, aannemers of partners bij betrokken zijn.
Belangrijkste verschillen in reactie:
- HR en Legal moeten vanaf de eerste indicatie worden betrokken
- Het verzamelen van bewijsmateriaal moet de juiste keten-of-bewaringsprocedures volgen voor mogelijke juridische procedures
- Communicatie over het onderzoek is beperkt tot een need-to-know-groep
- Toegangsherroeping moet zorgvuldig worden gecoördineerd om te voorkomen dat het onderwerp wordt gewaarschuwd voordat het bewijs is beveiligd
Incidentrespons en naleving
Regelgevende nalevingskaders bevelen niet alleen IR-plannen aan. Verschillende vereisen ze expliciet, met specifieke documentatie en testverplichtingen.
| Kader | IR Requirement |
| NIST CSF 2.0 | Reageren en herstellen functies vereisen gedocumenteerde IR-mogelijkheden — zie NIST's Incident Response Guidance |
| ISO 27035 | Internationale norm specifiek voor informatiebeveiligingsincidentbeheer |
| AVG | Artikel 33: Inbreukmelding binnen 72 uur, gedocumenteerde procedures vereist |
| hippees | Beveiligingsregel vereist gedocumenteerde procedures voor het reageren op incidenten en training van het personeel |
| PCI DSS | Vereiste 12.10: gedocumenteerd IR-plan, jaarlijkse tests, 24/7 responscapaciteit |
| SOC 2 | Incident response is een criterium voor de kernbeschikbaarheid en security trust service |
Voor organisaties die onderworpen zijn aan meerdere frameworks, dekt een enkele goed gedocumenteerde IRP die is afgestemd op NIST SP 800-61 REV 3 de meeste vereisten. De sleutel is documentatie, testen van bewijs en regelmatige updates.
Checklist voor incidentreactie
Gebruik deze checklist tijdens een actief incident. Print het uit en houd een kopie offline.
Voorbereiding (Pre-incident)
- [ ] IRP gedocumenteerd en goedgekeurd door juridisch, HR en uitvoerend leiderschap
- [ ] CSIRT-rollen toegewezen met benoemde back-ups voor elke rol
- [ ] Playbooks geschreven voor ransomware, DDoS, datalekken en insiderbedreiging
- [ ] Out-of-band communicatiekanalen getest en bevestigd werken
- [ ] De contactpersoon voor noodbeveiliging van de hostingprovider bevestigd en offline opgeslagen
- [ ] Backup integriteit geverifieerd — Laatste testdatum: ___________
- [ ] Tafelbladoefening voltooid — Laatste datum: ___________
- [ ] Externe IR Firm Retainer op zijn plaats (indien van toepassing): ___________
Detectie en identificatie
- [ ] Alert ontvangen of incident gemeld: Tijd: ___________
- [ ] Initiële triage voltooid - vals positief of waar incident bevestigd
- [ ] Incident ernst geclassificeerd: P1 / P2 / P3 / P4
- [ ] Incidentmanager aangemeld: Tijd: ___________
- [ ] Incidentlogboek geopend en uitgevoerd
- [ ] passend speelboek geactiveerd
bedrog
- [ ] Aangetaste systemen geïdentificeerd en geïnventariseerd
- [ ] Netwerkisolatie geïmplementeerd (intern + providerniveau)
- [ ] Gecompromitteerde accounts uitgeschakeld
- [ ] Forensisch bewijs dat is vastgelegd voordat de sanering begint
- [ ] Hostingprovider aangemeld (als serverinfrastructuur wordt beïnvloed): tijd: ___________
- [ ] Wetshandhavers op de hoogte (indien vereist): Tijd: ___________
- [ ] Verloofde juridisch adviseur: Tijd: _____________
Uitstraling
- [ ] Oorzaakanalyse voltooid
- [ ] Alle malware en ongeautoriseerde toegangshulpmiddelen verwijderd
- [ ] misbruikte kwetsbaarheid gepatcht of verzacht
- [ ] Ongeautoriseerde accounts en inloggegevens verwijderd
- [ ] Wachtwoord opnieuw ingesteld voor betrokken accounts
Herstel
- [ ] Herstelplan gedocumenteerd met geprioriteerde systeemlijst
- [ ] Back-upintegriteit geverifieerd vóór herstel
- [ ] Systemen hersteld en gevalideerd voordat ze terugkeerden naar de productie
- [ ] Verbeterde bewaking actief op herstelde systemen
- [ ] Hostingprovider bevestigde schone IP-reputatie en netwerkroutering
post-incident
- [ ] Lessen-gelezen vergadering gepland (binnen 14 dagen): Datum: ___________
- [ ] IRP en playbooks bijgewerkt op basis van bevindingen
- [ ] Regelgevingsmeldingen verzonden (indien vereist): Datum: ___________
- [ ] Uitvoerende en bestuursbriefing voltooid
- [ ] Incidentrapport ingediend bij verzekeringsmaatschappij (indien van toepassing)
Real-World Casestudy: St. Paul Ransomware-aanval (2025)
In juli 2025 werd de stad St. Paul, Minnesota, getroffen door een gecoördineerde ransomware-aanval die overheidsdiensten in de stad verstoorde. De respons toonde zowel aan wat werkt als waar organisaties zich op moeten voorbereiden bij incidenten met hoge ernst.
De tijdlijn:
- 25 juli: Verdachte activiteit gedetecteerd op stadsnetwerken. IT-team begint onmiddellijk met onderzoekstriage.
- 27 juli: Kwaadaardig gedrag bevestigd. City IT sluit alle informatiesystemen proactief af om verdere verspreiding te voorkomen.
- Volgende dagen: FBI ingeschakeld voor inperking en forensisch onderzoek. Minnesota National Guard cyberactiva geactiveerd door de gouverneur.
Wat werkte:
- Vroege detectie: de eerste waarschuwing op 25 juli gaf het team twee dagen voordat ze de beslissing namen om de shutdown te nemen. Dat detectievenster was van cruciaal belang.
- Isolatie boven betaling: St. Paul koos ervoor om het losgeld niet te betalen. In plaats daarvan implementeerden ze defensief isolement en systematisch herstel, wat het financiële verlies beperkte en de prikkel voor toekomstige aanvallen verminderde.
- Overheidspartnerschappen: het betrekken van de FBI en de Nationale Garde bracht middelen en forensische capaciteiten die het interne team van de stad alleen niet kon bieden.
- Grootschalige reset voor referenties: ongeveer 3.500 werknemersaccounts werden gereset als onderdeel van het herstel, waardoor fysieke coördinatie nodig was om het proces veilig te beheren.
De les: Geen enkele organisatie is te groot of te goed van toepassing om geraakt te worden. Het verschil tussen een beheersbaar incident en een catastrofaal is het bestaan van een getest IR-plan, duidelijke autoriteit om te handelen en de relaties (met wetshandhavers, met uw hostingprovider, met een extern IR-bedrijf) tot stand gebracht voordat de aanval arriveert.
Hoe AI de incidentrespons in 2026 verandert
Kunstmatige intelligentie verandert IR tegelijkertijd in twee richtingen: het maakt geautomatiseerde detectie en reactie sneller, en het maakt aanvallen verfijnder en moeilijker te vangen.
AI-aangedreven detectie en SOAR
Security Orchestration, Automation en Response (SOAR)-platforms gebruiken nu machine learning om waarschuwingen te correleren met meerdere beveiligingstools, prioriteit te geven aan echte bedreigingen en vooraf goedgekeurde reactieacties automatisch uit te voeren - zonder te wachten tot een mens elke waarschuwing bekijkt.
UEBA-platforms (User and Entity Behaviour Analytics) bouwen basismodellen van normaal gedrag voor elke gebruiker en elk apparaat in uw netwerk. Afwijkingen van die basislijn - een gebruiker die 50 GB downloadt om 3 uur 's nachts, een serviceaccount dat toegang heeft tot systemen die het nooit heeft aangeraakt - activeer waarschuwingen die op regels gebaseerde systemen volledig missen.
XDR-platforms (Extended Detection and Response) consolideren eindpunt-, netwerk-, identiteits- en cloudtelemetrie in één detectieoppervlak, waardoor IR-teams zichtbaarheid krijgen die voorheen onmogelijk was zonder meerdere afzonderlijke tools.
Het vals-positieve probleem
AI-gestuurde detectie genereert meer waarschuwingen. Meer waarschuwingen betekent meer triagewerk. De triagelast voor menselijke IR-teams is aanzienlijk toegenomen naarmate AI-tools gevoeliger worden.
Een volwassen IR-programma in 2026 investeert evenveel in vals-positieve reductie als in detectiecapaciteit. Slecht afgestemde detectieregels die branden op goedaardige responscapaciteit voor afval en - gevaarlijker - trainen teams om waarschuwingen te negeren. Dat is precies het patroon dat echte incidenten laat doorglijden.
AI-aangedreven aanvallen
Dezelfde AI-mogelijkheden die beschikbaar zijn voor verdedigers zijn beschikbaar voor aanvallers. AI wordt gebruikt om meer overtuigende phishing-e-mails te schrijven, doelen efficiënter te identificeren, malware aan te passen om detectie te ontwijken en verkenning te automatiseren. De verfijning van aanvallen neemt sneller toe dan de meeste IR-programma's evolueren.
De praktische implicatie: IR-plannen moeten rekening houden met een snellere aanvalsprogressie. Het venster tussen de eerste toegang en het volledige compromis is korter dan twee jaar geleden. Detectiesnelheid en inperkingssnelheid zijn belangrijker dan ooit.
Veelgestelde vragen
Wat zijn de 6 stappen van incidentrespons?
De zes stappen van incidentrespons zijn: (1) Voorbereiding — Het bouwen van uw team, tools en plannen voordat een incident zich voordoet; (2) Identificatie — het detecteren en bevestigen dat er een beveiligingsincident heeft plaatsgevonden; (3) inperking — het isoleren van getroffen systemen om te voorkomen dat het incident zich verspreidt; (4) Uitroeiing — het verwijderen van alle sporen van de aanvaller en het sluiten van misbruikte kwetsbaarheden; (5) Herstel — Herstel van systemen voor normaal gebruik veilig en met bewaking; (6) Geleerde lessen — Binnen 14 dagen een beoordeling na het incident uitvoeren om uw processen te verbeteren.
Wat is het verschil tussen NIST en SANS Incident Response Frameworks?
NIST SP 800-61 consolideert insluiting, uitroeiing en herstel in een enkele fase omdat het werk vaak overlapt. SANS scheidt ze in drie verschillende fasen voor teams die de voorkeur geven aan duidelijke overdrachten van fase voor fase. Beide kaders bestrijken dezelfde kernactiviteiten. NIST is beter geschikt voor organisaties onder Amerikaanse federale nalevingsvereisten of met formele bestuursstructuren. Sans werkt beter voor kleinere teams die hun eerste IR-programma bouwen.
Hoe lang moet een incidentresponsplan zijn?
Een IRP moet lang genoeg zijn om volledig te zijn en kort genoeg om onder druk te worden gelezen. De meest effectieve IRP's zijn 10 tot 30 pagina's voor het kerndocument, met aparte draaiboeken voor elk type aanval. Een plan dat niemand tijdens een crisis leest, is geen plan - het is een document. Houd de kern-IRP beknopt en zet de operationele details in de playbooks.
Wat doet een hostingprovider tijdens een serverbeveiligingsincident?
Een capabele hostingprovider kan verschillende kritieke acties ondernemen tijdens een beveiligingsincident: het implementeren van isolatie op netwerkniveau door het IP-adres van uw server op het BGP-niveau te implementeren, waardoor u toegang krijgt tot out-of-band consoletoegang (IPMI/IDRAC) voor het onderzoeken van een gecompromitteerde server zonder afhankelijk te zijn van de gecompromitteerde toegang OS, het activeren van DDoS-filtering en verkeersscrubing, het verstrekken van logboeken op infrastructuurniveau voor forensische analyse en het coördineren van IP-reputatieherstel tijdens herstel. Bij Atal Networks behandelt ons 24/7 ondersteuningsteam beveiligingsincidenten als prioritaire escalaties en coördineert rechtstreeks met uw IR-team of externe IR-firma. Neem hier contact op met ons team.
Hoe vaak moet u uw incidentresponsplan testen?
Uw IRP moet minimaal één keer per jaar worden beoordeeld en bijgewerkt. Tafelbladoefeningen moeten minstens twee keer per jaar worden uitgevoerd - en onmiddellijk na een significante wijziging van het incident of grote infrastructuur. Volledige gesimuleerde oefeningen (rood team versus blauw team of penetratietests tegen specifieke aanvalsscenario's) moeten ten minste jaarlijks worden uitgevoerd. Het doel is nooit om uw IRP een document te laten worden dat alleen op papier bestond.
Wat is NIST SP 800-61 Rev 3?
NIST SP 800-61 Revisie 3 is de huidige versie van het Incident Response Guidance-document van het National Institute of Standards en Technologie, gepubliceerd in april 2025. Cybersecurity Framework 2.0, introduceert een nieuw communityprofiel voor cyberincidentrisicobeheer en legt sterker de nadruk op continue verbetering, documentatie en governance. Het is het meest waarnaar wordt verwezen in incidentresponskader in Amerikaanse federale en ondernemingsomgevingen.
slotwoord
Incidentresponsprocedures zijn geen selectievakje voor naleving. Ze zijn het verschil tussen een beveiligingsincident dat u een paar uur kost en een incident dat u miljoenen dollars kost, klantvertrouwen en maanden herstelwerk.
De organisaties die incidenten goed afhandelen, zijn niet degenen met de beste tools. Zij zijn degenen die voorbereid, gedocumenteerd, getraind en getest voordat de aanval arriveerde.
En nog een ding: je hostinginfrastructuur maakt deel uit van je IR-plan, of je er nu over nagedacht hebt of niet. Een provider die een gecompromitteerde server op netwerkniveau kan isoleren, u toegang tot de console buiten de band kan geven en om 2 uur 's nachts met uw team kan coördineren, is het waard om over na te denken voordat u ze nodig heeft.
Bij Atal Networks draaien we VPS-servers, dedicated servers, en bare metal-infrastructuur in 213+ datacenters wereldwijd. Ons team is 24/7 beschikbaar voor beveiligingsincidenten. Als u uw IR-plan bekijkt en wilt begrijpen hoe uw hostinginfrastructuur daarin past, Neem contact op met ons ondersteuningsteam — We zijn blij om door uw opstelling te lopen.
Gepubliceerd door Atal Networks — Global hosting provider die meer dan 36.000 klanten bedient in 196 landen met dedicated servers, VPS-hosting, bare metal infrastructuur en 24/7 expertondersteuning.
