 Перейти к содержимому



Кибератака не ждет, пока вы будете готовы. Он быстро поражает, быстро распространяется и стоит быстро. IBM 2024 г. Стоимость отчета об утечке данных обнаружили, что организации с формальным планом реагирования на инциденты и обученной командой сэкономили в среднем $473 706 за нарушение по сравнению с организациями без них.
Этот разрыв не случайность. Это результат четких процедур реагирования на инциденты до того, как произойдет нарушение, а не изобретать их, пока системы горят.
Это руководство охватывает все: что такое процедуры реагирования на инциденты, обновленные NIST SP 800-61 Rev 3 Фреймворк опубликован в апреле 2025 года, поэтапная разбивка всех шести этапов и то, что никакие другие руководства не охватывают, что ваш провайдер инфраструктуры хостинга должен делать в момент подтверждения инцидента.
Если вы управляете своим бизнесом на VPS, выделенном сервере или сервере Bare Metal, уровень инфраструктуры является частью вашего реагирования на инцидент. Это руководство рассматривает его таким образом.
Содержание
- Что такое процедура реагирования на инциденты?
- NIST SP 800-61 Rev 3: что изменилось в апреле 2025 года
- NIST против SANS: выбор правильного фреймворка
- 6 фаз реагирования на инцидент
- Что ваш хостинг-провайдер должен делать во время инцидента
- Создание группы реагирования на инциденты (CSIRT)
- ИК-процедуры для обычных типов атак
- Реагирование на инцидент и соблюдение
- Контрольный список реагирования на инциденты
- Часто задаваемые вопросы
Что такое процедура реагирования на инциденты?
Процедура реагирования на инциденты — это документированный пошаговый набор действий, которые ваша команда предпринимает при происшествии. Оно говорит людям, кто что делает, в каком порядке и с какой властью.
Три термина постоянно путаются. Вот разница:
| Срок | Что это |
| ИК-фреймворк | Стратегическая модель. NIST и Sans оба публикуют их. Это «конституция» — принципы и фазы высокого уровня. |
| План реагирования на инцидент (IRP) | тактический документ для вашей организации. Он называет вашу команду, ваши инструменты, пути связи и ваши пороги эскалации. |
| ИК плейбук | Операционный скрипт для определенного типа атаки. Один для программы-вымогателя, один для DDoS, другой для утечки данных. Снял с полки в тот момент, когда этот инцидент подтверждается. |
У большинства организаций есть план. У гораздо меньше есть плейбуков. Их почти никто не тестировал.
Что считается инцидентом безопасности?
NIST SP 800-61 Rev 3 определяет инцидент с кибербезопасностью как нарушение или неминуемую угрозу нарушения политик компьютерной безопасности, политик допустимого использования или стандартные методы безопасности.
На практике это включает в себя:
- вымогатель или вредоносное ПО
- Несанкционированный доступ к системам или данным
- Эксфильтрация данных (подтверждено или подозреваемая)
- DDoS-атаки нарушают доступность сервиса
- Активность внутренней угрозы
- Фишинговые атаки, которые приводят к компромиссу
- Компромисс цепочки поставок
- Отказ в обслуживании на сетевом или прикладном уровне
Не каждое предупреждение является инцидентом. Частью сильной ИК-процедуры является процесс сортировки, который отделяет ложные срабатывания от истинных событий безопасности, требующих ответа.
NIST SP 800-61 Rev 3: что изменилось в апреле 2025 года
В апреле 2025 года Национальный институт стандартов и технологий (NIST) опубликовал окончательную версию Специальная публикация 800-61 Редакция 3 — Самое значительное обновление руководства по реагированию на инциденты за более чем десятилетие.
Предыдущая версия (Rev 2, опубликованная в 2012 г.) рассматривала реакцию инцидента как ограниченный, линейный набор из четырех фаз. Вы обнаруживаете инцидент, отвечаете, выздоравливаете, пишете отчет, полученный от уроков. готово
Rev 3 меняет эту модель принципиально.
Ключевые изменения в SP 800-61 Rev 3
- Интеграция с CSF 2.0 Rev 3 больше не является отдельной публикацией. Он построен как профиль сообщества в рамках NIST CyberSecurity Framework 2.0. Это означает, что реакция на инцидент теперь вплетена во все шесть функций CSF: управлять, идентифицировать, защищать, обнаруживать, реагировать и восстанавливать.
- Постоянное улучшение теперь явно Старая модель закончилась на «усвоенных уроках». Rev 3 рассматривает постоянное совершенствование как первоклассное требование, а не как запоздалую мысль. Ожидается, что организации будут постоянно тестировать, обновлять и развивать свои возможности в области ИК, а не только после инцидентов.
- Требования к документации расширены Rev 3 уделяет больше внимания написанным плейбукам, ролевым заданиям и предварительно авторизованным деревьям решений. Цель состоит в том, чтобы устранить импровизацию в реальном времени во время активного инцидента.
- Техническая деталь сдвинулась Поскольку специфика быстрого изменения ИК-излучения в различных технологиях и средах, Rev 3 намеренно переместила детальное техническое руководство в дополнительные ресурсы. Сама публикация посвящена принципам управления рисками, которые применяются во всех средах.
Если ваш план реагирования на инцидент был написан против версии 2012 года, ему нужен обзор. Основные этапы аналогичны, но модель управления и требования к непрерывному улучшению существенно отличаются.
NIST против SANS: выбор правильного фреймворка
И NIST, и SAN пользуются большим уважением. Оба верны. Разница сводится к тому, как они делят фазы и для каких организаций они лучше всего подходят.
параллельное сравнение
| Фаза | NIST SP 800-61 Rev 3 | Справочник обработчика инцидентов SANS |
| 1 | Подготовка | Подготовка |
| 2 | Обнаружение и анализ | Удостоверение личности |
| 3 | Сдерживание, искоренение и восстановление | Политика сдерживания |
| 4 | Активность после инцидента | Искоренение |
| 5 | — | Восстановление |
| 6 | — | Извлеченные уроки |
Практическая разница: Группы NIST сдерживание, искоренение и восстановление в одну фазу, поскольку работа часто пересекается — вы не должны ждать, пока сдерживание не будет завершено, прежде чем начать искоренить подтвержденные угрозы. SANS разделяет их на три отдельные фазы для команд, которые предпочитают четкую передачу между действиями.
Какой из них использовать:
- НИСТ Лучше работает для организаций, подпадающих под действие федеральных требований США, более крупных предприятий с определенными структурами управления и групп, которые работают в рамках формальных рамок управления рисками.
- Без Лучше работает для небольших групп безопасности, организаций, которым нужны четкие поэтапные контрольные списки, и команды, которые создают свою первую ИК-программу.
Честный ответ заключается в том, что оба дают один и тот же результат при правильном выполнении. Выберите один, задокументируйте его и обучите свою команду.
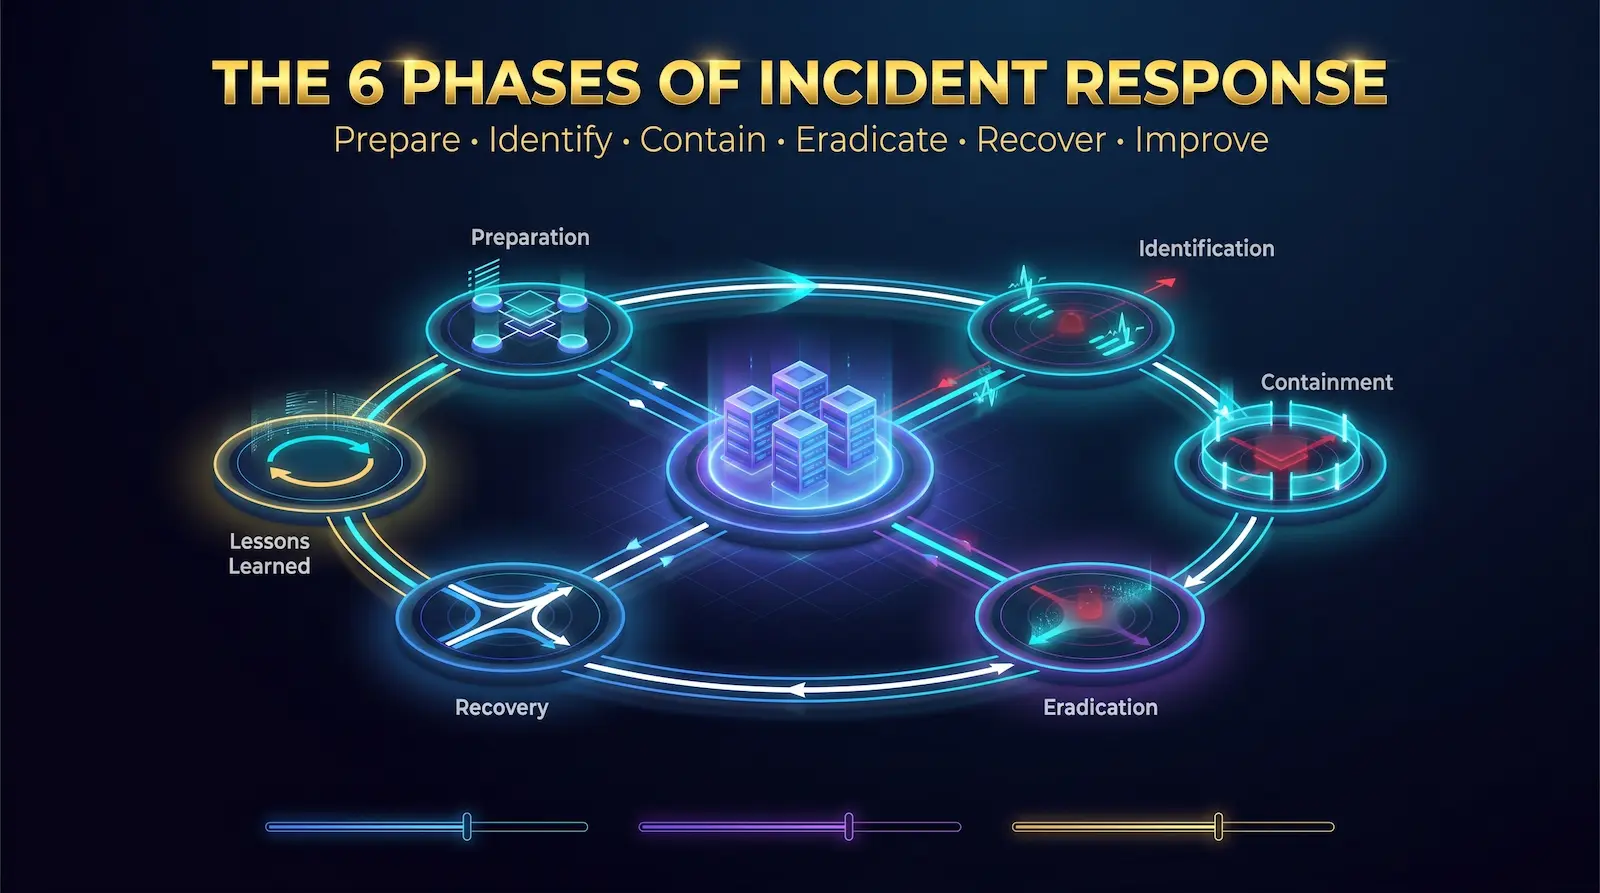
6 фаз реагирования на инцидент
Шесть этапов ниже следуют Справочник обработчика инцидентов без модель, потому что она дает наиболее четкое операционное разделение между действиями. Выравнивание NIST CSF 2.0 отмечено, где это необходимо.
Фаза 1: Подготовка
Прямой ответ: Подготовка — это все, что вы делаете до того, как произойдет инцидент, чтобы убедиться, что вы можете эффективно реагировать, когда это делаете.
Подготовка является наиболее важной фазой, в которую большинство организаций не инвестируют. Оно охватывает:
Команда и структура:
- Определите роли вашей группы реагирования на инциденты в кибербезопасности (CSIRT) (подробно описаны ниже)
- Назначьте менеджера по инцидентам, технического руководителя и менеджера по коммуникациям
- Документировать матрицу полномочий: кто может разрешить систему отключения, кто уведомляет регулирующих органов, кто общается с прессой
Инструменты и доступ:
- Развертывание инструментов мониторинга: SIEM, EDR, UEBA и анализ сетевого трафика
- Подтвердите, что ваша команда готова к выходным каналам связи — отдельная платформа зашифрованных сообщений, дерево телефона или физическая точка встречи, когда основные системы выходят из строя.
- Ведите актуальную инвентаризацию активов, чтобы вы знали, что вы защищаете
Документация:
- Напишите свой IRP и проверяйте его с помощью юридического, HR и исполнительного руководства.
- Напишите учебники для ваших сценариев с наивысшим риском: программы-вымогатели, DDoS, утечка данных, Insider Threat
- Храните печатные копии в безопасном автономном месте
Тестирование:
- Запускайте настольные упражнения не реже одного раза в квартал. Столешница — это ролевая сессия, где фасилитатор представляет сценарий атаки, и команда обсуждает свой ответ.
- Запустите тесты на проникновение, чтобы найти пробелы, прежде чем это сделают злоумышленники
- Время вашего ответа упражняется и записывает метрики — это становится вашим базовым уровнем для измерений улучшения
Подготовка к хостингу (критическая и незамеченная):
- Узнайте процесс контакта с провайдером вашего хостинга, прежде чем вам это нужно
- Подтвердите, что покрывает ваш хостинг SLA: изоляция сети, переназначение IP, доступ к журналам и внеполосная связь во время крупного инцидента
- В Atal Networks наша круглосуточная служба поддержки может быть доступна немедленно во время инцидента с безопасностью сервера. Свяжитесь с нашей службой поддержки здесь.
Фаза 2: Идентификация
Прямой ответ: Идентификация — это процесс обнаружения потенциального инцидента, сбора доказательств и подтверждения того, произошло ли истинное событие безопасности.
Не каждое предупреждение является инцидентом. Эта фаза существует для того, чтобы сделать это определение точно и быстро.
Триггеры обнаружения делятся на две категории:
Фронтальная (раннее предупреждение): Фиды сведений об угрозах, предупреждения о приманке, аномальные попытки входа в систему, необычные модели сетевого трафика или правила корреляции SIEM, которые срабатывают до того, как произойдет повреждение. Они ловят больше ложных срабатываний, но останавливают атаки раньше.
Загруженный (видимый урон): Пользователи, сообщающие о проблемах с производительностью, недоступны данные, заметки о выкупе или внешние исследователи, сообщающие о нарушении. Это скорее реальные инциденты, но прибывают после того, как начались повреждения.
Процесс сортировки:
- Собирайте все доступные данные: журналы, оповещения, отчеты пользователей и сетевые захваты
- Определите, является ли событие ложноположительным или истинным инцидентом
- В случае истинного инцидента классифицируйте его по степени тяжести (P1/Critical, P2/High, P3/Medium, P4/Low)
- Активируйте соответствующий плейбук
Ключевой принцип: Запишите все с этого момента вперед. Каждое действие, каждое решение, каждая метка времени. Этот журнал является вашей юридической отчетностью, вашей страховой документацией и материалом, извлеченным из уроков.
Фаза 3: Сдерживание
Прямой ответ: Сдерживание ограничивает область действия инцидента, чтобы предотвратить его распространение на дополнительные системы или данные.
Контейнер имеет два этапа:
Краткосрочная локализация происходит сразу. Цель состоит в том, чтобы быстро остановить кровотечение. Действия включают в себя изоляцию затронутой системы из сети, блокировку IP-адресов злоумышленника, отключение скомпрометированных учетных записей пользователей и активацию DDoS-фильтрации при объемной атаке.
Долгосрочное сдерживание происходит, когда искоренение готовится. Затронутые системы продолжают работать (или восстанавливаются до чистого изображения) в изолированной среде, поэтому судебно-медицинское расследование может продолжаться.
Сдерживание уровня сервера — что это значит на практике:
За Среды VPS, сдерживание часто означает сделать снимок затронутого экземпляра и раскрутить чистую замену. Компромиссированный снимок сохраняется для судебно-медицинской экспертизы, но сохраняется в автономном режиме и вне сети.
За выделенные серверы, для содержания может потребоваться отключение на уровне сети на порту коммутатора или на уровне правила брандмауэра. Ваш хостинг-провайдер может реализовать это на уровне инфраструктуры, быстрее, чем может действовать большинство внутренних команд.
За bare metal серверы, может потребоваться полная физическая изоляция. Это означает, что null-маршрутизация IP сервера на уровне BGP — сервер становится недоступным из общедоступного Интернета, пока ваша команда исследует.
Сохраняйте целостность судебной экспертизы во время сдерживания. Не протирайте системы перед сбором доказательств. Дампы памяти, запущенные списки процессов, состояния сетевого подключения и полные образы диска должны быть записаны до начала какой-либо исправления.
Фаза 4: Искоренение
Прямой ответ: Eradication удаляет все следы атаки из вашей среды — вредоносное ПО, бэкдоры, скомпрометированные учетные данные и эксплуатируемые уязвимости.
Искоренение должно быть тщательным, иначе нападающий вернется. Самая распространенная неудача в ИР заключается в том, что среда чистая, когда бэкдор или спящий имплантат все еще присутствуют.
Шаги ликвидации:
- Проведите анализ коренных причин (RCA), чтобы точно определить, как злоумышленник попал в
- Удалите все вредоносные программы, полезные программы-вымогатели и вредоносные скрипты
- Исследуйте и закройте эксплуатируемую уязвимость (исправление, изменение конфигурации или отзыв доступа)
- Удалите все несанкционированные учетные записи администратора и ключи SSH, добавленные злоумышленником
- Восстановление поврежденных или управляемых систем из известного базового уровня
- Обновите правила брандмауэра и политики фильтрации DNS
- принудительно сбросить пароль для всех учетных записей в радиусе взрыва — и для привилегированных учетных записей в организации в качестве предосторожности
- Поверните ключи API, учетные данные учетной записи службы и сертификаты, которые могли быть открыты
Решение о восстановлении против восстановления: Восстановление с нуля занимает больше времени, но гарантирует чистую систему. Восстановление из резервной копии происходит быстрее, но безопасно только в том случае, если резервная копия предшествует взлому, а сама резервная копия не была скомпрометирована. Для тяжелых инцидентов перестраивайтесь.
Фаза 5: Восстановление
Прямой ответ: Восстановление восстанавливает затронутые системы до нормальной работы безопасно, постепенно и с установленным мониторингом, чтобы подтвердить, что угроза исчезла.
Восстановление — это не одно действие. Это контролируемый, поэтапный процесс.
Принципы восстановления:
- Восстановление систем в порядке деловой критичности
- Не торопитесь. Возвращение скомпрометированной или нестабильной системы в Интернете расширяет инцидент.
- Внедрите расширенный мониторинг каждой восстановленной системы не менее 30 дней
- Определите явные критерии перехода/отказы, прежде чем запускать каждую систему в реальном времени — подтверждать отсутствие подозрительной активности, никаких неожиданных сетевых подключений, никаких несанкционированных процессов
Этапы восстановления:
- Восстановление из проверенной чистой резервной копии или восстановленного образа
- Примените все исправления безопасности перед подключением к сети
- Сначала вывести системы в онлайн в поэтапной, контролируемой среде
- Проверка функциональности с подмножеством пользователей перед полным производственным трафиком
- Масштаб до полного производства после подтверждения стабильности
Для серверных сред: Роль вашего хостинг-провайдера в восстановлении включает подтверждение чистого IP-репутации (отсутствие черного списка из инцидента), восстановление маршрутизации BGP и активная проверка мониторинга на уровне сети. В Atal Networks наша команда инфраструктуры работает вместе с вашей группой безопасности на этапе восстановления, чтобы подтвердить, что сетевой уровень чист до восстановления полного трафика.
Фаза 6: Извлеченные уроки
Прямой ответ: Извлеченные уроки — это структурированный обзор инцидента, проведенный в течение 14 дней после полного восстановления, чтобы определить, что сработало, что не удалось, а что нужно изменить.
NIST SP 800-61 Rev 3 явно требует, чтобы это был безупречный процесс. Люди не будут делиться честными наблюдениями о неудачах, если боятся наказания. Цель состоит в том, чтобы улучшить систему, а не наказывать людей.
В обзоре постинцидента рассматриваются:
- Полная хронология инцидента от первого индикатора до полного восстановления
- Какое обнаружение сработало и что пропущено
- Правильно ли функционировали протоколы эскалации
- была ли связь (внутренняя и внешняя) ясной и своевременной
- Точно ли отражали ли IRP и Playbooks то, что нужно сделать команде?
- где ресурсов (людей, инструментов, доступа) было недостаточно
Выходы:
- Обновлены IRP и Playbooks
- Новые или пересмотренные правила обнаружения
- исправление или изменения конфигурации, выявленные во время RCA
- Рекомендации по обучению для конкретных членов команды или отделов
- Письменный отчет для исполнительного руководства, юридических и (при необходимости) регуляторов
Что ваш хостинг-провайдер должен делать во время инцидента
Это раздел, который не имеет других ИК-направляющих крышек. Это также раздел, который имеет наибольшее значение, если ваш бизнес работает в облаке, VPS или выделенной серверной инфраструктуре.
Ваш хостинг-провайдер не является пассивным прохожим во время инцидента с безопасностью. Они управляют вашим сетевым доступом, вашей IP-маршрутизацией, вашим серверным оборудованием и, во многих случаях, вашими внеполосными каналами связи. Способный провайдер хостинга является частью вашей группы реагирования на инциденты.
Вот именно, что ваш провайдер должен быть в состоянии сделать:
Изоляция на уровне сети
Когда сервер подтверждается скомпрометированным, он должен немедленно отрезать его от остальной части Интернета. Хороший хостинг-провайдер может:
- Реализовать нулевый маршрут на уровне BGP, что делает IP-адрес сервера недоступным извне
- Примените правила брандмауэра на краю сети, а не только на уровне сервера, чтобы заблокировать боковое движение
- Переназначьте свои IP-адреса, если они занесены в черный список из-за исходящего спама или атаки трафика с скомпрометированного сервера.
В Atal Networks изоляция сетевого уровня может быть активирована сразу через нашу службу поддержки. Мы работаем в более чем 213 центрах обработки данных с избыточностью BGP через Simply Transit, что означает, что изменения изоляции и маршрутизации вступают в силу на уровне инфраструктуры, а не только на уровне ОС.
Тип сервера имеет значение: сдерживание по инфраструктуре
Для разных типов серверов требуются разные подходы к сдерживанию. Ваш IRP должен задокументировать, какой тип вы запускаете, и точные шаги для каждого из них. Не знаете, какой тип сервера соответствует вашей рабочей нагрузке? См. наш Выделенные серверы и сравнение хостинга VPS.
| Тип сервера | Сдерживающий подход | Действия провайдера |
| VPS | Снимок экземпляра, раскрутка чистой замены | Провайдер делает снимок на уровне гипервизора, изолирует виртуальный сетевой интерфейс виртуальной машины |
| Выделенный сервер | выключаться на уровне порта коммутатора или брандмауэра | Провайдер применяет список контроля доступа (ACL) на коммутаторе, отключается от сети Network Fabric |
| голый металл | Полный IP-маршрут NULL-маршрут + внеполосный доступ к консоли | Провайдер нулевых маршрутов BGP, обеспечивает IPMI/IDRAC доступ для удаленного исследования |
| Размещение | Координация физического доступа | Провайдер контролирует сетевые межсоединения, координирует доступ для вашей команды или сторонней фирмы по ИК |
Внеполосная связь во время инцидента
Это самая забытая часть ИК-планирования. Если ваши основные системы не работают — электронная почта не работает, Slack не работает, ваш VPN не работает — как ваша команда общается и координирует свои действия?
Серьезный хостинг-провайдер предоставляет вам внеполосный доступ через:
- IPMI (интерфейс управления платформой): Доступ к консольному оборудованию к вашему серверному оборудованию независимо от операционной системы. Если ОС скомпрометирована, вы все равно можете видеть, что происходит, и выдавать команды.
- IDRAC / МОТ: Карты удаленного управления на уровне производителя, которые работают, даже когда сервер выключен или операционная система неисправна.
- Специальный канал поддержки: Номер телефона или система экстренного билета, которая обходит стандартные очереди билетов во время подтвержденного инцидента.
Если ваш хостинг не может предложить внеполосный доступ к вашим серверам, это серьезный пробел в возможностях реагирования на инциденты.
Удержание журнала и данные судебной экспертизы
После инцидента вам понадобятся журналы. Журналы сетевого трафика, журналы доступа, журналы аутентификации, журналы запросов DNS. Ваш хостинг-провайдер может хранить журналы на уровне инфраструктуры, которые ваши внутренние системы не собирают.
Прежде чем произойдёт инцидент, подтвердите у своего хостинг-провайдера:
- Какие журналы сохраняются на уровне инфраструктуры
- Как далеко уходит окно удержания (30 дней, 90 дней, дольше)
- В каком формате журналы поставляются для криминалистического анализа
В Atal Networks мы сохраняем журналы на уровне инфраструктуры и можем предоставлять их клиентам во время подтвержденного инцидента безопасности. Наша служба поддержки согласовывается напрямую с вашей командой ИК или вашей внешней ИК-фирмой.
Как уведомить провайдера хостинга
В тот момент, когда вы подтверждаете инцидент с безопасностью, затрагивающую вашу размещенную инфраструктуру, немедленно откройте тикет службы поддержки и отметьте его как экстренную безопасность. Не ждите, пока сдерживание не будет завершено.
Информация для включения в ваше уведомление:
- Подтверждение того, что произошел инцидент безопасности
- Какие серверы или IP-адреса затронуты
- Нужна ли вам изоляция сети, доступ к журналам или внеполосный доступ к консоли
- Ваши контактные данные по вызову на время инцидента
Связаться с Atal Networks 24/7 — Наша команда доступна круглосуточно и рассматривает инциденты безопасности как приоритетную эскалацию.
Создание группы реагирования на инциденты (CSIRT)
Группа реагирования на инциденты в кибербезопасности (CSIRT) — это группа, отвечающая за выполнение вашего плана IR, когда происходит инцидент. У каждого участника есть определенная роль до того, как произойдет инцидент.
Основные роли
Менеджер по инцидентам (IM) IM ведет реакцию. Они управляют потоками связи, обновляют заинтересованные стороны, делегируют задачи другим членам команды и отслеживают часы. Важно, что IM во время инцидента не выполняет техническую работу. Их работа – координация и принятие решений. В кризисе замедление времени актуально — люди теряют счет того, сколько времени уходят. IM следит за часами и держит команду в курсе.
Технический руководитель (TL) TL выступает в качестве эксперта по техническим вопросам. Они направляют действия по сдерживанию, искоренению и восстановлению, при необходимости привлекают дополнительных технических специалистов и делают призыв к принятию решений о восстановлении и восстановлении. TL координируется с командой инфраструктуры вашего хостинг-провайдера.
Менеджер по коммуникациям (CM) CM управляет всеми внутренними и внешними коммуникациями во время инцидента. Внутренние обновления сотрудников и исполнительного руководства. Внешние коммуникации с клиентами, регуляторами и средствами массовой информации. CM также заранее готовит заявления о холдинге — предварительно одобренные формулировки для сценариев, таких как репортер, звонящий по поводу предполагаемого нарушения.
Юрисконсульт Юридическое лицо должно быть задействовано с момента подтверждения нарушения, особенно когда могут быть задействованы личные данные. Они консультируют по срокам уведомления регулирующих органов (GDPR: 72 часа, HIPAA: 60 дней), требования к обработке доказательств и то, что можно и что нельзя делить извне.
исполнительный спонсор Высший руководитель, имеющий право принимать решения на уровне бизнеса во время инцидента. Это включает в себя разрешение системных закрытий, которые влияют на доход, утверждение сообщений и принятие решения о том, следует ли привлекать правоохранительные органы.
Когда привозить внешние ИК-фирмы
Внешние фирмы IR привозят готовые плейбукы, опытных специалистов по реагированию и судебную экспертизу, которых нет у большинства внутренних команд. Consider engaging one when:
- Серьезность инцидента P1 (вымогатель, эксфильтрация данных, полный компромиссы системы)
- Вашей внутренней команде не хватает опыта работы с конкретным типом атаки
- Вам нужны независимые судебно-медицинские доказательства для юридических или страховых целей
- Инцидент достаточно велик, чтобы сокрушить вашу внутреннюю способность
Выберите свою внешнюю ИК-фирму до того, как произойдёт инцидент. Предварительная переговоры о гоноре намного лучше, чем поиск фирмы во время нападения.
Запуск настольного упражнения
Настольное упражнение — это ролевая сессия, на которой фасилитатор представляет сценарий атаки, и команда обсуждает свой ответ в режиме реального времени. Никаких реальных систем не задействовано. Ценность заключается в поиске пробелов в вашем плане и принятии решений, прежде чем они имеют значение.
Базовый формат настольного:
- Facilitator представляет сценарий: «Ваша система мониторинга только что пометила необычный исходящий трафик с трех серверов. Сейчас 2 часа ночи».
- Команда обсуждает: кому звонят первыми, какие действия предпринимаются, какая информация нужна
- Facilitator внедряет новые разработки: «Серверы подтверждены скомпрометированы. Развернуты программы-вымогатели».
- Команда продолжает реагировать
- Подведение итогов после тренировки: что сработало, а что нет, какие пробелы были обнаружены
Запускайте столешницы не реже двух раз в год. Запускайте их после каждого существенного инцидента или серьезной смены инфраструктуры.
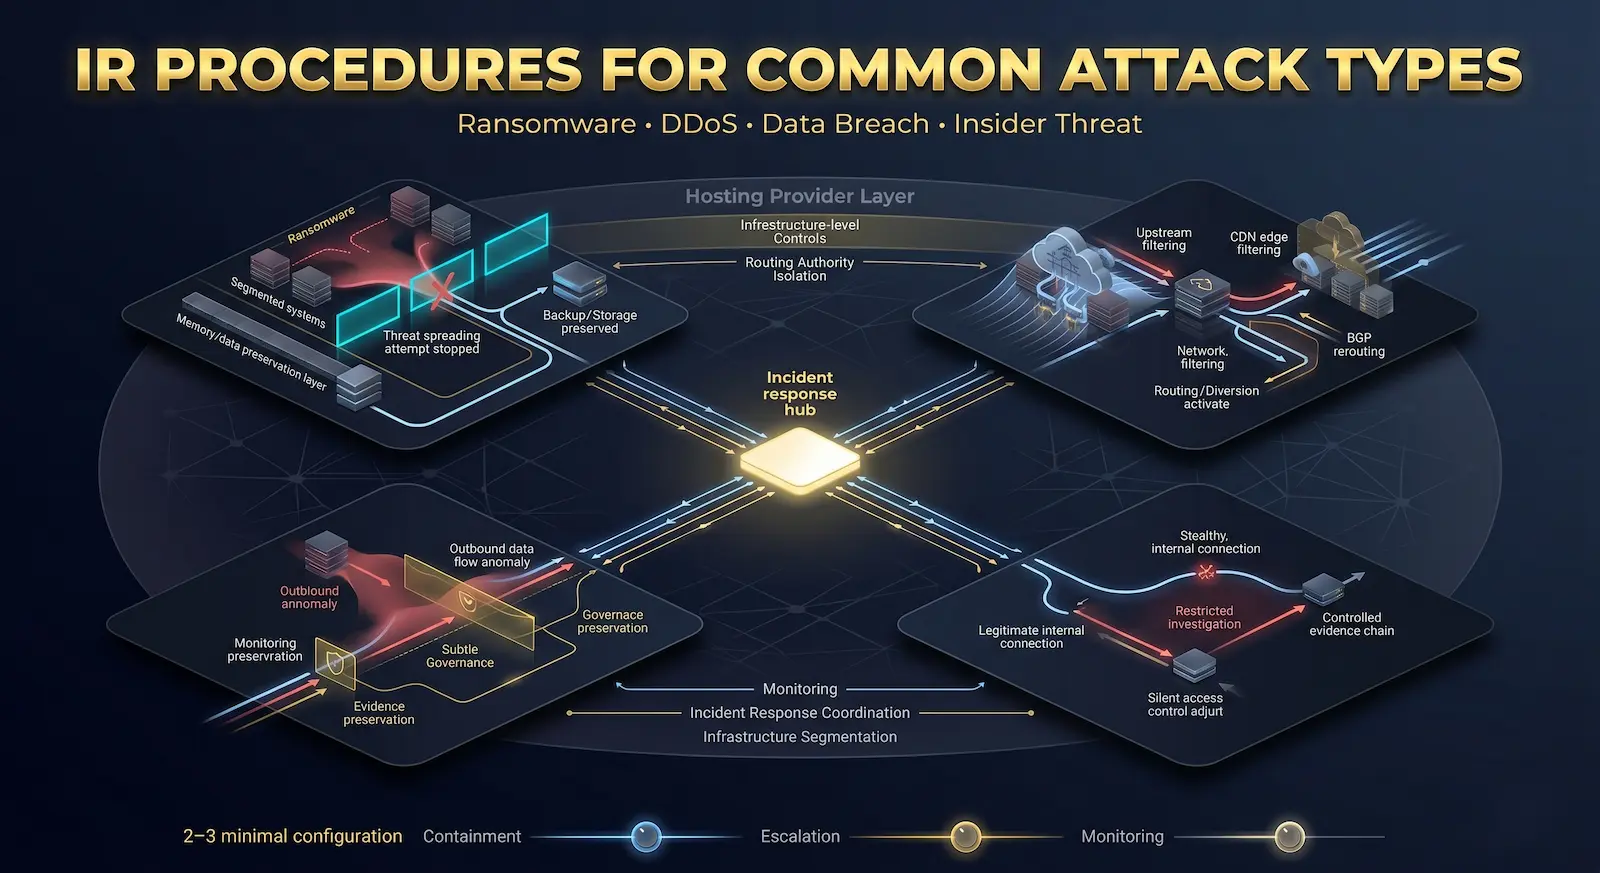
ИК-процедуры для обычных типов атак
Ваш общий IRP охватывает шесть фаз. Ваши плейбукы охватывают конкретные типы атак. Вот ключевые решения и действия для четырех наиболее распространенных сценариев.
Программа-вымогатель
Программа-вымогатель является наиболее приоритетным типом инцидента для большинства организаций. Скорость сдерживания напрямую определяет, сколько данных зашифровано.
Решение о заработной плате или не оплате: Правоохранительные органы, включая ФБР, рекомендуют не платить выкуп. Оплата не гарантирует восстановление данных, финансирует преступную деятельность и может нарушить санкции OFAC, если субъект угрозы находится в заблокированном списке. Лучшая позиция — это проверенная сегментированная стратегия резервного копирования, которая делает ненужной оплату.
Критические действия:
- Изолируйте затронутые системы немедленно на уровне сети (ваш хостинг-провайдер может это сделать)
- Не перезагружайте затронутые системы — судебная экспертиза памяти может выявить инструменты злоумышленника
- Определите вариант программы-вымогателя, чтобы определить, существует ли свободный ключ расшифровки (проверьте nomoraransom.org)
- Notify your cyber insurance carrier immediately
- заниматься правоохранительными органами — Центр жалоб на преступление в Интернете (IC3) Собирает отчеты о программах-вымогателях и может иметь информацию о конкретном субъекте угрозы
DDoS-атаки
Распределенные атаки типа «отказ в обслуживании» целевую доступность. Ответ находится на сетевом уровне, что делает вашего хостинг-провайдера основным респондентом, а не просто ресурсом поддержки.
Действия ответа на хостинг-провайдер:
- Активируйте фильтрацию DDoS и очистку трафика на грани сети
- Примените ограничение скорости и формирование трафика для поглощения или перенаправления объема атаки
- Внедрить блокировку на основе IP для подтвержденных источников атак
- Привлекайте провайдеров транзитных перевозок для дорожного движения, если атака превышает емкость очистки
Внутренние действия:
- Активируйте уровень защиты от DDoS вашего CDN
- Включите ограничение скорости на уровне приложений на ваших веб-серверах
- Сообщите предполагаемое время восстановления обслуживания затронутым клиентам
- Зарегистрировать весь атакующий трафик для анализа после инцидента
В Atal Networks наша сеть BGP с просто транзитной маршрутизацией включает в себя возможности по смягчению последствий DDoS. Смотрите нашу инфраструктуру Bare Metal Server Для получения подробной информации о том, что покрывается на уровне инфраструктуры.
утечка данных
Когда личные данные могли быть раскрыты, часы начинаются для уведомления нормативных актов.
Сроки уведомлений:
- GDPR: 72 часа, чтобы уведомить соответствующий надзорный орган после того, как узнали о нарушении
- HIPAA: 60 дней с момента открытия, чтобы уведомить Управление HHS о гражданских правах
- Государственные законы о нарушениях (США): Варьируется в зависимости от состояния, от 30 до 90 дней
Критические действия:
- Сохраните все доказательства до любой исправительной
- Определить масштабы воздействия: какие данные, сколько особей, какие категории
- Немедленно привлеките юрисконсульт
- Проект уведомлений клиентов и регулирующих органов — не отправляйте без юридической проверки
- Документируйте все действия, предпринятые с помощью меток времени для нормативной отчетности
Внутренняя угроза
Внутренние угрозы являются одними из самых трудных для обнаружения и наиболее чувствительными в обращении, потому что в них участвуют сотрудники, подрядчики или партнеры.
Ключевые различия в ответах:
- HR и Legal должны быть вовлечены с первого указания
- Сбор доказательств должен следовать надлежащим процедурам цепочки поставок для потенциального судопроизводства
- Сообщение о расследовании ограничивается группой, связанной с необходимостью познания.
- Отзыв доступа должен быть тщательно согласован, чтобы избежать предупреждения испытуемого до получения доказательств
Реагирование на инцидент и соблюдение
Рамки соблюдения нормативных требований не просто рекомендуют планы IR. Некоторые требуют их явно, с конкретной документацией и обязательствами по тестированию.
| Рамки | Требование ИК |
| NIST CSF 2.0 | Функции реагирования и восстановления требуют задокументированных возможностей IR — см. Руководство NIST по реагированию на инциденты |
| ИСО 27035 | Международный стандарт специально для управления инцидентами в области информационной безопасности |
| GDPR | Статья 33: уведомление о нарушении в течение 72 часов, требуются документированные процедуры |
| ХИПАА | Правило безопасности требует задокументированных процедур реагирования на инциденты и обучения рабочей силы |
| PCI DSS | Требование 12.10: Задокументированный план ИК-плана, ежегодное тестирование, 24/7 возможности реагирования |
| SOC 2 | Реагирование на инциденты — это основной критерий обслуживания доступности и безопасности доверия |
Для организаций, подверженных множеству фреймворков, единый хорошо задокументированный IRP, соответствующий NIST SP 800-61 Rev 3, предусматривает большинство требований. Ключевым моментом является документация, тестирование доказательств и регулярные обновления.
Контрольный список реагирования на инциденты
Используйте этот контрольный список во время активного инцидента. Распечатайте и сохраните копию в автономном режиме.
Подготовка (до инцидента)
- [ ] IRP задокументировано и одобрено юридическим, HR и исполнительным руководством
- [ ] Роли CSIRT, назначенные с именем резервных копий для каждой роли
- [ ] Плейбуки, написанные для вымогателей, DDoS, утечки данных и инсайдерской угрозы
- [ ] Внеполосные каналы связи проверены и подтверждены
- [ ] Контакты службы экстренной безопасности хостинг-провайдера подтверждены и сохранены в автономном режиме
- [ ] Проверка целостности резервного копирования — дата последнего тестирования: ___________
- [ ] Настольное упражнение выполнено — Последняя дата: __________
- [ ] Внешний держатель фирмы IR на месте (если применимо): ___________
Обнаружение и идентификация
- [ ] Получено предупреждение или сообщение об инциденте: Время: ___________
- [ ] Первоначальная сортировка завершена — подтвержден ложноположительный или истинный инцидент
- [ ] Степень серьезности инцидента: P1/P2/P3/P4
- [ ] Менеджер по инцидентам уведомлен: Время: ___________
- [ ] Журнал инцидентов открыт и запущен
- [ ] Активирован соответствующий плейбук
Политика сдерживания
- [ ] Затронутые системы идентифицированы и инвентаризированы
- [ ] Реализована сетевая изоляция (внутренний + уровень провайдера)
- [ ] скомпрометированные учетные записи отключены
- [ ] Судебно-медицинские доказательства, захваченные до начала реабилитации
- [ ] Уведомление провайдера хостинга (если затронута инфраструктура сервера): Время: ___________
- [ ] Уведомление правоохранительных органов (при необходимости): Время: __________
- [ ] Юрисконсульт помолвлен: Время: __________
Искоренение
- [ ] Анализ коренных причин завершен
- [ ] Удалены все вредоносные программы и несанкционированные инструменты доступа
- [ ] Эксплуатируемая уязвимость исправлена или смягчена
- [ ] Удалены несанкционированные учетные записи и учетные данные
- [ ] Начат сброс пароля для затронутых учетных записей
Восстановление
- [ ] План восстановления задокументирован со списком приоритетных систем
- [ ] Целостность резервного копирования проверена перед восстановлением
- [ ] Системы восстановлены и подтверждены до возвращения к производству
- [ ] Улучшенный мониторинг активен в восстановленных системах
- [ ] хостинг-провайдер подтвердил чистую репутацию IP и сетевую маршрутизацию
пост-инцидент
- [ ] Запланировано собрание уроков (в течение 14 дней): Дата: ___________
- [ ] IRP и плейбукы обновлены на основе результатов
- [ ] Отправленные нормативные уведомления (при необходимости): Дата: ___________
- [ ] Брифинг исполнительной власти и совета директоров завершен
- [ ] Отчет об инциденте, поданный в страховую компанию (если применимо)
Реальный пример из практики: атака программы-вымогателя St. Paul (2025)
В июле 2025 года город Сент-Пол, штат Миннесота, подвергся скоординированной атаке программ-вымогателей, которая нарушила государственные службы по всему городу. Ответ продемонстрировал как то, что работает, и к чему организация должна готовиться в инцидентах с высокой степенью серьезности.
Хронология:
- 25 июля: Подозрительная активность обнаружена в городских сетях. ИТ-команда немедленно начинает расследование.
- 27 июля: Подтверждено злонамеренное поведение. Город он отключает все информационные системы упреждающе, чтобы предотвратить дальнейшее распространение.
- Следующие дни: ФБР занимается сдерживанием и судебно-медицинским расследованием. Киберактивы Национальной гвардии Миннесоты активированы губернатором.
Что работало:
- Раннее обнаружение: Первоначальное предупреждение 25 июля дало команде два дня до того, как они приняли решение об отключении. Это окно обнаружения было критическим.
- Изоляция из-за оплаты: Сент-Пол решил не платить выкуп. Вместо этого они внедрили обороноспособность и систематическое восстановление, что ограничило финансовые потери и уменьшило стимулы для будущих атак.
- Партнерство правительства: Привлечение ФБР и Национальной гвардии принесло ресурсы и судебную экспертизу, которые внутренняя команда города не могла предоставить.
- Крупномасштабный сброс учетных данных: около 3500 учетных записей сотрудников были сброшены в рамках восстановления, что требовало физической координации для безопасного управления процессом.
Урок: Ни одна организация не является слишком большой или слишком хорошо обеспеченной, чтобы ее можно было ударить. Разница между управляемым инцидентом и катастрофическим заключается в существовании проверенного плана IR, четкого полномочий действовать и отношений (с правоохранительными органами, с вашим хостинг-провайдером, с внешней фирмой IR), установленными до прибытия атаки.
Как ИИ меняет реакцию инцидента в 2026 году
Искусственный интеллект меняет ИК в двух направлениях: он ускоряет автоматическое обнаружение и реагирование и делает атаки более сложными и труднее улавливать.
Обнаружение и SOAR на базе искусственного интеллекта
Платформы оркестровки безопасности, автоматизации и реагирования (SOAR) теперь используют машинное обучение, чтобы сопоставлять предупреждения по нескольким инструментам безопасности, расставлять приоритеты подлинным угрозам и автоматически выполнять предварительно одобренные действия ответа, не дожидаясь, пока человек проверит каждое предупреждение.
Платформы UEBA (аналитика поведения пользователей и сущностей) создают базовые модели нормального поведения для каждого пользователя и устройства в вашей сети. Отклонения от этой базовой линии — пользователь, загружающий 50 ГБ в 3 часа ночи, системы доступа к сервисным учетным записям, к которым он никогда не прикасался, — запускают предупреждения, которые полностью упускают системы на основе правил.
Платформы XDR (расширенное обнаружение и ответ) объединяют конечные точки, сеть, идентификацию и облачную телеметрию в единую поверхность обнаружения, что дает ИК-командам видимость, что ранее было невозможно без нескольких отдельных инструментов.
Ложная положительная проблема
Обнаружение, управляемое ИИ, генерирует больше предупреждений. Больше предупреждений означает больше работы по сортировке. Нагрузка на человеческую ИК-команду значительно увеличилась по мере того, как инструменты ИИ становятся более чувствительными.
Зрелая ИК-программа в 2026 году инвестирует столько же в ложноположительные сокращения, сколько в возможности обнаружения. Плохо настроенные правила обнаружения, которые стреляют по доброкачественной способности реагирования на отходы активности и, что еще более опасно, обучают команды игнорировать предупреждения. Это именно тот шаблон, который позволяет реальным инцидентам проскальзывать.
Атаки на базе ИИ
Те же возможности ИИ, которые доступны защитникам, доступны для злоумышленников. ИИ используется для того, чтобы писать более убедительные фишинговые электронные письма, более эффективно определять цели, адаптировать вредоносное ПО для уклонения от обнаружения и автоматизировать разведку. Изощренность атак увеличивается быстрее, чем развивается большинство программ ИК.
Практическое значение: планы IR должны учитывать более быструю продвижение атаки. Окно между первоначальным доступом и полным компромиссом короче, чем два года назад. Скорость обнаружения и скорость сдерживания имеют значение больше, чем когда-либо.
Часто задаваемые вопросы
Каковы 6 шагов реагирования на инцидент?
Шесть шагов реагирования на инцидент: (1) подготовка — создание вашей команды, инструментов и планов до того, как произойдет инцидент; (2) Идентификация — обнаружение и подтверждение того, что произошёл инцидент безопасности; (3) сдерживание — изоляция затронутых систем, чтобы предотвратить распространение инцидента; (4) уничтожение — удаление всех следов злоумышленника и закрытие эксплуатируемых уязвимостей; (5) восстановление — восстановление систем до нормального режима работы и с контролем на месте; (6) Извлеченные уроки — проведение обзора после инцидента в течение 14 дней для улучшения ваших процессов.
В чем разница между структурами реагирования на инциденты NIST и SAN?
NIST SP 800-61 объединяет сдерживание, искоренение и восстановление в одну фазу, поскольку работа часто пересекается. SANS разделяет их на три отдельные фазы для команд, которые предпочитают четкие поэтапные передачи. Оба фреймворка охватывают одну и ту же основную деятельность. NIST лучше подходит для организаций в соответствии с федеральными требованиями соответствия США или с формальными структурами управления. SANS лучше подходит для небольших команд, создающих свою первую ИК-программу.
Как долго должен быть план реагирования на инциденты?
IRP должен быть достаточно длинным, чтобы быть полным и достаточно коротким, чтобы его можно было прочитать под давлением. Наиболее эффективным IRP являются от 10 до 30 страниц для основного документа, с отдельными плейбуками для каждого типа атаки. План, который никто не читает во время кризиса, — это не план — это документ. Сохраняйте краткую базу IRP и помещайте детали в плейбукы.
Что делает хостинг-провайдер во время инцидента с безопасностью сервера?
Способный хостинг-провайдер может предпринять несколько критических действий во время инцидента с безопасностью: Реализация изоляции на уровне сети путем нулевой маршрутизации IP вашего сервера на уровне BGP, обеспечивая внеполосный доступ к консоли (IPMI/IDRAC) для исследования скомпрометированного сервера, не полагаясь на скомпрометированный ОС, активируя фильтрацию DDoS и очистку трафика, обеспечивая журналы на уровне инфраструктуры для криминалистического анализа и координируя восстановление репутации IP во время восстановления. В Atal Networks наша круглосуточная служба поддержки рассматривает инциденты безопасности как приоритетные эскалации и координирует непосредственно вашу команду IR или внешнюю компанию IR. Contact our team here.
Как часто вы должны проверять свой план реагирования на инциденты?
Ваш IRP должен пересматриваться и обновляться как минимум один раз в год. Настольные упражнения должны проводиться не реже двух раз в год и сразу после любого существенного инцидента или серьезной смены инфраструктуры. Полные смоделированные упражнения (красная команда против синей команды или тесты на проникновение в отношении конкретных сценариев атаки) должны выполняться не реже одного раза в год. Цель никогда не допустить, чтобы ваш IRP стал документом, который существовал только на бумаге.
Что такое NIST SP 800-61 Rev 3?
NIST SP 800-61 Редакция 3 является текущей версией Национального института стандартов и рекомендаций по реагированию на инциденты, опубликованной в апреле 2025 года. Он обновляет предыдущую версию 2012 года (Rev 2) путем интеграции реагирования на инциденты в NIST Cybersecurity Framework 2.0, введение нового профиля сообщества в области управления рисками киберпроисшествий и уделение большего внимания постоянному совершенствованию, документированию и управлению. Это наиболее широко используемая структура реагирования на инциденты в федеральной и корпоративной среде США.
Заключительное слово
Процедуры реагирования на инциденты не являются флажком соответствия. Это разница между инцидентом безопасности, который стоит вам несколько часов, и инцидентом, который стоит вам миллионы долларов, доверие клиентов и месяцы восстановительных работ.
Организации, которые хорошо справляются с инцидентами, не те, у которых есть лучшие инструменты. Это те, кто готовился, задокументировал, обучил и проверил до наступления нападения.
И еще: ваша хостинговая инфраструктура является частью вашего плана IR, независимо от того, думали ли вы об этом так или нет. Провайдер, который может изолировать скомпрометированный сервер на сетевом уровне, предоставит вам внеполосный доступ к консоли и координирует свою работу с вашей командой в 2 часа ночи, стоит подумать, прежде чем они вам понадобятся.
В Atal Networks мы запускаем VPS-серверы, выделенные серверы, и bare metal инфраструктуре в более чем 213 центрах обработки данных по всему миру. Наша команда работает круглосуточно и без выходных. Если вы просматриваете свой план IR и хотите понять, как в него вписывается ваша инфраструктура хостинга, Обратитесь в нашу службу поддержки — Мы с удовольствием пройдемся по вашей установке.
Опубликовано Atal Networks — глобальный хостинг-провайдер, обслуживающий более 36 000 клиентов в 196 странах с выделенными серверами, хостингом VPS, инфраструктурой Bare Metal и круглосуточной экспертной поддержкой.
