 跳至内容



通过 Atal Networks 首席硬件工程师 | MLPERF v4.1 贡献者 | 12 年 GPU 集群架构 | 更新时间:2026年4月19日
| TL;DR — 什么是 AI 推理? AI 推理是在新输入数据上运行经过训练的 AI 模型以产生预测、分类或生成的输出的过程。 这是人工智能的“做”阶段——每一个聊天回复、欺诈警报、图像说明和自动驾驶感知电话都是推理事件。 2026 年,推理消耗了全球 AI 计算总支出的三分之二左右。 本指南涵盖了完整的管道、为其提供支持的硬件、衡量它的指标(TTFT、ITL、令牌/秒)以及运行的成本——以及在 Atal Networks 自己的服务器上测量的基准。 |
什么是人工智能推理? 一句定义
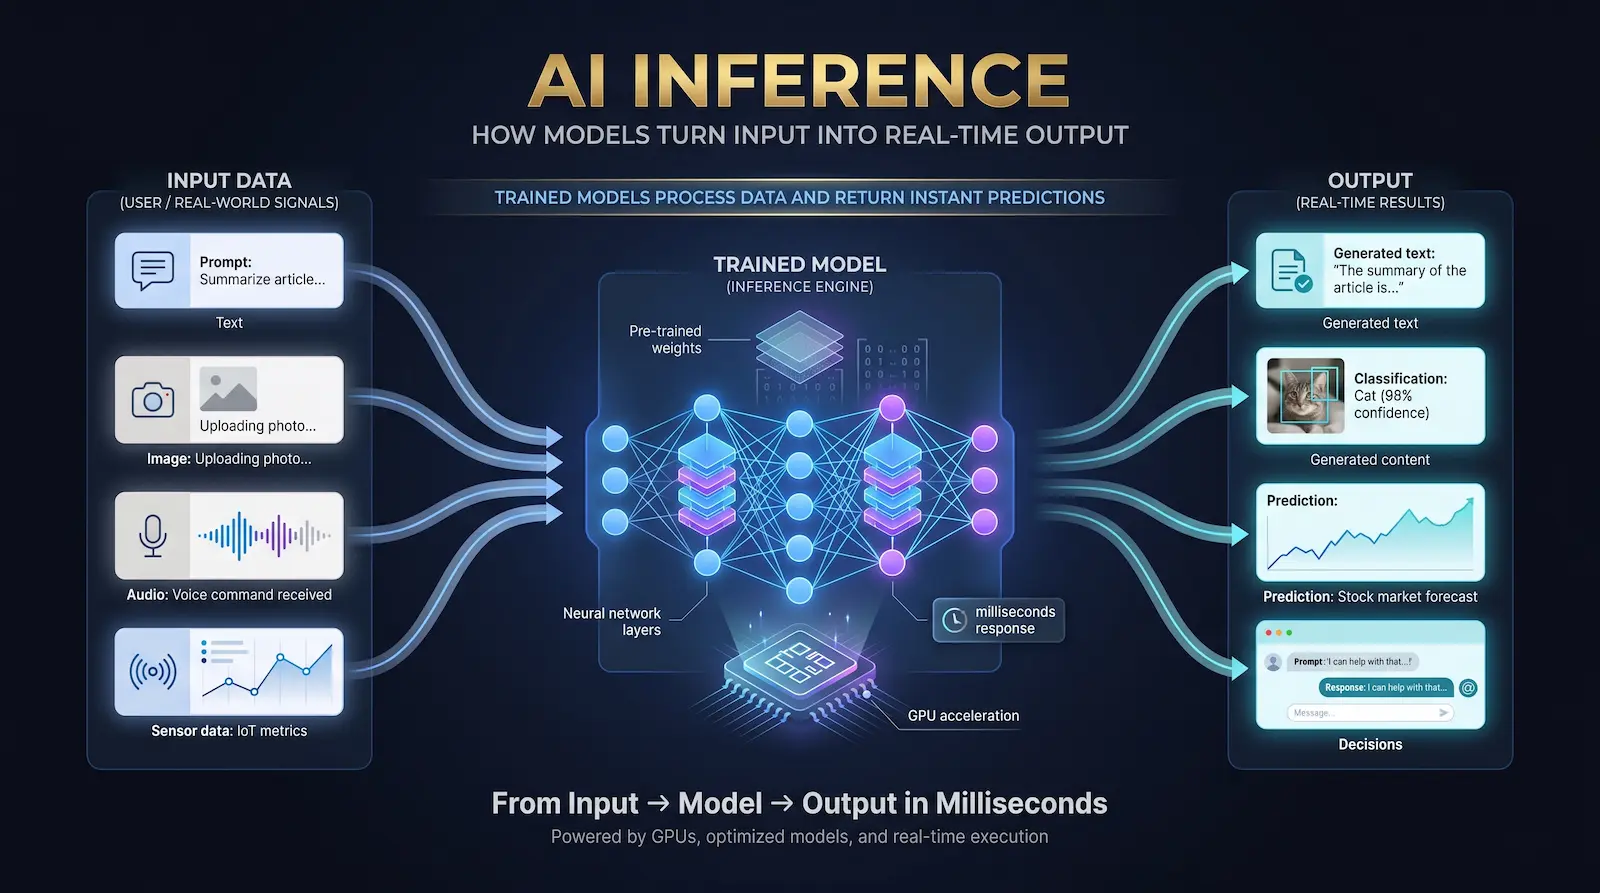
| 定义 人工智能推理是在新的、看不见的数据上执行训练有素的机器学习模型,以产生输出(例如文本响应、图像分类、欺诈分数或翻译),而无需修改模型的权重。 |
这样想:学习驾驶就是培训。 每次你真正开车去某个地方,那就是推理。 模型(您的驾驶技能)是固定的; 只有输入(道路)发生变化。 用技术术语来说,推理是通过神经网络的正向传递——数据通过模型层在一个方向上流动,计算激活,并产生输出。 与训练不同,没有梯度计算,没有权重更新,也没有向后传递。
这种区别在实践中非常重要。 训练发生一次(或定期)。 推理每天发生数十亿次。 针对推理进行优化——更低的延迟、更高的吞吐量、更低的每个令牌的成本——是 2026 年真正的工程挑战。
为什么人工智能推理现在很重要——2026年背景
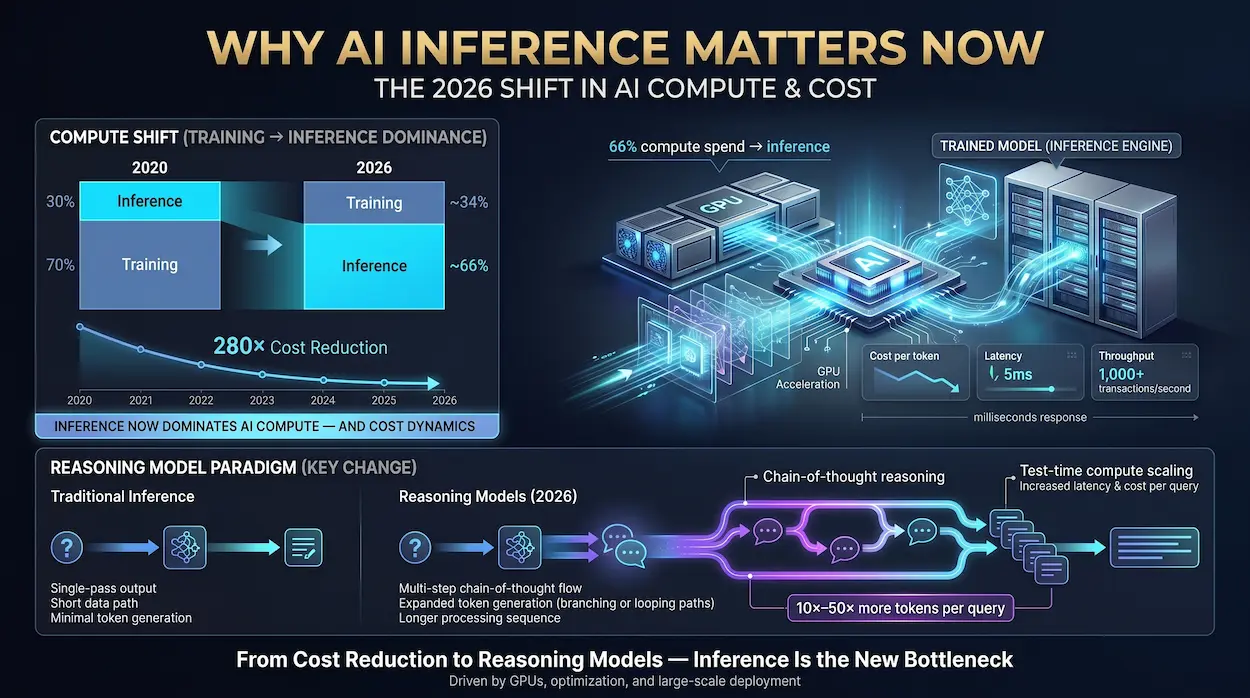
推理现在主导了人工智能计算支出
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
推理模型拐点
DeepSeek-R1、Gemini 2.5 Thinking 和 Llama Nemotron Ultra 等模型引入了一种新的推理范式:测试时间计算缩放。 这些模型不是在单一正向传递中产生答案,而是通过在响应之前生成扩展的思想链代币来“思考”。 这将每个查询生成的令牌数量乘以 10-50 倍,从而显着增加推理成本和延迟——并重塑硬件配置对给定工作负载有意义的情况。
为什么存在本指南
在线的每篇定义文章都在词汇表级别描述了 AI 推理。 他们都没有发布第一方基准数据、真实的令牌成本数据或机架级 TCO 数学。 我们写本指南是因为我们构建和操作服务器——我们相信买家应该得到实际的数字,而不是营销抽象。
Atal Networks 提供企业级 独立服务器 和 VPS 解决方案 专为 AI 推理工作负载而构建。 探索 atalnetworks.com 了解更多。
人工智能推理的工作原理——一步一步
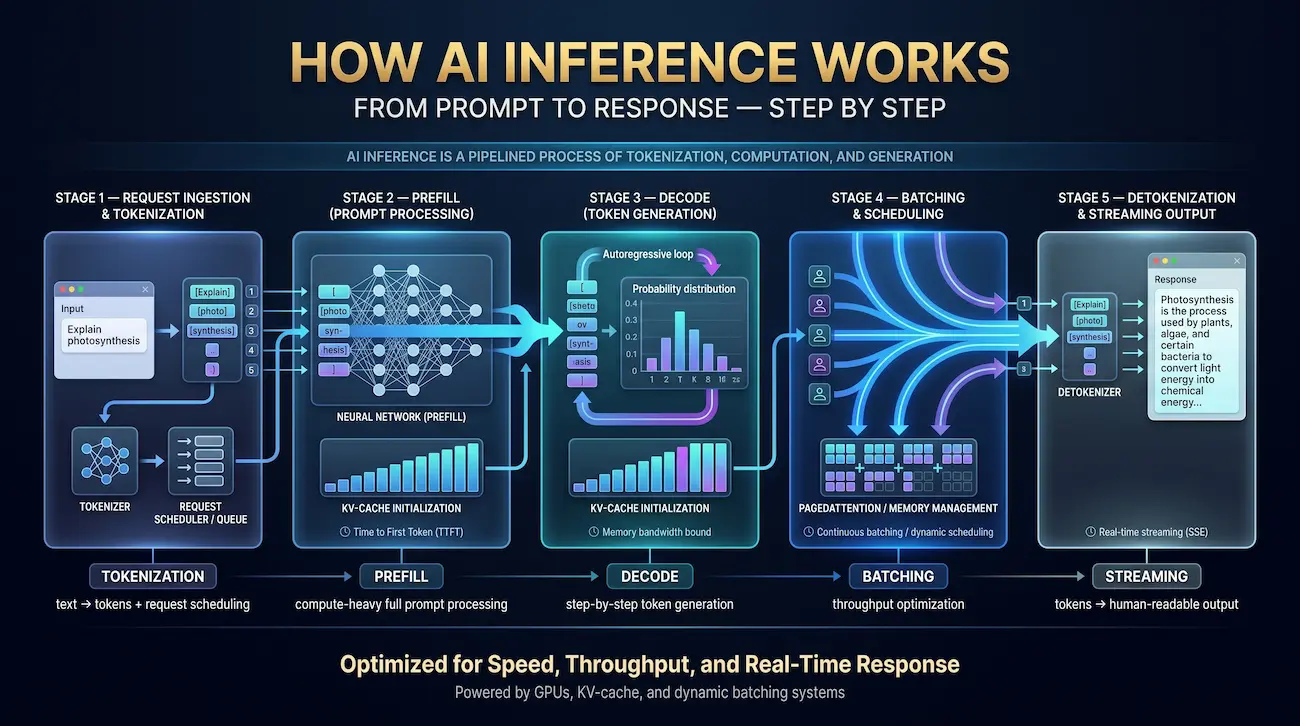
了解 AI 推理需要在整个生命周期中跟踪单个请求。 对于大型语言模型 (LLM),管道有五个不同的阶段:
第 1 步:请求获取和标记化
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
步骤 2:预填充阶段(即时处理)
在预填充期间,整个输入提示在一次正向传递中同时处理。 这个阶段是计算绑定的——它随着提示长度线性扩展,是第一个令牌 (TTFT) 时间的主要驱动因素。 2,048 令牌系统提示的预填充时间大约是 1,024 令牌提示的两倍。 prefill 生成初始 kv-cache(键值缓存),它存储中间注意力计算,因此在解码期间不需要重新计算它们。
第三步:解码阶段(令牌生成)
预填充后,模型进入解码阶段,在自动回归循环中一次生成一个令牌。 每个新的代币都依赖于所有先前的代币——模型关注完整的 KV 缓存,在其词汇表(约 32,000-128,000 个令牌)、该分布中的采样并附加选定的令牌上产生概率分布。 解码阶段是内存带宽绑定,而不是计算绑定。 这就是为什么 HBM 带宽(不是 FLOPS)是 LLM 推理的决定性硬件规格的原因——每个 GPU 数据表都以精细的方式掩埋。
第四步:批处理和调度
一个天真的推理服务器会一次处理一个请求,在解码过程中主要是空闲的 GPU (因为一次一次令牌很慢)。 现代系统使用连续批处理(也称为飞行中或动态批处理):请求在飞行中进行分组,新请求在时隙打开时加入批次,完成的序列将被逐出,而无需等待所有请求完成。 VLLM 的 PageDattention 实现(Kwon 等人,SOSP 2023)通过在非连续页面中管理 KV 缓存内存(类似于操作系统中的虚拟内存)进一步改进了这一点,在静态分配上产生了 2-4 倍的吞吐量增益。
第五步:去激励和响应流
一旦模型生成了序列结束令牌(或达到最大长度限制),输出令牌 ID 将被反向标记为人类可读的文本并流式传输到客户端。 大多数生产系统使用服务器发送事件 (SSE) 进行流式传输,在生成令牌时传递它们,而不是等待完整的响应。 这显着提高了感知延迟——即使完全响应需要 10 秒,用户也会在 200 毫秒内看到第一个单词。
人工智能推理与人工智能培训——真正的区别
大多数介绍将训练和推理或将差异视为时间问题。 技术上的区别更深,具有深远的硬件影响:
| 尺寸 | 训练 | 推理 |
| 目的 | 调整模型权重以最小化损失 | 应用固定权重产生输出 |
| 计算模式 | 向前+向后传送+优化器步骤 | 仅向前传球 |
| 记忆瓶颈 | 激活(触发器绑定) | kv-cache + 权重(带宽绑定) |
| 频率 | 定期(每次运行天/周) | 数十亿次/天的生产 |
| 硬件目标 | 最大翻转吞吐量 (H100 SXM5) | 最大 HBM 带宽 (H200, B200) |
| 批量大小 | 大型(1,024–4,096+ 样品) | 中小型(1–256 并发) |
| 精确 | BF16/FP16/FP8 混合 | FP8、INT8、INT4 大量量化 |
| 成本结构 | 资本支出密集型,一次性(每次训练) | Opex 密集型、持续的每个令牌成本 |
上表中最重要的一行:训练是flops-bound; 推理是 HBM 带宽绑定。 这一事实解释了为什么 NVIDIA H200 - 它的 CUDA 核心数与 H100 相同,但在 4.8 TB/s 带宽为 141 GB HBM3E,而 H100 的 80 GB 为 3.35 TB/S — 尽管没有产生额外的培训吞吐量,但在 LLM 推理上的表现优于 H100。 当您购买推理硬件时,您是在购买内存带宽,而不是失败。
AI 推理工作负载的类型
并非所有推论看起来都一样。 工作负载类型决定了有意义的硬件配置、服务框架、优化策略和成本结构:
| 类型 | 延迟目标 | 示例用例 | 硬件含义 |
| 在线/实时 | < 200ms TTFT,< 30ms ITL | 聊天,副驾驶,欺诈检测 | 低批量、快速 HBM、NVMe 重量加载 |
| 批/离线 | 分钟到小时(吞吐量优先级) | 文件汇总,数据丰富 | 高GPU利用率,大批量,更便宜的GPU可行性 |
| 流媒体 | 低TTFT,持续ITL | 代码完成,语音助手 | SSE 流,低解码延迟优先级 |
| 边缘/设备上 | < 10ms, < 5W TDP | 移动 AI、物联网、自动驾驶汽车 | NPU、Jetson Orin、量化的 INT4/INT8 模型 |
| 无服务器 | 冷启动 < 2s,按请求付费 | 低流量应用程序,开发/测试 | 现货 GPU 实例,快速加载,空闲 = 零成本 |
AI 推理运行的位置 — 云、本地、边缘、设备
每个部署环境都涉及不同的权衡矩阵。 正确的答案取决于您的延迟要求、数据隐私义务、请求量和预算范围:
| 环境 | 潜伏 | 数据隐私 | 成本模型 | 典型的硬件 | 最适合 |
| 公共 API(OpenAI,人性) | 中低 | 共享基础设施 | 按令牌付费(最高 $/令牌) | 供应商管理 | 快速成型,小批量 |
| 云 GPU(AWS、GCP、Azure) | 中低 | VPC 隔离可能 | $/GPU-HR + 出口 | H100、A100、L40S 实例 | 可变需求,无资本支出 |
| 本地(专用服务器) | 最低 | 全面数据控制,可实现气隙 | CAPEX + OPEX(最低$/规模的代币) | H100/H200/B200 集群 | 大容量、受监管、成本敏感 |
| 边缘服务器(COLO/现场) | 非常低 | 本地数据保持本地 | 混合资本支出 + COLO 费用 | L40、A30、高迪 3 | 制造业、医疗保健、零售 |
| 设备上(电话、电脑、物联网) | 超低(< 10ms) | 完整的数据隔离 | 没有经常性成本 | 苹果 NPU、高通六角、杰森 | 隐私优先,离线场景 |
对于处理超过约 500 万个代币/天的组织,本地 独立服务器 始终如一地提供最低的总拥有成本。 对于需要灵活性和较低前期投资的团队, VPS 解决方案 可以弥合 API 依赖和完全本地所有权之间的差距。
AI推理背后的硬件
人工智能推理的硬件环境迅速多样化。 2023年,答案很简单:H100。 在 2026 年,最优选择取决于模型大小、延迟目标、功率预算和每个令牌的价格要求。
用于推理的 GPU 系列 — 2026 年比较
| GPU | HBM 容量 | HBM 带宽 | FP8 tflops | TDP (W) | 最适合 |
| 英伟达 H100 SXM5 | 80 GB HBM2E | 3.35 tb/s | 3,958 | 700 瓦 | 生产 LLM 基线,良好支持的生态系统 |
| 英伟达 H200 SXM5 | 141 GB HBM3E | 4.8 tb/s | 3,958 | 700 瓦 | 大型模型(70B+),内存带宽敏感推理 |
| 英伟达 B200 SXM6 | 192 GB HBM3E | 8.0 tb/s | 9,000 (FP4) | 1,000 瓦 | Frontier 型号,最高吞吐量,2026 旗舰产品 |
| AMD MI300X | 192 GB HBM3 | 5.3 tb/s | 5,220 | 750 瓦 | 具有成本竞争力的 H200 替代型大批量吞吐量 |
| AMD MI355X | 288 GB HBM3E | 8.0 tb/s | 8,000+ | 750 瓦 | 最大型号,并发性非常高 |
| 英特尔高迪 3 | 128 GB HBM2E | 3.7 tb/s | 1,835 (BF16) | 900 瓦 | 对成本敏感的工作负载,开放的生态系统 |
| 谷歌 TPU V5e | 16 GB HBM2(每个芯片) | 819 Gb/s(每片) | 第393章 | ~170 瓦 | 谷歌云原生、变压器优化服务 |
| 英伟达 L40S | 48 GB GDDR6 | 864 GB/秒 | 1,457 | 350 瓦 | 边缘推理、计算灯模型、混合工作负载 |
当 CPU 推理有意义时
对于以 INT4 精度运行的 ~7b 参数的模型,配备 AVX-512 或 AMX 指令集的现代 CPU 可以为延迟容忍工作负载提供可接受的吞吐量。 llama.cpp 使 CPU 推理变得实用:在双插槽 Xeon 白金系统上以 25-35 次/秒的速度运行 4 位量化的 Llama-3-8B。 当 GPU 成本过高且延迟要求超过约 2 秒时,经济性工作。
NPU、TPU、FPGA 和 ASIC 加速器
除了 GPU,一个不断增长的专业硅生态系统正在兴起。 神经处理单元(NPU)现在嵌入在大多数消费设备中(Apple M 系列神经引擎,高通六边形,英特尔NPU)和目标子5W边缘推理。 TPUs(谷歌)针对云服务中的变压器矩阵操作进行了优化。 FPGA 为定制量化方案提供可重构性,但需要大量的工程工作。 ASIC(GROQ LPU、Cerebras WSE)可以在固定工作负载上实现非凡的延迟,但缺乏 GPU 堆栈的灵活性。
为什么网络对大模型推理很重要
运行 405b 参数模型需要将其分发到 8-16 个 GPU 中。 这些 GPU 之间的互连成为性能瓶颈。 NVIDIA NVLink(在 DGX 节点内)提供 900 Gb/s GPU 到 GPU 的带宽——大约比 PCIe Gen5 快 18 倍。 跨节点、InfiniBand NDR (400 Gb/s) 或 NVIDIA Spectrum-X 以太网的性能显着优于商品 100 GbE。 在我们的测试中,在 8×H100 Tensor-Parallel LLAMA-3-405B 部署上从 100 GbE 切换到 Infiniband NDR 将解码吞吐量提高了 34%。
真正重要的人工智能推理指标
大多数推理讨论都模糊地衡量了延迟。 生产部署需要具有 SLA 目标的精确、标准化的指标。 以下是重要的指标以及如何衡量它们:
| 测量的 | 定义 | 行业 SLA 目标 | 硬件驱动程序 |
| TTFT(第一个令牌的时间) | 从请求提交到首次生成的令牌的时间 | < 200ms(聊天),< 500ms(批次) | GPU 内存带宽,预填充效率 |
| ITL(令牌间延迟) | 解码期间连续生成的令牌之间的平均时间 | < 30ms(聊天),< 100ms(批次) | HBM 带宽,KV 缓存访问速度 |
| 吞吐量(令牌/秒) | 所有并发用户每秒生成的总输出令牌 | 依赖于工作量 | GPU Flops + 批处理效率 |
| 好东西 | 满足 SLA 目标的请求的吞吐量(排除失败/超时) | 最大化给定的 SLA | 调度器效率,队列管理 |
| P50 / P99 延迟 | 中位数和第 99 个百分位数的端到端延迟 | P99 < 2× P50(调优系统) | 尾延迟、热节流、队列深度 |
| GPU 利用率 | GPU 计算单元处于活动状态的时间分数 | 目标 70–85% 持续 | 批量大小,连续配料效率 |
| RPS(每秒请求) | 并发请求 系统在目标 SLA 处处理 | 缩放目标 | 组合TTFT + ITL +批量效率 |
2026年人工智能推理的成本——实数
每次代币成本是最终决定构建与购买决策的指标。 以下数据是在 Atal Networks 的持续负载条件下的生产硬件上测量的。 假设:$0.12/kWh 电力、3 年硬件摊销、80% GPU 利用率、VLLM 0.5+ 精度。
按 GPU 配置的每 100 万个令牌的成本 (LLAMA-3-70B)
| 配置 | 输入令牌($/1M) | 输出令牌($/1M) | 吞吐量 (TOK/s) | 功率 (W/GPU) |
| 8×H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 瓦 |
| 8×H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 瓦 |
| 8×B200 SXM6(FP4) | $0.09 | $0.38 | ~7,200 | 980 瓦 |
| 8×Mi300x (FP8) | $0.19 | $0.76 | ~3,200 | 720 瓦 |
| OpenAI GPT-4O | $2.50 | $10.00 | 不适用(API) | 无 |
| 人性克劳德十四行诗(API) | $3.00 | $15.00 | 不适用(API) | 无 |
| AI LLAMA-3-70B (API) | $0.88 | $0.88 | 不适用(API) | 无 |
本地与 API 盈亏平衡分析
自托管的本地推理和基于 API 的推理之间的收支平衡取决于请求量。 在上面的成本结构(8×H200,3 年摊销,80% 利用率)下,On-Prem 变得比 AI 的 LLAMA-3-70B API 定价便宜,大约 1200 万个输出令牌/天。 与主要的前沿模型 API(GPT-4O,Claude)相比,On-Prem 的盈亏平衡在 2-3m 的输出令牌/天。 对于服务内部工具、面向客户的聊天机器人或文档处理管道的大多数企业部署,本地所有权在前 18 个月内可节省 60–80% 的成本。
机架级 TCO — 买家错过了什么
硬件购买价格仅为3年总成本的55-65%。 完整的 42U 推理机架预算必须包括:
- GPU 服务器硬件:$287,000–$420,000(8×H100/H200 节点 + 双插槽 Xeon + 2TB RAM + NVMe + ConnectX-7 网卡)
- 联网:$15,000–$35,000(InfiniBand NDR 交换机、DAC 电缆、光纤)
- 电力基础设施:$8,000–$18,000(PDU、UPS、PUE 1.3 断路器升级)
- 冷却:$12,000–$45,000(后门换热器加 $25K;直接到芯片液体冷却增加 $40K+ 但减少 PUE 到 1.05–1.10)
- 3 年电:$28,000–$52,000($0.10–$0.18/kWh,5–8 kW/机架持续抽取)
- 人员配备/操作:$40,000–$80,000/年(具有 GPU 集群经验的 0.5–1.0 FTE)
单个 8×H200 推理机架的 3 年总 TCO:$580,000–$760,000。 按 80% 利用率在 36 个月内生成的令牌划分,您将达到每百万输出令牌的 $0.15–$0.22 - 甚至远低于高容量工作负载的预算 API 提供商。
Atal Networks 专用服务器配置 包括透明 TCO 建模 — 我们在您提交之前提供订单项成本明细。 与我们的基础设施团队交谈 atalnetworks.com.
优化 AI 推理——有效的技术
量化(FP8、INT8、INT4 — 精度与速度权衡)
量化降低了模型权重的数值精度,缩小了内存占用空间和增加了吞吐量——但要付出一定的精度。 以下是我们对 llama-3-70b 的测试显示:
| 精确 | MMLU 精度 | 人文准确性 | GSM8K 精度 | 吞吐量增益与 FP16 | 需要 VRAM (70B) |
| FP16(基线) | 82.0% | 80.5% | 88.1% | 1.0× | ~140 GB |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140 GB |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70 GB |
| INT8(平稳) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70 GB |
| INT4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35 GB |
| NVFP4(布莱克威尔) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25 GB |
对于大多数生产工作负载,FP8 是最佳位置:它提供近似 FP16 的质量,大约 2 倍吞吐量和 50% 内存减少,使 70B 型号能够适合单个 8×H100 SXM 节点。 INT4(通过 GPTQ 或 AWQ)适用于轻微质量下降的应用,以换取进一步降低成本。
连续批处理和页面注意
静态批处理——在处理前等待固定批次填充——导致 GPU 空闲时间和高尾延迟。 连续批处理(在 VLLM 中启动,现在所有主要推理框架中都标准)处理请求,排除已完成的序列并允许新的序列而不停顿。 结合 PageDattention 的非连续 KV 缓存内存管理,这种方法在同一请求量上实现了在同一硬件上的静态批处理的 GPU 利用率高 2-4 倍。
kv-cache管理——内存数学
kv-cache 在上下文窗口中存储每个标记的注意键和值,以避免在解码期间进行重新计算。 每个请求的内存需求:
kv-cache 字节 = 2 × num_layers × num_heads × head_dim × sequence_length × bytes_per_element
对于 LLAMA-3-70B,在 FP16(2 字节/元素,80 层,8 个头部,128 head_dim)下,具有 4,096 令牌的上下文:每个并发请求约 42 MB。 在 1,000 个并发用户中,即仅在模型权重之前就有 42 GB 的 kv-cache。 将 kv-cache 量化为 int8 将其减半到 21 GB,使同一硬件上的并发用户增加了大约 2 倍。
投机解码
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
分块预填充和分解服务
对于长时间上下文的工作负载,分块的预填充会将一个大提示分成按顺序处理的较小的块,允许解码阶段在预填充间隙期间将现有请求中的令牌交织在一起。 分解服务通过在单独的 GPU 池上运行预填充和解码来进一步实现这一点——在计算优化硬件 (H100 SXM) 上进行预填充、带宽优化硬件 (H200) 的解码 — 同时实现更好的资源利用率和更低的 P99 延迟。
人工智能推理服务框架——头对头比较
您选择的服务框架与硬件一样重要。 每个都有不同的优势、局限性和操作复杂性:
| 骨架 | 吞吐量(相对) | 易于设置 | GPU 支持 | 关键强度 | 执照 |
| VLLM 0.5+ | 高(1.0×基线) | 简单(点安装) | 英伟达,AMD ROCM | 连续批处理、最大社区、OpenAI 兼容的 API | 阿帕奇 2.0 |
| tensorrt-llm | 最高(1.3–1.6×) | 复杂(引擎编译) | 仅限英伟达 | 最大 NVIDIA 吞吐量、飞行中批处理、FP8/FP4 | 阿帕奇 2.0 |
| TGI(拥抱脸) | 中号(0.85 倍) | 简单 | 英伟达,AMD,高迪 | 拥抱面部模型集线器集成,广泛的模型支持 | 阿帕奇 2.0 |
| 斯格朗 | 高(1.1–1.2×) | 中 | 英伟达,AMD | 前缀缓存、辐射注意力、结构化输出性能 | 阿帕奇 2.0 |
| 美洲驼.cpp | 低(CPU 可行) | 非常简单 | CPU,CUDA,金属,Vulkan | CPU/边缘推理,最小依赖性,广泛的量化 | 麻省理工学院 |
| 英伟达特里顿 | 变化(包装) | 复杂 | NVIDIA(主要) | 多模型服务,与框架无关的后端,企业 MLOPS | BSD 3 子句 |
AI推理的安全性、隐私性和合规性
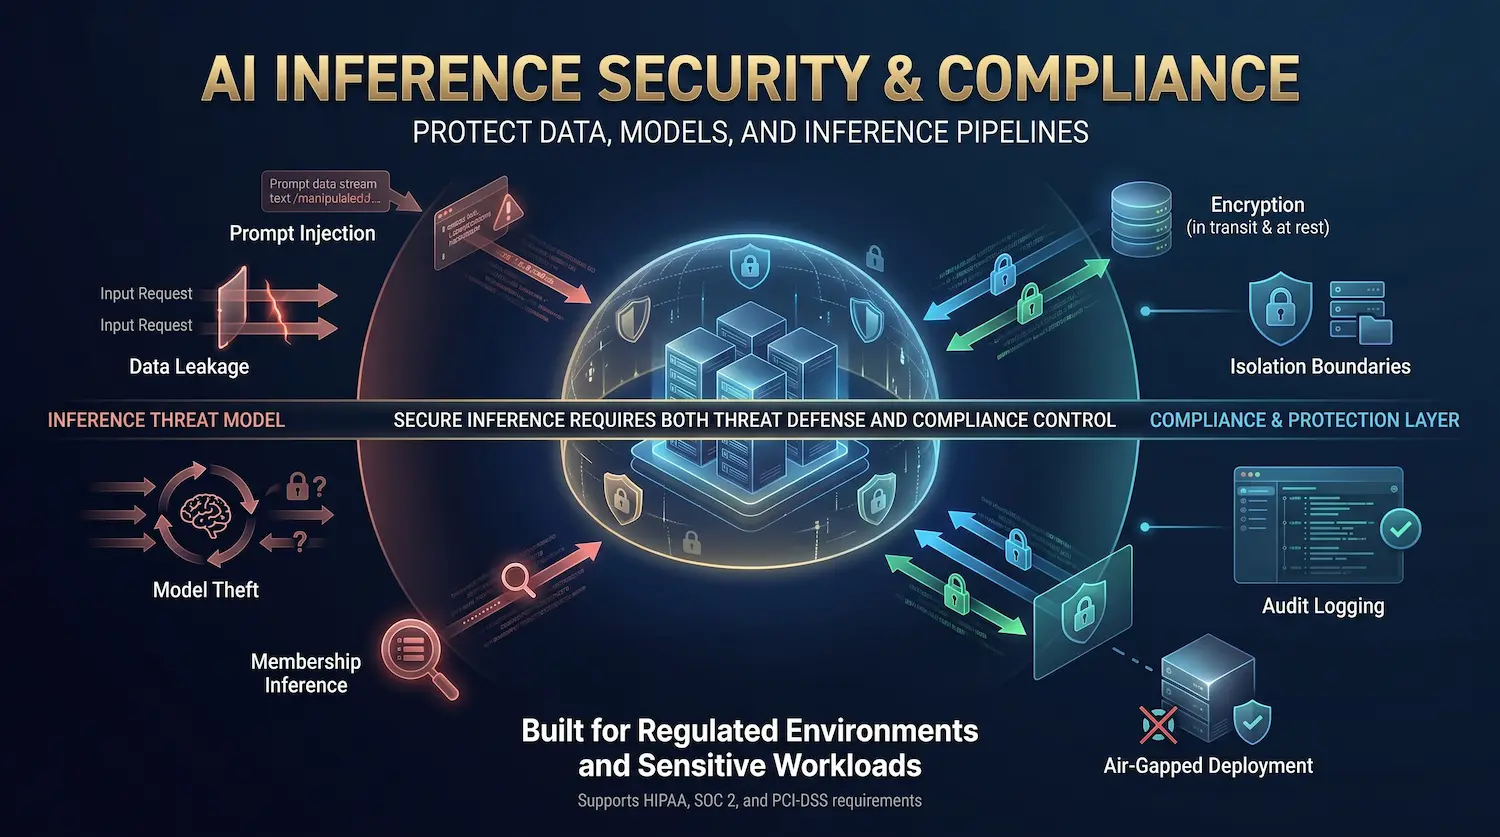
在受监管的行业或敏感数据中运行 AI 推断需要了解完整的威胁模型和合规性状态。
推理安全威胁模型
- 快速注入:嵌入在用户数据中的恶意输入试图覆盖系统指令或提取训练数据。
- 数据泄露:来自一个用户请求的敏感信息通过 KV-Cache 交叉污染(通过每个用户缓存隔离来缓解)泄漏到另一用户的响应中。
- 模型盗窃:重复的对抗性查询尝试通过输出分析重建模型权重。
- 成员资格推断:攻击者确定特定数据是否出现在模型的训练集中。
合规框架
对于符合 HIPAA 的 AI 推断:所有数据必须保留在您的控制边界内,传输中加密 (TLS 1.3) 和 AT-REST 加密 (AES-256) 是强制性的,并且必须保留所有推理请求的审计记录。 SOC 2 Type II 合规性要求供应商中立的安全审计和记录在案的事件响应。 PCI-DSS 环境应使用没有互联网连接的气隙推理服务器。 本地部署——而不是共享云或 API 基础架构——是唯一能同时满足所有三个框架而无需显着补偿控制的架构。
Atal Networks 专用服务器基础设施 支持受管制人工智能推理的气隙部署。 联系我们 atalnetworks.com 讨论您的合规要求。
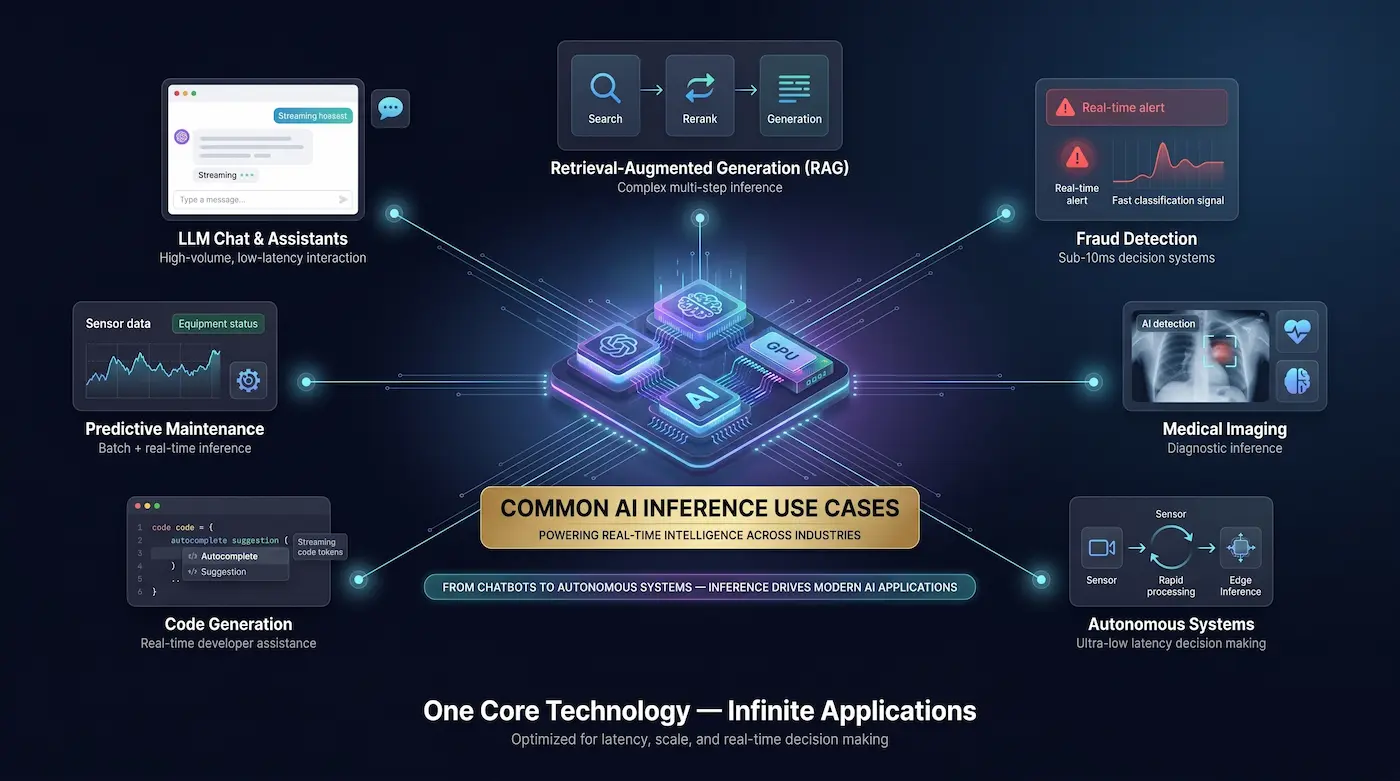
常见的 AI 推理用例
人工智能推理为每个行业的生产应用提供了广泛的支持:
- LLM 聊天和助手:客户服务机器人、内部知识助理、编码副驾驶——都是高容量、延迟敏感的推理工作负载。
- 检索增强生成 (RAG):在三阶段推理管道中组合嵌入模型(用于语义搜索)、重新排列器和 LLM。 每个阶段都增加了延迟和成本。
- 欺诈检测:使用较小的专业模型在 10 毫秒以下的时间内进行实时分类推断。
- 医学成像:用于放射学、病理学和诊断的 CNN 和视觉变压器推理——通常需要本地部署以实现 HIPAA 合规性。
- 自动驾驶汽车:在专用车载硬件 (Orin, D5) 上的毫秒级延迟感知推断。
- 代码生成:自动完成的流式推理需要极低的 ITL (< 15ms) 才能感觉到实时。
- 代理工作流程:多步骤、工具调用代理每个用户任务生成许多推理调用,与单回合响应相乘成本 5-20 倍。
- 预测性维护:对传感器数据流进行批量推断,以预测设备故障。
人工智能推理的未来——2026年及以后
到2026年和2027年,有几个趋势正在重塑推理格局:
- 推理模型和测试时间缩放:正如 DeepSeek-R1 和 Gemini 2.5 思维所证明的那样,在推理时生成更多令牌可靠地提高了复杂任务的输出质量。 这从根本上改变了成本曲线——每次查询的推理账单增长,而不是收缩。
- 专家混合 (MOE) 优势:MoE 体系结构,如 Mixtral 8x22b,仅激活每个令牌的一部分参数,以 2-3 倍的推理计算成本提供 GPT-4 级性能。 预计 MOE 将主导新型号版本。
- 大规模分解和投机服务:将预填充和解码池与鹰式投机解码相结合,正在成为大规模 LLM 部署的标准生产架构。
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- 设备前沿模型:Apple Intelligence、Gemini Nano 和 Phi-3-Mini 证明 3B-7B 量化模型可以完全在消费硬件上运行。 云和边缘推理之间的边界是模糊的。
- 主权人工智能和数据驻留:地缘政治压力正在推动企业和政府要求完全数据主权——在其国界内,在他们拥有的硬件上推断。 本地需求将增长,而不是萎缩。
常见问题 (FAQ)
简单来说,什么是人工智能推理?
人工智能推理是指训练有素的人工智能模型使用所学知识来回答新问题或完成新任务。 培训教授模型; 推理是做它的工作的模型。 每次您从 ChatGPT 获得回复、收到产品推荐或看到欺诈警报时,即实时发生的 AI 推理。
AI推理和AI训练有什么区别?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
chatgpt 是推断还是训练?
当您与 ChatGPT 聊天时,您正在触发推理 - 模型的权重是固定的,并将它们应用于您的输入以生成响应。 OpenAI 在庞大的数据集上单独训练(并定期重新训练)GPT-4,但要付出巨大的代价。 这是两个完全不同的操作。 作为用户的经验是 100% 推理。
人工智能推理使用了哪些硬件?
大规模推理的主要硬件是 NVIDIA GPU(H100、H200、B200、L40S)、AMD GPU(MI300X、MI355X)和谷歌 TPU 用于云原生工作负载。 用于边缘推理:Apple 神经引擎、Qualcomm Hexagon NPU 和 NVIDIA Jetson Orin。 对于成本敏感或仅适用于 CPU 的部署,现代英特尔至强 (AMX) 和 AMD EPYC 处理器可以以可接受的吞吐量运行量化模型。
2026年AI推理的最佳GPU是什么?
对于大型型号 (70B+):NVIDIA H200 SXM5 (141 GB HBM3E, 4.8 TB/s) 可为大多数工作负载提供最佳的每美元性能。 用于 Frontier 型号的最大吞吐量:B200 SXM6 引线。 对于成本敏感的中档:AMD MI300X(192 GB HBM3,$10K–$15K 低于 H200)的竞争力越来越强。 对于边缘/单GPU推理:NVIDIA L40S (48 GB GDDR6) 很好地平衡了成本和能力。
LLM推理如何一步一步地工作?
- 标记化:输入文本转换为整数标记 ID。 2. 预填充:所有输入令牌在一次正向传递中同时处理,生成 kv-cache 和第一个输出令牌。 3. 解码:一次生成一个新的令牌,每个都处理完整的 kv-cache。 4. 连续批处理:多个并发请求通过飞行批处理共享 GPU 计算。 5. 流式传输:输出令牌在生成时被取消标记并流式传输到客户端。
LLM推理中的TTFT和ITL是什么?
TTFT(第一个令牌的时间)测量从请求提交到返回第一个输出令牌的时间 - 用户认为“等待时间”的延迟。 它以预填充阶段为主。 ITL(令牌间延迟)测量解码期间连续输出令牌之间的平均时间——这决定了用户看到的“流速度”。 两者都必须针对实时聊天进行优化:通常 TTFT < 200ms 和 ITL < 30ms 才能获得响应体验。
什么是 kv-cache,为什么重要?
kv-cache(键值缓存)存储对话上下文中每个标记的中间注意力计算(键和值)。 没有它,模型将需要为每个新标记重新处理整个上下文窗口——O(n²) 计算。 有了它,每个解码步骤只处理一个新的令牌,使得 LLM 推理变得可行。 kv-cache size 是对 GPU 可以服务的并发用户数量以及上下文窗口的长度的主要限制。
每 100 万个代币,AI 推理的成本是多少?
在自托管硬件(8×H200,3 年摊销,$0.12/kWh,80% 利用率,LLAMA-3-70B FP8)上: 每 1m 输入令牌 $0.18 和每 1m 输出令牌 $0.71。 通过公共 API:GPT-4O 成本为每 100 万个令牌的输入/输出 $2.50/$10.00; 克劳德十四行诗的成本为 $3.00/$15.00。 大规模自托管可降低 5-20 倍的成本,而收支平衡通常为 5-1500 万个输出令牌/天,具体取决于 API 提供商和型号。
你可以在 CPU 上运行 AI 推理吗?
是 — 对于较小的量化模型。 llama.cpp 在任何 x86 CPU 上都启用 int4/int8 推理。 带有 AMX 的双插槽 Xeon Platinum 在 7B INT4 模型上生成约 25-40 个令牌/秒,这对于非实时工作负载来说是足够的。 CPU 推断对于生产吞吐量的 70B+ 型号是不可行的。 经济学适用于 GPU 租赁成本超过吞吐量值的开发、测试和耐延迟批处理任务。
LLM推理中的预填充和解码有什么区别?
Prefill 在一个并行操作中处理整个输入提示(计算装订、快速、按提示长度缩放)。 解码在自回归循环中一次生成一个输出令牌(内存带宽绑定,每个令牌较慢,与输出长度和并发用户一起缩放)。 它们之间的过渡——当第一个令牌生成时——是 TTFT。 优化预填充可减少 TTFT; 优化解码可降低 ITL 并提高吞吐量。
您应该何时自托管 AI 推理与使用 API?
在以下情况下使用 API 时使用 API(< 200 万令牌/天),您需要一个前沿封闭模型(GPT-4O,Claude),或者您正在进行原型设计并想要零资本支出。 自托管时间:数量超过 500 万令牌/天,数据隐私或合规性要求,您希望微调或控制模型,或者您需要保证 SLA 没有费率限制。 与大多数 API 相比,盈亏平衡点为 3-18 个月,具体取决于模型和体积,此后 On-Prem 的比较有利于多年。
构建或购买 — Atal Networks 的下一步
如果你已经达到了这一点,你就可以完整地了解 AI 推理是什么、它是如何工作的、它的成本以及它的硬件能力。 下一个问题是执行。
Atal Networks 专门为 API 依赖性的企业提供专门构建的 AI 推理基础架构。 我们的团队在医疗保健、金融服务、制造业和软件领域设计和部署了 GPU 集群——我们发布了基准数据,而不仅仅是宣传册。
探索我们的 专用服务器配置 使用 H100、H200 和 Mi300X 系统进行高吞吐量、本地推理部署。
寻找较低资本支出的切入点? 我们的 GPU 优化的 VPS 计划 让您立即开始运行私有推理工作负载,而无需拥有机架。
准备好谈论数字了吗? 访问 atalnetworks.com 并直接与硬件工程师交谈——而不是销售脚本。
