 Zum Inhalt springen



Von Principal Hardware Engineer, Atal Networks | MLPerf V4.1 Contributor | 12 Jahre GPU-Cluster-Architektur | Aktualisiert: 19. April 2026
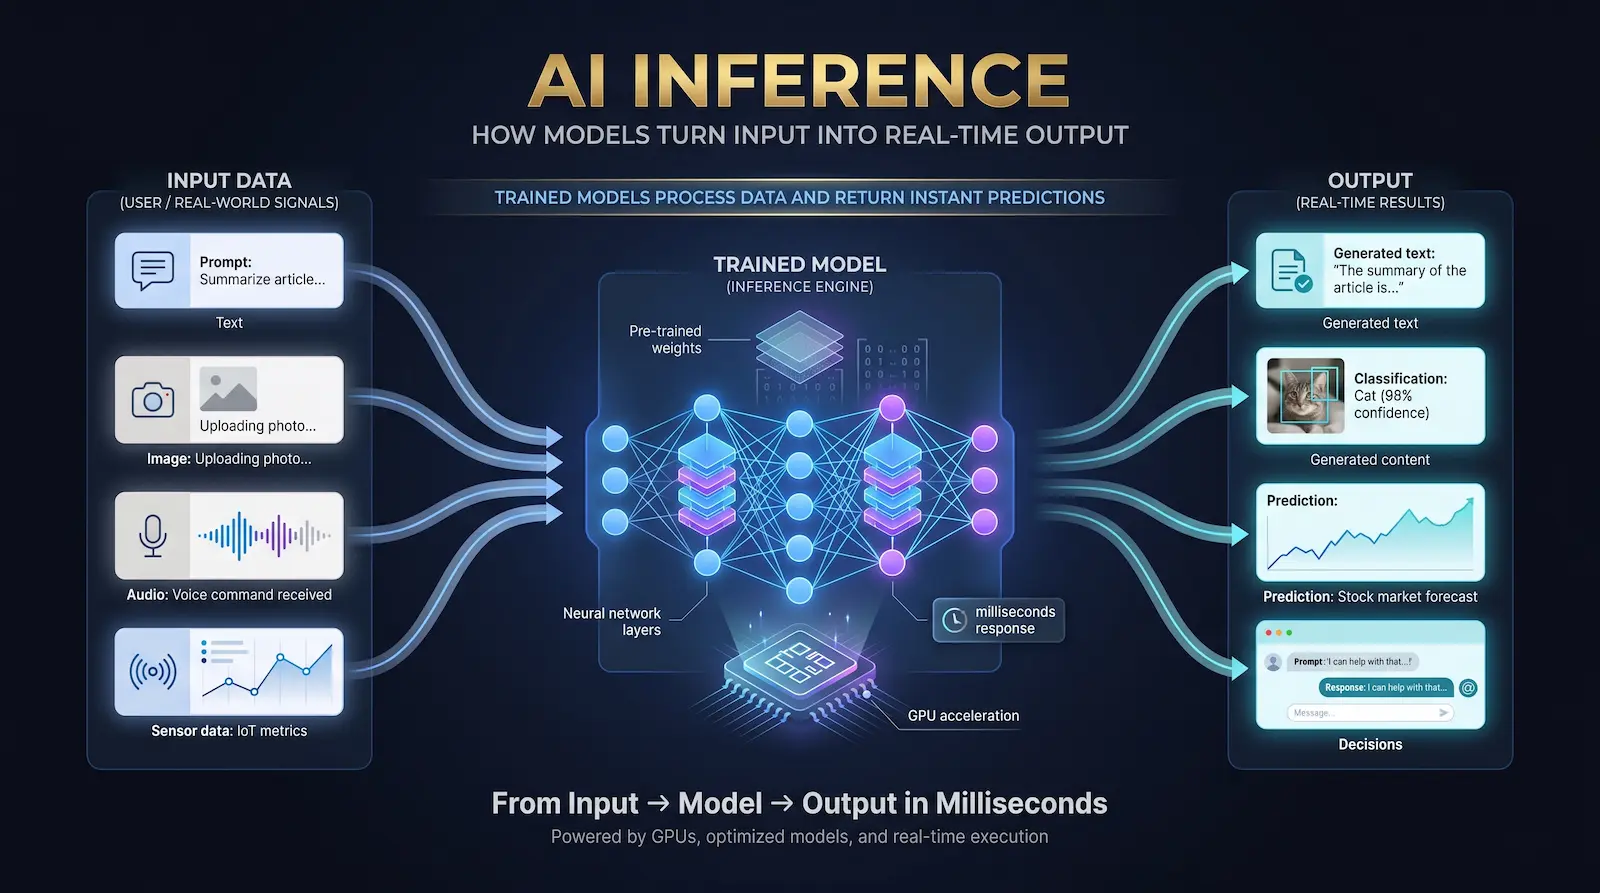
| TL; DR - Was ist KI-Inferenz? KI-Inferenz ist der Prozess des Ausführens eines trainierten KI-Modells für neue Eingabedaten, um eine Vorhersage, Klassifizierung oder generierte Ausgabe zu erzeugen. Es ist die Phase der KI - jede Chatgpt-Antwort, Betrugswarnung, Bildunterschrift und jeder selbstfahrende Wahrnehmungsaufruf ist ein Inferenzereignis. Im Jahr 2026 verbraucht die Inferenz ungefähr zwei Drittel der gesamten KI-Rechenausgaben weltweit. Dieser Leitfaden behandelt die vollständige Pipeline, die Hardware, die sie misst, die Metriken, die sie messen (TTFT, ITL, Tokens / Sek.) und deren Ausführung - mit Benchmarks, die auf eigenen Atal Networks-Servern gemessen werden. |
Was ist KI-Inferenz? Die Ein-Satz-Definition
| Definition KI-Inferenz ist die Ausführung eines trainierten maschinellen Lernmodells für neue, unsichtbare Daten, um eine Ausgabe - wie Textantwort, Bildklassifizierung, Betrugsbewertung oder Übersetzung - zu erzeugen, ohne die Gewichte des Modells zu ändern. |
Stellen Sie sich das so vor: Fahren lernen ist Training. Jedes Mal, wenn Sie tatsächlich irgendwohin fahren, ist das Inferenz. Das Modell (Ihre Fahrkünste) ist fest; Nur die Eingabe (die Straße) ändert sich. Technisch gesehen ist Inferenz ein Durchlauf durch das neuronale Netzwerk - Datenflüsse in einer Richtung durch die Schichten des Modells, Aktivierungen werden berechnet und eine Ausgabe erzeugt. Im Gegensatz zum Training gibt es keine Gradientenberechnungen, keine Gewichtsaktualisierungen und keinen Rückwärtsgang.
Die Unterscheidung ist in der Praxis enorm wichtig. Das Training findet einmalig (oder periodisch) statt. Die Inferenz geschieht milliardenfache Male pro Tag. Bei der Optimierung für Inferenz - geringere Latenz, höherer Durchsatz, niedrigere Kosten pro Token - lebt die echte Engineering Challenge im Jahr 2026.
Warum KI-Inferenz jetzt wichtig ist - der Kontext 2026
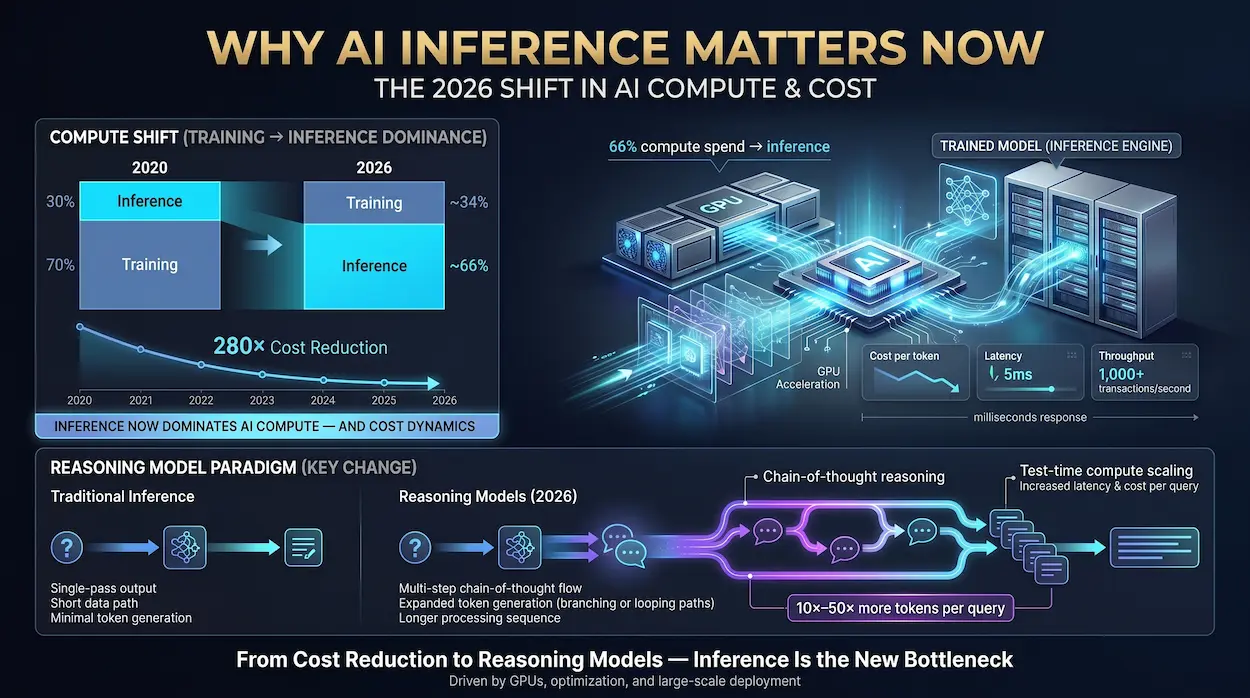
Inferenz dominiert jetzt die KI-Compute-Ausgaben
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
Der Wendepunkt des Argumentationsmodells
Modelle wie DeepSeek-R1, Gemini 2.5 Thinking und Lama Nemotron Ultra haben ein neues Inferenzparadigma eingeführt: die Testzeit-Computer-Skalierung. Anstatt eine Antwort in einem einzigen Durchlauf zu erzeugen, „denken“ diese Modelle, indem sie erweiterte Gedankenketten-Token generieren, bevor sie antworten. Dies multipliziert die Anzahl der pro Abfrage generierten Token mit 10–50 ×, erhöht die Inferenzkosten und die Latenz erheblich - und verändert die Hardwarekonfiguration für eine bestimmte Arbeitslast.
Warum dieser Leitfaden existiert
Jeder Definitionsartikel online beschreibt KI-Inferenz auf Glossarebene. Keiner von ihnen veröffentlicht Benchmark-Daten von Erstanbietern, echte Cost-per-Token-Zahlen oder TCO-Mathematik auf Rack-Ebene. Wir haben diesen Leitfaden geschrieben, weil wir die Server bauen und betreiben - und wir glauben, dass die Käufer tatsächliche Zahlen verdienen und nicht die Marketing-Abstraktionen.
Atal Networks bietet Enterprise-Klasse dedizierte Server und VPS-Lösungen Speziell für KI-Inferenz-Workloads erstellt. Erkunden atalnetworks.de um mehr zu lernen.
Wie KI-Inferenz funktioniert – Schritt für Schritt
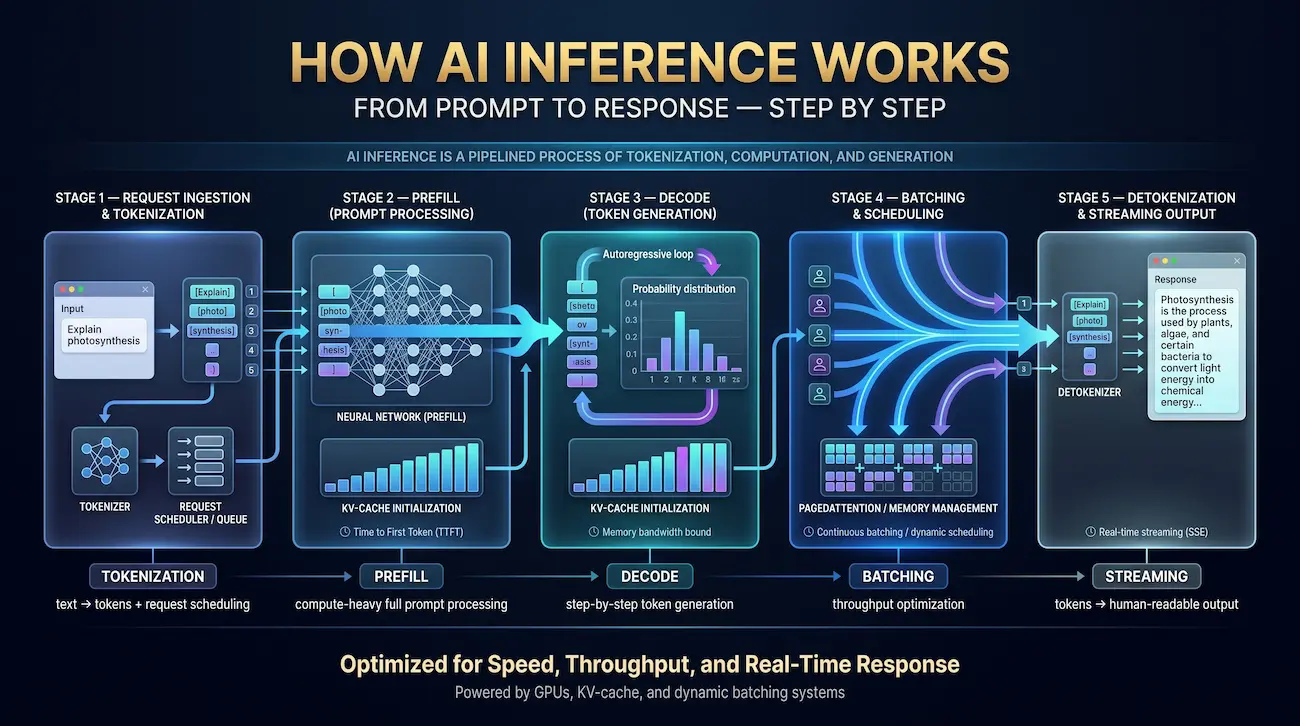
Das Verständnis der KI-Inferenz erfordert das Nachzeichnen einer einzelnen Anfrage über ihren gesamten Lebenszyklus. Für ein großes Sprachmodell (LLM) hat die Pipeline fünf verschiedene Stufen:
Schritt 1: Aufnahme und Tokenisierung anfordern
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
Schritt 2: Die Vorbefüllstufe (Eingabeaufbereitung)
Während des Prefills wird die gesamte Eingabeaufforderung gleichzeitig in einem einzigen Durchlauf verarbeitet. Diese Stufe ist rechengebunden - sie wird linear mit der Eingabeaufforderung skaliert und ist der Haupttreiber der Zeit bis zum ersten Token (TTFT). Eine 2.048-Token-System-Eingabeaufforderung dauert ungefähr doppelt so lange wie eine 1.024-Token-Eingabeaufforderung. Prefill generiert den anfänglichen KV-Cache (Schlüsselwert-Cache), der die Zwischenaufmerksamkeitsberechnungen speichert, damit sie während der Dekodierung nicht neu berechnet werden müssen.
Schritt 3: Die Dekodierungsstufe (Tokengenerierung)
Nach dem Vorfüllen tritt das Modell in die Dekodierungsstufe ein und generiert jeweils einen Token in einer autoregressiven Schleife. Jedes neue Token hängt von allen vorhergehenden Token ab – das Modell nimmt den vollständigen KV-Cache auf, erzeugt eine Wahrscheinlichkeitsverteilung über seinen Wortschatz (~32.000–128.000 Token), Proben aus dieser Verteilung und fügt den ausgewählten Token an. Die Dekodierungsstufe ist speicherbandbreitengebunden, nicht rechnergebunden. Aus diesem Grund ist die HBM-Bandbreite (nicht Flops) die entscheidende Hardware-Spezifikation für LLM-Inferenz - eine Tatsache, die jedes GPU-Datenblatt im Kleingedruckten begräbt.
Schritt 4: Batching und Planung
Ein naiver Inferenzserver würde jeweils eine Anforderung verarbeiten, wobei die GPU während der Dekodierung größtenteils im Leerlauf bleibt (da ein Token-zu-Zeit-Zeitpunkt langsam ist). Moderne Systeme verwenden kontinuierliche Batching (auch während des Flugs oder dynamische Batching genannt): Anfragen werden in der Mitte des Fluges gruppiert, neue Anfragen fügen sich dem Batch bei, wenn die Slots geöffnet sind, und abgeschlossene Sequenzen werden ohne Wartezeit auf alle Anfragen gestrichen. Die PageDattention-Implementierung von VLLM (KWON et al., SSP 2023) verbessert dies durch die Verwaltung des KV-Cache-Speichers in nicht zusammenhängenden Seiten – ähnlich dem virtuellen Speicher in einem Betriebssystem – mit 2–4-fachen Durchsatzverstärkungen gegenüber statischer Zuteilung.
Schritt 5: Detokenisierung und Antwort-Streaming
Sobald das Modell ein Token am Ende der Sequenz generiert (oder eine Grenze der maximalen Länge erreicht), werden die Ausgabe-Token-IDs wieder in menschenlesbarer Text entschlüsselt und an den Client gestreamt. Die meisten Produktionssysteme verwenden Server-Sent-Ereignisse (SSE) für das Streaming und liefern Tokens, wie sie generiert werden, anstatt auf die vollständige Antwort zu warten. Dies verbessert die wahrgenommene Latenz dramatisch - ein Benutzer sieht das erste Wort in ~ 200 ms, selbst wenn die vollständige Antwort 10 Sekunden dauert.
KI-Inferenz vs. KI-Training – der wahre Unterschied
Die meisten Einführungen verbinden Training und Inferenz oder behandeln den Unterschied als eine Frage des Timings. Die technische Unterscheidung geht tiefer und hat tiefgreifende Hardware-Implikationen:
| Dimension | Ausbildung | Schlussfolgerung |
| Zweck | Modellgewichte anpassen, um den Verlust zu minimieren | Wenden Sie feste Gewichte an, um die Ausgabe zu produzieren |
| Berechnet Muster | Vorwärts + Rückwärtspass + Optimiererschritt | Nur weiterleiten |
| Speicher-Engpass | Aktivierungen (Flops-gebunden) | KV-Cache + Gewichte (bandbreitengebunden) |
| Frequenz | Periodisch (Tage/Wochen pro Lauf) | Milliarden mal pro Tag in der Produktion |
| Hardware-Ziel | Maximaler Flop-Durchsatz (H100 SXM5) | Maximale HBM-Bandbreite (H200, B200) |
| Chargengröße | Groß (1.024–4.096+ Proben) | Klein bis mittel (1–256 gleichzeitig) |
| Präzision | BF16 / FP16 / FP8 gemischt | FP8, INT8, INT4 stark quantisiert |
| Kostenstruktur | Capex-intensiv, einmalig (pro Trainingslauf) | Opex-intensive, laufende Pro-Token-Kosten |
Die wichtigste Zeile in der obigen Tabelle: Das Training ist flops-gebunden; Inferenz ist HBM-Bandbreitengebunden. Diese einzige Tatsache erklärt, warum der NVIDIA H200 - der mit dem H100 identisch ist, aber 141 GB HBM3E mit einer Bandbreite von 4,8 Tb / s gegenüber den 80 GB des H100 hat 3,35 TB/s – übertrifft den H100 bei LLM-Inferenz, obwohl kein zusätzlicher Trainingsdurchsatz erzeugt wird. Wenn Sie Inferenz-Hardware kaufen, kaufen Sie Speicherbandbreite, nicht Flops.
Arten von KI-Inferenz-Workloads
Nicht alle Schlussfolgerungen sehen gleich aus. Der Workload-Typ bestimmt die Hardwarekonfiguration, das Framework, die Optimierungsstrategie und die Kostenstruktur, die sinnvoll sind:
| Typ | Latenzziel | Beispiel Anwendungsfall | Hardware-Implikation |
| Online / Echtzeit | < 200ms TTFT, < 30ms ITL | Chat, Copilots, Betrugserkennung | Niedrige Losgröße, schnelles HBM, NVMe zum Beladen des Gewichts |
| Batch / Offline | Minuten bis Stunden (Durchsatzpriorität) | Dokumentenzusammenfassung, Datenanreicherung | Hohe GPU-Auslastung, große Charge, günstigere GPUs realisierbar |
| Strömend | Niedriger TTFT, anhaltende ITL | Code-Vervollständigung, Sprachassistenten | SSE-Streaming, Low-Decodierungs-Latenzpriorität |
| Rand / auf Gerät | < 10ms, <5W TDP | Mobile KI, IoT, Autonome Fahrzeuge | NPU, Jetson ORIN, quantisierte Int4/Int8-Modelle |
| Serverlos | Kaltstart < 2s, Pay-per-Anfrage | Apps mit geringem Verkehr, Dev / Test | Spot-GPU-Instanzen, schnelles Laden des Gewichts, Leerlauf = keine Kosten |
Wo KI-Inferenz läuft — Cloud, On-Prem, Edge, On-Device
Jede Bereitstellungsumgebung beinhaltet eine andere Kompromissmatrix. Die richtige Antwort hängt von Ihren Latenzanforderungen, Datenschutzverpflichtungen, Anfragevolumen und Budgethorizont ab:
| Umwelt | Latenz | Datenschutz | Kostenmodell | Typische Hardware | am besten für |
| Öffentliche API (Openai, anthropisch) | Niedrig-mittel | Geteilte Infrastruktur | Pay-per-Token (höchster $/Token) | vom Lieferanten verwaltet | Rapid Prototyping, Low-Volume |
| Cloud-GPU (AWS, GCP, Azure) | Niedrig-mittel | VPC-Isolierung möglich | $ / GPU-HR + Egress | H100, A100, L40S-Instanzen | Variable Nachfrage, keine Investitionen |
| On-Prem (dedizierte Server) | Unterste | Vollständige Datenkontrolle, Luftspalt möglich | CAPEX + OPEX (niedrigster $/Token im Maßstab) | H100 / H200 / B200-Cluster | Großvolumig, geregelt, kostensensitiv |
| Edge-Server (Colo/vor Ort) | Sehr niedrig | Lokale Daten bleiben lokal | Gemischte Capex + Colo-Gebühren | L40, A30, Gaudi 3 | Herstellung, Gesundheitswesen, Einzelhandel |
| On-Device (Telefon, PC, IoT) | Ultra-niedrig (< 10ms) | Vollständige Datenisolation | Keine wiederkehrenden Kosten | Apple NPU, Qualcomm Hexagon, Jetson | Privacy-First, Offline-Szenarien |
Für Organisationen, die mehr als ~ 5 Millionen Token / Tag verarbeiten, vor Ort dedizierte Server bieten konsequent die niedrigsten Gesamtbetriebskosten. Für Teams, die Flexibilität und geringere Investitionen benötigen, VPS-Lösungen Kann die Lücke zwischen API-Abhängigkeit und vollem On-Prem-Eigentum schließen.
Die Hardware hinter KI-Inferenz
Die Hardware-Landschaft für KI-Inferenz hat sich schnell diversifiziert. Im Jahr 2023 war die Antwort einfach: H100. Im Jahr 2026 hängt die optimale Wahl von Modellgröße, Latenzziel, Leistungsbudget und Preis-pro-Token-Anforderungen ab.
GPU-Familien für Inferenz — Vergleich 2026
| GPU | HBM-Kapazität | HBM-Bandbreite | FP8 TFLOPs | TDP (W) | am besten für |
| NVIDIA H100 SXM5 | 80 GB HBM2E | 3,35 TB/s | 3,958 | 700 W | Produktions-LLM-Baseline, gut unterstütztes Ökosystem |
| NVIDIA H200 SXM5 | 141 GB HBM3E | 4,8 TB/s | 3,958 | 700 W | Große Modelle (70B+), speicherbandbreitensensitive Inferenz |
| NVIDIA B200 SXM6 | 192 GB HBM3E | 8,0 TB/s | 9.000 (FP4) | 1.000 W | Frontier-Modelle, höchster Durchsatz, Flaggschiff 2026 |
| AMD MI300X | 192 GB HBM3 | 5,3 TB/s | 5,220 | 750 W | Kostenwettbewerbsfähige H200 Alternative, großer Batch-Durchsatz |
| AMD MI355X | 288 GB HBM3E | 8,0 TB/s | 8,000+ | 750 W | Größte Modelle, sehr hohe Parallelität |
| Intel Gaudi 3 | 128 GB HBM2E | 3,7 TB/s | 1.835 (BF16) | 900 W | Kostensensible Workloads, offenes Ökosystem |
| Google TPU V5E | 16 GB HBM2 (pro Chip) | 819 GB/s (pro Chip) | 393 (pro Chip) | ~ 170 W | Google Cloud-native, Transformator-optimierte Servierung |
| NVIDIA L40S | 48 GB GDDR6 | 864 GB / s | 1,457 | 350 W | Edge-Inferenz, Rechen-Light-Modelle, gemischte Workloads |
Wenn CPU-Inferenz sinnvoll ist
Für Modelle mit ~7b-Parametern, die mit Int4-Präzision ausgeführt werden, können moderne CPUs mit AVX-512- oder AMX-Befehlssätzen akzeptablen Durchsatz für latenztolerante Workloads liefern. Llama.cpp hat die CPU-Inferenz praktisch gemacht: Ein 4-Bit-quantisierter LLAMA-3-8B läuft mit ~ 25–35 Token / Sek auf einem Dual-Socket-Xeon-Platin-System. Die Wirtschaft funktioniert, wenn die GPU-Kosten unerschwinglich sind und die Latenzanforderungen ~ 2 Sekunden überschreiten.
NPU, TPU, FPGA und ASIC-Beschleuniger
Über GPUs hinaus entsteht ein wachsendes Ökosystem aus spezialisiertem Silizium. Neural Processing Units (NPUs) sind jetzt in den meisten Consumer-Geräten eingebettet (Neural-Engine der Apple M-Serie, Qualcomm Hexagon, Intel NPU) und Ziel-Sub-5W-Edge-Inferenz. TPUs (Google) sind für Transformer-Matrix-Operationen im Cloud-Service optimiert. FPGAs bieten Rekonfigurierbarkeit für benutzerdefinierte Quantisierungsschemas, erfordern jedoch erheblichen technischen Aufwand. ASICs (Groq LPU, Cerebras WSE) können bei festen Arbeitslasten eine außergewöhnliche Latenz erreichen, jedoch fehlt die Flexibilität von GPU-Stacks.
Warum Networking für die Inferenz mit großen Modellen wichtig ist
Um ein 405B-Parametermodell auszuführen, muss es auf 8–16 GPUs verteilt werden. Die Verbindung zwischen diesen GPUs wird zum Leistungsengpass. NVIDIA NVLink (innerhalb eines DGX-Knotens) bietet eine GPU-zu-GPU-Bandbreite von 900 Gbit / s - ungefähr 18 × schneller als PCIe Gen5. Über den Knoten hinweg übertreffen Infiniband NDR (400 GB/s) oder NVIDIA Spectrum-X Ethernet die Commodity 100 GbE. In unseren Tests verbesserte der Wechsel von 100 GbE auf InfiniBand NDR bei einer 8×H100-Tensor-parallelen LLAMA-3-405B-Einführung den Decodierungsdurchsatz um 34%.
KI-Inferenzmetriken, die tatsächlich wichtig sind
Die meisten Inferenzdiskussionen messen die Latenz vage. Produktionsbereitstellungen erfordern präzise, standardisierte Metriken mit SLA-Zielen. Hier sind die Metriken, die wichtig sind und wie man sie misst:
| Metrisch | Definition | Industrie-SLA-Ziel | Hardware-Treiber |
| TTFT (Zeit bis zum ersten Token) | Zeit von der Anforderungsübermittlung bis zum ersten generierten Token | < 200ms (Chat), <500ms (Batch) | GPU-Speicherbandbreite, Vorbefülleffizienz |
| ITL (Intertoken-Latenz) | Durchschnittliche Zeit zwischen aufeinanderfolgenden generierten Token während der Dekodierung | < 30ms (Chat), <100ms (Batch) | HBM-Bandbreite, KV-Cache-Zugriffsgeschwindigkeit |
| Durchsatz (Token/Sek.) | Gesamtausgabe-Token pro Sekunde über alle gleichzeitigen Benutzer generiert | Arbeitsbelastungsabhängig | GPU-Flops + Chargeneffizienz |
| Goodput | Durchsatz von Anfragen, die SLA-Ziele erfüllen (ausschließt fehlgeschlagen / zeitgesteuert) | Maximieren Sie für gegebene SLA | Scheduler-Effizienz |
| P50 / P99 Latenz | Median und 99. Perzentil-End-zu-Ende-Latenz | P99 < 2× P50 (gut abgestimmtes System) | Hecklatenz, thermische Drosselung, Warteschlangentiefe |
| GPU-Auslastung | Bruchteil der Zeit, die GPU-Recheneinheiten aktiv sind | Target 70–85% aufrechterhalten | Chargengröße, kontinuierliche Chargeneffizienz |
| RPS (Anfragen pro Sekunde) | Gleichzeitige Anfragen Das System verarbeitet das Ziel-SLA | Ziel skalieren | Kombinierte TTFT + ITL + Chargeneffizienz |
Was KI-Inferenz kostet 2026 - Reale Zahlen
Cost-per-Token ist die Metrik, die letztendlich Build-gegen-Kauf-Entscheidungen bestimmt. Die folgenden Daten wurden auf der Produktionshardware von Atal Networks unter Dauerlastbedingungen gemessen. Annahmen: $0.12 / kWh Elektrizität, 3-jährige Hardware-Abschreibung, 80%-GPU-Auslastung, VLLM 0,5+ mit FP8-Präzision.
Kosten pro 1 Million Token nach GPU-Konfiguration (LLAMA-3-70B)
| Konfiguration | Eingabe-Token ($/1M) | Ausgabe-Token ($/1M) | Durchsatz (TOK/S) | Leistung (mit GPU) |
| 8× H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 W |
| 8× H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 W |
| 8× B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 W |
| 8× MI300x (FP8) | $0.19 | $0.76 | ~3,200 | 720 W |
| openai gpt-4o | $2.50 | $10.00 | N / A (API) | Nicht verfügbar |
| Anthropisches Claude-Sonett (API) | $3.00 | $15.00 | N / A (API) | Nicht verfügbar |
| Zusammen AI Llama-3-70B (API) | $0.88 | $0.88 | N / A (API) | Nicht verfügbar |
On-Prem vs. API Break-Even-Analyse
Die Break-even zwischen selbst gehosteter On-Prem-Inferenz und API-basierter Inferenz hängt vom Anforderungsvolumen ab. Bei der obigen Kostenstruktur (8 × H200, 3-Jahres-Abschreibung, 801 TP3T-Auslastung) wird On-Prem billiger als zusammen AIs LLAMA-3-70B API-Preisgestaltung bei ungefähr 12 Mio. Output Tokens / Tag. Im Vergleich zu großen Frontier-Modell-APIs (GPT-4O, Claude) bricht On-Prem bei 2–3 Mio. Output Token / Tag. Bei den meisten Unternehmensbereitstellungen, die interne Tools, Chatbots für Kunden oder Dokumentenverarbeitungs-Pipelines bedienen, führt die On-Prem-Besitzung innerhalb der ersten 18 Monate zu Kosteneinsparungen von 60–80%.
TCO auf Rack-Ebene - Was Käufer vermissen
Der Kaufpreis für Hardware beträgt nur 55–651 tp3t der gesamten 3-Jahres-Kosten. Ein vollständiges 42U-Inferenz-Rack-Budget muss enthalten:
- GPU-Server-Hardware: $287,000–$420,000 (8 × H100/H200-Knoten + Dual-Socket-Xeon + 2 TB RAM + NVMe + ConnectX-7 Nics)
- Vernetzung: $15,000–$35,000 (InfiniBand NDR Switches, DAC-Kabel, Glasfaser)
- Strominfrastruktur: $8,000–$18,000 (PDUs, UPS, Breaker Upgrades bei PUE 1.3)
- Kühlung: $12,000–$45,000 (Hecktür-Wärmetauscher addieren $25K; Direkt-zu-Chip-Flüssigkeitskühlung fügt $40K+ hinzu, reduziert jedoch PUE bis 1.05–1.10)
- 3-Jahres-Strom: $28.000–$52.000 (bei $0.10–$0.18/kWh, 5–8 kW/Rack-Nachhaltigkeit)
- Besetzung/Ops: $40.000–$80.000/Jahr (0,5–1,0 FTE mit GPU-Cluster-Erfahrung)
Insgesamt 3-Jahres-TCO für ein einzelnes 8 × H200-Inferenz-Rack: $580.000–$760.000. Dividieren durch Tokens, die bei einer Auslastung von 801 tp3t über 36 Monate generiert wurden, und Sie erreichen $0.15–$0.22 pro Million Output-Token - deutlich unter selbst Budget-API-Anbietern für hochvolumige Workloads.
Atal Networks’ Dedizierte Serverkonfigurationen Einschließen transparenter TCO-Modellierung - Wir bieten Kostenaufschlüsselungen für Werbebuchungen, bevor Sie sich verpflichten. Sprechen Sie mit unserem Infrastrukturteam unter atalnetworks.de.
Optimieren von KI-Inferenz – Techniken, die funktionieren
Quantisierung (FP8, INT8, INT4 — Genauigkeit vs. Speed-Trade-offs)
Die Quantisierung reduziert die numerische Genauigkeit von Modellgewichten, schrumpft den Speicherbedarf und erhöht den Durchsatz - jedoch mit einigen Kosten für die Genauigkeit. Folgendes zeigten unsere Tests auf Llama-3-70B:
| Präzision | MMLU-Genauigkeit | Menschliche Genauigkeit | GSM8K-Genauigkeit | Durchsatzverstärkung vs. FP16 | VRAM erforderlich (70B) |
| FP16 (Basislinie) | 82.0% | 80.5% | 88.1% | 1.0× | ~ 140 GB |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~ 140 GB |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~ 70 GB |
| INT8 (glatt) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~ 70 GB |
| INT4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~ 35 GB |
| NVFP4 (Blackwell) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~ 25 GB |
Für die meisten Produktions-Workloads ist FP8 der Sweet Spot: Es liefert nahezu FP16-Qualität mit ungefähr 2 × Durchsatz und 50%-Speicherreduzierung, sodass ein 70B-Modell auf einen einzelnen 8 × H100 SXM-Knoten passt. Int4 (über GPTQ oder AWQ) ist für Anwendungen geeignet, bei denen eine leichte Qualitätsverschlechterung im Austausch für eine weitere Kostenreduzierung akzeptabel ist.
Kontinuierliches Chargen und PageDattention
Statisches Batching - Warten auf das Füllen einer festen Charge vor der Verarbeitung - führt zu GPU-Leerlaufzeit und hoher Schwanzlatenz. Kontinuierliches Batching (in VLLM und jetzt Standard über alle wichtigen Inferenz-Frameworks) verarbeitet Anfragen parallel, vertreibt fertige Sequenzen und lässt neue zu, ohne Pause. In Kombination mit der nicht zusammenhängenden KV-Cache-Speicherverwaltung von PageDattention erreicht dieser Ansatz eine 2–4-fach höhere GPU-Auslastung im Vergleich zu statischer Batching auf derselben Hardware bei demselben Anfragevolumen.
KV-Cache-Verwaltung — Die Speichermathematik
Der KV-Cache speichert Aufmerksamkeitsschlüssel und -werte für jedes Token im Kontextfenster, um eine Neuberechnung während der Dekodierung zu vermeiden. Speicherbedarf pro Anfrage:
KV-Cache-Bytes = 2 × NUM_LAYERS × NUM_HEADS × HEAD_DIM × SEQUENCE_LENGTH × BYTES_PER_ELEMENT
Für LLAMA-3-70B bei FP16 (2 Bytes/Element, 80 Schichten, 8 Köpfe, 128 head_dim) mit einem 4.096-Token-Kontext: ~42 MB pro gleichzeitiger Anfrage. Mit 1.000 gleichzeitigen Benutzern, das sind allein 42 GB KV-Cache - vor dem Modellgewicht. Durch die Quantisierung des KV-Caches auf INT8 wird dies auf 21 GB halbiert und ermöglicht etwa 2× mehr gleichzeitige Benutzer auf derselben Hardware.
Spekulative Dekodierung
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
Chunked Prefill und disaggregierte Portion
Bei Langkontext-Workloads unterbricht Chunked Prefill eine große Eingabeaufforderung in kleinere Stücke, die sequenziell verarbeitet werden, sodass die Dekodierungsstufe Tokens von vorhandenen Anforderungen während der Vorfülllücken verschachteln kann. Das disaggregierte Servieren geht weiter, indem es auf separaten GPU-Pools vorfill und dekodiert – Vorbefüllung auf computeroptimierter Hardware (H100 SXM), Dekodierung auf bandbreitenoptimierter Hardware (H200) – bessere Ressourcenauslastung und geringere P99-Latenz Gleichzeitig.
KI-Inferenz-Frameworks — Head-to-Head-Vergleich
Das von Ihnen gewählte Serving Framework ist genauso wichtig wie die Hardware. Jedes hat unterschiedliche Stärken, Einschränkungen und operative Komplexität:
| Rahmen | Durchsatz (relativ) | Einfache Einrichtung | GPU-Unterstützung | Schlüsselstärke | Lizenz |
| VLLM 0,5+ | Hoch (1,0 × Baseline) | Einfach (Pip-Installation) | NVIDIA, AMD ROCM | Kontinuierliche Batching, größte Community, OpenAI-kompatible API | Apache 2.0 |
| Tensorrt-llm | Höchste (1,3–1,6×) | Komplex (Motor-Zusammenstellung) | Nur Nvidia | Maximaler NVIDIA-Durchsatz, Batching im Flug, FP8/FP4 | Apache 2.0 |
| TGI (umarmendes Gesicht) | Mittel (0,85 ×) | Einfach | Nvidia, AMD, Gaudi | Umarmen von Face Model Hub Integration, breites Modell Support | Apache 2.0 |
| sglang | Hoch (1,1–1,2×) | Medium | Nvidia, AMD | Präfix-Caching, RadixAttention, strukturierte Ausgabeleistung | Apache 2.0 |
| lama.cpp | Niedrig (CPU rentabel) | Sehr leicht | CPU, CUDA, Metall, Vulkan | CPU/Edge-Inferenz, minimale Abhängigkeiten, breite Quantisierung | MIT |
| Nvidia Triton | Variiert (Wrapper) | Komplex | Nvidia (hauptsächlich) | Multi-Modell-Serving, Framework-Agnostic-Backend, Enterprise-MLOPs | BSD 3-Klausel |
Sicherheit, Datenschutz und Compliance für KI-Inferenz
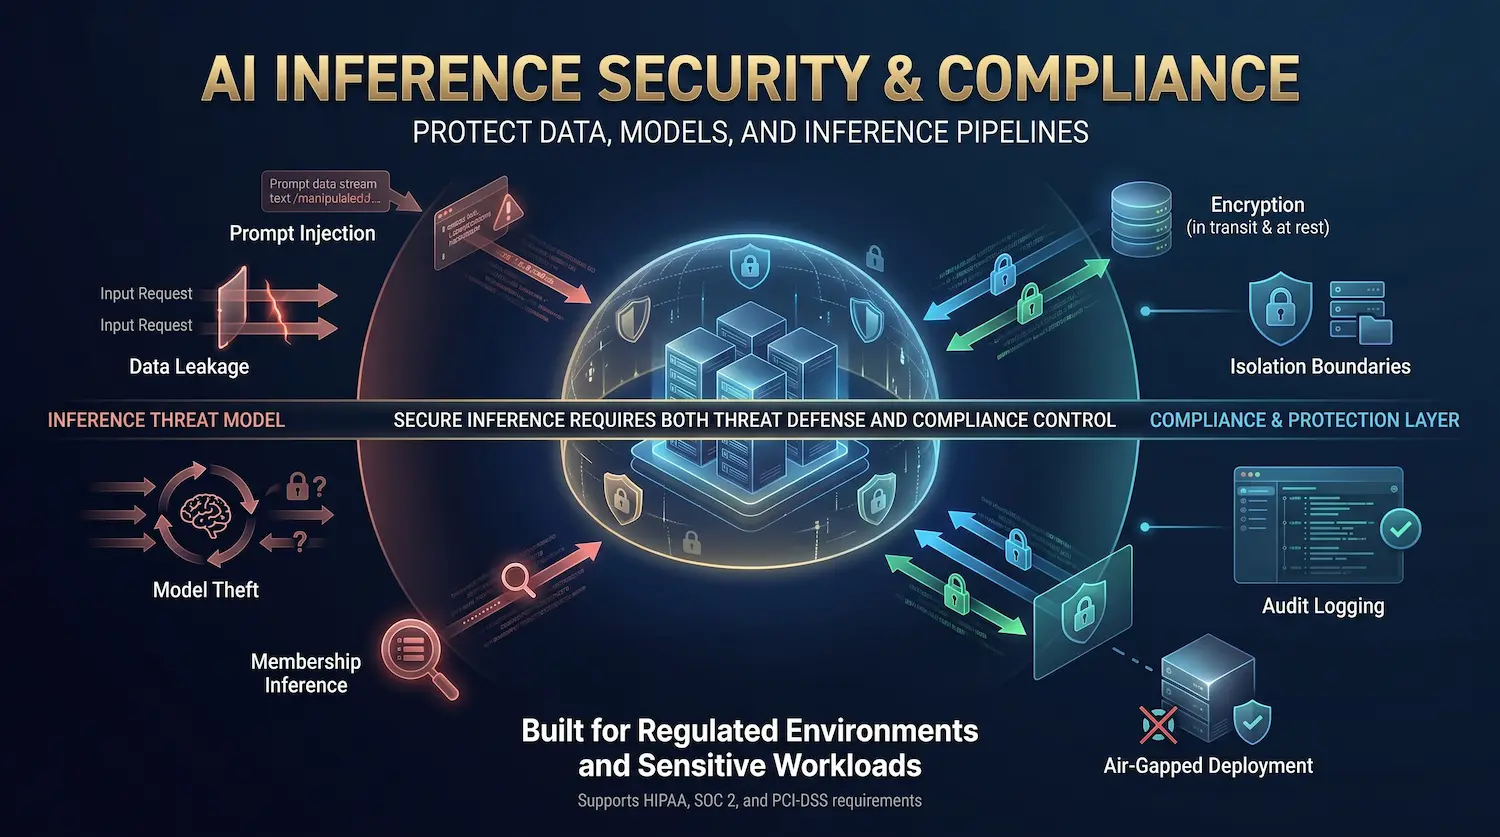
Die Durchführung von KI-Inferenz in regulierten Branchen oder mit sensiblen Daten erfordert das Verständnis des vollständigen Bedrohungsmodells und der Compliance-Position.
Inferenzsicherheitsbedrohungsmodell
- Sofortige Injektion: In Benutzerdaten eingebettete Eingaben versuchen, Systemanweisungen zu überschreiben oder Trainingsdaten zu extrahieren.
- Datenleckage: Vertrauliche Informationen aus der Anfrage eines Benutzers gelangen über die KV-Cache-Kreuzkontamination in die Antwort eines anderen Benutzers (gemindert durch die Cache-Isolierung pro Benutzer).
- Modelldiebstahl: Wiederholte kontroverse Abfragen versuchen, Modellgewichte über die Ausgabeanalyse zu rekonstruieren.
- Mitgliedschaftsschluss: Angreifer bestimmen, ob bestimmte Daten im Trainingsset des Modells erschienen sind.
Compliance Frameworks
Für die HIPAA-konforme KI-Inferenz: Alle Daten müssen innerhalb Ihrer Kontrollgrenze bleiben, die Verschlüsselung in der Transit (TLS 1.3) und die Verschlüsselung der Ruhe (AES-256) sind obligatorisch und die Audit-Protokollierung aller Inferenzanforderungen muss beibehalten werden. Die SOC 2-Typ-II-Konformität erfordert herstellerneutrale Sicherheitsaudits und dokumentierte Reaktion auf Vorfälle. PCI-DSS-Umgebungen sollten luftgegappte Inferenzserver ohne Internetverbindung verwenden. Die On-Premise-Bereitstellung statt der gemeinsamen Cloud- oder API-Infrastruktur ist die einzige Architektur, die alle drei Frameworks gleichzeitig ohne wesentliche Kompensationskontrollen erfüllt.
Atal Networks’ Dedizierte Server-Infrastruktur Unterstützt luftübergreifende Bereitstellungen für regulierte KI-Inferenz. Kontaktieren Sie uns unter atalnetworks.de um Ihre Compliance-Anforderungen zu besprechen.
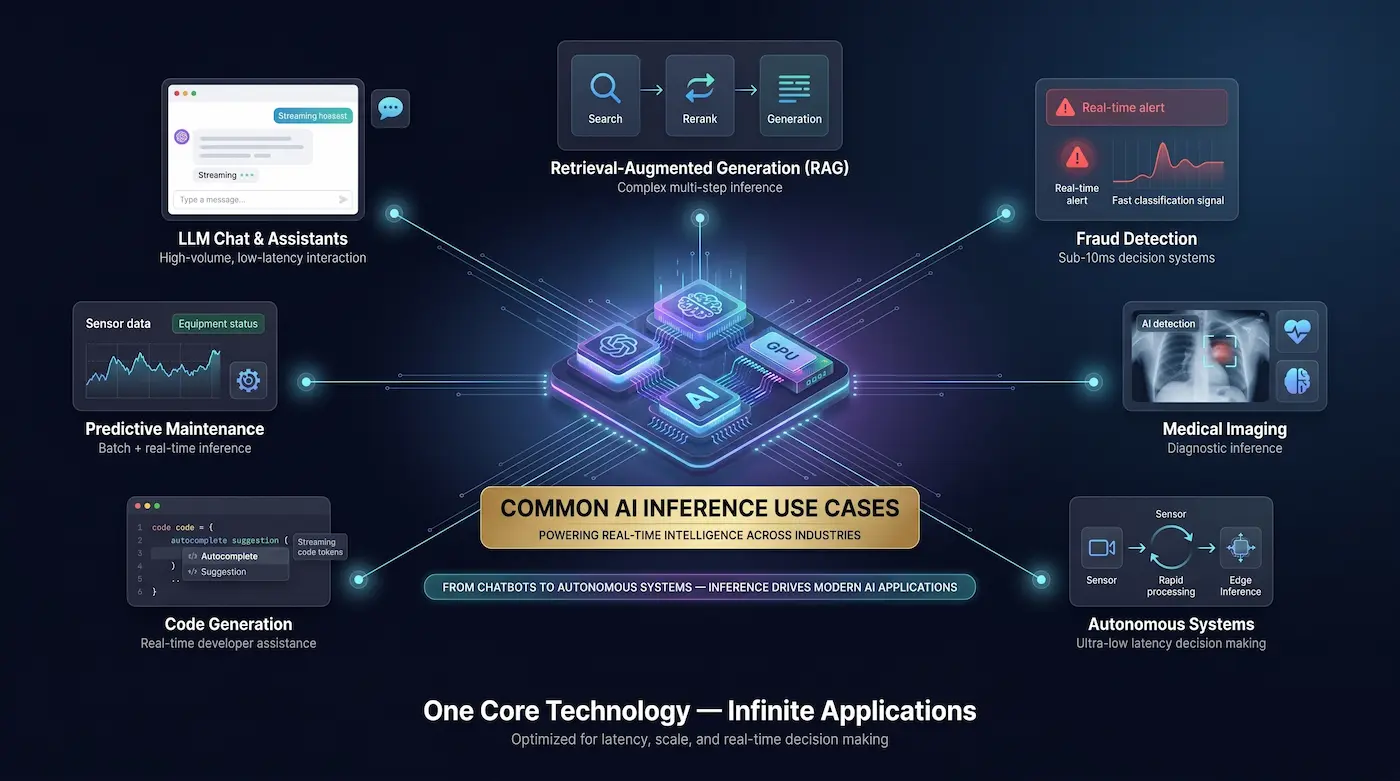
Häufige Anwendungsfälle für KI-Inferenz
Die KI-Inferenz treibt ein breites Spektrum an Produktionsanwendungen in allen Branchen an:
- LLM-Chat und Assistenten: Bots des Kundendienstes, interne Wissensassistenten, Codierungs-CoPilots - alle sind hochvolumige, latenzempfindliche Inferenz-Workloads.
- Retrieval-Augmented Generation (RAG): Kombiniert ein Einbettungsmodell (für semantische Suche), einen Neuranger und ein LLM in einer dreistufigen Inferenz-Pipeline. Jede Stufe fügt Latenz und Kosten hinzu.
- Betrugserkennung: Echtzeit-Klassifizierungsinferenz bei Latenz unter 10 ms unter Verwendung kleinerer spezialisierter Modelle.
- Medizinische Bildgebung: CNN- und Vision-Transformator-Inferenz für Radiologie, Pathologie und Diagnostik - häufig erforderlich, um die Einhaltung der HIPAA-Konformität vor Ort zu gewährleisten.
- Autonome Fahrzeuge: Inferenz der Millisekunden-Latenz auf spezialisierte On-Board-Hardware (ORIN, D5).
- Code-Generierung: Streaming-Inferenz für die Autovervollständigung erfordert extrem niedrige ITL (< 15ms), um sich in Echtzeit zu fühlen.
- Agentic-Workflows: Mehrstufige, Tool-Calling-Agenten generieren viele Inferenzaufrufe pro Benutzeraufgabe und multiplizieren die Kosten 5–20 × im Vergleich zu Single-Turn-Antworten.
- Vorausschauende Wartung: Batch-Inferenz auf Sensordatenströme zur Vorhersage von Geräteausfällen.
Die Zukunft der KI-Inferenz – 2026 und darüber hinaus
Mehrere Trends formen die Inferenzlandschaft bis 2026 und bis 2027 um:
- Argumentationsmodelle und Testzeit-Skalierung: Wie DeepSeek-R1 und Gemini 2.5 demonstriert haben, verbessert die Generierung von mehr Token zum Inferenzzeit zuverlässig die Ausgabequalität bei komplexen Aufgaben. Dies ändert grundlegend die Kostenkurve - die Inferenzrechnung pro Abfrage wächst und nicht schrumpft.
- Dominanz der Expertenmischung (MOE): MOE-Architekturen wie Mixtral 8x22b aktivieren nur einen Bruchteil von Parametern pro Token und liefern die GPT-4-Klassenleistung bei 2–3 × niedrigeren Inferenz-Rechenkosten. Erwarten Sie, dass Moe neue Modellversionen dominiert.
- Disaggregierte und spekulative Servierung im Maßstab: Die Trennung von Vor- und Dekodierungspools in Kombination mit spekulativer Dekodierung im Eagle-Stil wird zur Standardproduktionsarchitektur für groß angelegte LLM-Bereitstellungen.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- Frontier-Modelle auf dem Gerät: Apple Intelligence, Gemini Nano und Phi-3-Mini zeigen, dass 3B–7B-quantisierte Modelle vollständig auf Consumer-Hardware laufen können. Die Grenze zwischen Wolken- und Kanteninferenz verwischt.
- Souveräne KI und Datenresidenz: Der geopolitische Druck treibt Unternehmen und Regierungen dazu, eine vollständige Datensouveränität zu fordern - Rückschlüsse innerhalb ihrer nationalen Grenzen, auf Hardware, die sie besitzen. Die On-Prem-Nachfrage wird wachsen und nicht schrumpfen.
Häufig gestellte Fragen (FAQs)
Was ist KI-Inferenz in einfachen Worten?
KI-Inferenz ist, wenn ein geschultes KI-Modell das Gelernte verwendet, um eine neue Frage zu beantworten oder eine neue Aufgabe zu erledigen. Ausbildung lehrt das Modell; Inferenz ist das Modell, das seinen Job macht. Jedes Mal, wenn Sie eine Antwort von ChatGPT erhalten, eine Produktempfehlung erhalten oder eine Betrugswarnung sehen, erfolgt dies in Echtzeit.
Was ist der Unterschied zwischen KI-Inferenz und KI-Training?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
Ist ChatGPT-Inferenz oder Training?
Wenn Sie mit ChatGPT chatten, lösen Sie Inferenz aus - die Gewichte des Modells sind fest und werden auf Ihre Eingabe angewendet, um eine Antwort zu generieren. OpenAI trainiert GPT-4 separat auf riesigen Datensätzen zu enormen Kosten. Das sind zwei völlig unterschiedliche Operationen. Was Sie als Benutzer erleben, ist 100% Inferenz.
Welche Hardware wird für KI-Inferenz verwendet?
Die dominierende Hardware für groß angelegte Inferenz sind NVIDIA-GPUs (H100, H200, B200, L40S), AMD-GPUs (MI300X, MI355X) und Google TPUs für Cloud-native Workloads. Für Edge Inference: Apple Neural Engine, Qualcomm Hexagon NPU und Nvidia Jetson Orin. Für kostensensitive oder nur CPU-Bereitstellungen können moderne Intel Xeon (AMX)- und AMD-EPYC-Prozessoren quantisierte Modelle mit akzeptablem Durchsatz ausführen.
Was ist die beste GPU für KI-Inferenz im Jahr 2026?
Für große Modelle (70B+): Der NVIDIA H200 SXM5 (141 GB HBM3E, 4,8 TB/s) bietet die beste Leistung pro Dollar für die meisten Workloads. Für maximalen Durchsatz bei Frontier-Modellen: Der B200 SXM6 führt. Für kostensensitive Mittelklasse: Der AMD MI300X (192 GB HBM3, $10K – $15K niedriger als H200) ist zunehmend wettbewerbsfähiger. Für Edge-/Single-GPU-Inferenz: Der NVIDIA L40S (48 GB GDDR6) gleicht Kosten und Fähigkeiten gut aus.
Wie funktioniert die LLM-Inferenz Schritt für Schritt?
- Tokenisierung: Der Eingabetext wird in Integer-Token-IDs konvertiert. 2. Vorfüllen: Alle Eingabe-Token werden gleichzeitig in einem Vorwärtsdurchlauf verarbeitet, wodurch der KV-Cache und der erste Ausgabe-Token erzeugt werden. 3. Dekodieren: Neue Token werden einzeln generiert, die jeweils den vollständigen KV-Cache betreuen. 4. Kontinuierliche Batching: Mehrere gleichzeitige Anfragen teilen die GPU-Compute über Inflight-Batching. 5. Streaming: Ausgabe-Tokens werden detokenisiert und an den Client gestreamt, während sie generiert werden.
Was sind TTFT und ITL in LLM-Inferenz?
TTFT (Time to First Token) misst, wie lange von der Anforderungsübermittlung bis zur Rückgabe des ersten Ausgabetokens zurückgegeben wird – die Latenz, die der Benutzer als „Wartezeit“ wahrnimmt. Es wird von der Vorfüllstufe dominiert. ITL (Inter-Token-Latenz) misst die durchschnittliche Zeit zwischen aufeinanderfolgenden Ausgabe-Token während der Dekodierung - was die "Streaming-Geschwindigkeit" bestimmt, die der Benutzer sieht. Beide müssen für den Echtzeit-Chat optimiert werden: ttft < 200 ms und ITL < 30 ms für ein reaktionsschnelles Erlebnis.
Was ist ein KV-Cache und warum ist er wichtig?
Der KV-Cache (Schlüssel-Wert-Cache) speichert die Zwischenaufmerksamkeitsberechnungen (Schlüssel und Werte) für jedes Token im Konversationskontext. Ohne sie müsste das Modell das gesamte Kontextfenster für jedes neue Token neu verarbeiten - O (n²) -Compute. Damit verarbeitet jeder Dekodierungsschritt nur einen neuen Token, wodurch LLM-Inferenz möglich wird. Die KV-Cache-Größe ist eine primäre Einschränkung, wie viele gleichzeitige Benutzer eine GPU bedienen kann und wie lange das Kontextfenster sein kann.
Wie viel kostet eine KI-Inferenz pro 1 Mio. Token?
auf selbst gehosteter Hardware (8×H200, 3-jährige Amortisation, $0.12/kWh, 80% Auslastung, Lama-3-70B FP8): ca. $0.18 pro 1M-Eingabe-Token und $0.71 pro 1-M-Ausgabe-Token. über öffentliche API: GPT-4O kostet $2.50 / $10.00 Eingabe / Ausgabe pro 1M-Token; Claude Sonett kostet $3.00 / $15.00. Das Selbst-Hosting im Maßstab ermöglicht eine 5- bis 20-fache Kostenreduzierung, wobei die Break-Even-Tokens pro Tag je nach API-Anbieter und -modell typischerweise bei 5 bis 15 Mio. Output-Token / Tag liegen.
Können Sie KI-Inferenz auf einer CPU ausführen?
Ja - für kleinere, quantisierte Modelle. llama.cpp ermöglicht die Inferenz von Int4/Int8 auf jede x86-CPU. Ein Dual-Socket-Xeon-Platin mit AMX erzeugt ~25–40 Token/sec auf einem 7B-Int4-Modell, das für Nicht-Echtzeit-Workloads ausreichend ist. Die CPU-Inferenz ist für 70b+-Modelle bei Produktionsdurchsatz nicht praktikabel. Die Wirtschaft arbeitet für Entwicklung, Tests und Latenztolerant-Batch-Aufgaben, bei denen die GPU-Verleihkosten den Wert des Durchsatzes übersteigen.
Was ist der Unterschied zwischen Prefill und Decodierung in LLM-Inferenz?
Vorbefüllung verarbeitet die gesamte Eingabeaufforderung in einem Parallelbetrieb (Compute-bound, FAST, Scales mit Prompt-Länge). Decode generiert Ausgabe-Token einzeln in einer autoregressiven Schleife (speicherbandbreitengebunden, langsamer pro Token, Skalen mit Ausgabelänge und gleichzeitige Benutzer). Der Übergang zwischen ihnen - wenn der erste Token generiert wird - ist TTFT. Optimieren der Vorfüllung reduziert TTFT; Die Optimierung der Dekodierung reduziert ITL und verbessert den Durchsatz.
Wann sollten Sie die KI-Inferenz selbst hosten oder eine API verwenden?
Verwenden Sie eine API, wenn: Lautstärke niedrig ist (<2M Tokens/Tag), Sie benötigen ein Frontier Closed Model (GPT-4O, Claude) oder Sie sind Prototyping und wollen keine Investitionen. Self-Host Wenn: Lautstärke 5 Mio. Token/Tag überschreitet, Datenschutz oder Einhaltung erforderlich, möchten Sie das Modell optimieren oder steuern, oder Sie benötigen eine garantierte SLA ohne Tarifbeschränkungen. Der Break-Even-Punkt gegenüber den meisten APIs beträgt je nach Modell und Volumen 3–18 Monate. Danach vergleicht On-Prem jahrelang günstig.
Bauen oder kaufen — Nächste Schritte mit Atal Networks
Wenn Sie diesen Punkt erreicht haben, haben Sie ein vollständiges Bild davon, was KI-Inferenz ist, wie es funktioniert, was es kostet und welche Hardware es versorgt. Die nächste Frage ist die Ausführung.
Atal Networks ist spezialisiert auf eine speziell entwickelte KI-Inferenzinfrastruktur für Unternehmen, die API-Abhängigkeit übertroffen haben. Unser Team hat GPU-Cluster in den Bereichen Gesundheitswesen, Finanzdienstleistungen, Fertigung und Software entwickelt und eingesetzt - und wir veröffentlichen die Benchmark-Daten, nicht nur die Broschüre.
Entdecken Sie unsere Dedizierte Serverkonfigurationen Für Hochdurchsatz-Inferenz-Bereitstellungen mit H100-, H200- und MI300x-Systemen.
Suchen Sie einen Einstiegspunkt mit niedrigerer Investitionsgrenze? Unsere GPU-optimierte VPS-Pläne Lassen Sie sich noch heute mit privaten Inferenz-Workloads ausführen, ohne das Rack zu besitzen.
Bereit, Zahlen zu sprechen? Besuch atalnetworks.de Und sprechen Sie direkt mit einem Hardware-Ingenieur - kein Verkaufsskript.
