 Μετάβαση στο περιεχόμενο



Με Κύριος Μηχανικός Υλικού, Atal Networks | MLPERF v4.1 Συνεισφέρων | Αρχιτεκτονική συμπλέγματος GPU 12 ετών | Ενημερώθηκε: 19 Απριλίου 2026
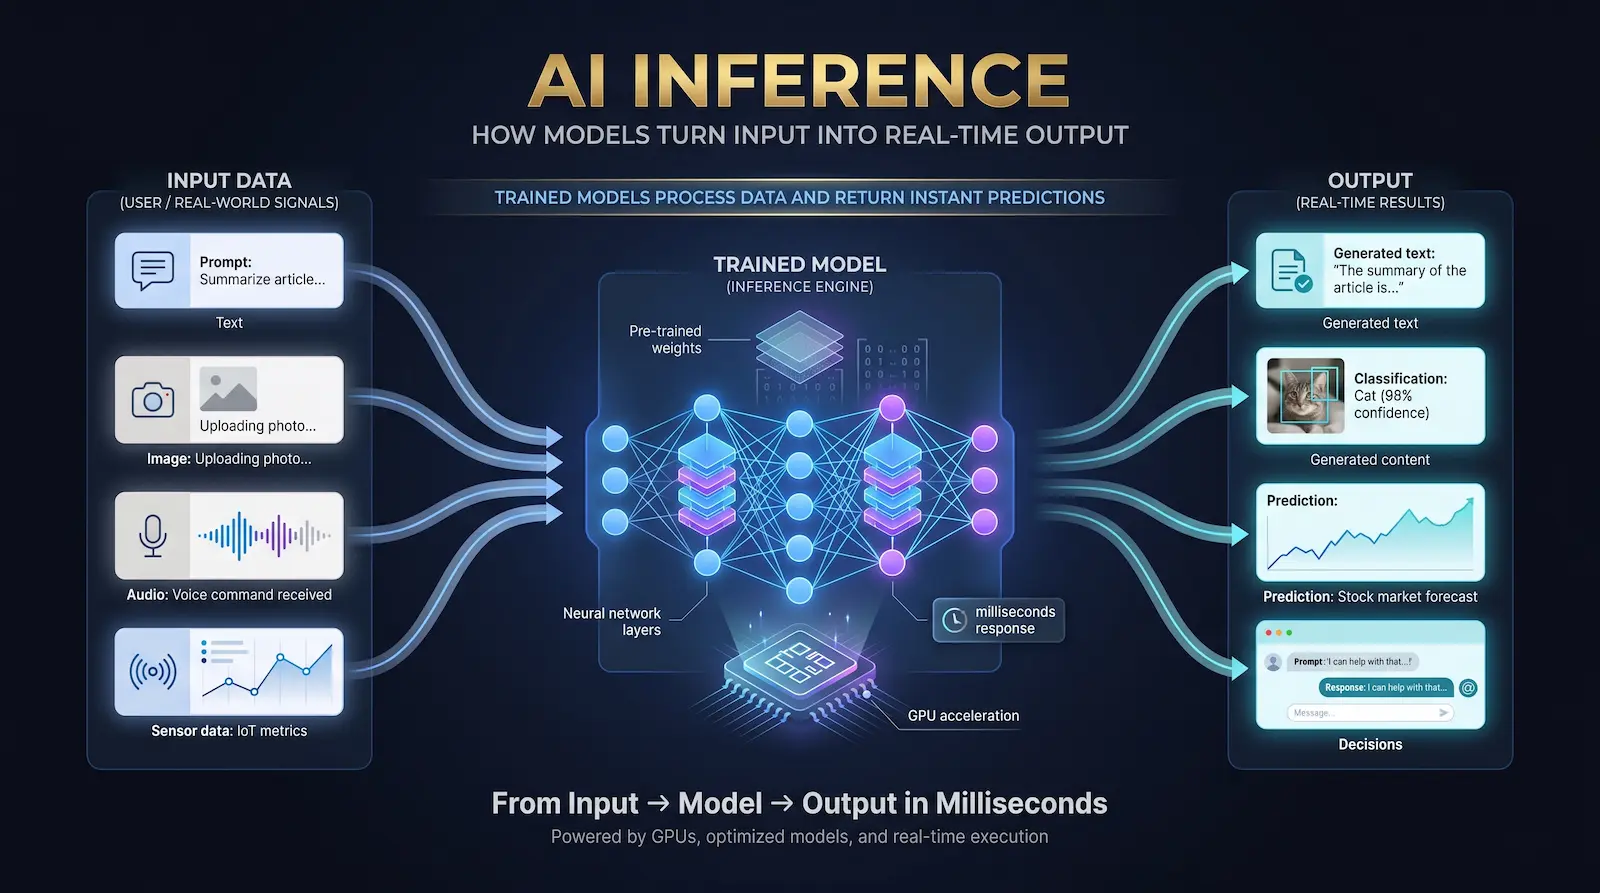
| TL;DR — Τι είναι το συμπέρασμα AI; Το συμπέρασμα τεχνητής νοημοσύνης είναι η διαδικασία εκτέλεσης ενός εκπαιδευμένου μοντέλου AI σε νέα δεδομένα εισόδου για την παραγωγή μιας πρόβλεψης, ταξινόμησης ή παραγόμενης εξόδου. Είναι η φάση «κάνω» της τεχνητής νοημοσύνης — κάθε απάντηση chatgpt, ειδοποίηση απάτης, λεζάντα εικόνας και κλήση αντίληψης αυτοοδήγησης είναι ένα γεγονός συμπερασμάτων. Το 2026, το συμπέρασμα καταναλώνει περίπου τα δύο τρίτα των συνολικών υπολογιστικών δαπανών τεχνητής νοημοσύνης παγκοσμίως. Αυτός ο οδηγός καλύπτει τον πλήρη αγωγό, το υλικό που τον τροφοδοτεί, τις μετρήσεις που τον μετρούν (TTFT, ITL, Tokens/Sec) και το κόστος εκτέλεσης — με σημεία αναφοράς που μετρώνται στους διακομιστές του ίδιου του Atal Networks. |
Τι είναι το συμπέρασμα AI; Ο ορισμός μιας πρότασης
| Ορισμός Το συμπέρασμα τεχνητής νοημοσύνης είναι η εκτέλεση ενός εκπαιδευμένου μοντέλου μηχανικής εκμάθησης σε νέα, αόρατα δεδομένα για την παραγωγή μιας εξόδου — όπως μια απόκριση κειμένου, ταξινόμηση εικόνας, βαθμολογία απάτης ή μετάφραση — χωρίς τροποποίηση των βαρών του μοντέλου. |
Σκεφτείτε το ως εξής: Η εκμάθηση οδήγησης είναι εκπαίδευση. Κάθε φορά που οδηγείτε πραγματικά κάπου, αυτό είναι συμπέρασμα. Το μοντέλο (οι οδηγικές σας ικανότητες) είναι σταθερό. Μόνο η είσοδος (ο δρόμος) αλλάζει. Σε τεχνικούς όρους, το συμπέρασμα είναι ένα μπροστινό πέρασμα μέσω του νευρωνικού δικτύου — ρέουν δεδομένα προς μία κατεύθυνση μέσω των επιπέδων του μοντέλου, υπολογίζονται οι ενεργοποιήσεις και παράγεται μια έξοδος. Σε αντίθεση με την προπόνηση, δεν υπάρχουν υπολογισμοί κλίσης, δεν υπάρχουν ενημερώσεις βάρους και δεν υπάρχει πάσα προς τα πίσω.
Η διάκριση έχει τεράστια σημασία στην πράξη. Η εκπαίδευση γίνεται μία φορά (ή περιοδικά). Τα συμπεράσματα συμβαίνουν δισεκατομμύρια φορές την ημέρα. Η βελτιστοποίηση για συμπεράσματα — χαμηλότερη καθυστέρηση, υψηλότερη απόδοση, χαμηλότερο κόστος ανά διακριτικό — είναι εκεί που ζει η πραγματική πρόκληση μηχανικής το 2026.
Γιατί το συμπέρασμα τεχνητής νοημοσύνης έχει σημασία τώρα — το πλαίσιο του 2026
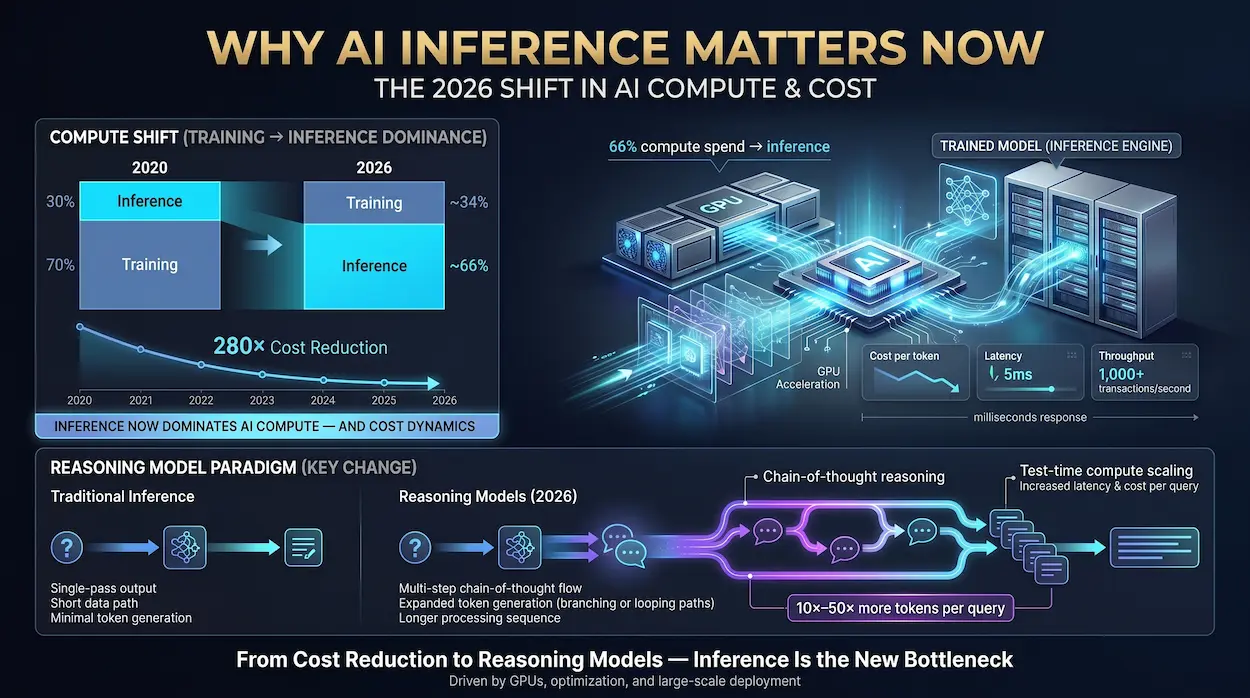
Το συμπέρασμα κυριαρχεί πλέον στις δαπάνες υπολογισμού AI
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
το σημείο καμπής συλλογισμού-μοντέλου
Μοντέλα όπως το DeepSeek-R1, το Gemini 2.5 Thinking και το Llama Nemotron Ultra έχουν εισαγάγει ένα νέο παράδειγμα συμπερασμάτων: την κλιμάκωση υπολογισμού χρόνου δοκιμής. Αντί να παράγουν μια απάντηση σε ένα μόνο μπροστινό πέρασμα, αυτά τα μοντέλα «σκέφτονται» δημιουργώντας εκτεταμένα διακριτικά αλυσίδας σκέψης πριν απαντήσουν. Αυτό πολλαπλασιάζει τον αριθμό των διακριτικών που δημιουργούνται ανά ερώτημα επί 10–50×, αυξάνοντας δραματικά το κόστος συμπερασμάτων και την καθυστέρηση — και αναδιαμορφώνοντας ποια διαμόρφωση υλικού έχει νόημα για ένα δεδομένο φόρτο εργασίας.
Γιατί υπάρχει αυτός ο οδηγός
Κάθε άρθρο ορισμού στο διαδίκτυο περιγράφει συμπεράσματα τεχνητής νοημοσύνης σε επίπεδο γλωσσαρίου. Κανένα από αυτά δεν δημοσιεύει δεδομένα αναφοράς πρώτου μέρους, στοιχεία πραγματικού κόστους ανά διακριτικό ή μαθηματικά TC σε επίπεδο rack. Γράψαμε αυτόν τον οδηγό επειδή κατασκευάζουμε και λειτουργούμε τους διακομιστές — και πιστεύουμε ότι οι αγοραστές αξίζουν πραγματικούς αριθμούς, όχι αφαιρέσεις μάρκετινγκ.
Το Atal Networks προσφέρει εταιρικής ποιότητας αποκλειστικοί διακομιστές και Λύσεις VPS Σκοπός για φόρτους εργασίας συμπερασμάτων τεχνητής νοημοσύνης. Εξερευνώ atalnetworks.com Για να μάθετε περισσότερα.
Πώς λειτουργεί το συμπέρασμα τεχνητής νοημοσύνης — βήμα προς βήμα
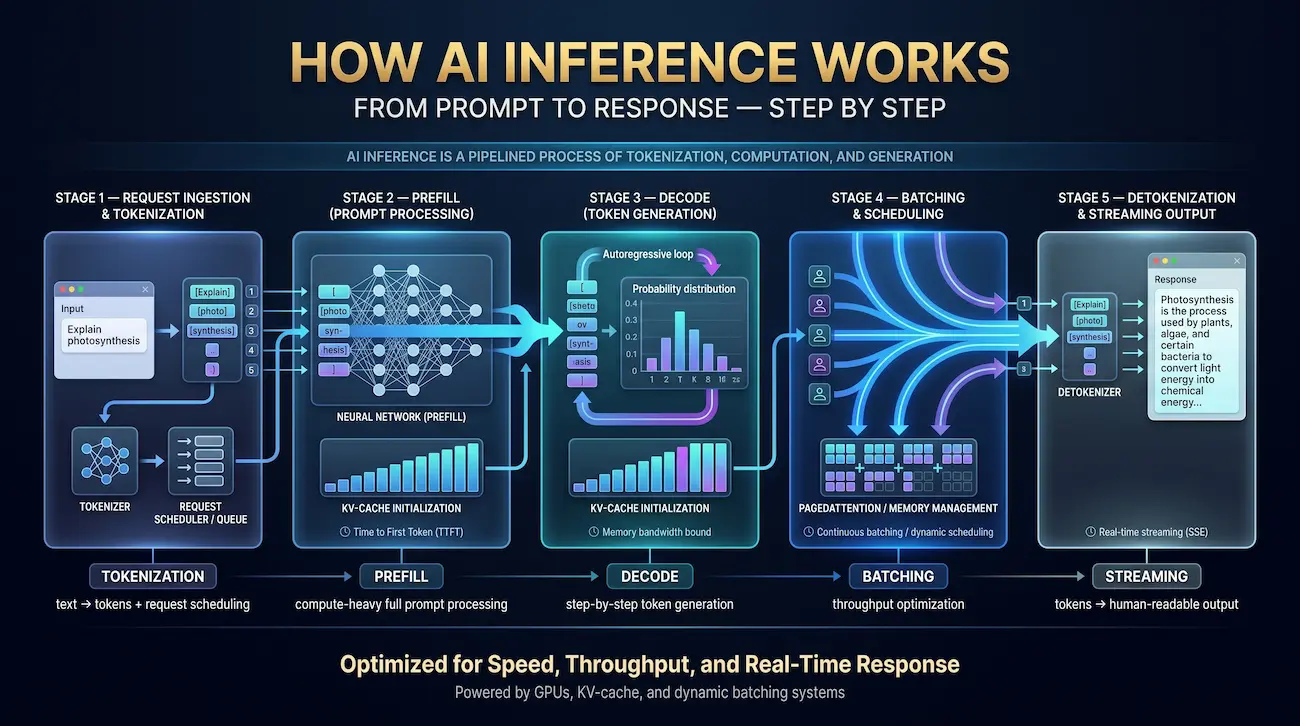
Η κατανόηση του συμπεράσματος τεχνητής νοημοσύνης απαιτεί την ανίχνευση ενός μόνο αιτήματος μέσω του πλήρους κύκλου ζωής του. Για ένα μεγάλο γλωσσικό μοντέλο (LLM), ο αγωγός έχει πέντε διακριτά στάδια:
Βήμα 1: Ζητήστε κατάποση και διακριτική
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
Βήμα 2: Το στάδιο προπλήρωσης (προτροπή επεξεργασίας)
Κατά την προπλήρωση, ολόκληρη η προτροπή εισόδου επεξεργάζεται ταυτόχρονα σε ένα μόνο μπροστινό πέρασμα. Αυτό το στάδιο είναι υπολογισμένο - κλιμακώνεται γραμμικά με το μήκος της προτροπής και είναι ο κύριος οδηγός του χρόνου στο πρώτο διακριτικό (TTFT). Μια προτροπή συστήματος 2.048 διακριτικών διαρκεί περίπου διπλάσιο χρόνο σε προπλήρωση από μια προτροπή 1.024 διακριτικών. Το Prefill δημιουργεί την αρχική κρυφή μνήμη KV (κλειδί-τιμή κρυφής μνήμης), η οποία αποθηκεύει υπολογισμούς ενδιάμεσης προσοχής, ώστε να μην χρειάζεται να υπολογιστούν εκ νέου κατά την αποκωδικοποίηση.
Βήμα 3: Το στάδιο αποκωδικοποίησης (δημιουργία διακριτικών)
Μετά την προπλήρωση, το μοντέλο εισέρχεται στο στάδιο αποκωδικοποίησης, δημιουργώντας ένα διακριτικό τη φορά σε έναν αυτοπαλινδρομικό βρόχο. Κάθε νέο διακριτικό εξαρτάται από όλα τα προηγούμενα διακριτικά - το μοντέλο παρακολουθεί την πλήρη κρυφή μνήμη KV, παράγει μια κατανομή πιθανοτήτων πάνω από το λεξιλόγιό του (~32.000–128.000 μάρκες), δείγματα από αυτήν την κατανομή και προσθέτει το επιλεγμένο διακριτικό. Το στάδιο αποκωδικοποίησης είναι δεσμευμένο σε εύρος ζώνης μνήμης, όχι δεσμευμένο σε υπολογισμό. Αυτός είναι ο λόγος για τον οποίο το εύρος ζώνης HBM (όχι flops) είναι η αποφασιστική προδιαγραφή υλικού για το συμπέρασμα LLM — γεγονός που κάθε φύλλο δεδομένων GPU θάβει με ψιλά γράμματα.
Βήμα 4: Παρτίδα και προγραμματισμός
Ένας αφελής διακομιστής συμπερασμάτων θα επεξεργαζόταν ένα αίτημα κάθε φορά, αφήνοντας τη GPU ως επί το πλείστον σε αδράνεια κατά την αποκωδικοποίηση (καθώς το ένα διακριτικό κάθε φορά είναι αργό). Τα σύγχρονα συστήματα χρησιμοποιούν συνεχή παρτίδα (ονομάζεται επίσης κατά την πτήση ή δυναμική παρτίδα): Τα αιτήματα ομαδοποιούνται κατά τη διάρκεια της πτήσης, νέα αιτήματα ενώνονται στην παρτίδα καθώς ανοίγουν οι υποδοχές και οι ολοκληρωμένες ακολουθίες εξάγονται χωρίς να περιμένουν να ολοκληρωθούν όλα τα αιτήματα. Η υλοποίηση PageDattention του VLLM (Kwon et al., SOSP 2023) βελτιώνει περαιτέρω αυτό με τη διαχείριση της μνήμης KV-cache σε μη συνεχόμενες σελίδες — παρόμοια με την εικονική μνήμη σε ένα λειτουργικό σύστημα — αποδίδοντας κέρδη 2–4× διεκπεραίωσης έναντι στατικών κατανομή.
Βήμα 5: Αποτοξινοποίηση και ροή απόκρισης
Μόλις το μοντέλο δημιουργήσει ένα διακριτικό τέλους ακολουθίας (ή φτάσει σε ένα όριο μέγιστου μήκους), τα αναγνωριστικά διακριτικών εξόδου αποσυναρμολογούνται ξανά σε κείμενο αναγνώσιμο από τον άνθρωπο και μεταδίδονται σε ροή στον πελάτη. Τα περισσότερα συστήματα παραγωγής χρησιμοποιούν συμβάντα που αποστέλλονται από διακομιστή (SSE) για ροή, παρέχοντας διακριτικά καθώς δημιουργούνται αντί να περιμένουν την πλήρη απόκριση. Αυτό βελτιώνει δραματικά την αντιληπτή καθυστέρηση — ένας χρήστης βλέπει την πρώτη λέξη σε ~200ms, ακόμα κι αν η πλήρης απάντηση διαρκεί 10 δευτερόλεπτα.
Συμπεράσματα AI έναντι εκπαίδευσης AI — η πραγματική διαφορά
Οι περισσότερες εισαγωγές συγχέουν την εκπαίδευση και τα συμπεράσματα ή αντιμετωπίζουν τη διαφορά ως θέμα χρόνου. Η τεχνική διάκριση είναι βαθύτερη και έχει βαθιές επιπτώσεις στο υλικό:
| Διάσταση | Εκπαίδευση | Συμπέρασμα |
| Σκοπός | Adjust model weights to minimize loss | Εφαρμόστε σταθερά βάρη για την παραγωγή παραγωγής |
| υπολογιστικό μοτίβο | εμπρός + βήμα προς τα πίσω + βήμα βελτιστοποίησης | μόνο προς τα εμπρός πάσο |
| εμπόδιο μνήμης | ενεργοποιήσεις (δεσμευμένες στο flops) | KV-cache + βάρη (δεσμευμένο εύρος ζώνης) |
| Συχνότητα | Περιοδική (ημέρες/εβδομάδες ανά τρέξιμο) | δισεκατομμύρια φορές/ημέρα σε παραγωγή |
| στόχος υλικού | Μέγιστη απόδοση flop (H100 SXM5) | Μέγιστο εύρος ζώνης HBM (H200, B200) |
| μέγεθος παρτίδας | Μεγάλο (1.024–4.096+ δείγματα) | Μικρό έως μεσαίο (1–256 ταυτόχρονο) |
| Ακρίβεια | BF16/FP16/FP8 Μικτό | fp8, int8, int4 σε μεγάλο βαθμό κβαντισμένο |
| δομή κόστους | Εντάσεως Capex, εφάπαξ (ανά τρέξιμο) | OpEx-εντατικό, συνεχές κόστος ανά συμβολικό κόστος |
Η μοναδική πιο σημαντική γραμμή στον παραπάνω πίνακα: Η προπόνηση είναι δεσμευμένη σε flops. Το συμπέρασμα είναι δεσμευμένο σε εύρος ζώνης HBM. Αυτό το μεμονωμένο γεγονός εξηγεί γιατί το NVIDIA H200 — το οποίο έχει τον ίδιο αριθμό πυρήνων CUDA με το H100 αλλά 141 GB HBM3E σε εύρος ζώνης 4,8 TB/s έναντι των 80 GB του H100 σε 3,35 TB/s — Ξεπερνά τις επιδόσεις του H100 στο συμπέρασμα LLM παρά το γεγονός ότι δεν παράγει πρόσθετη απόδοση εκπαίδευσης. Όταν αγοράζετε υλικό συμπερασμάτων, αγοράζετε εύρος ζώνης μνήμης, όχι flops.
Τύποι φόρτου εργασίας συμπερασμάτων τεχνητής νοημοσύνης
Δεν φαίνονται όλα τα συμπεράσματα ίδια. Ο τύπος φόρτου εργασίας καθορίζει τη διαμόρφωση υλικού, το πλαίσιο εξυπηρέτησης, τη στρατηγική βελτιστοποίησης και τη δομή κόστους που είναι λογικό:
| Τύπος | στόχος καθυστέρησης | Παράδειγμα περίπτωσης χρήσης | υπονοούμενα υλικού |
| Διαδικτυακά / σε πραγματικό χρόνο | < 200ms TTFT, < 30ms ITL | συνομιλία, συγκυβερνήτες, ανίχνευση απάτης | Χαμηλό μέγεθος παρτίδας, γρήγορο HBM, NVMe για φόρτωση βάρους |
| παρτίδα / εκτός σύνδεσης | λεπτά έως ώρες (προτεραιότητα διεκπεραίωσης) | Σύνοψη εγγράφων, εμπλουτισμός δεδομένων | Υψηλή χρήση GPU, μεγάλη παρτίδα, φθηνότερες GPU βιώσιμες |
| ροή | χαμηλό ttft, διατηρημένο itl | συμπλήρωση κώδικα, φωνητικοί βοηθοί | ροή SSE, προτεραιότητα χαμηλής αποκωδικοποίησης λανθάνουσας κατάστασης |
| Edge / On-Device | < 10ms, < 5W TDP | Κινητό AI, IoT, αυτόνομα οχήματα | NPU, Jetson Orin, κβαντισμένα μοντέλα INT4/INT8 |
| άγονος | Ψυχρή εκκίνηση < 2s, pay-per-request | Εφαρμογές χαμηλής επισκεψιμότητας, dev/test | Spot περιπτώσεις GPU, γρήγορη φόρτωση βάρους, ρελαντί=μηδενικό κόστος |
Όπου εκτελείται το συμπέρασμα AI — Cloud, On-Prem, Edge, On-Device
Κάθε περιβάλλον ανάπτυξης περιλαμβάνει μια διαφορετική μήτρα ανταλλαγής. Η σωστή απάντηση εξαρτάται από τις απαιτήσεις καθυστέρησης, τις υποχρεώσεις απορρήτου δεδομένων, τον όγκο αιτημάτων και τον ορίζοντα προϋπολογισμού:
| Περιβάλλο | Αφάνεια | ιδιωτικότητα δεδομένων | μοντέλο κόστους | Τυπικό υλικό | καλύτερο για |
| Δημόσιο API (Openai, Anthropic) | χαμηλό-μεσαίο | Κοινόχρηστη υποδομή | pay-per-token (υψηλότερο $/token) | διαχειριζόμενος από τον πωλητή | Ταχεία πρωτότυπα, χαμηλού όγκου |
| Cloud GPU (AWS, GCP, Azure) | χαμηλό-μεσαίο | Δυνατότητα απομόνωσης VPC | $/gpu-hr + έξοδος | περιπτώσεις H100, A100, L40S | Μεταβλητή ζήτηση, χωρίς Capex |
| On-Prem (Αποκλειστικοί διακομιστές) | Χαμηλότερο | Πλήρης έλεγχος δεδομένων, δυνατό διάκενο αέρα | CAPEX + OPEX (χαμηλότερη $/Token σε κλίμακα) | Συστάδες H100/H200/B200 | Υψηλού όγκου, ρυθμιζόμενο, ευαίσθητο στο κόστος |
| Διακομιστής Edge (colo/on-site) | πολύ χαμηλά | Τα τοπικά δεδομένα παραμένουν τοπικά | Μικτά τέλη Capex + Colo | L40s, A30, Gaudi 3 | μεταποίηση, υγειονομική περίθαλψη, λιανικό εμπόριο |
| στη συσκευή (τηλέφωνο, υπολογιστής, IoT) | Εξαιρετικά χαμηλό (< 10ms) | Complete data isolation | Χωρίς επαναλαμβανόμενο κόστος | Apple NPU, Qualcomm Hexagon, Jetson | Σενάρια Privacy-First, Offline |
Για οργανισμούς που επεξεργάζονται περισσότερα από ~5 εκατομμύρια μάρκες/ημέρα, εσωτερικής εγκατάστασης αποκλειστικοί διακομιστές Προσφέρετε σταθερά το χαμηλότερο συνολικό κόστος ιδιοκτησίας. Για ομάδες που χρειάζονται ευελιξία και χαμηλότερη αρχική επένδυση, Λύσεις VPS Μπορεί να γεφυρώσει το χάσμα μεταξύ της εξάρτησης API και της πλήρους ιδιοκτησίας on-prem.
το υλικό πίσω από το συμπέρασμα AI
Το τοπίο υλικού για το συμπέρασμα τεχνητής νοημοσύνης έχει διαφοροποιηθεί γρήγορα. Το 2023, η απάντηση ήταν απλή: H100. Το 2026, η βέλτιστη επιλογή εξαρτάται από το μέγεθος του μοντέλου, τον στόχο καθυστέρησης, τον προϋπολογισμό ισχύος και τις απαιτήσεις τιμής ανά διακριτικό.
Οικογένειες GPU για συμπεράσματα — Σύγκριση 2026
| GPU | Χωρητικότητα HBM | Εύρος ζώνης HBM | FP8 TFLOPS | TDP (W) | καλύτερο για |
| NVIDIA H100 SXM5 | 80 GB HBM2E | 3,35 TB/s | 3,958 | 700 W | Παραγωγή LLM Baseline, καλά υποστηριζόμενο οικοσύστημα |
| NVIDIA H200 SXM5 | 141 GB HBM3E | 4,8 TB/s | 3,958 | 700 W | Μεγάλα μοντέλα (70B+), συμπέρασμα ευαίσθητο στο εύρος ζώνης μνήμης |
| NVIDIA B200 SXM6 | 192 GB HBM3E | 8,0 TB/s | 9.000 (FP4) | 1.000 W | Frontier Models, υψηλότερη απόδοση, ναυαρχίδα του 2026 |
| amd mi300x | 192 GB HBM3 | 5,3 TB/s | 5,220 | 750 W | Ανταγωνιστική ως προς το κόστος εναλλακτική λύση H200, μεγάλη απόδοση παρτίδας |
| amd mi355x | 288 GB HBM3E | 8,0 TB/s | 8,000+ | 750 W | Μεγαλύτερα μοντέλα, πολύ υψηλό συγχρονισμό |
| Intel Gaudi 3 | 128 GB HBM2E | 3,7 TB/s | 1.835 (BF16) | 900 W | Κόστος ευαίσθητος φόρτος εργασίας, ανοιχτό οικοσύστημα |
| Google TPU v5e | 16 GB HBM2 (ανά τσιπ) | 819 GB/s (ανά τσιπ) | 393 (ανά τσιπ) | ~170 w | Google Cloud-Native, μετασχηματιστής-βελτιστοποιημένη εξυπηρέτηση |
| nvidia l40s | 48 GB GDDR6 | 864 GB/s | 1,457 | 350 W | Συμπεράσματα άκρων, μοντέλα υπολογιστικού φωτός, μικτός φόρτος εργασίας |
Όταν το συμπέρασμα της CPU έχει νόημα
Για μοντέλα κάτω των ~ 7b παραμέτρων που εκτελούνται με ακρίβεια INT4, οι σύγχρονες CPU με σετ εντολών AVX-512 ή AMX μπορούν να προσφέρουν αποδεκτή απόδοση για φόρτους εργασίας ανεκτικούς σε λανθάνοντα χρόνο. Το Llama.cpp έχει κάνει το συμπέρασμα της CPU πρακτικό: Ένα κβαντισμένο LAMA-3-8B 4 bit τρέχει με ~25–35 μάρκες/δευτερόλεπτο σε ένα σύστημα Xeon Platinum διπλής υποδοχής. Τα οικονομικά λειτουργούν όταν το κόστος της GPU είναι απαγορευτικό και οι απαιτήσεις καθυστέρησης υπερβαίνουν τα ~2 δευτερόλεπτα.
Επιταχυντές NPU, TPU, FPGA και ASIC
Πέρα από τις GPU, αναδύεται ένα αναπτυσσόμενο οικοσύστημα εξειδικευμένου πυριτίου. Οι μονάδες νευρωνικής επεξεργασίας (NPU) είναι πλέον ενσωματωμένες στις περισσότερες καταναλωτικές συσκευές (Neural Engine της σειράς M της Apple, Qualcomm Hexagon, Intel NPU) και Target Sub-5W Edge Inference. Τα TPU (Google) έχουν βελτιστοποιηθεί για λειτουργίες μήτρας μετασχηματιστή στην εξυπηρέτηση cloud. Τα FPGA προσφέρουν δυνατότητα επαναδιαμόρφωσης για προσαρμοσμένα σχήματα κβαντισμού, αλλά απαιτούν σημαντική προσπάθεια μηχανικής. Τα ASIC (GroQ LPU, Cerebras WSE) μπορούν να επιτύχουν εξαιρετική καθυστέρηση σε σταθερούς φόρτους εργασίας, αλλά δεν έχουν την ευελιξία των στοίβων GPU.
Γιατί η δικτύωση έχει σημασία για συμπεράσματα μεγάλου μοντέλου
Η εκτέλεση ενός μοντέλου παραμέτρων 405b απαιτεί τη διανομή του σε 8–16 GPU. Η διασύνδεση μεταξύ αυτών των GPU γίνεται το σημείο συμφόρησης απόδοσης. Το NVIDIA NVLink (εντός ενός κόμβου DGX) παρέχει 900 GB/s εύρος ζώνης GPU σε GPU — περίπου 18× ταχύτερο από το PCIe Gen5. Σε όλους τους κόμβους, το InfiniBand NDR (400 Gb/s) ή το Nvidia Spectrum-X Ethernet ξεπερνούν δραματικά το εμπόρευμα 100 GbE. Στις δοκιμές μας, η εναλλαγή από 100 GbE σε InfiniBand NDR σε 8×H100 τανυστή-παράλληλη LAMA-3-3-405B ανάπτυξη βελτίωσε την απόδοση αποκωδικοποίησης κατά 34%.
Μετρήσεις συμπερασμάτων AI που έχουν πραγματικά σημασία
Οι περισσότερες συζητήσεις συμπερασμάτων μετρούν την καθυστέρηση αόριστα. Οι αναπτύξεις παραγωγής απαιτούν ακριβείς, τυποποιημένες μετρήσεις με στόχους SLA. Ακολουθούν οι μετρήσεις που έχουν σημασία και πώς να τις μετρήσετε:
| Μετρικός | Ορισμός | Στόχος SLA βιομηχανίας | πρόγραμμα οδήγησης υλικού |
| TTFT (χρόνος στο πρώτο διακριτικό) | Χρόνος από την υποβολή αιτήματος έως το πρώτο διακριτικό που δημιουργήθηκε | < 200ms (chat), < 500ms (παρτίδα) | Εύρος ζώνης μνήμης GPU, αποτελεσματικότητα προπλήρωσης |
| ITL (Inter-Token Latency) | Μέσος χρόνος μεταξύ διαδοχικών διακριτικών που δημιουργούνται κατά την αποκωδικοποίηση | < 30ms (CHAT), < 100ms (παρτίδα) | Εύρος ζώνης HBM, ταχύτητα πρόσβασης στην κρυφή μνήμη KV |
| διεκπεραίωση (κουπόνια/δευτερόλεπτο) | Συνολικά διακριτικά εξόδου που δημιουργούνται ανά δευτερόλεπτο σε όλους τους ταυτόχρονους χρήστες | Workload-dependent | Αποτυχίες GPU + απόδοση παρτίδας |
| καλή διάθεση | διεκπεραίωση αιτημάτων που ανταποκρίνονται στους στόχους SLA (εξαιρούνται οι αποτυχημένες/χρονικοί άουτ) | μεγιστοποίηση για δεδομένη SLA | Αποδοτικότητα προγραμματιστή, διαχείριση ουράς |
| P50 / P99 Latency | διάμεσος και 99ος εκατοστημόριος καθυστέρηση από άκρο σε άκρο | P99 < 2× P50 (καλά ρυθμισμένο σύστημα) | καθυστέρηση ουράς, θερμικός στραγγαλισμός, βάθος ουράς |
| Αξιοποίηση GPU | κλάσμα του χρόνου Οι μονάδες υπολογισμού GPU είναι ενεργές | Ο στόχος 70–85% διατηρήθηκε | Μέγεθος παρτίδας, απόδοση συνεχούς παρτίδας |
| RPS (αιτήματα ανά δευτερόλεπτο) | ταυτόχρονα αιτήματα που χειρίζεται το σύστημα στο στόχο SLA | στόχος κλίμακας | Συνδυασμένο TTFT + ITL + απόδοση παρτίδας |
Τι κοστίζει το συμπέρασμα τεχνητής νοημοσύνης το 2026 — Πραγματικοί αριθμοί
Το κόστος ανά διακριτικό είναι η μέτρηση που καθορίζει τελικά τις αποφάσεις κατασκευής έναντι αγοράς. Τα ακόλουθα δεδομένα μετρήθηκαν σε υλικό παραγωγής Atal Networks υπό συνθήκες παρατεταμένου φορτίου. Υποθέσεις: $0,12/kWh ηλεκτρική ενέργεια, 3ετής απόσβεση υλικού, χρήση 80% GPU, VLLM 0,5+ με ακρίβεια FP8.
Κόστος ανά 1 εκατομμύριο μάρκες ανά διαμόρφωση GPU (LLAMA-3-70B)
| Διαμόρφωση | διακριτικά εισόδου ($/1M) | διακριτικά εξόδου ($/1M) | διεκπεραίωση (TOK/s) | Ισχύς (με GPU) |
| 8× H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 W |
| 8× H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 w |
| 8× B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 W |
| 8× MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720 w |
| openai gpt-4o | $2.50 | $10.00 | N/A (API) | Ν/Α |
| Anthropic Claude Sonnet (API) | $3.00 | $15.00 | N/A (API) | Ν/Α |
| Μαζί AI LLAMA-3-70B (API) | $0.88 | $0.88 | N/A (API) | Ν/Α |
Ανάλυση νεκρού σημείου On-Prem έναντι API
Το νεκρό σημείο μεταξύ του αυτο-φιλοξενούμενου συμπερασμάτων on-prem και του συμπερασμάτων που βασίζεται σε API εξαρτάται από τον όγκο αιτημάτων. Με τη δομή κόστους παραπάνω (8×H200, απόσβεση 3 ετών, χρήση 80%), η On-Prem γίνεται φθηνότερη από την τιμολόγηση LAMA-3-70B API της AI μαζί σε παραγωγή περίπου 12 εκατ. μάρκες/ημέρα. Σε σύγκριση με τα κύρια API του μοντέλου Frontier (GPT-4O, Claude), τα διαλείμματα on-prem διακόπτονται ακόμη και με μάρκες εξόδου 2–3m/ημέρα. Για τις περισσότερες εταιρικές αναπτύξεις που εξυπηρετούν εσωτερικά εργαλεία, chatbots που αντιμετωπίζουν πελάτες ή αγωγούς επεξεργασίας εγγράφων, η ιδιοκτησία on-prem παράγει εξοικονόμηση κόστους 60–80% μέσα στους πρώτους 18 μήνες.
TCO επιπέδου rack — Τι χάνουν οι αγοραστές
Η τιμή αγοράς υλικού είναι μόνο 55–65% του συνολικού κόστους 3 ετών. Ένας πλήρης προϋπολογισμός ραφιών συμπερασμάτων 42u πρέπει να περιλαμβάνει:
- Υλικό διακομιστή GPU: $287,000–$420.000 (8×H100/H200 κόμβος + διπλή υποδοχή Xeon + 2TB RAM + NVME + ConnectX-7 NIC)
- Δικτύωση: $15.000–$35.000 (διακόπτες NDR InfiniBand, καλώδια DAC, οπτικές ίνες)
- Υποδομή ηλεκτρικής ενέργειας: $8.000–$18.000 (PDU, UPS, αναβαθμίσεις διακόπτη στο PUE 1.3)
- Ψύξη: $12.000–$45.000 (Οι εναλλάκτες θερμότητας στην πίσω πόρτα προσθέτουν $25K, η υγρή ψύξη απευθείας στο τσιπ προσθέτει $40K+ αλλά μειώνεται PUE έως 1,05–1,10)
- Ηλεκτρισμός 3 ετών: $28.000–$52.000 (στο $0.10–$0.18/kWh, 5–8 kW/rack Sustained Draw)
- Στελέχωση/Επιχείρηση: $40.000–$80.000/έτος (0,5–1,0 FTE με εμπειρία συμπλέγματος GPU)
Σύνολο 3ετών TCO για ένα μόνο ράφι συμπερασμάτων 8×H200: $580.000–$760.000. Διαιρέστε με μάρκες που δημιουργούνται σε 80% Χρήση σε 36 μήνες και φτάνετε σε $0.15–$0,22 ανά εκατομμύριο μάρκες εξόδου — πολύ κάτω από ακόμη και παρόχους προϋπολογισμού API για μεγάλους όγκους φόρτους εργασίας.
Atal Networks' διαμορφώσεις αποκλειστικού διακομιστή Συμπεριλάβετε τη διαφανή μοντελοποίηση TCO — παρέχουμε αναλύσεις κόστους γραμμικών στοιχείων προτού δεσμευτείτε. Μιλήστε με την ομάδα υποδομής μας στο atalnetworks.com.
Βελτιστοποίηση συμπερασμάτων τεχνητής νοημοσύνης — Τεχνικές που λειτουργούν
Κβαντοποίηση (FP8, INT8, INT4 — Ακρίβεια έναντι αντισταθμίσεων ταχύτητας)
Η κβαντοποίηση μειώνει την αριθμητική ακρίβεια των βαρών του μοντέλου, τη συρρίκνωση του αποτυπώματος της μνήμης και την αύξηση της απόδοσης — αλλά με κάποιο κόστος για την ακρίβεια. Εδώ είναι τι έδειξε η δοκιμή μας στο LLAMA-3-70B:
| Ακρίβεια | ακρίβεια mmlu | ανθρώπινη ακρίβεια | Ακρίβεια GSM8K | κέρδος απόδοσης έναντι FP16 | Απαιτείται VRAM (70B) |
| FP16 (γραμμή βάσης) | 82.0% | 80.5% | 88.1% | 1.0× | ~140 GB |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140 GB |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70 GB |
| int8 (smoothquant) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70 GB |
| INT4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35 GB |
| NVFP4 (Blackwell) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25 GB |
Για τους περισσότερους φόρτους εργασίας παραγωγής, το FP8 είναι το γλυκό σημείο: προσφέρει ποιότητα σχεδόν FP16 με περίπου 2× απόδοση και μείωση μνήμης 50%, επιτρέποντας σε ένα μοντέλο 70B να χωράει σε έναν μόνο κόμβο SXM 8×H100. Το INT4 (μέσω GPTQ ή AWQ) είναι βιώσιμο για εφαρμογές όπου η ελαφρά υποβάθμιση της ποιότητας είναι αποδεκτή με αντάλλαγμα περαιτέρω μείωση του κόστους.
Συνεχής ομαδοποίηση και Προσοχή σελίδας
Η στατική παρτίδα — Αναμονή για να γεμίσει μια σταθερή παρτίδα πριν από την επεξεργασία — οδηγεί σε χρόνο αδράνειας GPU και υψηλή καθυστέρηση ουράς. Η συνεχής παρτίδα (πρωτοποριακή σε VLLM και τώρα τυπική σε όλα τα κύρια πλαίσια συμπερασμάτων) επεξεργάζεται τα αιτήματα παράλληλα, εκδιώκοντας ολοκληρωμένες ακολουθίες και εισάγοντας νέες χωρίς παύση. Σε συνδυασμό με τη μη συνεχόμενη διαχείριση μνήμης KV-cache του PageDattention, αυτή η προσέγγιση επιτυγχάνει 2–4× υψηλότερη χρήση GPU έναντι στατικής παρτίδας στο ίδιο υλικό στον ίδιο όγκο αιτημάτων.
KV-Cache Management — The Memory Math
Η κρυφή μνήμη KV αποθηκεύει κλειδιά προσοχής και τιμές για κάθε διακριτικό στο παράθυρο περιβάλλοντος για να αποφύγει τον εκ νέου υπολογισμό κατά την αποκωδικοποίηση. Απαίτηση μνήμης ανά αίτημα:
kv-cache bytes = 2 × num_layers × num_heads × head_dim × sequence_length × bytes_per_element
για LLAMA-3-70B στο FP16 (2 byte/στοιχείο, 80 επίπεδα, 8 κεφαλές, 128 head_dim) με περιβάλλον 4.096 διακριτικών: ~42 MB ανά ταυτόχρονο αίτημα. Σε 1.000 ταυτόχρονους χρήστες, δηλαδή 42 GB κρυφής μνήμης KV μόνο — πριν από τα βάρη του μοντέλου. Η κβαντοποίηση της κρυφής μνήμης KV σε INT8 μειώνει στο μισό αυτό στα 21 GB, επιτρέποντας περίπου 2× περισσότερους ταυτόχρονους χρήστες στο ίδιο υλικό.
κερδοσκοπική αποκωδικοποίηση
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
τεμαχισμένη προπλήρωση και αποσυναρμολογημένη μερίδα
Για φόρτους εργασίας μεγάλου περιβάλλοντος, το Chunked Prefill διακόπτει μια μεγάλη προτροπή σε μικρότερα κομμάτια που επεξεργάζονται διαδοχικά, επιτρέποντας στο στάδιο αποκωδικοποίησης να παρεμβάλλει διακριτικά από τα υπάρχοντα αιτήματα κατά τη διάρκεια των κενών προπλήρωσης. Η κατανεμημένη μερίδα το προχωρά περαιτέρω εκτελώντας την προπλήρωση και την αποκωδικοποίηση σε ξεχωριστές ομάδες GPU — Prefill σε υλικό βελτιστοποιημένο για υπολογισμούς (H100 SXM), αποκωδικοποίηση σε βελτιστοποιημένο υλικό εύρους ζώνης (H200) — επιτυγχάνοντας καλύτερη χρήση πόρων και χαμηλότερο λανθάνοντα χρόνο P99 ταυτόχρονα.
Πλαίσια εξυπηρέτησης συμπερασμάτων AI — Σύγκριση κατά μέτωπο
Το πλαίσιο εξυπηρέτησης που επιλέγετε είναι εξίσου σημαντικό με το υλικό. Το καθένα έχει διαφορετικά πλεονεκτήματα, περιορισμούς και λειτουργική πολυπλοκότητα:
| Σκελετός | απόδοση (σχετική) | ευκολία εγκατάστασης | Υποστήριξη GPU | Βασική δύναμη | Άδεια |
| VLLM 0,5+ | Υψηλό (1,0× γραμμή βάσης) | Εύκολη (Εγκατάσταση PIP) | NVIDIA, AMD ROCM | Συνεχής παρτίδα, μεγαλύτερη κοινότητα, API συμβατό με το OpenAI | Apache 2.0 |
| tensorrt-llm | Υψηλότερο (1,3–1,6×) | Σύνθετο (Συλλογή κινητήρα) | Μόνο NVIDIA | Μέγιστη απόδοση NVIDIA, παρτίδα κατά την πτήση, FP8/FP4 | Apache 2.0 |
| TGI (αγκαλιά πρόσωπο) | Μέσο (0,85×) | Εύκολο | Nvidia, AMD, Gaudi | Hugging Face Model Hub Integration, ευρεία υποστήριξη μοντέλου | Apache 2.0 |
| μαστίγωμα | Υψηλό (1,1–1,2×) | Μέσον | NVIDIA, AMD | Προσωρινή αποθήκευση προθέματος, ριζοσπαστικοποίηση, απόδοση δομημένης εξόδου | Apache 2.0 |
| λάμα.cpp | Χαμηλό (CPU βιώσιμο) | Πολύ εύκολο | CPU, cuda, metal, vulkan | Συμπέρασμα CPU/EDGE, ελάχιστες εξαρτήσεις, ευρεία κβαντοποίηση | γούστο |
| Nvidia Triton | ποικίλλει (περιτύλιγμα) | Συγκρότημα | nvidia (κυρίως) | Εξυπηρέτηση πολλαπλών μοντέλων, πλαίσιο-αγνωστικό backend, εταιρικά MLOP | BSD 3-ρήτρα |
Ασφάλεια, απόρρητο και συμμόρφωση για συμπεράσματα τεχνητής νοημοσύνης
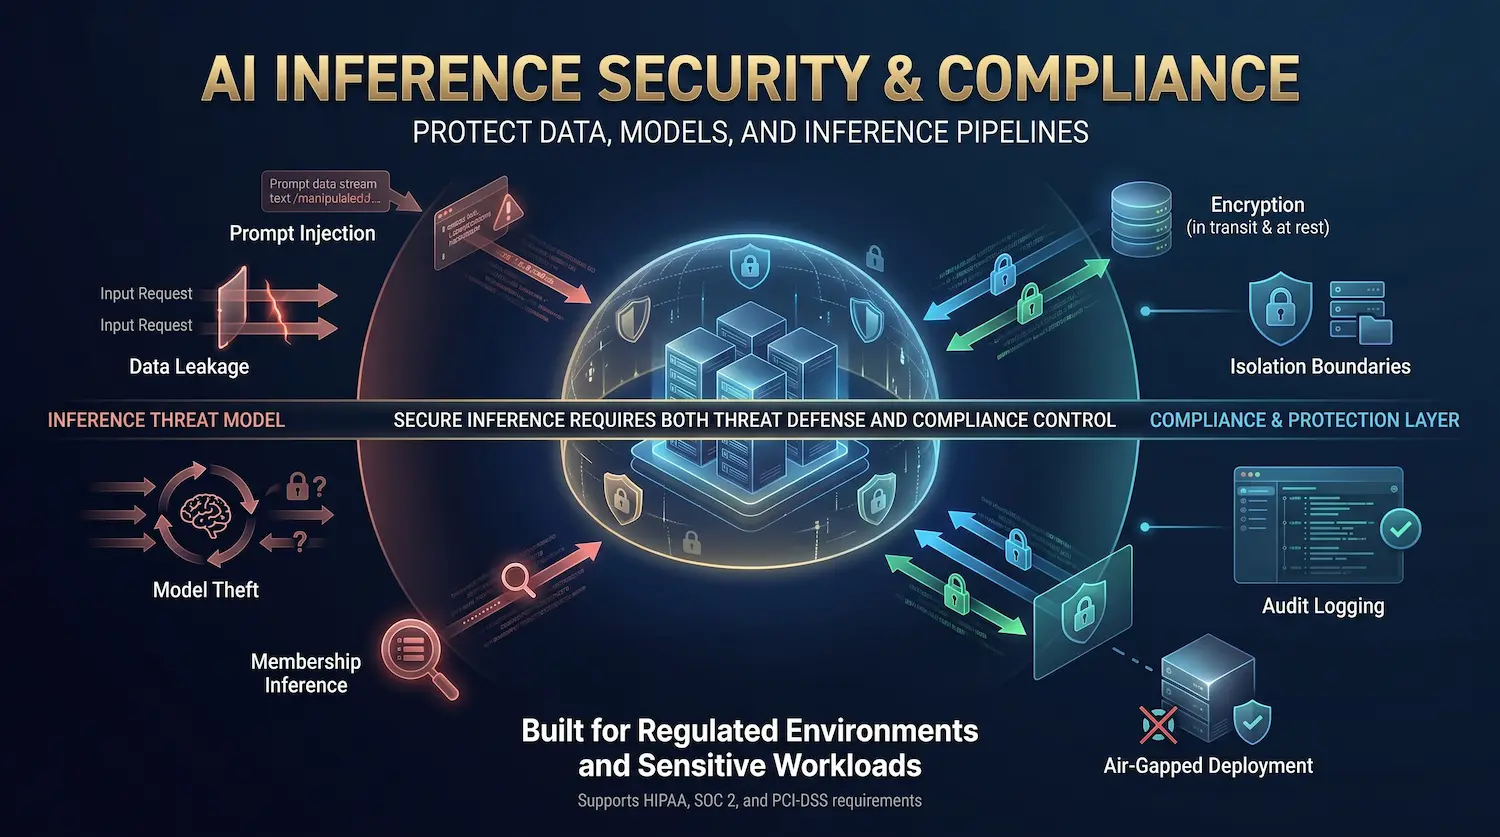
Η εκτέλεση συμπερασμάτων τεχνητής νοημοσύνης σε ρυθμιζόμενες βιομηχανίες ή με ευαίσθητα δεδομένα απαιτεί την κατανόηση του μοντέλου πλήρους απειλής και της στάσης συμμόρφωσης.
μοντέλο απειλής ασφάλειας συμπερασμάτων
- Άμεση έγχυση: Κακόβουλες εισόδους που είναι ενσωματωμένες σε δεδομένα χρήστη Προσπαθήστε να παρακάμψετε τις οδηγίες του συστήματος ή να εξαγάγετε δεδομένα εκπαίδευσης.
- Διαρροή δεδομένων: Ευαίσθητες πληροφορίες από το αίτημα ενός χρήστη διαρρέουν στην απάντηση ενός άλλου χρήστη μέσω διασταυρούμενης μόλυνσης της κρυφής μνήμης KV (μετριάζεται από την απομόνωση της κρυφής μνήμης ανά χρήστη).
- Κλοπή μοντέλου: Επαναλαμβανόμενα αντίθετα ερωτήματα προσπαθούν να ανακατασκευάσουν τα βάρη του μοντέλου μέσω ανάλυσης εξόδου.
- Συμπέρασμα ιδιότητας μέλους: Οι εισβολείς καθορίζουν εάν εμφανίζονται συγκεκριμένα δεδομένα στο εκπαιδευτικό σύνολο του μοντέλου.
πλαίσια συμμόρφωσης
Για συμπέρασμα τεχνητής νοημοσύνης συμβατό με το HIPAA: Όλα τα δεδομένα πρέπει να παραμένουν εντός των ορίων ελέγχου σας, η κρυπτογράφηση κατά τη μεταφορά (TLS 1.3) και η κρυπτογράφηση AT-REST (AES-256) είναι υποχρεωτική και η καταγραφή ελέγχου όλων των αιτημάτων συμπερασμάτων πρέπει να διατηρηθεί. Η συμμόρφωση με το SOC 2 Type II απαιτεί ελέγχους ασφαλείας ουδέτερου από τον προμηθευτή και τεκμηριωμένη απόκριση περιστατικών. Τα περιβάλλοντα PCI-DSS θα πρέπει να χρησιμοποιούν διακομιστές συμπερασμάτων με διάκενο αέρα χωρίς σύνδεση στο Διαδίκτυο. Η ανάπτυξη εντός των εγκαταστάσεων — αντί της κοινόχρηστης υποδομής cloud ή API — είναι η μόνη αρχιτεκτονική που ικανοποιεί και τα τρία πλαίσια ταυτόχρονα χωρίς σημαντικά αντισταθμιστικά στοιχεία ελέγχου.
Atal Networks' ειδική υποδομή διακομιστή Υποστηρίζει αναπτύξεις με διάκενο αέρα για ρυθμιζόμενα συμπεράσματα AI. Επικοινωνήστε μαζί μας στο atalnetworks.com to discuss your compliance requirements.
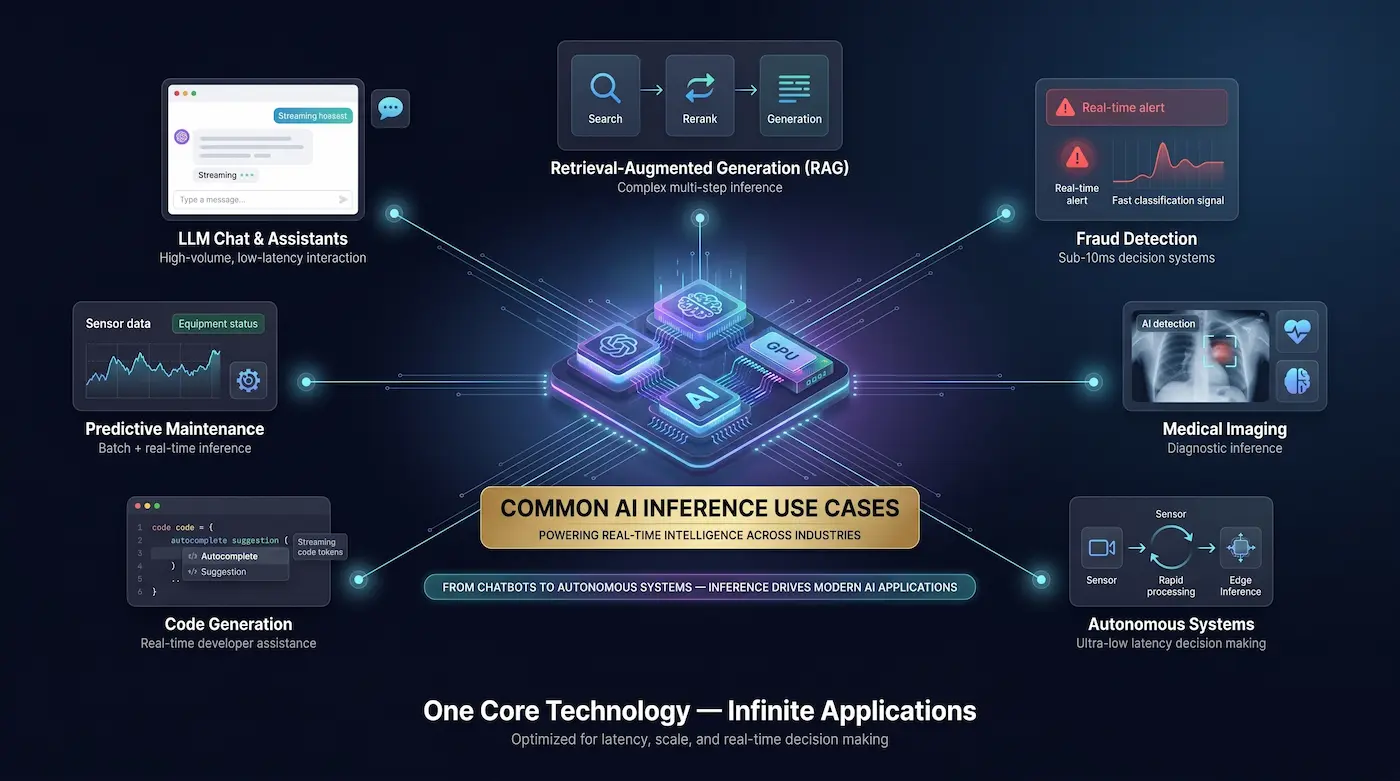
Συνήθεις περιπτώσεις χρήσης συμπερασμάτων AI
Το συμπέρασμα τεχνητής νοημοσύνης δίνει ένα διευρυνόμενο φάσμα εφαρμογών παραγωγής σε κάθε κλάδο:
- Συνομιλία και βοηθοί LLM: ρομπότ εξυπηρέτησης πελατών, εσωτερικοί βοηθοί γνώσης, συγκυβερνήτες κωδικοποίησης — όλα είναι φόρτοι εργασίας συμπερασμάτων υψηλής έντασης και λανθάνουσας κατάστασης.
- Ανάκτηση-Augmented Generation (RAG): Συνδυάζει ένα μοντέλο ενσωμάτωσης (για σημασιολογική αναζήτηση), ένα RANKER και ένα LLM σε έναν αγωγό συμπερασμάτων τριών σταδίων. Κάθε στάδιο προσθέτει καθυστέρηση και κόστος.
- Ανίχνευση απάτης: Συμπέρασμα ταξινόμησης σε πραγματικό χρόνο σε καθυστέρηση κάτω των 10 ms χρησιμοποιώντας μικρότερα εξειδικευμένα μοντέλα.
- Ιατρική απεικόνιση: CNN και συμπέρασμα μετασχηματιστή όρασης για ακτινολογία, παθολογία και διαγνωστικά — συχνά απαιτεί ανάπτυξη on-prem για συμμόρφωση με το HIPAA.
- Αυτόνομα οχήματα: Συμπέρασμα αντίληψης λανθάνοντος χρόνου χιλιοστού δευτερολέπτου σε εξειδικευμένο υλικό επί του οχήματος (ORIN, D5).
- Δημιουργία κώδικα: Το συμπέρασμα ροής για αυτόματη συμπλήρωση απαιτεί εξαιρετικά χαμηλό ITL (< 15 ms) για να αισθάνεστε σε πραγματικό χρόνο.
- Agentic Workflows: Οι πράκτορες κλήσεων εργαλείων πολλαπλών βημάτων δημιουργούν πολλές κλήσεις συμπερασμάτων ανά εργασία χρήστη, πολλαπλασιάζοντας το κόστος 5–20× έναντι των απαντήσεων μίας στροφής.
- Προγνωστική συντήρηση: Συμπεράσματα παρτίδας σε ροές δεδομένων αισθητήρων για την πρόβλεψη αστοχίας εξοπλισμού.
The Future of AI Inference — 2026 και μετά
Αρκετές τάσεις αναδιαμορφώνουν το τοπίο συμπερασμάτων μέχρι το 2026 και το 2027:
- Μοντέλα συλλογιστικής και κλιμάκωση χρόνου δοκιμής: Όπως αποδεικνύεται η σκέψη DeepSeek-R1 και Gemini 2.5, η δημιουργία περισσότερων διακριτικών τη στιγμή του συμπεράσματος βελτιώνει αξιόπιστα την ποιότητα εξόδου σε σύνθετες εργασίες. Αυτό αλλάζει θεμελιωδώς την καμπύλη κόστους — ο λογαριασμός συμπερασμάτων ανά ερώτημα αυξάνεται, δεν συρρικνώνεται.
- Κυριαρχία Mixture-of-Experts (MOE): Οι αρχιτεκτονικές MOE όπως το Mixtral 8x22b ενεργοποιούν μόνο ένα κλάσμα παραμέτρων ανά διακριτικό, παρέχοντας απόδοση κατηγορίας GPT-4 σε 2–3× χαμηλότερο υπολογιστικό κόστος συμπερασμάτων. Αναμένετε ότι το MOE θα κυριαρχήσει στις εκδόσεις νέων μοντέλων.
- Η διαχωρισμένη και κερδοσκοπική υπηρεσία σε κλίμακα: ο διαχωρισμός των ομάδων προπλήρωσης και αποκωδικοποίησης, σε συνδυασμό με κερδοσκοπική αποκωδικοποίηση τύπου Eagle, γίνεται η τυπική αρχιτεκτονική παραγωγής για μεγάλης κλίμακας αναπτύξεις LLM.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- Μοντέλα Frontier On-Device: Τα μοντέλα Apple Intelligence, Gemini Nano και Phi-3-Mini δείχνουν ότι τα κβαντισμένα μοντέλα 3B–7B μπορούν να λειτουργούν εξ ολοκλήρου σε καταναλωτικό υλικό. Το όριο μεταξύ του συμπεράσματος του νέφους και των άκρων είναι ασαφές.
- Κυρίαρχη τεχνητή νοημοσύνη και παραμονή δεδομένων: Οι γεωπολιτικές πιέσεις ωθούν τις επιχειρήσεις και τις κυβερνήσεις να απαιτήσουν πλήρη κυριαρχία δεδομένων — συμπεράσματα εντός των εθνικών τους συνόρων, σχετικά με το υλικό που κατέχουν. Η ζήτηση on-prem θα αυξηθεί, δεν θα συρρικνωθεί.
Συχνές ερωτήσεις (FAQ)
Τι είναι το συμπέρασμα AI με απλά λόγια;
Το συμπέρασμα τεχνητής νοημοσύνης είναι όταν ένα εκπαιδευμένο μοντέλο τεχνητής νοημοσύνης χρησιμοποιεί αυτό που έχει μάθει για να απαντήσει σε μια νέα ερώτηση ή να ολοκληρώσει μια νέα εργασία. Η εκπαίδευση διδάσκει το μοντέλο. Το συμπέρασμα είναι το μοντέλο που κάνει τη δουλειά του. Κάθε φορά που λαμβάνετε απάντηση από το ChatGPT, λαμβάνετε μια σύσταση προϊόντος ή βλέπετε μια ειδοποίηση απάτης, δηλαδή το συμπέρασμα τεχνητής νοημοσύνης που συμβαίνει σε πραγματικό χρόνο.
Ποια είναι η διαφορά μεταξύ συμπερασμάτων τεχνητής νοημοσύνης και εκπαίδευσης AI;
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
Είναι το ChatGPT συμπέρασμα ή εκπαίδευση;
Όταν συνομιλείτε με το ChatGPT, ενεργοποιείτε συμπεράσματα — τα βάρη του μοντέλου είναι σταθερά και τα εφαρμόζει στη συμβολή σας για να δημιουργήσετε μια απάντηση. Η OpenAI εκπαιδεύει (και εκπαιδεύει περιοδικά) το GPT-4 ξεχωριστά, σε τεράστια σύνολα δεδομένων, με τεράστιο κόστος. Αυτές είναι δύο εντελώς διαφορετικές λειτουργίες. Αυτό που βιώνετε ως χρήστης είναι το συμπέρασμα 100%.
Ποιο υλικό χρησιμοποιείται για συμπεράσματα τεχνητής νοημοσύνης;
Το κυρίαρχο υλικό για συμπεράσματα μεγάλης κλίμακας είναι τα NVIDIA GPU (H100, H200, B200, L40S), AMD GPU (MI300X, MI355X) και Google TPU για φόρτους εργασίας εγγενούς στο cloud. Για συμπεράσματα άκρων: Apple Neural Engine, Qualcomm Hexagon NPU και Nvidia Jetson Orin. Για αναπτύξεις με ευαισθησία στο κόστος ή μόνο για CPU, οι σύγχρονοι επεξεργαστές Intel Xeon (AMX) και AMD EPYC μπορούν να εκτελούν κβαντισμένα μοντέλα με αποδεκτή απόδοση.
Ποια είναι η καλύτερη GPU για συμπέρασμα τεχνητής νοημοσύνης το 2026;
Για μεγάλα μοντέλα (70B+): το NVIDIA H200 SXM5 (141 GB HBM3E, 4,8 TB/s) προσφέρει την καλύτερη απόδοση ανά δολάριο για τους περισσότερους φόρτους εργασίας. Για μέγιστη απόδοση σε μοντέλα Frontier: Τα καλώδια B200 SXM6. Για ευαίσθητα στο κόστος μεσαίου εύρους: Το AMD MI300X (192 GB HBM3, $10K–$15K χαμηλότερο από το H200) είναι όλο και πιο ανταγωνιστικό. Για συμπέρασμα άκρων/μονής GPU: Το NVIDIA L40S (48 GB GDDR6) εξισορροπεί καλά το κόστος και την ικανότητα.
Πώς λειτουργεί το συμπέρασμα LLM βήμα προς βήμα;
- Tokenization: Το κείμενο εισόδου μετατρέπεται σε ακέραια αναγνωριστικά διακριτικών. 2. Prefill: Όλα τα διακριτικά εισόδου υποβάλλονται σε επεξεργασία ταυτόχρονα σε ένα πέρασμα προς τα εμπρός, δημιουργώντας το KV-cache και το πρώτο διακριτικό εξόδου. 3. Αποκωδικοποίηση: Τα νέα διακριτικά δημιουργούνται ένα κάθε φορά, καθένα από τα οποία παρακολουθεί την πλήρη κρυφή μνήμη KV. 4. Συνεχής παρτίδα: Πολλαπλά ταυτόχρονα αιτήματα μοιράζονται υπολογισμό GPU μέσω παρτίδας κατά την πτήση. 5. Ροή: Τα διακριτικά εξόδου αποκαθίστανται και μεταδίδονται στον πελάτη καθώς δημιουργούνται.
Τι είναι το TTFT και το ITL στο συμπέρασμα LLM;
Το TTFT (χρόνος έως το πρώτο διακριτικό) μετρά πόσο χρόνο από την υποβολή αιτήματος μέχρι να επιστραφεί το πρώτο διακριτικό εξόδου — η καθυστέρηση που ο χρήστης αντιλαμβάνεται ως "χρόνος αναμονής". Κυριαρχείται από το στάδιο της προπλήρωσης. Το ITL (Inter-Token Latency) μετρά τον μέσο χρόνο μεταξύ των διαδοχικών διακριτικών εξόδου κατά την αποκωδικοποίηση — τι καθορίζει την «ταχύτητα ροής» που βλέπει ο χρήστης. Και τα δύο πρέπει να βελτιστοποιηθούν για συνομιλία σε πραγματικό χρόνο: συνήθως TTFT < 200ms και ITL < 30ms για μια εμπειρία απόκρισης.
Τι είναι η κρυφή μνήμη KV και γιατί έχει σημασία;
Η κρυφή μνήμη KV (κλειδί-τιμή κρυφής μνήμης) αποθηκεύει τους υπολογισμούς ενδιάμεσης προσοχής (κλειδιά και τιμές) για κάθε διακριτικό στο πλαίσιο συνομιλίας. Χωρίς αυτό, το μοντέλο θα έπρεπε να επεξεργαστεί ξανά ολόκληρο το παράθυρο περιβάλλοντος για κάθε νέο διακριτικό — Υπολογισμός O(n²). Με αυτό, κάθε βήμα αποκωδικοποίησης επεξεργάζεται μόνο ένα νέο διακριτικό, καθιστώντας εφικτό το συμπέρασμα LLM. Το μέγεθος της κρυφής μνήμης KV είναι ένας πρωταρχικός περιορισμός για το πόσους ταυτόχρονους χρήστες μπορεί να εξυπηρετήσει μια GPU και πόσο μεγάλο μπορεί να είναι το παράθυρο περιβάλλοντος.
Πόσο κοστίζει το συμπέρασμα τεχνητής νοημοσύνης ανά 1 εκατομμύριο μάρκες;
Σε αυτο-φιλοξενούμενο υλικό (8×H200, απόσβεση 3 ετών, $0.12/kWh, 80% Utilization, LLAMA-3-70B FP8): περίπου $0.18 ανά κουπόνια εισόδου 1M και $0.71 ανά 1M διακριτικά εξόδου. Μέσω δημόσιου API: Το GPT-4O κοστίζει $2.50/$10.00 Εισαγωγή/Έξοδος ανά 1M Tokens. Το σονέτο Claude κοστίζει $3,00/$15,00. Η αυτο-φιλοξενία σε κλίμακα προσφέρει μείωση κόστους 5–20×, με το νεκρό σημείο να είναι συνήθως στα 5–15 εκατομμύρια μάρκες εξόδου/ημέρα ανάλογα με τον πάροχο και το μοντέλο API.
Μπορείτε να εκτελέσετε συμπεράσματα AI σε μια CPU;
Ναι — για μικρότερα, κβαντισμένα μοντέλα. Το llama.cpp ενεργοποιεί το συμπέρασμα INT4/INT8 σε οποιαδήποτε CPU x86. Ένα Xeon Platinum διπλής υποδοχής με AMX παράγει ~25–40 μάρκες/δευτερόλεπτο σε ένα μοντέλο 7b Int4, το οποίο είναι επαρκές για φόρτους εργασίας εκτός σε πραγματικό χρόνο. Το συμπέρασμα της CPU δεν είναι βιώσιμο για μοντέλα 70B+ κατά την απόδοση παραγωγής. Η οικονομική εργασία για εργασίες ανάπτυξης, δοκιμών και λανθάνουσας παρτίδας όπου το κόστος ενοικίασης GPU υπερβαίνει την αξία της απόδοσης.
Ποια είναι η διαφορά μεταξύ προπλήρωσης και αποκωδικοποίησης στο συμπέρασμα LLM;
Η προπλήρωση επεξεργάζεται ολόκληρη την προτροπή εισόδου σε μία παράλληλη λειτουργία (υπολογισμένη, γρήγορη, ζυγαριά με μήκος προτροπής). Το Decode δημιουργεί διακριτικά εξόδου ένα κάθε φορά σε έναν αυτοπαλινδρομικό βρόχο (δεσμευμένο εύρος ζώνης μνήμης, πιο αργό ανά διακριτικό, κλίμακες με μήκος εξόδου και ταυτόχρονους χρήστες). Η μετάβαση μεταξύ τους - όταν δημιουργείται το πρώτο διακριτικό - είναι TTFT. Η βελτιστοποίηση της προπλήρωσης μειώνει το TTFT. Η βελτιστοποίηση της αποκωδικοποίησης μειώνει το ITL και βελτιώνει την απόδοση.
Πότε πρέπει να κάνετε αυτο-φιλοξενούμενο συμπέρασμα AI έναντι χρήσης API;
Χρησιμοποιήστε ένα API όταν: Ο όγκος είναι χαμηλός (< 2M tokens/ημέρα), χρειάζεστε ένα κλειστό μοντέλο Frontier (GPT-4O, Claude), ή κάνετε πρωτότυπο και θέλετε μηδενικό capex. Self-Host Όταν: Ο όγκος υπερβαίνει τα 5 εκατομμύρια μάρκες/ημέρα, το απόρρητο ή η συμμόρφωση δεδομένων το απαιτεί, θέλετε να τελειοποιήσετε ή να ελέγξετε το μοντέλο ή χρειάζεστε εγγυημένη SLA χωρίς όρια ρυθμού. Το νεκρό σημείο σε σχέση με τα περισσότερα API είναι 3–18 μήνες ανάλογα με το μοντέλο και τον όγκο, μετά τον οποίο το On-Prem συγκρίνεται ευνοϊκά για χρόνια.
Δημιουργία ή Αγορά — Επόμενα βήματα με το Atal Networks
Εάν έχετε φτάσει σε αυτό το σημείο, έχετε μια πλήρη εικόνα του τι είναι το συμπέρασμα τεχνητής νοημοσύνης, πώς λειτουργεί, τι κοστίζει και ποιο υλικό το τροφοδοτεί. Το επόμενο ερώτημα είναι η εκτέλεση.
Το Atal Networks ειδικεύεται σε ειδικά σχεδιασμένες υποδομές συμπερασμάτων AI για επιχειρήσεις που έχουν ξεπεράσει την εξάρτηση από το API. Η ομάδα μας έχει σχεδιάσει και αναπτύξει συμπλέγματα GPU σε τομείς υγειονομικής περίθαλψης, χρηματοοικονομικών υπηρεσιών, κατασκευής και λογισμικού — και δημοσιεύουμε τα δεδομένα αναφοράς, όχι μόνο το φυλλάδιο.
Εξερευνήστε μας διαμορφώσεις αποκλειστικού διακομιστή Για αναπτύξεις συμπερασμάτων υψηλής απόδοσης, on-prem με συστήματα H100, H200 και MI300x.
Ψάχνετε για σημείο εισόδου χαμηλότερου κεφαλαίου; Μας Σχέδια VPS βελτιστοποιημένα για GPU Επιτρέψτε σας να αρχίσετε να εκτελείτε φόρτους εργασίας ιδιωτικών συμπερασμάτων σήμερα χωρίς να έχετε το rack.
Ready to talk numbers? Επίσκεψη atalnetworks.com Και μιλήστε απευθείας με έναν μηχανικό υλικού — όχι ένα σενάριο πωλήσεων.
