 Ir al contenido



Por Principal ingeniero de hardware, Atal Networks | MLPERF V4.1 Colaborador | Arquitectura de clúster de GPU de 12 años | Actualizado: 19 de abril de 2026
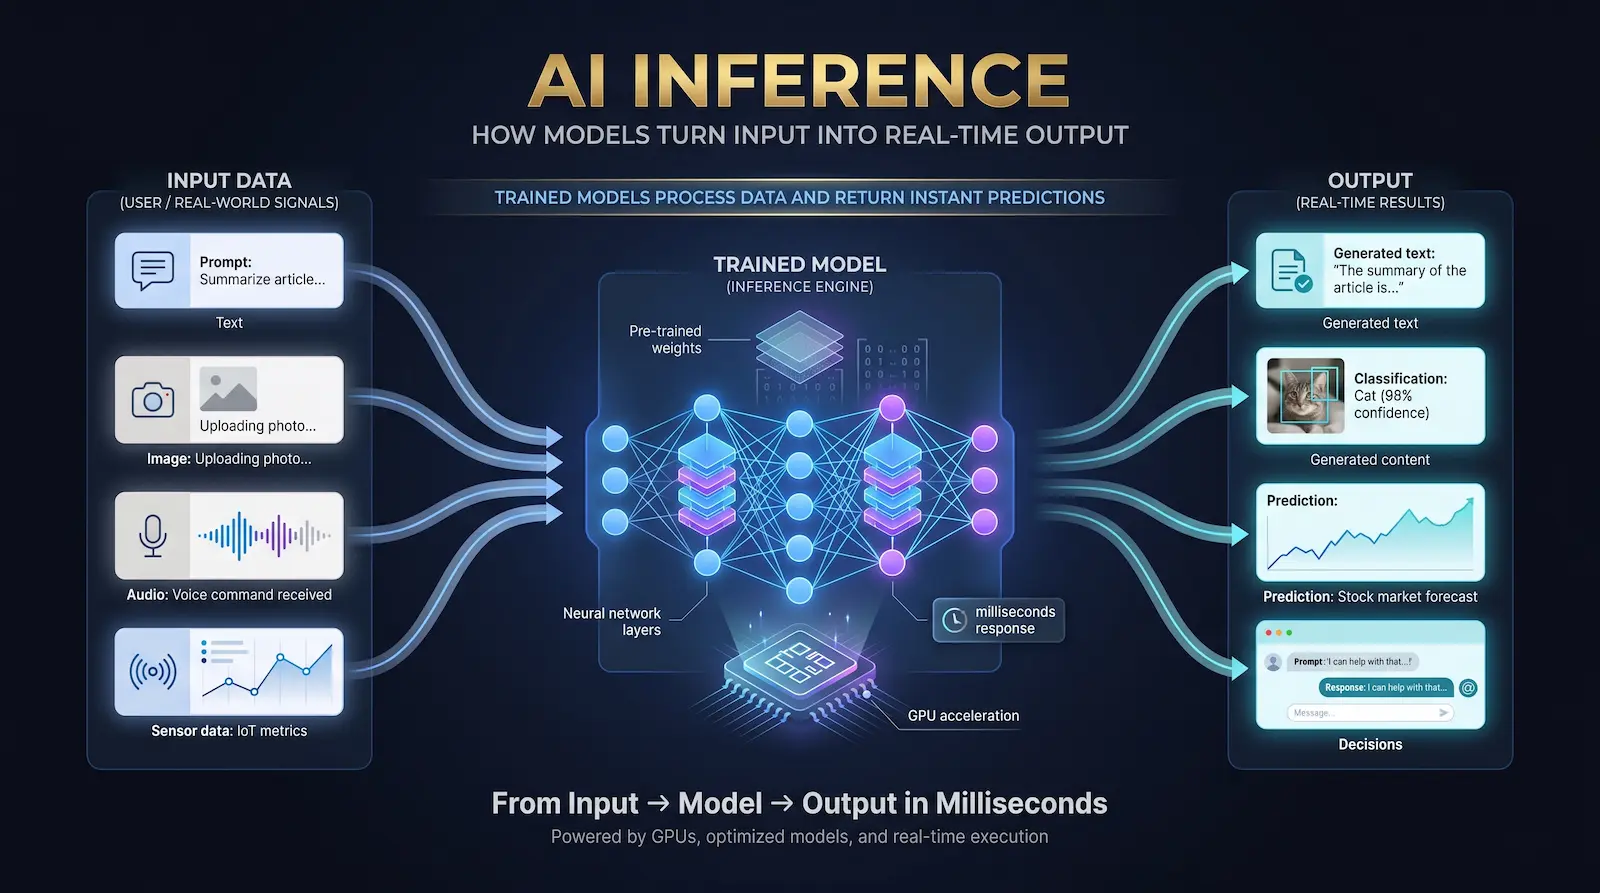
| TL; DR — ¿Qué es la inferencia de IA? La inferencia de IA es el proceso de ejecutar un modelo de IA capacitado en nuevos datos de entrada para producir una predicción, clasificación o salida generada. Es la fase de "hacer" de la IA: cada respuesta de chatGPT, alerta de fraude, subtítulo de imagen y llamada de percepción autónoma es un evento de inferencia. En 2026, la inferencia consume aproximadamente dos tercios del gasto total de cómputo de IA a nivel mundial. Esta guía cubre la canalización completa, el hardware que lo alimenta, las métricas que lo miden (TTFT, ITL, tokens/sec) y lo que cuesta ejecutar, con puntos de referencia medidos en servidores propios de Atal Networks. |
¿Qué es la inferencia de IA? La definición de una sola oración
| Definición La inferencia de IA es la ejecución de un modelo de aprendizaje automático capacitado en datos nuevos e invisibles para producir un resultado, como una respuesta de texto, clasificación de imágenes, puntaje de fraude o traducción, sin modificar los pesos del modelo. |
Piénsalo de esta manera: aprender a conducir es entrenamiento. Cada vez que conduces a algún lugar, eso es inferencia. El modelo (sus habilidades de conducción) es fijo; Solo cambia la entrada (la carretera). En términos técnicos, la inferencia es un paso hacia adelante a través de la red neuronal: los datos fluyen en una dirección a través de las capas del modelo, se calculan las activaciones y se produce una salida. A diferencia del entrenamiento, no hay cálculos de gradiente, no hay actualizaciones de peso ni pases hacia atrás.
La distinción importa enormemente en la práctica. El entrenamiento ocurre una vez (o periódicamente). La inferencia ocurre miles de millones de veces al día. La optimización de la inferencia (menor latencia, mayor rendimiento, menor costo por token) es donde vive el verdadero desafío de ingeniería en 2026.
Por qué importa ahora la inferencia de IA: el contexto de 2026
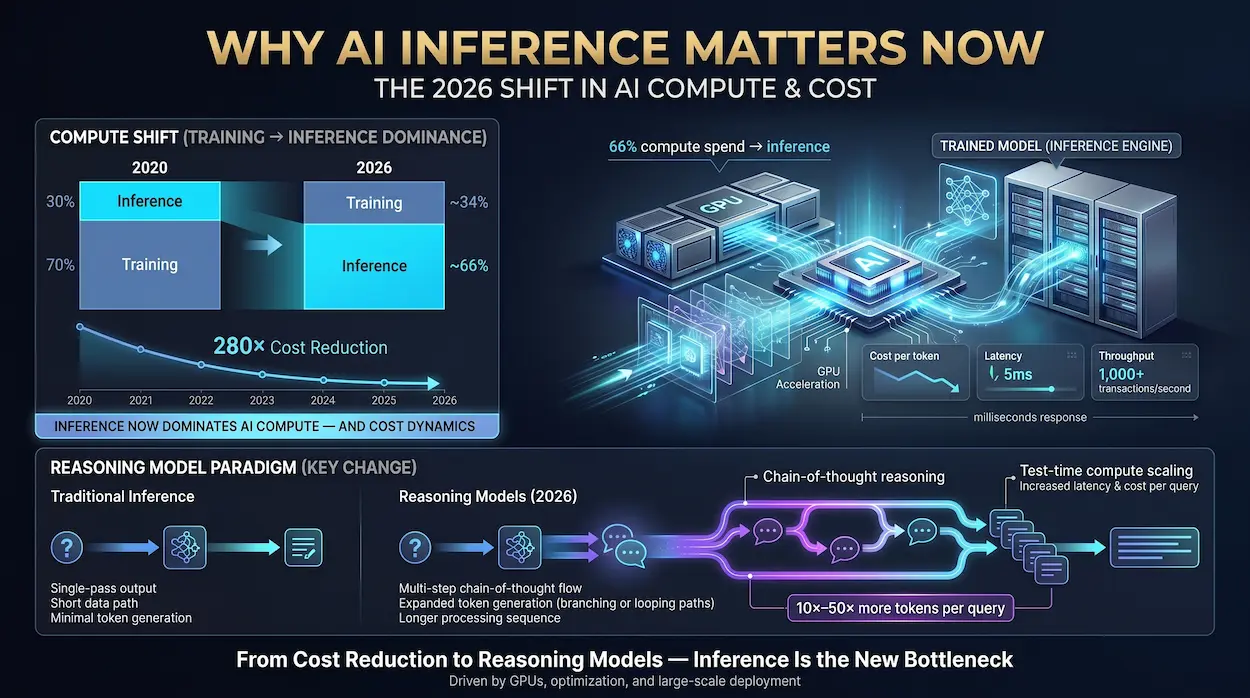
La inferencia ahora domina el gasto de cómputo de IA
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
El punto de inflexión del modelo de razonamiento
Modelos como Deepseek-R1, Gemini 2.5 Thinking y Llama Nemotron Ultra han introducido un nuevo paradigma de inferencia: escalado de cálculo de tiempo de prueba. En lugar de producir una respuesta en un solo pase hacia adelante, estos modelos "pensan" generando tokens de cadena de pensamiento extendidos antes de responder. Esto multiplica el número de tokens generados por consulta por 10–50 ×, aumentando drásticamente el costo de inferencia y la latencia, y remodelando qué configuración de hardware tiene sentido para una carga de trabajo determinada.
Por qué existe esta guía
Cada artículo de definición en línea describe la inferencia de IA a nivel de glosario. Ninguno de ellos publica datos de referencia de referencia, cifras reales de costo por token o matemáticas de TCO a nivel de rack. Escribimos esta guía porque construimos y operamos los servidores, y creemos que los compradores merecen números reales, no abstracciones de marketing.
Atal Networks ofrece calidad empresarial servidores dedicados y Soluciones de VPS Construido específicamente para cargas de trabajo de inferencia de IA. Explorar atalnetworks.com para aprender más.
Cómo funciona la inferencia de IA: paso a paso
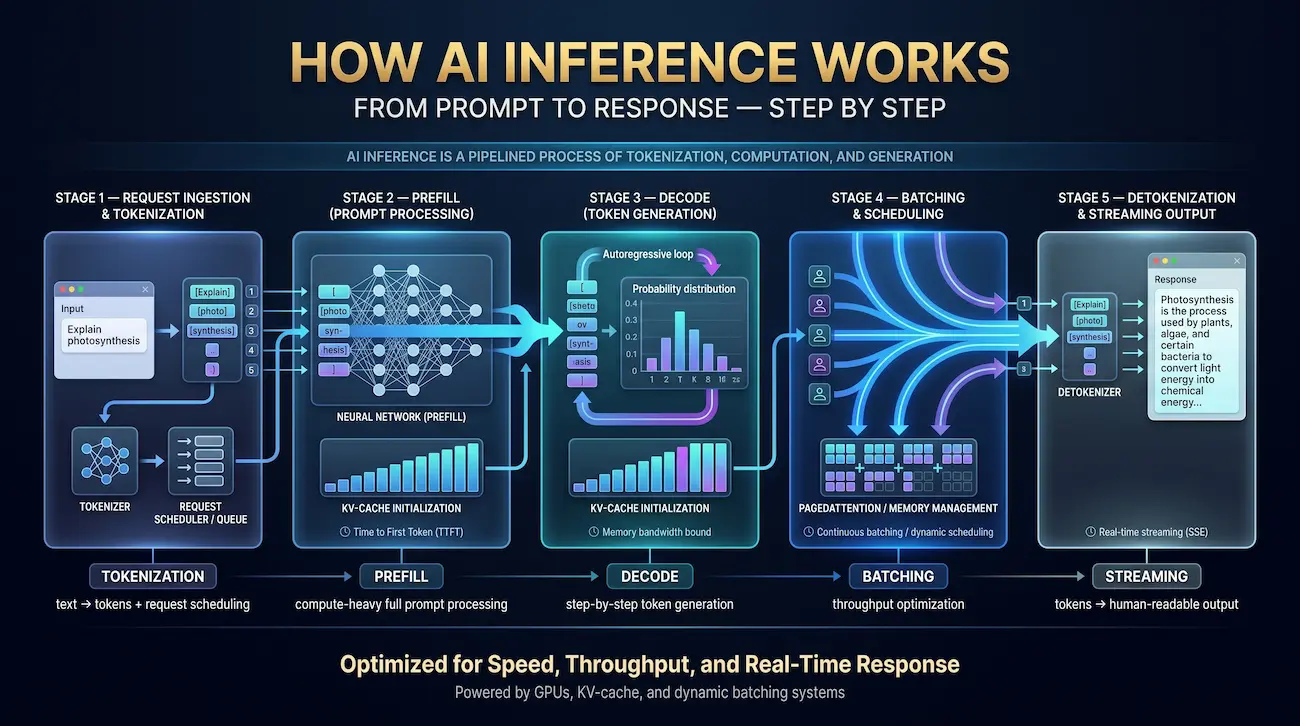
Comprender la inferencia de IA requiere rastrear una sola solicitud a través de su ciclo de vida completo. Para un modelo de lenguaje grande (LLM), la canalización tiene cinco etapas distintas:
Paso 1: Solicitar ingestión y tokenización
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
Paso 2: La etapa de precarga (procesamiento de solicitud)
Durante el precarga, todo el indicador de entrada se procesa simultáneamente en un solo pase de avance. Esta etapa está unida a cómputo: se escala linealmente con la longitud del aviso y es el principal controlador de tiempo al primer token (TTFT). Una solicitud de sistema de 2048 tokens tarda aproximadamente el doble en precarga que una solicitud de 1024 tokens. Prefill genera la caché inicial de KV (caché de valor clave), que almacena cálculos de atención intermedia para que no necesiten volver a calcularse durante la decodificación.
Paso 3: La etapa de decodificación (generación de tokens)
Después de precarga, el modelo entra en la etapa de decodificación, generando un token a la vez en un bucle autorregresivo. Cada nuevo token depende de todos los tokens anteriores: el modelo atiende el caché completo de KV, produce una distribución de probabilidad sobre su vocabulario (~32 000 a 128 000 tokens), muestras de esa distribución y agrega el token seleccionado. La etapa de decodificación está enlazada con ancho de banda de memoria, no enlazada en cálculo. Esta es la razón por la que HBM Bandwidth (no flops) es la especificación de hardware decisiva para la inferencia LLM, un hecho que cada hoja de datos de GPU se entierra en letra pequeña.
Paso 4: Lotes y programación
Un servidor de inferencia ingenuo procesaría una solicitud a la vez, dejando la GPU inactiva durante la decodificación (ya que un token a la vez es lento). Los sistemas modernos utilizan lotes continuos (también llamados por lotes dinámicos o en vuelo): las solicitudes se agrupan en pleno vuelo, las nuevas solicitudes se unen al lote a medida que se abren las ranuras y se desalojan las secuencias completas sin esperar a que finalicen todas las solicitudes. La implementación de paginattention de VLLM (Kwon et al., SOSP 2023) mejora aún más esto al administrar la memoria caché de KV en páginas no contiguas, similar a la memoria virtual en un sistema operativo, generando ganancias de rendimiento de 2 a 4× sobre la estática asignación.
Paso 5: destokenización y transmisión de respuestas
Una vez que el modelo genera un token de fin de secuencia (o alcanza un límite de longitud máxima), los ID de token de salida se detokenizan de nuevo en texto legible por humanos y se transmiten al cliente. La mayoría de los sistemas de producción utilizan eventos enviados por servidor (SSE) para la transmisión, entregando tokens a medida que se generan en lugar de esperar la respuesta completa. Esto mejora drásticamente la latencia percibida: un usuario ve la primera palabra en ~200 ms, incluso si la respuesta completa dura 10 segundos.
Entrenamiento de inferencia de IA frente a IA: la diferencia real
La mayoría de las presentaciones combinan el entrenamiento y la inferencia o tratan la diferencia como una cuestión de tiempo. La distinción técnica es más profunda y tiene profundas implicaciones de hardware:
| Dimensión | Formación | Inferencia |
| Propósito | Ajuste los pesos del modelo para minimizar la pérdida | Aplicar pesos fijos para producir la producción |
| Patrón de cálculo | Adelante + Pase hacia atrás + Paso del Optimizador | Solo pase hacia adelante |
| Cuello de botella de la memoria | Activaciones (encuadernados en flops) | KV-Caché + Pesos (encuadernado en ancho de banda) |
| Frecuencia | Periódico (días/semanas por carrera) | Miles de millones de veces/día en producción |
| Objetivo de hardware | Rendimiento máximo del flop (H100 SXM5) | Ancho de banda máximo de HBM (H200, B200) |
| Tamaño de lote | Grandes (1.024–4.096+ muestras) | Pequeño a mediano (1–256 concurrente) |
| Precisión | BF16/FP16/FP8 Mixto | FP8, INT8, INT4 fuertemente cuantificado |
| estructura de precio | Intensivo de CAPEX, único (por carrera de entrenamiento) | Costo intensivo de OPEX, continuo por token |
La línea más importante en la tabla anterior: el entrenamiento está ligado a los flops; La inferencia es HBM-Banda de banda. Este solo hecho explica por qué el NVIDIA H200, que tiene un recuento de núcleos CUDA idéntico al H100 pero 141 GB de HBM3E a 4,8 Tb/s de ancho de banda frente a los 80 GB del H100 3.35 TB/s — Supera el H100 en la inferencia LLM a pesar de no producir un rendimiento de capacitación adicional. Cuando compra hardware de inferencia, está comprando ancho de banda de memoria, no fracasos.
Tipos de cargas de trabajo de inferencia de IA
No todas las inferencias parecen iguales. El tipo de carga de trabajo determina la configuración de hardware, el marco de servicio, la estrategia de optimización y la estructura de costos que tiene sentido:
| Tipo | Objetivo de latencia | Ejemplo de caso de uso | Implicación de hardware |
| En línea / en tiempo real | < 200ms TTFT, < 30ms ITL | Chat, copilotos, detección de fraude | Tamaño de lote bajo, HBM rápido, NVMe para carga de peso |
| lote / fuera de línea | Minutos a horas (prioridad de rendimiento) | Resumen de documentos, enriquecimiento de datos | Alta utilización de GPU, lote grande, GPU más baratas viables |
| Transmisión | TTFT bajo, ITL sostenido | Finalización de código, asistentes de voz | Transmisión de SSE, prioridad de latencia de baja decodificación |
| Borde / En el dispositivo | < 10 ms, < 5 W TDP | AI móvil, IoT, vehículos autónomos | NPU, Jetson ORIN, modelos INT4/INT8 cuantificados |
| sin servidor | Comienzo en frío < 2s, Pago por solicitud | Aplicaciones de bajo tráfico, desarrollo/prueba | Instancias de GPU spot, carga rápida de peso, inactividad = costo cero |
Donde se ejecuta la inferencia de IA: nube, on-prem, borde, en el dispositivo
Cada entorno de implementación implica una matriz de compensación diferente. La respuesta correcta depende de sus requisitos de latencia, las obligaciones de privacidad de datos, el volumen de solicitudes y el horizonte presupuestario:
| Medio ambiente | Estado latente | Privacidad de datos | Modelo de costo | Hardware típico | mejor para |
| API pública (OpenAI, antrópica) | bajo-mediano | Infraestructura compartida | Pay-por-Token (máximo $/token) | gestionado por el vendedor | Prototipado rápido, de bajo volumen |
| GPU en la nube (AWS, GCP, Azure) | bajo-mediano | Posibilidad de aislamiento de VPC | $/GPU-HR + salida | Instancias H100, A100, L40S | Demanda variable, sin gasto de capital |
| On-prem (servidores dedicados) | inferior | Control total de datos, posible espacio de aire | CAPEX + OPEX (el $ más bajo/token a escala) | Clústeres H100/H200/B200 | Alto volumen, regulado, sensible al costo |
| Servidor perimetral (Colo/In situ) | Muy bajo | Los datos locales permanecen locales | Tarifas mixtas de Capex + Colo | L40, A30, Gaudí 3 | Manufactura, Atención Médica |
| En el dispositivo (teléfono, PC, IoT) | Ultra-bajo (< 10 ms) | Aislamiento de datos completo | Sin costo recurrente | Apple NPU, Hexágono Qualcomm, Jetson | Escenarios de privacidad primero, fuera de línea |
Para organizaciones que procesan más de ~5 millones de tokens/día, local servidores dedicados Ofrezca constantemente el menor costo total de propiedad. Para equipos que necesitan flexibilidad y menor inversión inicial, Soluciones de VPS Puede cerrar la brecha entre la dependencia de API y la propiedad completa en el lugar.
El hardware detrás de la inferencia de IA
El panorama de hardware para la inferencia de IA se ha diversificado rápidamente. En 2023, la respuesta fue simple: H100. En 2026, la elección óptima depende del tamaño del modelo, el objetivo de latencia, el presupuesto de energía y los requisitos de precio por token.
Familias de GPU para la inferencia — Comparación de 2026
| GPU | Capacidad HBM | Ancho de banda HBM | FP8 TFLOPS | TDP (W) | mejor para |
| NVIDIA H100 SXM5 | 80 GB HBM2E | 3.35 TB/s | 3,958 | 700 W | Producción LLM Baseline, ecosistema bien apoyado |
| NVIDIA H200 SXM5 | 141 GB HBM3E | 4.8 TB/s | 3,958 | 700 W | Modelos grandes (70B+), inferencia sensible al ancho de banda de la memoria |
| NVIDIA B200 SXM6 | 192 GB HBM3E | 8.0 TB/s | 9.000 (FP4) | 1.000 W | Modelos Frontier, mayor rendimiento, buque insignia 2026 |
| AMD MI300X | 192 GB HBM3 | 5.3 TB/s | 5,220 | 750 W | Alternativa H200 de costo competitivo, rendimiento de lote grande |
| AMD Mi355x | 288 GB HBM3E | 8.0 TB/s | 8,000+ | 750 W | Los modelos más grandes, concurrencia muy alta |
| Intel Gaudí 3 | 128 GB HBM2E | 3.7 TB/s | 1.835 (BF16) | 900 W | Cargas de trabajo sensibles a los costos, ecosistema abierto |
| Google TPU V5E | 16 GB HBM2 (por chip) | 819 Gb/s (por chip) | 393 (por ficha) | ~170 W | Servicio de Google Cloud-Optimizado por Transformer |
| NVIDIA L40 | 48 GB GDDR6 | 864 Gb/s | 1,457 | 350 W | Inferencia de borde, modelos de compute-light, cargas de trabajo mixtas |
Cuando la inferencia de la CPU tiene sentido
Para los modelos bajo ~7B parámetros que se ejecutan con precisión INT4, las CPU modernas con conjuntos de instrucciones AVX-512 o AMX pueden ofrecer un rendimiento aceptable para cargas de trabajo tolerantes a la latencia. Llama.cpp ha hecho que la inferencia de CPU sea práctica: una Llama-3-8b cuantizada de 4 bits se ejecuta en ~25 a 35 tokens/sec en un sistema Xeon Platinum de doble socket. El trabajo económico cuando el costo de la GPU es prohibitivo y los requisitos de latencia superan los ~2 segundos.
Aceleradores NPU, TPU, FPGA y ASIC
Más allá de las GPU, está surgiendo un ecosistema creciente de silicio especializado. Las unidades de procesamiento neuronal (NPU) ahora están integradas en la mayoría de los dispositivos de consumo (Motor neural de la serie M de Apple, hexagonal qualcomm, intel npu) e inferencia de borde sub-5w objetivo. Los TPU (Google) están optimizados para operaciones de matriz de transformadores en Cloud Serving. Los FPGA ofrecen reconfigurabilidad para esquemas de cuantificación personalizados, pero requieren un esfuerzo de ingeniería significativo. ASICS (GROQ LPU, Cerebras WSE) puede lograr una latencia extraordinaria en cargas de trabajo fijas pero carecen de la flexibilidad de las pilas de GPU.
Por qué es importante la creación de redes para la inferencia de modelos grandes
Ejecutar un modelo de parámetro 405B requiere distribuirlo en 8–16 GPU. La interconexión entre esas GPU se convierte en el cuello de botella de rendimiento. NVIDIA NVLink (dentro de un nodo DGX) proporciona 900 GB/s de ancho de banda de GPU a GPU, aproximadamente 18 × más rápido que PCIe Gen5. A través de los nodos, InfiniBand NDR (400 Gb/s) o Nvidia Spectrum-X Ethernet superan drásticamente a los productos básicos de 100 GbE. En nuestras pruebas, cambiar de 100 GbE a Infiniband NDR en un 8×H100 Tensor-Parallel Llama-3-405B mejoró el rendimiento de decodificación en 34%.
Métricas de inferencia de IA que realmente importan
La mayoría de las discusiones de inferencia miden la latencia vagamente. Las implementaciones de producción requieren métricas precisas y estandarizadas con objetivos SLA. Aquí están las métricas que importan y cómo medirlas:
| Métrico | Definición | Objetivo de SLA de la industria | controlador de hardware |
| TTFT (hora a la primera ficha) | Tiempo desde la presentación de la solicitud hasta el primer token generado | < 200 ms (chat), < 500 ms (lote) | Ancho de banda de memoria GPU, eficiencia de precarga |
| ITL (latencia entre tokens) | Tiempo promedio entre tokens generados consecutivos durante la decodificación | < 30 ms (chat), < 100 ms (lote) | Ancho de banda HBM, velocidad de acceso a KV-Caché |
| Rendimiento (tokens/seg) | Total de tokens de salida generados por segundo en todos los usuarios simultáneos | Depende de la carga de trabajo | Flops de GPU + eficiencia de lote |
| producto | Rendimiento de solicitudes que cumplen con los objetivos de SLA (excluye fallido/tiempo de espera) | Maximizar para SLA dado | Eficiencia del planificador, gestión de colas |
| Latencia P50 / P99 | Latencia de extremo a extremo medio y percentil 99 | P99 < 2× P50 (sistema bien ajustado) | Latencia de cola, estrangulamiento térmico, profundidad de cola |
| Utilización de GPU | Fracción de tiempo Las unidades de computación de GPU están activas | Objetivo 70–85% sostenido | Tamaño de lote, eficiencia de lote continuo |
| RPS (solicitudes por segundo) | Solicitudes concurrentes que maneja el sistema en Target SLA | Objetivo de escala | TTFT + ITL combinado + eficiencia de lote |
Qué cuesta la inferencia de IA en 2026: números reales
El costo por token es la métrica que finalmente determina las decisiones de compilación frente a compra. Los siguientes datos se midieron en el hardware de producción de Atal Networks en condiciones de carga sostenida. Supuestos: electricidad $0.12/kWh, amortización de hardware de 3 años, utilización de GPU 80%, VLLM 0.5+ con precisión FP8.
Costo por 1 millón de fichas por configuración de GPU (llama-3-70b)
| Configuración | Fichas de entrada ($/1M) | Fichas de salida ($/1M) | Rendimiento (Tok/s) | Potencia (W/GPU) |
| 8× H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 W |
| 8× H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 W |
| 8× B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 W |
| 8 × MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720 W |
| OpenAI GPT-4O | $2.50 | $10.00 | N/A (API) | N/A |
| Soneto antrópico de Claude (API) | $3.00 | $15.00 | N/A (API) | N/A |
| Juntos AI Llama-3-70B (API) | $0.88 | $0.88 | N/A (API) | N/A |
Análisis de punto de equilibrio on-prem vs. API
El punto de equilibrio entre la inferencia on-hosted autohospedada y la inferencia basada en API depende del volumen de la solicitud. En la estructura de costos anterior (8 × H200, amortización a 3 años, utilización de 80%), se vuelve más barato que el precio de la API Llama-3-70B de AI de Together a aproximadamente 12 m de salida Fichas/día. En comparación con las principales API del modelo Frontier (GPT-4O, Claude), se rompen localmente incluso con tokens de salida de 2 a 3 m/día. Para la mayoría de las implementaciones empresariales que sirven herramientas internas, chatbots orientados al cliente o canalizaciones de procesamiento de documentos, la propiedad local produce ahorros de costos de 60 a 80% en los primeros 18 meses.
TCO a nivel de rack: lo que los compradores se pierden
El precio de compra de hardware es de solo 55 a 65% del costo total de 3 años. Un presupuesto completo de rack de inferencias de 42U debe incluir:
- Hardware de servidor GPU: $287,000–$420,000 (nodo 8×H100/H200 + Xeon de doble socket + RAM de 2 TB + NVMe + ConnectX-7 nic)
- Redes: $15,000–$35,000 (conmutadores NDR InfiniBand, cables DAC, fibra)
- Infraestructura de energía: $8,000–$18,000 (PDU, UPS, actualizaciones de interruptores en PUE 1.3)
- Refrigeración: $12,000–$45,000 (intercambiadores de calor de la puerta trasera agregan $25K; enfriamiento líquido directo a viruta agrega $40K+ pero reduce la PUE a 1.05–1.10)
- Electricidad de 3 años: $28,000–$52,000 (a $0.10–$0,18/kWh, 5–8 kW/difusión sostenida)
- Personal/OPS: $40,000–$80,000/año (0,5 a 1,0 FTE con experiencia en clúster de GPU)
Total de TCO de 3 años para un solo rack de inferencia 8×H200: $580,000–$760,000. Divida por tokens generados en la utilización de 80% durante 36 meses y se llega a $0.15–$0.22 por millón de tokens de salida, muy por debajo de los proveedores de API de presupuesto para cargas de trabajo de gran volumen.
Atal Networks’ Configuraciones de servidores dedicados Incluya el modelado transparente de TCO: proporcionamos desgloses de costos de elementos de línea antes de comprometerse. Hable con nuestro equipo de infraestructura en atalnetworks.com.
Optimización de la inferencia de IA: técnicas que funcionan
Cuantificación (FP8, INT8, INT4 — compensación de precisión frente a velocidad)
La cuantificación reduce la precisión numérica de los pesos del modelo, reduciendo la huella de la memoria y aumentando el rendimiento, pero con cierto costo de precisión. Esto es lo que mostró nuestra prueba en Llama-3-70b:
| Precisión | Precisión MMLU | Precisión humana | Precisión GSM8K | Ganancia de rendimiento frente a FP16 | Se requiere VRAM (70B) |
| FP16 (línea de base) | 82.0% | 80.5% | 88.1% | 1.0× | ~140 GB |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140 GB |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70 GB |
| INT8 (Smoothquant) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70 GB |
| INT4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35 GB |
| NVFP4 (Blackwell) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25 GB |
Para la mayoría de las cargas de trabajo de producción, FP8 es el punto óptimo: ofrece una calidad cercana al FP16 con aproximadamente 2 × rendimiento y reducción de memoria 50%, lo que permite que un modelo 70B encaje en un solo nodo 8 × H100 SXM. INT4 (a través de GPTQ o AWQ) es viable para aplicaciones donde es aceptable una ligera degradación de la calidad a cambio de una mayor reducción de costos.
Lotes continuos y pageDattention
El lote estático, esperando que se llene un lote fijo antes del procesamiento, conduce al tiempo de inactividad de la GPU y la alta latencia de cola. El procesamiento por lotes continuo (pionero en VLLM y ahora estándar en todos los principales marcos de inferencia) procesa las solicitudes en paralelo, desalojando secuencias completas y admitiendo otras nuevas sin pausa. Combinado con la gestión de memoria caché no contigua de PageDattention, este enfoque logra una utilización de GPU de 2 a 4 × más versus lotes estáticos en el mismo hardware con el mismo volumen de solicitud.
Gestión de caché de KV: la matemática de la memoria
La memoria caché KV almacena claves y valores de atención para cada token en la ventana de contexto para evitar el recómputo durante la decodificación. Requisito de memoria por solicitud:
bytes de caché de kv = 2 × num_layers × num_heads × head_dim × sequence_length × bytes_per_element
Para Llama-3-70b en FP16 (2 bytes/elemento, 80 capas, 8 cabezales, 128 head_dim) con un contexto de 4.096 tokens: ~42 MB por solicitud simultánea. Con 1000 usuarios simultáneos, es decir, 42 GB solo de caché KV, antes de los pesos del modelo. La cuantificación de la caché KV a INT8 reduce esto a 21 GB, lo que permite aproximadamente 2 usuarios simultáneos en el mismo hardware.
Decodificación especulativa
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
Servido de precarga y desagregados fragmentados
Para las cargas de trabajo de contexto largo, el prefill fragmentado divide un aviso grande en fragmentos más pequeños procesados de forma secuencial, lo que permite que la etapa de decodificación intercale los tokens de las solicitudes existentes durante las brechas previas al llenado. La porción desagregada lleva esto más allá al ejecutar el precarga y decodificar en grupos de GPU separados: precarga en hardware optimizado para computación (H100 SXM), decodificar en hardware optimizado con ancho de banda (H200) - Logrando una mejor utilización de los recursos y P99 más bajo latencia simultáneamente.
Marcos de servicio de inferencia de IA: comparación directa
El marco de servicio que elijas es tan importante como el hardware. Cada uno tiene diferentes fortalezas, limitaciones y complejidad operativa:
| Marco de referencia | Rendimiento (relativo) | Facilidad de configuración | Soporte de GPU | Fuerza clave | Licencia |
| VLLM 0.5+ | Alto (1.0× Baseline) | Fácil (instalación PIP) | NVIDIA, AMD ROCM | Loteado continuo, comunidad más grande, API compatible con OpenAI | Apache 2.0 |
| Tensort-LLM | Más alto (1.3–1.6×) | Complejo (compilación de motores) | solo nvidia | Rendimiento máximo de NVIDIA, lote en vuelo, FP8/FP4 | Apache 2.0 |
| TGI (cara de abrazo) | Medio (0.85×) | Fácil | Nvidia, AMD, Gaudí | Abrazando la integración de Hub de modelo de cara, soporte de modelo amplio | Apache 2.0 |
| orgía | Alto (1.1–1.2×) | Medio | Nvidia, AMD | Caché de prefijo, Attention RadixAttention, rendimiento de salida estructurada | Apache 2.0 |
| Llama.cpp | Bajo (CPU viable) | Muy fácil | CPU, CUDA, Metal, Vulkan | Inferencia de CPU/borde, dependencias mínimas, cuantificación amplia | mitr |
| Nvidia Tritón | Varía (envoltura) | Complejo | Nvidia (principalmente) | Servicio multimodelo, backend agnóstico de marco, MLOPS empresarial | Cláusula 3-BSD |
Seguridad, privacidad y cumplimiento de la inferencia de IA
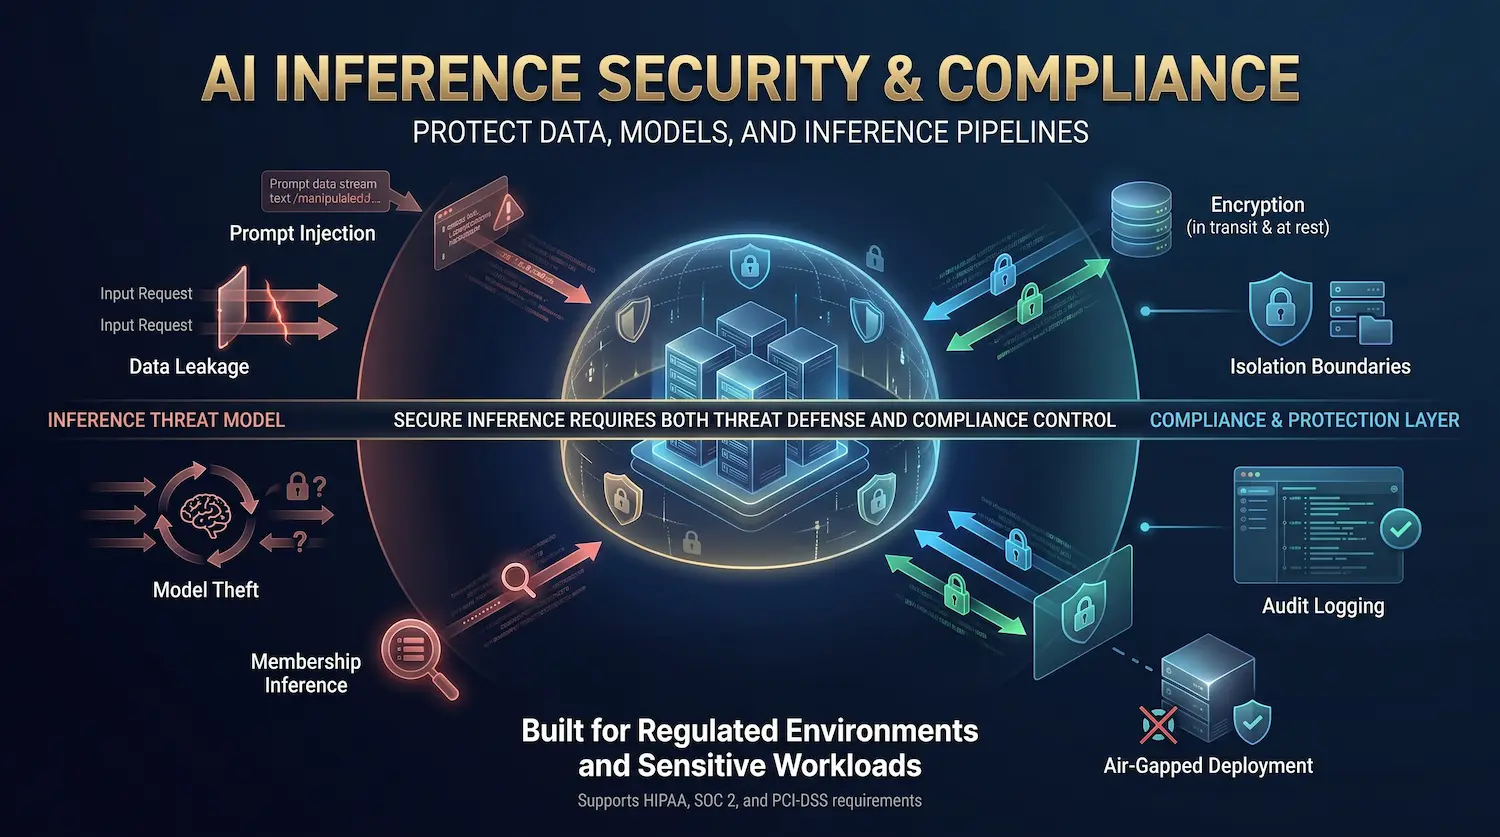
Ejecutar inferencia de IA en industrias reguladas o con datos confidenciales requiere comprender el modelo de amenaza completo y la postura de cumplimiento.
Modelo de amenaza de seguridad de inferencia
- Inyección rápida: las entradas maliciosas incrustadas en los datos del usuario intentan anular las instrucciones del sistema o extraer los datos de entrenamiento.
- Fuga de datos: la información confidencial de la solicitud de un usuario se filtra en la respuesta de otro usuario a través de la contaminación cruzada KV-Cache (mitigado por el aislamiento de caché por usuario).
- Robo del modelo: las consultas adversas repetidas intentan reconstruir los pesos del modelo a través del análisis de salida.
- Inferencia de membresía: los atacantes determinan si aparecieron datos específicos en el conjunto de entrenamiento del modelo.
Marcos de cumplimiento
Para la inferencia de IA compatible con HIPAA: todos los datos deben permanecer dentro de su límite de control, el cifrado en tránsito (TLS 1.3) y el cifrado en reposo (AES-256) son obligatorios, y el registro de auditoría de todas las solicitudes de inferencia debe ser mantenido. El cumplimiento de SOC 2 Type II requiere auditorías de seguridad neutrales a los proveedores y una respuesta a incidentes documentada. Los entornos PCI-DSS deben usar servidores de inferencia con espacios de aire sin conectividad a Internet. La implementación local, en lugar de la infraestructura de API o nube compartida, es la única arquitectura que satisface los tres marcos simultáneamente sin controles de compensación significativos.
Atal Networks’ Infraestructura de servidores dedicado Soporta implementaciones con brechas de aire para la inferencia de IA regulada. Contáctenos en atalnetworks.com para discutir sus requisitos de cumplimiento.
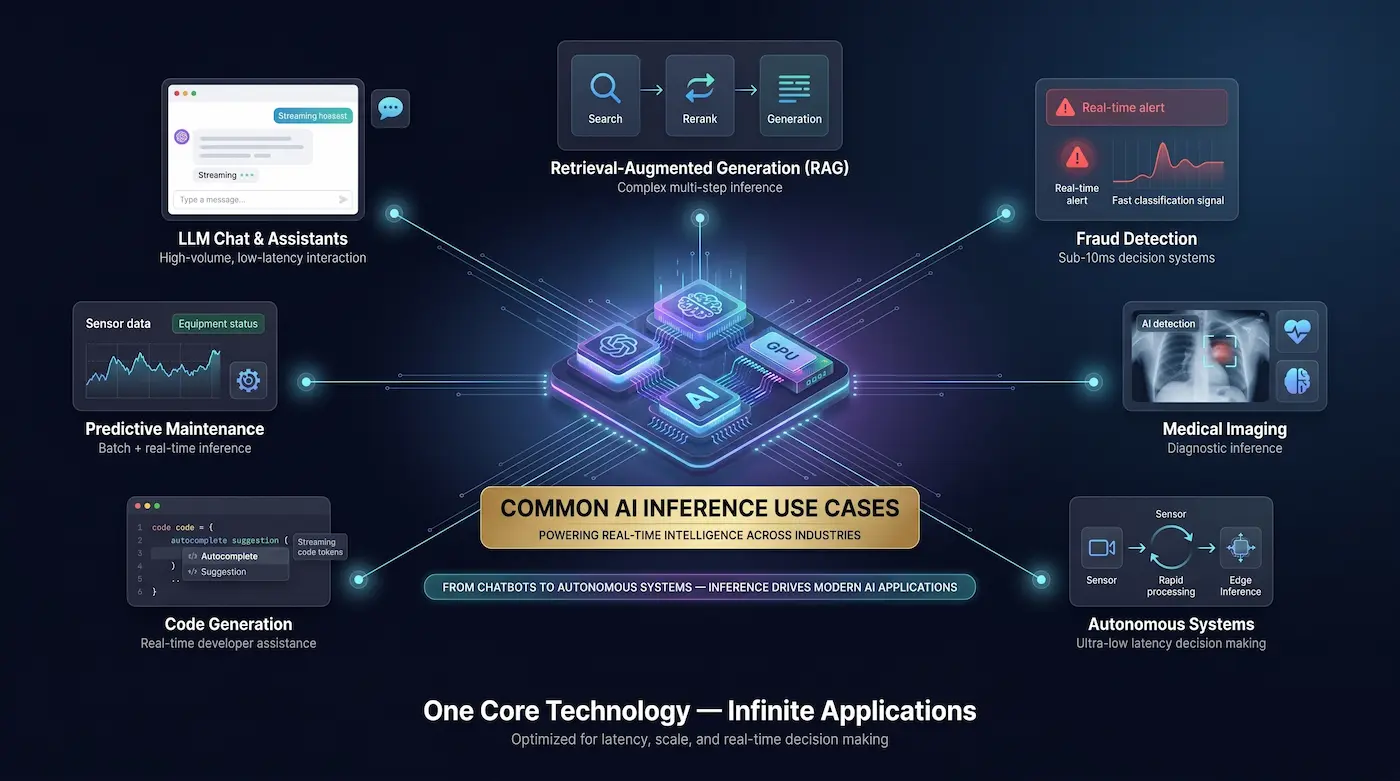
Casos comunes de uso de inferencia de IA
AI Inference impulsa una amplia gama de aplicaciones de producción en todas las industrias:
- LLM Chat y asistentes: bots de servicio al cliente, asistentes de conocimiento interno, copilotos de codificación: todos son cargas de trabajo de inferencia de gran volumen y sensibles a la latencia.
- Generación aumentada por recuperación (RAG): combina un modelo de incrustación (para búsqueda semántica), un reranker y un LLM en una tubería de inferencia de tres etapas. Cada etapa agrega latencia y costo.
- Detección de fraude: inferencia de clasificación en tiempo real con una latencia sub-10 ms utilizando modelos especializados más pequeños.
- Imágenes médicas: CNN y la inferencia del transformador de visión para radiología, patología y diagnóstico, que a menudo requieren un despliegue local para el cumplimiento de HIPAA.
- Vehículos autónomos: inferencia de percepción de latencia de milisegundos sobre hardware a bordo especializado (ORIN, D5).
- Generación de código: la inferencia de transmisión para autocompletar requiere ITL extremadamente baja (< 15 ms) para sentirse en tiempo real.
- Flujos de trabajo de agente: los agentes de llamadas de herramientas de varios pasos generan muchas llamadas de inferencia por tarea de usuario, multiplicando el costo de 5 a 20 × frente a las respuestas de un solo giro.
- Mantenimiento predictivo: inferencia por lotes en flujos de datos del sensor para predecir la falla del equipo.
El futuro de la inferencia de IA — 2026 y más allá
Varias tendencias están remodelando el panorama de la inferencia hasta 2026 y 2027:
- Modelos de razonamiento y escalado de tiempo de prueba: como demostró DeepSeek-R1 y Gemini 2.5 Thinking, generar más tokens en el tiempo de inferencia mejora de manera confiable la calidad de salida en tareas complejas. Esto cambia fundamentalmente la curva de costo: la factura de inferencia por consulta crece, no se reduce.
- Mezcla de expertos (MOE) Dominancia: las arquitecturas MOE como Mixtral 8x22b activan solo una fracción de parámetros por token, brindando un rendimiento de clase GPT-4 con un costo de cálculo de inferencia de 2 a 3 × más bajo. Espere que MOE domine las versiones de los nuevos modelos.
- Servir desglosados y especulativos a escala: la separación de grupos de precarga y decodificación, combinados con la decodificación especulativa estilo Eagle, se está convirtiendo en la arquitectura de producción estándar para implementaciones de LLM a gran escala.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- Modelos de frontera en el dispositivo: Apple Intelligence, Gemini Nano y Phi-3-Mini demuestran que los modelos cuantificados 3B–7B pueden ejecutarse completamente en hardware de consumo. El límite entre la nube y la inferencia de borde se está desdibujando.
- La IA soberana y la residencia de datos: las presiones geopolíticas están impulsando a las empresas y los gobiernos a exigir la soberanía total de los datos, inferencia dentro de sus fronteras nacionales, sobre el hardware que poseen. La demanda local crecerá, no se reducirá.
Preguntas frecuentes (FAQs)
¿Qué es la inferencia de IA en términos simples?
La inferencia de IA es cuando un modelo de IA capacitado usa lo que ha aprendido para responder a una nueva pregunta o completar una nueva tarea. El entrenamiento enseña el modelo; La inferencia es el modelo que hace su trabajo. Cada vez que recibe una respuesta de chatgpt, recibe una recomendación de producto o ve una alerta de fraude, es decir, la inferencia de IA está sucediendo en tiempo real.
¿Cuál es la diferencia entre la inferencia de IA y el entrenamiento de IA?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
¿El chatgpt es inferencia o entrenamiento?
Cuando chatea con chatGPT, está activando la inferencia: los pesos del modelo son fijos y los aplica a su entrada para generar una respuesta. OpenAI entrena (y vuelve a entrenar periódicamente) GPT-4 por separado, en vastos conjuntos de datos, a un costo enorme. Esas son dos operaciones completamente diferentes. Lo que experimentas como usuario es 100% Inferencia.
¿Qué hardware se utiliza para la inferencia de IA?
El hardware dominante para la inferencia a gran escala son las GPU NVIDIA (H100, H200, B200, L40S), las GPU AMD (MI300X, MI355X) y TPUs de Google para cargas de trabajo nativos en la nube. Para Edge Inference: Apple Neural Engine, Qualcomm Hexagon NPU y Nvidia Jetson Orin. Para despliegues de costes o solo de CPU, los procesadores Intel Xeon (AMX) y AMD EPYC modernos pueden ejecutar modelos cuantificados con un rendimiento aceptable.
¿Cuál es la mejor GPU para la inferencia de IA en 2026?
Para modelos grandes (70B+): el NVIDIA H200 SXM5 (141 GB HBM3E, 4.8 TB/s) ofrece el mejor rendimiento por dólar para la mayoría de las cargas de trabajo. Para el máximo rendimiento en modelos Frontier: el B200 SXM6 lleva. Para un rango medio sensible al costo: el AMD MI300X (192 GB HBM3, $10K–$15K más bajo que H200) es cada vez más competitivo. Para la inferencia Edge/Single-GPU: el NVIDIA L40S (48 GB GDDR6) equilibra bien el costo y la capacidad.
¿Cómo funciona la inferencia LLM paso a paso?
- Tokenización: el texto de entrada se convierte a ID de token entero. 2. Prellenado: todos los tokens de entrada se procesan simultáneamente en un pase directo, generando el caché KV y el primer token de salida. 3. Decodificar: se generan nuevos tokens de uno en uno, cada uno de ellos atendiendo al caché completo de KV. 4. Loteado continuo: varias solicitudes simultáneas comparten la computación de GPU a través de lotes en vuelo. 5. Streaming: los tokens de salida se destokenizan y se transmiten al cliente a medida que se generan.
¿Qué son TTFT e ITL en la inferencia LLM?
TTFT (Time to First Token) mide cuánto tiempo desde el envío de la solicitud hasta que se devuelve el primer token de salida: la latencia que el usuario percibe como "tiempo de espera". Está dominado por la etapa de precarga. ITL (latencia entre tokens) mide el tiempo promedio entre tokens de salida consecutivos durante la decodificación, lo que determina la "velocidad de transmisión" que ve el usuario. Ambos deben optimizarse para el chat en tiempo real: normalmente TTFT < 200 ms e ITL < 30 ms para una experiencia receptiva.
¿Qué es un caché KV y por qué importa?
El KV-Cache (cache de clave-valor) almacena los cálculos de atención intermedia (claves y valores) para cada token en el contexto de conversación. Sin él, el modelo tendría que volver a procesar toda la ventana de contexto para cada nuevo token: o(n²) compute. Con él, cada paso de decodificación solo procesa un nuevo token, lo que hace que la inferencia de LLM sea factible. El tamaño de caché de KV es una restricción principal sobre cuántos usuarios simultáneos puede servir una GPU y qué tan larga puede durar la ventana de contexto.
¿Cuánto cuesta la inferencia de IA por tokens de 1 millón?
En hardware autohospedado (8 × H200, amortización a 3 años, $0.12/kWh, utilización 80%, Llama-3-70B FP8): Aproximadamente $0.18 por 1M de fichas de entrada y $0.71 por 1M de salida. a través de API pública: GPT-4O cuesta $2.50/$10.00 de entrada/salida por 1M tokens; El soneto de Claude cuesta $3.00/$15.00. El autohosting a escala ofrece una reducción de costos de 5 a 20 ×, con tokens de salida de 5 a 15 millones por día, según el proveedor y el modelo de API.
¿Puedes ejecutar una inferencia de IA en una CPU?
Sí, para modelos más pequeños y cuantificados. Llama.cpp habilita la inferencia INT4/INT8 en cualquier CPU x86. Un Xeon Platinum de doble socket con AMX genera ~25 a 40 tokens/seg en un modelo 7B INT4, que es adecuado para cargas de trabajo no en tiempo real. La inferencia de CPU no es viable para los modelos 70B+ en el rendimiento de producción. El trabajo económico para tareas de desarrollo, prueba y latencia tolerante a la latencia en las que el costo de alquiler de GPU supera el valor del rendimiento.
¿Cuál es la diferencia entre precarga y decodificación en LLM Inference?
Prefill procesa todo el indicador de entrada en una operación paralela (enlazado por computación, rápido, escalas con longitud de solicitud). Decode genera tokens de salida uno a la vez en un bucle autorregresivo (memoria-ancho de banda de banda, más lento por token, escalas con longitud de salida y usuarios simultáneos). La transición entre ellos, cuando se genera el primer token, es TTFT. Optimizar la precarga reduce TTFT; Optimizar Decode reduce ITL y mejora el rendimiento.
¿Cuándo deberías autohospedar la inferencia de IA frente a usar una API?
Use una API cuando: El volumen es bajo (< 2 M Fichas/día), necesita un modelo cerrado de Frontier (GPT-4O, Claude), o está prototipado y desea CERO CERO. Autohost cuando: el volumen supera los 5 millones de fichas/día, la privacidad de los datos o el cumplimiento lo requiere, desea ajustar o controlar el modelo, o necesita SLA garantizado sin límites de tarifa. El punto de equilibrio frente a la mayoría de las API es de 3 a 18 meses dependiendo del modelo y el volumen, después de lo cual se compara favorablemente durante años.
Construya o compre — Próximos pasos con Atal Networks
Si ha llegado a este punto, tiene una imagen completa de qué es la inferencia de IA, cómo funciona, cuánto cuesta y qué hardware la alimenta. La siguiente pregunta es la ejecución.
Atal Networks se especializa en infraestructura de inferencia de IA especialmente diseñada para empresas que han superado la dependencia de API. Nuestro equipo ha diseñado e implementado clústeres de GPU en los sectores de atención médica, servicios financieros, fabricación y software, y publicamos los datos de referencia, no solo el folleto.
Explora nuestro Configuraciones de servidores dedicados Para implementaciones de inferencia de alto rendimiento, con sistemas H100, H200 y MI300X.
¿Está buscando un punto de entrada de CAPEX más bajo? Nuestro Planes VPS optimizados para GPU Permita que comience a ejecutar cargas de trabajo de inferencia privada hoy sin tener el rack.
¿Listo para hablar de números? Visita atalnetworks.com Y hable directamente con un ingeniero de hardware, no con un guión de ventas.
