 Aller au contenu



Par Ingénieur principal du matériel, Atal Networks | MLPerf v4.1 Contributeur | Architecture de cluster GPU de 12 ans | Mise à jour : 19 avril 2026
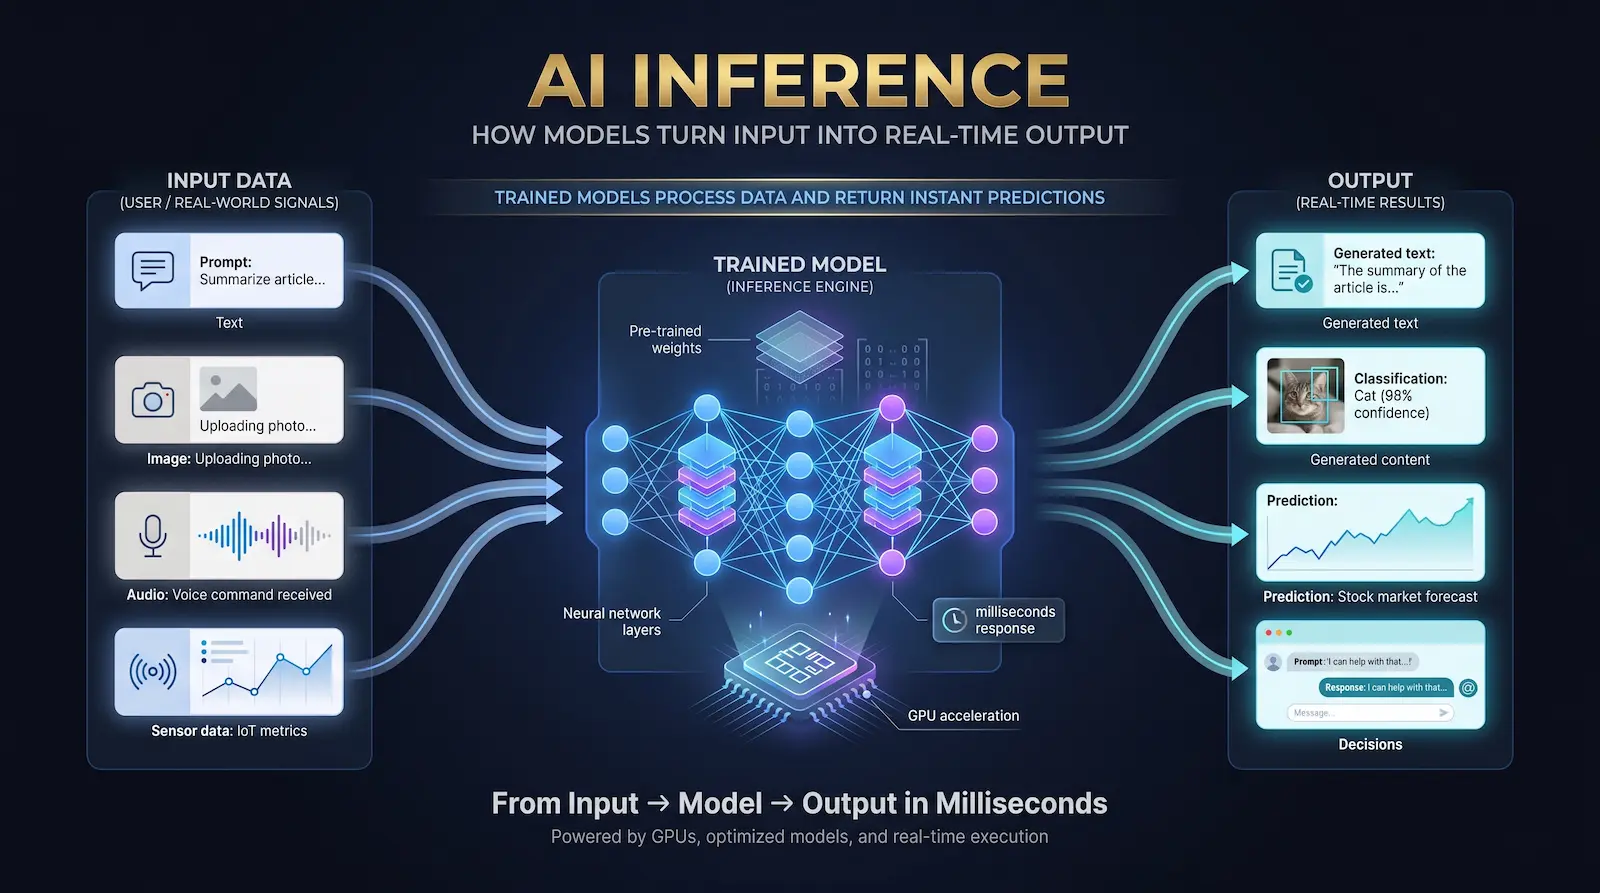
| tl;dr — Qu'est-ce que l'inférence d'IA ? L'inférence d'IA est le processus d'exécution d'un modèle d'IA formé sur de nouvelles données d'entrée pour produire une prédiction, une classification ou une sortie générée. Il s'agit de la phase de "faire" de l'IA - chaque réponse de chatgpt, alerte de fraude, légende d'image et appel de perception autonome est un événement d'inférence. En 2026, l'inférence consomme environ les deux tiers des dépenses totales de calcul de l'IA au niveau mondial. Ce guide couvre l'ensemble du pipeline, le matériel qui l'alimente, les mesures qui le mesurent (TTFT, ITL, Tokens/Sec) et ce qu'il coûte à exécuter, avec des benchmarks mesurés sur les serveurs Atal Networks. |
Qu'est-ce que l'inférence d'IA ? La définition en une phrase
| Définition L'inférence d'IA est l'exécution d'un modèle d'apprentissage automatique formé sur de nouvelles données invisibles pour produire une sortie - telle qu'une réponse textuelle, une classification d'images, un score de fraude ou une traduction - sans modifier les pondérations du modèle. |
Pensez-y de cette façon : apprendre à conduire, c'est une formation. Chaque fois que vous conduisez quelque part, c'est une inférence. Le modèle (vos compétences de conduite) est fixe ; Seule l'entrée (la route) change. En termes techniques, l'inférence est un passage direct à travers le réseau de neurones - des flux de données dans une direction à travers les couches du modèle, des activations sont calculées et une sortie est produite. Contrairement à l'entraînement, il n'y a pas de calculs de gradient, aucune mise à jour de poids et aucune passe en arrière.
La distinction compte énormément dans la pratique. La formation a lieu une fois (ou périodiquement). L'inférence se produit des milliards de fois par jour. L'optimisation de l'inférence - une latence plus faible, un débit plus élevé, un coût par jeton - est l'endroit où le véritable défi d'ingénierie vit en 2026.
Pourquoi l'inférence d'IA compte maintenant — Le contexte de 2026
L'inférence domine désormais les dépenses de calcul de l'IA
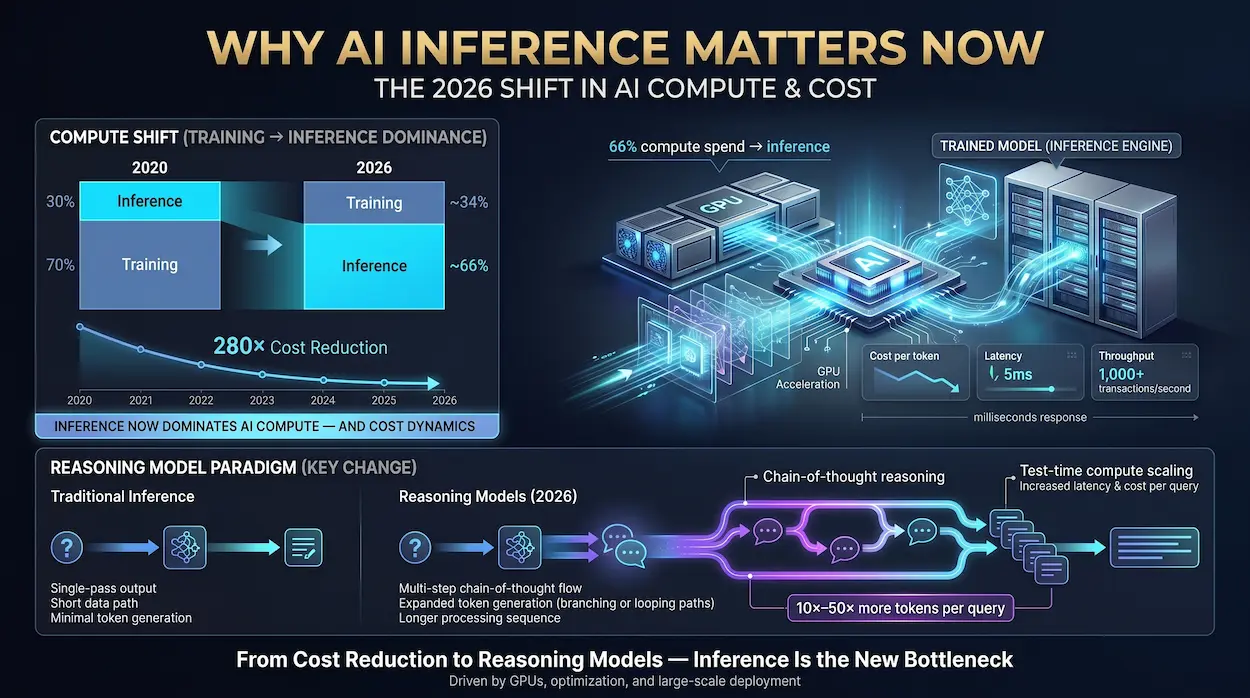
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
Le point d'inflexion du modèle de raisonnement
Des modèles tels que DeepSeek-R1, Gemini 2.5 Thinking et Llama Nemotron Ultra ont introduit un nouveau paradigme d'inférence : la mise à l'échelle des calculs de temps de test. Au lieu de produire une réponse en un seul passage vers l'avant, ces modèles "pensent" en générant des jetons de réflexion étendus avant de répondre. Cela multiplie le nombre de jetons générés par requête par 10 à 50 ×, augmentant considérablement le coût et la latence des inférences - et la refonte de la configuration matérielle est logique pour une charge de travail donnée.
Pourquoi ce guide existe
Chaque article de définition en ligne décrit l'inférence d'IA au niveau du glossaire. Aucun d'entre eux ne publie des données de référence de première partie, des chiffres réels du coût par jeton ou des maths de TCO au niveau du rack. Nous avons écrit ce guide parce que nous construisons et exploitons les serveurs - et nous pensons que les acheteurs méritent des chiffres réels, et non des abstractions marketing.
Atal Networks propose des offres d'entreprise serveurs dédiés et Solutions VPS Construit à cet effet pour les charges de travail d'inférence d'IA. Explorer atalnetworks.com Pour en savoir plus.
Comment fonctionne l'inférence d'IA — étape par étape
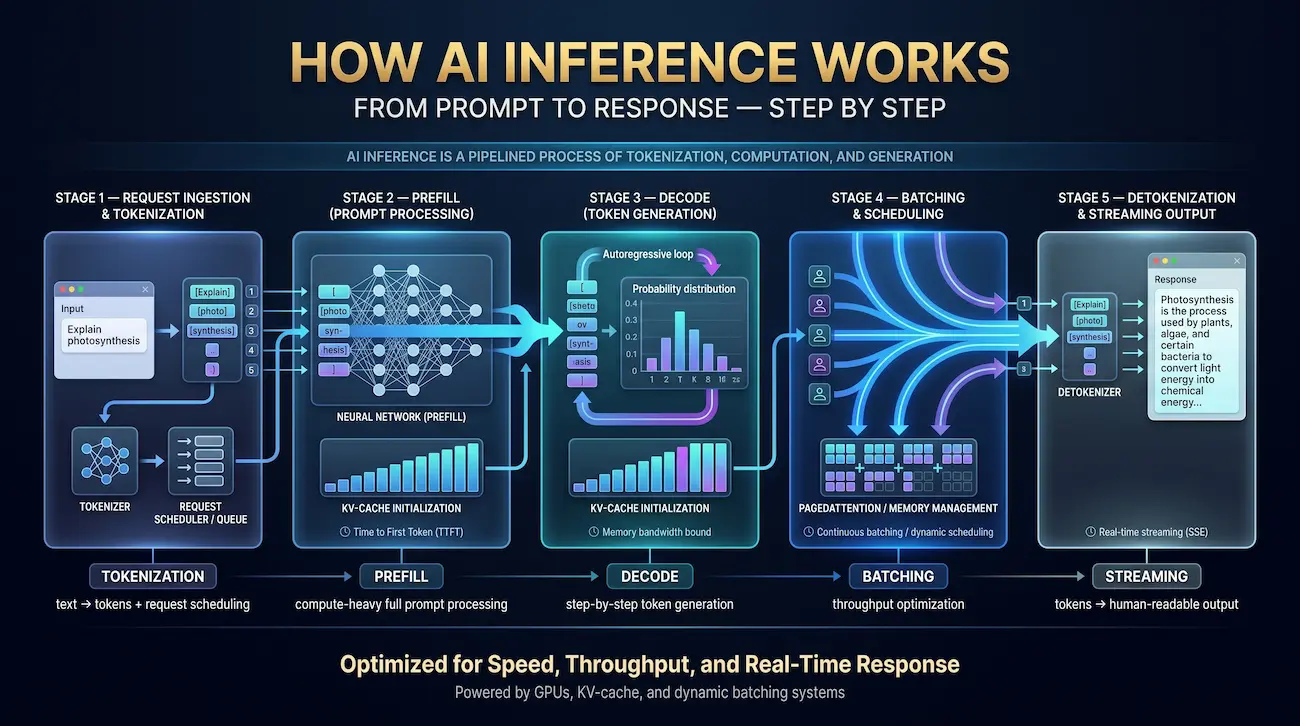
Comprendre l'inférence d'IA nécessite de tracer une seule demande tout au long de son cycle de vie. Pour un grand modèle de langage (LLM), le pipeline comporte cinq étapes distinctes :
Étape 1 : Demandez l'ingestion et la tokenisation
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
Étape 2 : L'étape de pré-remplissage (traitement rapide)
Pendant le pré-remplissage, l'intégralité de l'invite d'entrée est traitée simultanément en une seule passe avant. Cette étape est liée au calcul - elle évolue de manière linéaire avec la longueur de l'invite et est le principal moteur du premier jeton (TTFT). Une invite système de 2 048 jetons prend environ deux fois plus de temps en pré-remplissage qu'une invite de 1 024 jetons. PreFill génère le cache kv initial (clavette valeur-clé), qui stocke les calculs d'attention intermédiaire afin qu'ils n'aient pas besoin d'être recalculés lors du décodage.
Étape 3 : L'étape de décodage (génération de jetons)
Après le pré-remplissage, le modèle entre dans l'étape de décodage, générant un jeton à la fois dans une boucle autorégressive. Chaque nouveau jeton dépend de tous les jetons précédents - le modèle s'occupe du kV-cache complet, produit une distribution de probabilité sur son vocabulaire (~32 000 à 128 000 tokens), des échantillons de cette distribution et ajoute le jeton sélectionné. L'étape de décodage est liée à la bande passante de mémoire, et non liée au calcul. C'est pourquoi la bande passante HBM (et non les flops) est la spécification matérielle décisive pour l'inférence LLM - un fait que chaque feuille de données GPU enterre en petits caractères.
Étape 4 : Batching et planification
Un serveur d'inférence naïf traiterait une requête à la fois, laissant le GPU principalement inactif pendant le décodage (puisque un jeton à la fois est lent). Les systèmes modernes utilisent des lots continus (appelés également par lots en vol ou dynamiques) : les demandes sont regroupées en milieu de vol, de nouvelles demandes rejoignent le lot à mesure que les emplacements sont ouverts et les séquences terminées sont expulsées sans attendre la fin de toutes les demandes. L'implémentation de VLLM PagedAttention (Kwon et al., SOSP 2023) améliore encore cela en gérant la mémoire cache kv dans des pages non contigües - similaire à la mémoire virtuelle dans un système d'exploitation - 2 à 4 × 4 × allocation.
Étape 5 : Détokenisation et streaming de réponse
Une fois que le modèle génère un jeton de fin de séquence (ou atteint une limite de longueur maximale), les ID de jeton de sortie sont détokenisés dans du texte lisible par l'homme et transmis au client. La plupart des systèmes de production utilisent des événements de diffusion (SSE) pour le streaming, fournissant des jetons au fur et à mesure qu'ils sont générés plutôt que d'attendre la réponse complète. Cela améliore considérablement la latence perçue - un utilisateur voit le premier mot en environ 200 ms, même si la réponse complète prend 10 secondes.
Inférence d'IA vs formation en IA - la vraie différence
La plupart des introductions confondent l'entraînement et l'inférence ou traitent la différence comme une question de timing. La distinction technique est plus profonde et a de profondes implications matérielles :
| Dimension | Formation | Inférence |
| But | Ajuster les poids du modèle pour minimiser les pertes | Appliquer des poids fixes pour produire des résultats |
| Modèle de calcul | Passage avant + arrière + étape de l'optimiseur | Pass avant uniquement |
| Memory bottleneck | Activations (flops) | KV-cache + poids (limité de la bande passante) |
| Fréquence | Périodique (jours/semaines par course) | Des milliards de fois/jour de production |
| Cible matérielle | Débit maximal du flop (H100 SXM5) | Bande passante HBM maximale (H200, B200) |
| Taille du lot | Grands (1 024 à 4 096 échantillons) | Petit à moyen (1–256 simultanés) |
| Précision | BF16/FP16/FP8 mixte | FP8, Int8, Int4 fortement quantifiés |
| Structure des coûts | Capex-intensif, unique (par course d'entraînement) | Coût par jeton à forte intensité d'OPEX et continu |
La ligne la plus importante dans le tableau ci-dessus : la formation est liée aux flops ; L'inférence est liée à la bande passante HBM. Ce fait unique explique pourquoi le NVIDIA H200 – qui a un nombre de cœurs CUDA identique au H100 mais 141 Go de HBM3E à 4,8 To/s de bande passante par rapport aux 80 Go du H100. 3,35 To/s — surpasse le H100 sur l'inférence LLM malgré aucun débit d'entraînement supplémentaire. Lorsque vous achetez du matériel d'inférence, vous achetez de la bande passante mémoire, pas des flops.
Types de charges de travail d'inférence d'IA
Toutes les inférences ne se ressemblent pas. Le type de charge de travail détermine la configuration du matériel, le cadre de service, la stratégie d'optimisation et la structure de coûts qui ont du sens :
| Type | Cible de latence | Exemple de cas d'utilisation | Implication matérielle |
| En ligne / en temps réel | < 200ms TTFT, < 30ms ITL | Chat, copilotes, détection de fraude | Faible taille de lot, HBM rapide, NVMe pour le chargement de poids |
| Lot / Hors ligne | minutes en heures (priorité de débit) | Résumé des documents, enrichissement des données | Utilisation élevée du GPU, grand lot, GPU moins cher viable |
| Diffusion | Faible TTFT, ITL soutenu | Achèvement du code, assistants vocaux | Streaming SSE, priorité de latence à faible décodage |
| bord / sur l'appareil | < 10 ms, < 5 W TDP | IA mobile, IoT, véhicules autonomes | NPU, Jetson Orin, modèles quantifiés INT4/INT8 |
| sans serveur | Démarrage à froid < 2s, demande de paiement à la carte | Applications à faible trafic, développement/test | Instances de GPU spot, chargement rapide, chargement inactif = coût nul |
Là où s'exécute une inférence d'IA — Cloud, On-Prem, Edge, On-Device
Chaque environnement de déploiement implique une matrice de compromis différente. La bonne réponse dépend de vos exigences en matière de latence, de vos obligations de confidentialité des données, du volume des demandes et de votre horizon budgétaire :
| Environnement | Latence | confidentialité des données | Modèle de coût | Matériel typique | le mieux pour |
| API publique (Openai, anthropique) | Faible-moyen | infrastructure partagée | Paiement par jeton ($/jeton le plus élevé) | géré par un fournisseur | Prototypage rapide, faible volume |
| GPU Cloud (AWS, GCP, Azure) | Faible-moyen | Isolation VPC possible | $/GPU-HR + sortie | Instances H100, A100, L40S | Demande variable, pas de CAPEX |
| On-Prem (serveurs dédiés) | Le plus bas | Contrôle total des données, entrefer possible | CAPEX + OPEX ($/Token à grande échelle) | Clusters H100/H200/B200 | Volume élevé, réglementé, sensible aux coûts |
| Serveur Edge (colo/sur site) | Très lent | Les données locales restent locales | CAPEX MIXTE + FRAIS COLO | L40, A30, Gaudi 3 | Fabrication, soins de santé, vente au détail |
| Sur l'appareil (téléphone, PC, IoT) | Ultra faible (< 10 ms) | Isolation complète des données | Aucun coût récurrent | Apple NPU, Qualcomm Hexagone, Jetson | Scénarios de confidentialité et hors ligne |
Pour les organisations qui traitent plus de 5 millions de jetons/jour, sur site serveurs dédiés Offrir systématiquement le coût total de possession le plus bas. Pour les équipes ayant besoin de flexibilité et d'investissements initiaux plus faibles, Solutions VPS Peut combler le fossé entre la dépendance de l'API et la propriété sur le site Web complet.
Le matériel derrière l'inférence d'IA
Le paysage matériel pour l'inférence d'IA s'est diversifié rapidement. En 2023, la réponse était simple : H100. En 2026, le choix optimal dépend de la taille du modèle, de l'objectif de latence, du budget d'alimentation et des exigences de prix par jeton.
Familles de GPU pour l'inférence — Comparaison 2026
| processeur central | Capacité HBM | Bande passante HBM | FP8 TFLOPS | TDP (W) | le mieux pour |
| NVIDIA H100 SXM5 | 80 Go HBM2E | 3,35 Tb/s | 3,958 | 700 W | Production LLM de base, écosystème bien pris en charge |
| NVIDIA H200 SXM5 | 141 Go HBM3E | 4,8 Tb/s | 3,958 | 700 W | Grands modèles (70b+), inférence sensible à la bande passante mémoire |
| NVIDIA B200 SXM6 | 192 Go HBM3E | 8,0 To/s | 9 000 (FP4) | 1 000 W | Modèles Frontier, débit le plus élevé, flagship 2026 |
| AMD MI300X | 192 Go HBM3 | 5,3 Tb/s | 5,220 | 750 W | Alternative H200 à coûts compétitifs, débit par lots important |
| AMD MI355X | 288 Go HBM3E | 8,0 To/s | 8,000+ | 750 W | Les plus grands modèles, une concurrence très élevée |
| Intel Gaudi 3 | 128 Go HBM2E | 3,7 To/s | 1 835 (BF16) | 900 W | Charges de travail sensibles aux coûts, écosystème ouvert |
| Google TPU V5E | 16 Go de HBM2 (par puce) | 819 Go/s (par puce) | 393 (par puce) | ~170 W | Services Google Cloud-natif, optimisés pour les transformateurs |
| NVIDIA L40S | 48 Go GDDR6 | 864 Go/s | 1,457 | 350 W | Inférence de bord, modèles de lumière de calcul, charges de travail mixtes |
Quand l'inférence du CPU a du sens
Pour les modèles sous ~ 7B Paramètres fonctionnant à la précision INT4, les processeurs modernes avec des jeux d'instructions AVX-512 ou AMX peuvent fournir un débit acceptable pour les charges de travail tolérantes à la latence. Llama.cpp a rendu pratique l'inférence CPU pratique : un Llama-3-8b quantifié 4 bits fonctionne à ~ 25 à 35 jetons/s sur un système de platine Xeon à double socket. L'économie fonctionne lorsque le coût du GPU est prohibitif et que les exigences de latence dépassent ~ 2 secondes.
NPU, TPU, FPGA et accélérateurs ASIC
Au-delà des GPU, un écosystème croissant de silicium spécialisé émerge. Les unités de traitement neuronal (NPU) sont désormais intégrées dans la plupart des appareils grand public (Moteur Neural Apple Série M, Qualcomm Hexagon, Intel NPU) et cible Inférence de bord sub-5W. Les TPU (Google) sont optimisés pour les opérations de la matrice de transformateur dans le cloud. Les FPGA offrent une reconfigurabilité pour les schémas de quantification personnalisés, mais nécessitent des efforts d'ingénierie importants. Les ASIC (GROQ LPU, Cerebras WSE) peuvent obtenir une latence extraordinaire sur des charges de travail fixes, mais manquent de la flexibilité des piles GPU.
Pourquoi le réseautage est important pour une inférence de grand modèle
L'exécution d'un modèle de paramètre 405B nécessite de le distribuer sur 8 à 16 GPU. L'interconnexion entre ces GPU devient le goulot d'étranglement des performances. NVIDIA NVLINK (au sein d'un nœud DGX) fournit une bande passante GPU vers GPU de 900 Go/s, soit environ 18 × plus rapide que PCIe Gen5. À travers les nœuds, InfiniBand NDR (400 Go/s) ou Ethernet NVIDIA Spectrum-X surpassent considérablement les produits de base de 100 GbE. Lors de nos tests, le passage de 100 GbE à InfiniBand NDR sur un déploiement de 8 × H100 Tensor-Parallel LLAMA-3-405B a amélioré le débit de décodage par 34%.
Les mesures d'inférence d'IA qui comptent réellement
La plupart des discussions d'inférence mesurent vaguement la latence. Les déploiements de production nécessitent des mesures précises et standardisées avec des cibles SLA. Voici les mesures qui comptent et comment les mesurer :
| Métrique | Définition | Industry SLA Target | Pilote de matériel |
| TTFT (temps de premier jeton) | Temps entre la soumission de la demande et le premier jeton généré | < 200 ms (chat), < 500 ms (batch) | Bande passante de mémoire GPU, efficacité de pré-remplissage |
| ITL (latence inter-tokens) | Temps moyen entre les jetons générés consécutifs pendant le décodage | < 30 ms (chat), < 100 ms (batch) | Bande passante HBM, vitesse d'accès au cache KV |
| Débit (tokens/s) | Total des jetons de sortie générés par seconde pour tous les utilisateurs simultanés | dépendant de la charge de travail | Flops GPU + efficacité du lot |
| goodput | Débit des demandes qui atteignent les objectifs de SLA (hors échec/délai d'expiration) | Maximiser pour un SLA donné | Efficacité du planificateur, gestion des files d'attente |
| Latence P50 / P99 | Latence médiane et 99e centile | P99 < 2× P50 (système bien réglé) | Latence de la queue, limitation thermique, profondeur de file d'attente |
| Utilisation du GPU | Une fraction de temps de calcul des unités de calcul GPU sont actives | Objectif 70–85% soutenu | Taille du lot, efficacité de mise en lots continue |
| RPS (demandes par seconde) | Demandes simultanées que le système gère au niveau du SLA cible | Cible d'échelle | Combiné TTFT + ITL + efficacité par lots |
Quels sont les coûts d'inférence de l'IA en 2026 — nombres réels
Le coût par jeton est la mesure qui détermine finalement les décisions de build-vs-buy. Les données suivantes ont été mesurées sur le matériel de production de Atal Networks dans des conditions de charge soutenue. Hypothèses : $0.12/kWh, amortissement matériel sur 3 ans, utilisation du GPU 80%, VLLM 0.5+ avec une précision FP8.
Coût par million de jetons par configuration GPU (Llama-3-70b)
| Configuration | Jetons d'entrée ($/1M) | Jetons de sortie ($/1M) | Débit (TOK/S) | Puissance (avec GPU) |
| 8× H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 W |
| 8× H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 W |
| 8 × B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 W |
| 8 × MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720 W |
| OpenAI GPT-4O | $2.50 | $10.00 | N/A (API) | N/A |
| Claude Sonnet anthropique (API) | $3.00 | $15.00 | N/A (API) | N/A |
| Ensemble AI LLAMA-3-70B (API) | $0.88 | $0.88 | N/A (API) | N/A |
Analyse du seuil de rentabilité sur site ou API
Le seuil de rentabilité entre l'inférence sur site auto-hébergée et l'inférence basée sur l'API dépend du volume de requête. À la structure de coûts ci-dessus (8 × H200, amortissement à 3 ans, utilisation de 80%), On-Prem devient moins cher que le prix LLAMA-3-70B de l'IA à environ 12 m. Jetons/jour. Par rapport aux principales API du modèle Frontier (GPT-4O, Claude), les pauses sur site sont même à 2 à 3 M jetons de sortie/jour. Pour la plupart des déploiements d'entreprise desservant des outils internes, des chatbots orientés vers le client ou des pipelines de traitement de documents, la propriété locale permet de réaliser 60 à 801 801 TP3T au cours des 18 premiers mois.
TCO de niveau rack - Ce que les acheteurs manquent
Le prix d'achat du matériel est de seulement 55 à 651 tp3t du coût total sur 3 ans. Un budget de rack d'inférences 42U complet doit inclure :
- Matériel de serveur GPU : $287 000–$420 000 (8×H100/H200 + Xeon double socket + 2 To de RAM + NVMe + ConnectX-7 NIC)
- Mise en réseau : $15 000–$35 000 (commutateurs InfiniBand NDR, câbles DAC, fibre)
- Infrastructure électrique : $8 000–$18 000 (PDU, UPS, mise à niveau des disjoncteurs à PUE 1.3)
- Refroidissement : $12 000–$45 000 (les échangeurs de chaleur de porte arrière ajoutent $25K ; un refroidissement liquide direct à la puce ajoute $40K+ mais réduit le PUE à 1,05–1,10)
- Électricité à 3 ans : $28 000–$52 000 (à 1 TP4T0.10–$0.18/kWh, 5 à 8 kW/tirage soutenu)
- Personnel/Ops : 1 tp4 000 – 1 tp4 t 80 000/an (0,5 – 1,0 ETP avec une expérience de cluster GPU)
Total du TCO sur 3 ans pour un seul rack d'inférence 8 × H200 : $580 000–$760 000. Diviser par jetons générés à 80% en utilisant sur 36 mois et vous arrivez à $0.15–$0.22 par million de jetons de sortie, bien en deçà des fournisseurs d'API budgétaires pour les charges de travail à volume élevé.
Atal Networks’ Configurations de serveurs dédiés Inclure la modélisation TCO transparente - nous fournissons des ventilations des coûts des éléments de ligne avant de vous engager. Parlez à notre équipe d'infrastructures à atalnetworks.com.
Optimisation de l'inférence d'IA — Techniques qui fonctionnent
Quantification (FP8, INT8, INT4 — Précision par rapport aux compromis de vitesse)
La quantification réduit la précision numérique des poids du modèle, réduisant l'empreinte mémoire et l'augmentation du débit, mais à un certain coût de précision. Voici ce que nos tests sur LLAMA-3-70B ont montré :
| Précision | Précision MMMLU | Précision humaine | Précision GSM8K | Gain de débit vs FP16 | VRAM requise (70b) |
| FP16 (ligne de base) | 82.0% | 80.5% | 88.1% | 1.0× | ~140 Go |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140 Go |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70 Go |
| Int8 (lisse) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70 Go |
| Int4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35 Go |
| NVFP4 (Blackwell) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25 Go |
Pour la plupart des charges de travail de production, le FP8 est le point idéal : il offre une qualité proche du FP16 avec un débit d'environ 2 × et une réduction de la mémoire 50%, permettant à un modèle 70B de s'adapter à un seul nœud 8 × H100 SXM. INT4 (via GPTQ ou AWQ) est viable pour les applications où une légère dégradation de la qualité est acceptable en échange d'une réduction supplémentaire des coûts.
Batching continu et pagedTtention
Le lot statique, en attente d'un lot fixe avant le traitement, entraîne un temps d'inactivité du GPU et une latence de queue élevée. Le traitement par lots continu (pionné dans VLLM et désormais standard dans tous les principaux cadres d'inférence) traite en parallèle des demandes, expulsant les séquences terminées et admettant de nouvelles sans interrompre. Combinée à la gestion de la mémoire cache KV non contiguë de PageDaTtention, cette approche permet d'obtenir une utilisation GPU de 2 à 4 × plus par rapport à la mise en lots statique sur le même matériel au même volume de requête.
KV-Cache Management — The Memory Math
Le KV-Cache stocke les clés d'attention et les valeurs de chaque jeton dans la fenêtre contextuelle afin d'éviter le recalage lors du décodage. Exigence de mémoire par demande :
octets de cache kv = 2 × num_layers × num_heads × head_dim × sequence_length × octets_per_element
Pour LLAMA-3-70B à FP16 (2 octets/élément, 80 couches, 8 têtes, 128 têtes_dim) avec un contexte de 4 096 jetons : ~ 42 Mo par demande simultanée. Avec 1 000 utilisateurs simultanés, c'est 42 Go de KV-Cache seul - avant les poids du modèle. La quantification du KV-Cache à Int8 réduit la moitié de ce nombre à 21 Go, permettant à environ 2 × utilisateurs simultanés plus d'utilisateurs sur le même matériel.
décodage spéculatif
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
Pré-remplissage et portion désagrégées
Pour les charges de travail à long contexte, le pré-remplissage en morceaux divise une grande invite en morceaux plus petits traités de manière séquentielle, permettant à l'étage de décodage d'intercaler les jetons des demandes existantes pendant les lacunes de pré-remplissage. Le service désagrégé va encore plus loin en exécutant le pré-remplissage et le décodage sur des pools de GPU distincts – pré-remplissage sur du matériel optimisé pour le calcul (H100 SXM), décoder sur du matériel optimisé pour la bande passante (H200) – une meilleure utilisation des ressources et une meilleure utilisation des ressources. Latence p99 réduite simultanément.
Cadres de service d'inférences d'IA — Comparaison face à face
Le cadre de service que vous choisissez est aussi important que le matériel. Chacune a des forces, des limites et une complexité opérationnelle différentes :
| Cadre | Débit (relatif) | Facilité d'installation | Prise en charge du GPU | force clé | Licence |
| VLLM 0.5+ | Élevé (1,0 × Base de référence) | Facile (installation de pip) | NVIDIA, AMD ROCM | Batching continu, communauté la plus importante, API compatible OpenAI | Apache 2.0 |
| Tensorrt-llm | le plus élevé (1,3–1,6×) | Complexe (compilation de moteur) | Nvidia uniquement | Débit maximal NVIDIA, mise en lots en vol, FP8/FP4 | Apache 2.0 |
| TGI (visage étreint) | Moyenne (0,85×) | Facile | Nvidia, AMD, Gaudi | Intégration du hub de modèle de visage, prise en charge large du modèle | Apache 2.0 |
| sglang | Élevé (1,1–1,2×) | MOYEN | NVIDIA, AMD | Mise en cache des préfixes, RadixAttention, performances de sortie structurées | Apache 2.0 |
| lama.cpp | Faible (CPU viable) | Très facile | CPU, CUDA, Métal, Vulkan | Inférence CPU/EDGE, dépendances minimales, quantification large | mit |
| Nvidia Triton | Varie (emballage) | Complexe | Nvidia (principalement) | Service multi-modèles, backend indépendant du cadre, MLOPs d'entreprise | Clause 3 BSD |
Sécurité, confidentialité et conformité pour l'inférence d'IA
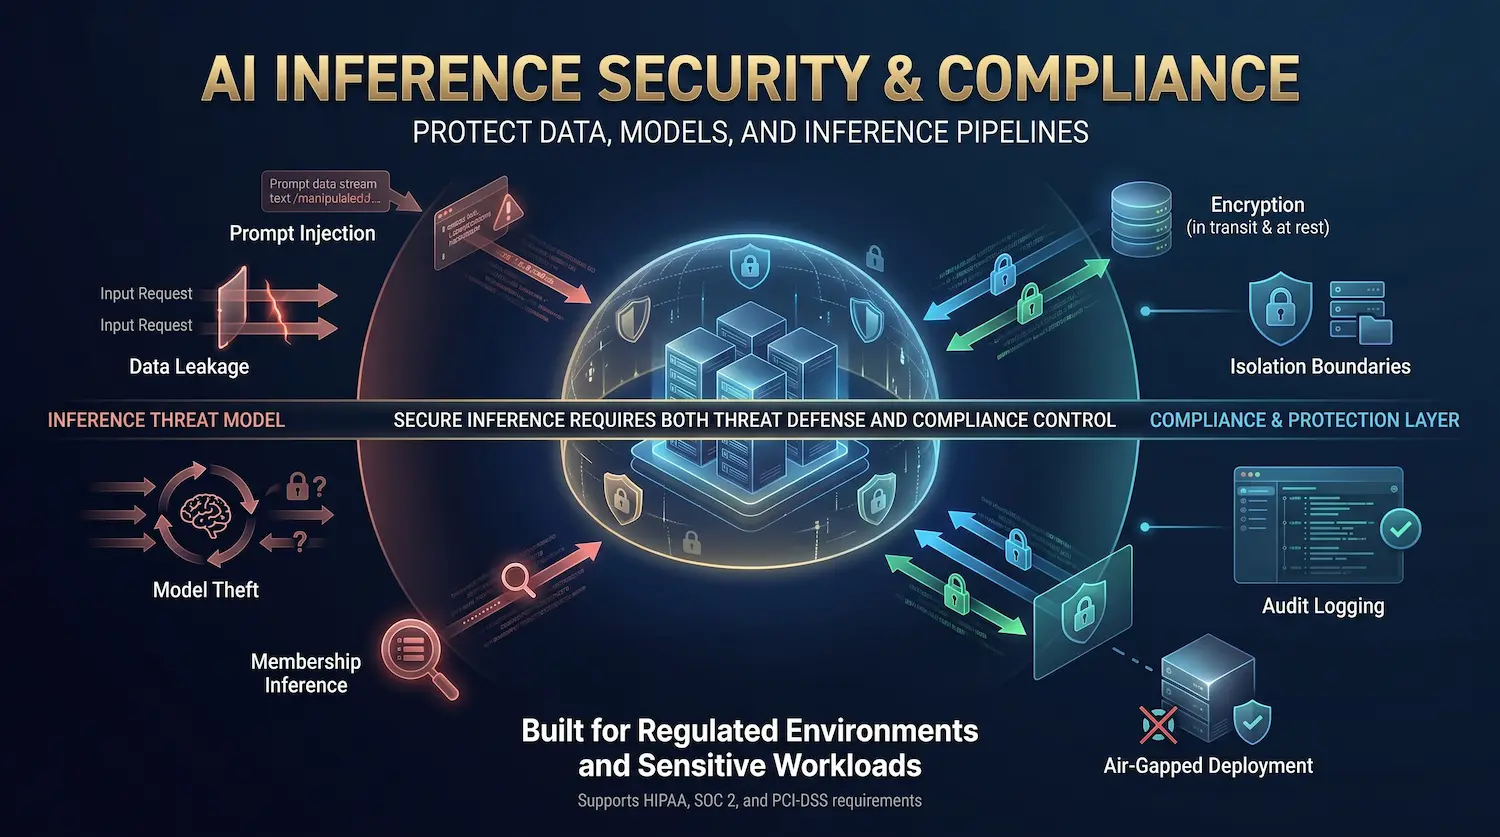
L'exécution d'une inférence d'IA dans des industries réglementées ou avec des données sensibles nécessite de comprendre le modèle de menace complet et la posture de conformité.
Modèle de menace de sécurité d'inférence
- Injection d'invite : entrées malveillantes intégrées dans les données utilisateur tentent de remplacer les instructions du système ou d'extraire des données d'apprentissage.
- Fuite de données : informations sensibles provenant de la demande d'un utilisateur fuit dans la réponse d'un autre utilisateur via la contamination croisée de KV-Cache (atténuée par l'isolement du cache par utilisateur).
- Vol du modèle : les requêtes contradictoires répétées tentent de reconstruire les poids du modèle via l'analyse de sortie.
- Inférence des membres : les attaquants déterminent si des données spécifiques sont apparues dans l'ensemble de formation du modèle.
Cadres de conformité
Pour l'inférence d'IA conforme à la HIPAA : toutes les données doivent rester dans votre limite de contrôle, le cryptage en transit (TLS 1.3) et le cryptage au repos (AES-256) sont obligatoires et la journalisation d'audit de toutes les demandes d'inférence doit être conservée. La conformité du SOC 2 de type II nécessite des audits de sécurité neutres par les fournisseurs et une réponse aux incidents documentée. Les environnements PCI-DSS doivent utiliser des serveurs d'inférence à intervalles aériens sans connectivité Internet. Le déploiement sur site, plutôt qu'une infrastructure partagée dans le cloud ou une API, est la seule architecture qui satisfait simultanément les trois frameworks sans des contrôles de compensation significatifs.
Atal Networks’ infrastructure de serveurs dédiée Prend en charge les déploiements à intervalles aériens pour l'inférence d'IA réglementée. Contactez-nous au atalnetworks.com pour discuter de vos exigences de conformité.
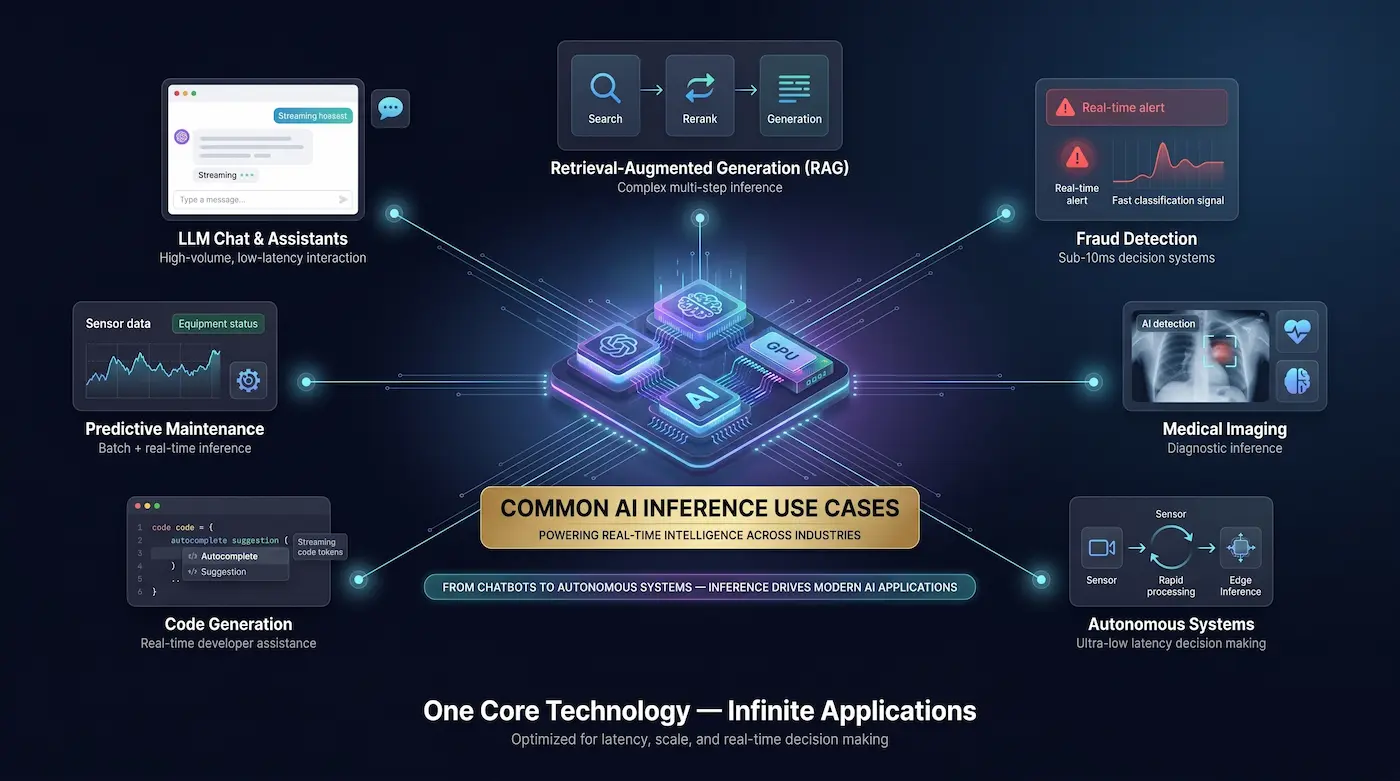
Cas d'utilisation d'IA d'inférence courants
L'inférence d'intelligence artificielle alimente un large éventail d'applications de production dans tous les secteurs :
- Chat et assistants LLM : bots de service à la clientèle, assistants de connaissances internes, codage des copilotes - tous sont des charges de travail d'inférence à volume élevé et sensibles à la latence.
- Récupération-Augmented Generation (RAG) : combine un modèle d'intégration (pour la recherche sémantique), un reranker et un LLM dans un pipeline d'inférence en trois étapes. Chaque étape ajoute de la latence et du coût.
- Détection de la fraude : inférence de classification en temps réel à une latence inférieure à 10 ms à l'aide de modèles spécialisés plus petits.
- Imagerie médicale : inférence CNN et Vision Transformer pour la radiologie, la pathologie et les diagnostics - nécessitant souvent un déploiement sur site pour la conformité HIPAA.
- Véhicules autonomes : inférence de perception de la latence en millisecondes sur du matériel embarqué spécialisé (ORIN, D5).
- Génération de code : l'inférence de streaming pour la saisie semi-automatique nécessite une ITL extrêmement faible (< 15 ms) pour se sentir en temps réel.
- Flux de travail agentic : les agents d'appel d'outils en plusieurs étapes génèrent de nombreux appels d'inférence par tâche d'utilisateur, multipliant les réponses aux coûts de 5 à 20 × par rapport à un tour.
- Maintenance prédictive : inférence par lots sur les flux de données de capteurs pour prédire la défaillance de l'équipement.
L'avenir de l'inférence d'IA — 2026 et au-delà
Plusieurs tendances remodelent le paysage d'inférence jusqu'en 2026 et en 2027 :
- Les modèles de raisonnement et la mise à l'échelle du temps de test : comme l'ont démontré DeepSeek-R1 et Gemini 2.5 2.5, générant davantage de jetons au moment de l'inférence améliore de manière fiable la qualité de sortie sur des tâches complexes. Cela modifie fondamentalement la courbe de coût - la facture d'inférence par requête augmente, pas diminue.
- Dominance du mélange d'experts (MOE) : les architectures de MOE comme Mixtral 8 x 22b n'activent qu'une fraction des paramètres par jeton, offrant des performances de classe GPT-4 à un coût de calcul d'inférence inférieur de 2 à 3 ×. Attendez-vous à ce que MoE domine les nouvelles versions de modèles.
- Servir désagrégé et spéculatif à grande échelle : la séparation des pools de pré-remplissage et de décodage, combinée au décodage spéculatif de style Eagle, devient l'architecture de production standard pour les déploiements de LLM à grande échelle.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- Modèles Frontière sur l'appareil : Apple Intelligence, Gemini Nano et PHI-3-mini démontrent que les modèles quantifiés 3B–7B peuvent fonctionner entièrement sur du matériel grand public. La frontière entre le nuage et l'inférence de bord est floue.
- L'IA souveraine et la résidence sur les données : les pressions géopolitiques poussent les entreprises et les gouvernements à exiger la pleine souveraineté des données - inférence à l'intérieur de leurs frontières nationales, sur le matériel qu'ils possèdent. La demande sur site va croître, et non diminuer.
Foire aux questions (FAQ)
Qu'est-ce que l'inférence d'IA en termes simples ?
L'inférence d'IA est lorsqu'un modèle d'IA formé utilise ce qu'il a appris pour répondre à une nouvelle question ou accomplir une nouvelle tâche. La formation enseigne le modèle; L'inférence est le modèle qui fait son travail. Chaque fois que vous recevez une réponse de ChatGPT, recevez une recommandation de produit ou voyez une alerte de fraude, c'est-à-dire une inférence d'IA qui se produit en temps réel.
Quelle est la différence entre l'inférence d'IA et la formation en IA ?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
Est-ce que ChatGPT est une inférence ou une formation ?
Lorsque vous discutez avec chatgpt, vous déclenchez une inférence - les poids du modèle sont fixes et les applique à votre entrée pour générer une réponse. OpenAI forme (et recycle périodiquement) GPT-4 séparément, sur de vastes ensembles de données, à un coût énorme. Ce sont deux opérations totalement différentes. Ce que vous ressentez en tant qu'utilisateur est une inférence de 100%.
Quel matériel est utilisé pour l'inférence d'IA ?
Le matériel dominant pour l'inférence à grande échelle est les GPU NVIDIA (H100, H200, B200, L40), les GPU AMD (MI300X, MI355X) et les TPU Google pour les charges de travail natives dans le cloud. Pour une inférence Edge : Apple Neural Engine, Qualcomm Hexagon NPU et Nvidia Jetson Orin. Pour les déploiements sensibles aux coûts ou CPU, les processeurs Intel Xeon (AMX) et AMD EPYC modernes peuvent exécuter des modèles quantifiés à un débit acceptable.
Quel est le meilleur GPU pour l'inférence d'IA en 2026 ?
Pour les grands modèles (70B+) : le NVIDIA H200 SXM5 (141 Go HBM3E, 4,8 To/s) offre la meilleure performance par dollar pour la plupart des charges de travail. Pour un débit maximal sur les modèles Frontier : les fils B200 SXM6. Pour le milieu de gamme sensible aux coûts : l'AMD Mi300X (192 Go HBM3, $10K–$15 K inférieur à H200) est de plus en plus compétitif. Pour l'inférence EDGE/Single-GPU : le NVIDIA L40S (48 Go GDDR6) équilibre bien le coût et la capacité.
Comment fonctionne l'inférence LLM étape par étape ?
- Tokenisation : le texte d'entrée est converti en ID de jetons entiers. 2. PreFill : tous les jetons d'entrée sont traités simultanément dans une seule passe avant, générant le kv-cache et le premier jeton de sortie. 3. Decode : les nouveaux jetons sont générés un par un, chacun s'occupant du kv-cache complet. 4. Batch continu : plusieurs demandes simultanées partagent le calcul du GPU via un traitement par lots en vol. 5. Streaming : les jetons de sortie sont détokalisés et diffusés en continu sur le client au fur et à mesure de leur génération.
Que sont TTFT et ITL dans l'inférence LLM ?
TTFT (Time to First Token) mesure la durée de la soumission de la demande jusqu'à ce que le premier jeton de sortie soit renvoyé - la latence perçue par l'utilisateur comme "temps d'attente". Il est dominé par la phase de pré-remplissage. ITL (latence inter-tokens) mesure le temps moyen entre les jetons de sortie consécutifs pendant le décodage - ce qui détermine la "vitesse de diffusion" que l'utilisateur voit. Les deux doivent être optimisés pour le chat en temps réel : généralement TTFT < 200 ms et ITL < 30 ms pour une expérience réactive.
Qu'est-ce qu'un KV-Cache et pourquoi est-ce important ?
Le KV-Cache (key-value cache) stocke les calculs d'attention intermédiaire (clés et valeurs) pour chaque jeton dans le contexte de la conversation. Sans cela, le modèle devrait retraiter l'intégralité de la fenêtre contextuelle pour chaque nouveau jeton - O (n²) Compute. Avec lui, chaque étape de décodage ne traite qu'un seul nouveau jeton, ce qui rend l'inférence LLM réalisable. La taille du cache kv est une contrainte principale sur le nombre d'utilisateurs simultanés qu'un GPU peut desservir et la durée de la fenêtre de contexte.
Combien coûte l'inférence d'IA pour les jetons de 1 M ?
sur du matériel auto-hébergé (8×H200, amortissement sur 3 ans, $0.12/kWh, 80%, utilisation, Llama-3-70B FP8) : $0.18 par jetons d'entrée 1M et $0.71 par jetons de sortie 1M. Via l'API publique : GPT-4O coûte 1 TP4T2.50/$10.00 Input/Sortie pour 1 M tokens ; Claude Sonnet coûte $3.00/$15.00. L'auto-hébergement à grande échelle permet une réduction de 5 à 20 ×, avec un seuil de rentabilité généralement à 5 à 15 M jetons de sortie/jour en fonction du fournisseur et du modèle d'API.
Pouvez-vous exécuter une inférence d'IA sur un processeur ?
Oui — pour les modèles plus petits et quantifiés. Llama.cpp Active l'inférence int4/int8 sur n'importe quel processeur x86. Un Xeon Platinum à double socket avec AMX génère environ 25 à 40 jetons/s sur un modèle 7B Int4, ce qui est adéquat pour les charges de travail non temps réel. L'inférence de CPU n'est pas viable pour les modèles 70B+ au débit de production. L'économie fonctionne pour le développement, les tests et les tâches de traitement par lots où le coût de location du GPU dépasse la valeur du débit.
Quelle est la différence entre le préfill et le décodage dans l'inférence LLM ?
PreFill traite l'intégralité de l'invite d'entrée en une seule opération parallèle (calcul, rapide, mise à l'échelle avec une longueur d'invite). Decode génère des jetons de sortie un à la fois dans une boucle autorégressive (mémoire-bande passante, plus lente par jeton, mise à l'échelle avec la longueur de sortie et les utilisateurs simultanés). La transition entre eux - lorsque le premier jeton est généré - est TTFT. L'optimisation du pré-remplissage réduit le TTFT ; L'optimisation du décodage réduit l'ITL et améliore le débit.
Quand faut-il auto-héberger une inférence d'IA ou utiliser une API ?
Utilisez une API lorsque : le volume est faible (< 2 m tokens/jour), vous avez besoin d'un modèle Frontier fermé (GPT-4O, Claude), ou vous êtes en prototypage et vous souhaitez zéro CAPEX. Auto-hôte lorsque : Le volume dépasse 5 millions de jetons/jour, la confidentialité des données ou la conformité l'exige, vous souhaitez affiner ou contrôler le modèle, ou vous avez besoin d'un SLA garanti sans limite de tarif. Le seuil de rentabilité par rapport à la plupart des API est de 3 à 18 mois selon le modèle et le volume, après quoi on-prem se compare favorablement pendant des années.
Construisez ou achetez - Prochaines étapes avec Atal Networks
Si vous avez atteint ce point, vous avez une image complète de ce qu'est l'inférence d'IA, de son fonctionnement, de son coût et de ce que le matériel alimente. La question suivante est l'exécution.
Atal Networks est spécialisé dans l'infrastructure d'inférence d'IA conçue pour les entreprises qui ont dépassé la dépendance de l'API. Notre équipe a conçu et déployé des clusters GPU dans les secteurs de la santé, des services financiers, de la fabrication et des logiciels, et nous publions les données de référence, et pas seulement la brochure.
Explorez notre Configurations de serveurs dédiés Pour les déploiements d'inférences sur site à haut débit avec des systèmes H100, H200 et MI300X.
Vous cherchez un point d'entrée bas-fond ? Notre Plans VPS optimisés pour les GPU Laissez-vous commencer à exécuter des charges de travail d'inférence privées aujourd'hui sans posséder le rack.
Prêt à parler de chiffres ? Visiter atalnetworks.com Et parlez directement avec un ingénieur matériel, pas un script de vente.
