 Перейти к содержимому



По Главный инженер по оборудованию, Atal Networks | MLPERF v4.1 Автор | Архитектура кластера GPU 12 лет | Обновлено: 19 апреля 2026 г.
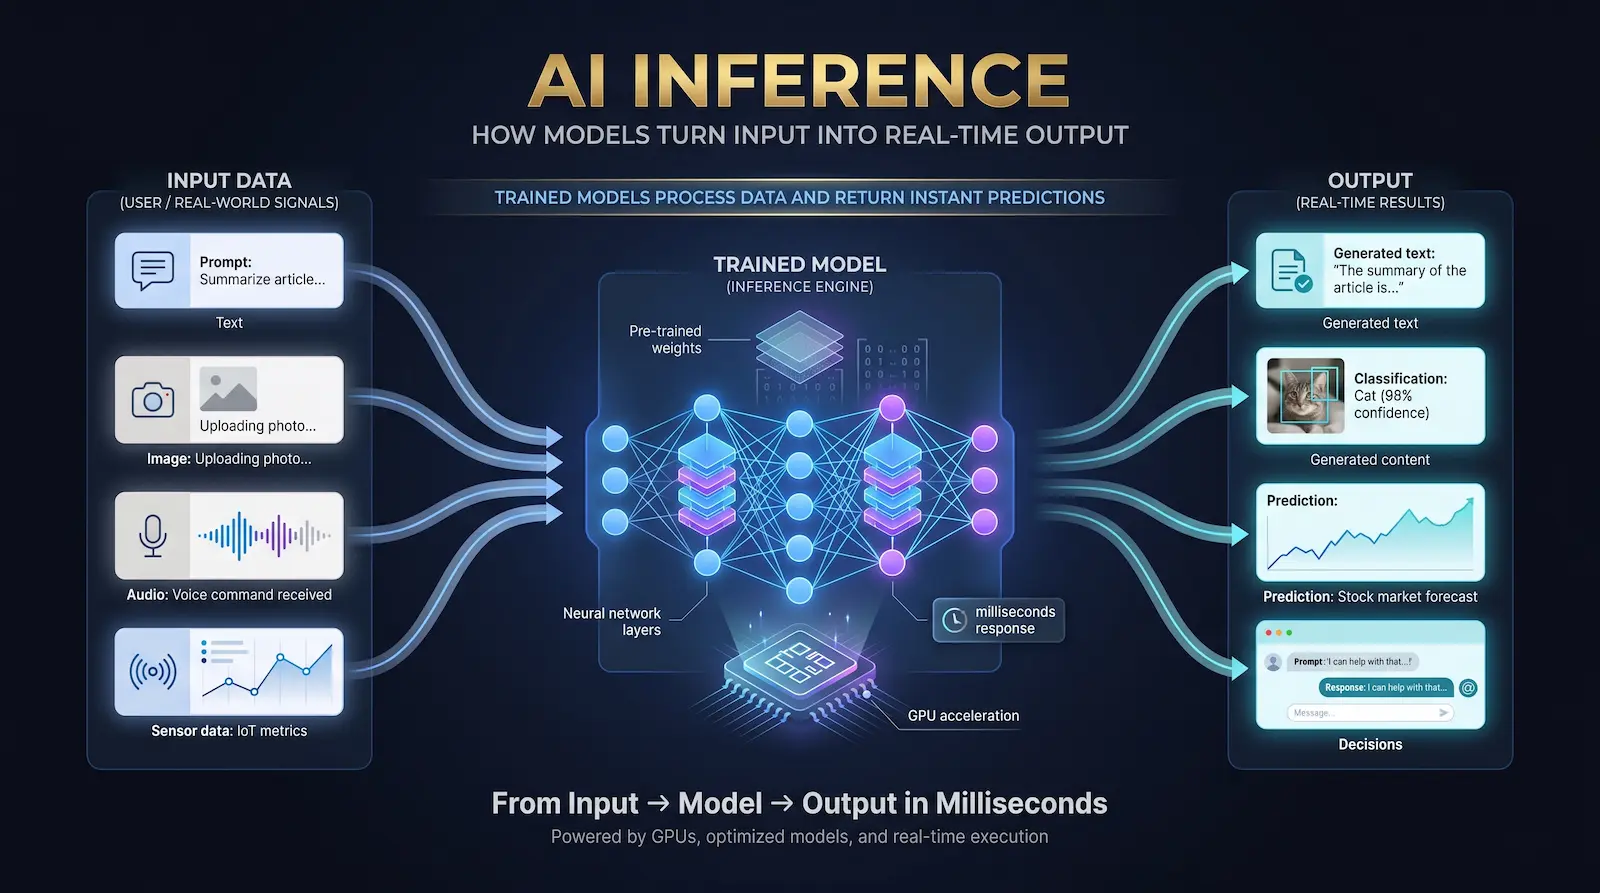
| TL;DR — Что такое вывод AI? Вывод AI — это процесс запуска обученной модели искусственного интеллекта для новых входных данных для создания прогноза, классификации или генерируемого вывода. Это фаза «делания» ИИ — каждый ответ ChatGPT, предупреждение о мошенничестве, подпись к изображению и звонок о самоуправляемом восприятии — это событие. В 2026 году вывод потребляет примерно две трети от общего объема расходов на искусственный интеллект в мире. Это руководство охватывает полный конвейер, аппаратное обеспечение, которое питает его, метрики, которые измеряют его (TTFT, ITL, токены/сек), и то, что стоит запустить — с бенчмарками, измеренными на собственных серверах Atal Networks. |
Что такое вывод ИИ? Определение с одним предложением
| Определение Вывод AI — это выполнение обученной модели машинного обучения на новых невидимых данных для получения результатов, таких как текстовая реакция, классификация изображений, оценка мошенничества или перевод без изменения веса модели. |
Подумайте об этом так: научиться водить машину — это тренироваться. Каждый раз, когда вы действительно едете куда-то, это вывод. Модель (ваши навыки вождения) фиксирована; Меняется только вход (дорожка). С технической точки зрения вывод — это прямой проход через нейронную сеть — данные потоки в одном направлении через уровни модели вычисляются активации и производится вывод. В отличие от тренировок, здесь нет вычислений градиента, нет обновлений веса и обратного пропуска.
Различие имеет большое значение на практике. Тренировка происходит один раз (или периодически). Вывод происходит миллиарды раз в день. Оптимизация для вывода — более низкая задержка, более высокая пропускная способность, более низкая стоимость токена — это то, где в 2026 году живет реальная инженерная задача.
Почему вывод ИИ имеет значение сейчас — контекст 2026 года
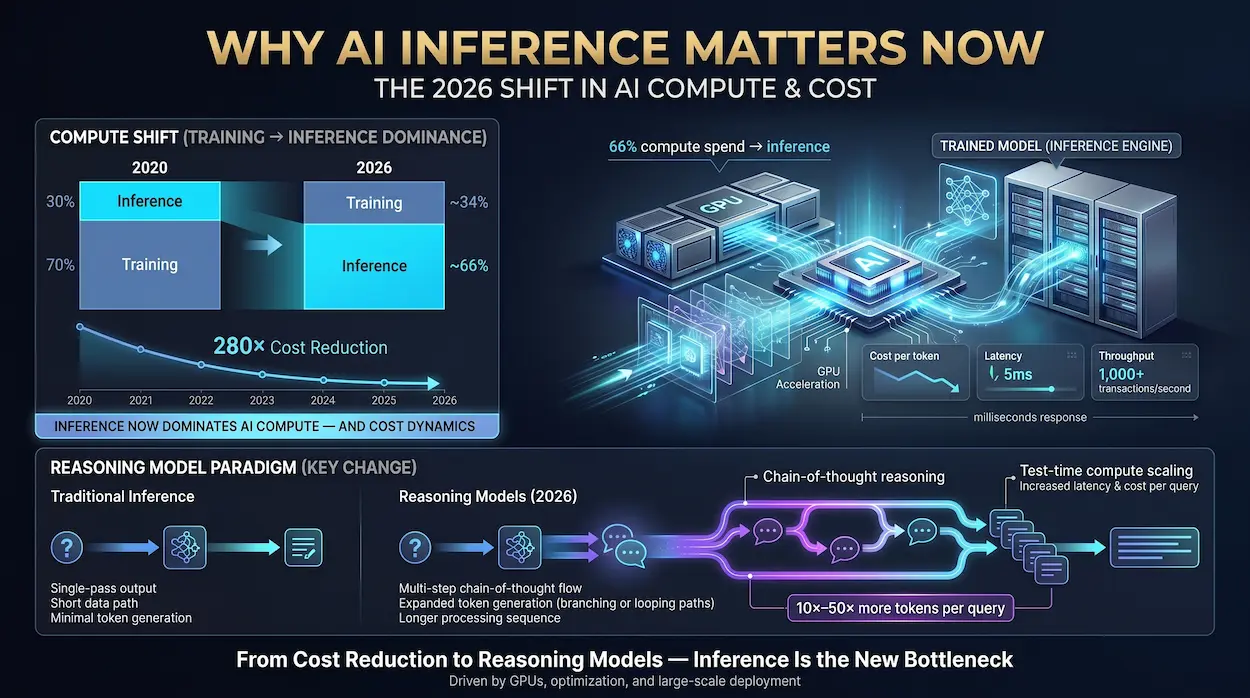
Вывод теперь доминирует над расходами на вычислительные средства ИИ
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
Точка перегиба модели рассуждений
Такие модели, как DeepSeek-R1, Gemini 2.5 Thinking и Llama Nemotron Ultra, представили новую парадигму вывода: масштабирование вычислений во время тестирования. Вместо того, чтобы давать ответ за один форвардный проход, эти модели «думают», создавая расширенные токены цепочки мыслей, прежде чем отвечать. Это умножает количество токенов, сгенерированных на запрос, на 10–50 раз, что значительно увеличивает стоимость вывода и задержку, а также изменяя конфигурацию оборудования для данной рабочей нагрузки.
Почему существует это руководство
Каждое определение статьи в Интернете описывает вывод ИИ на уровне глоссарии. Ни одна из них не публикует данные о тестах, реальные цены за токен, или стойку TCO Math. Мы написали это руководство, потому что мы создаем и эксплуатируем серверы и считаем, что покупатели заслуживают фактических цифр, а не абстракции маркетинга.
Atal Networks предлагает корпоративный класс выделенные серверы и VPS-решения Специально разработан для рабочих нагрузок вывода искусственного интеллекта. Проводить исследования atalnetworks.com чтобы узнать больше.
Как работает вывод ИИ — шаг за шагом
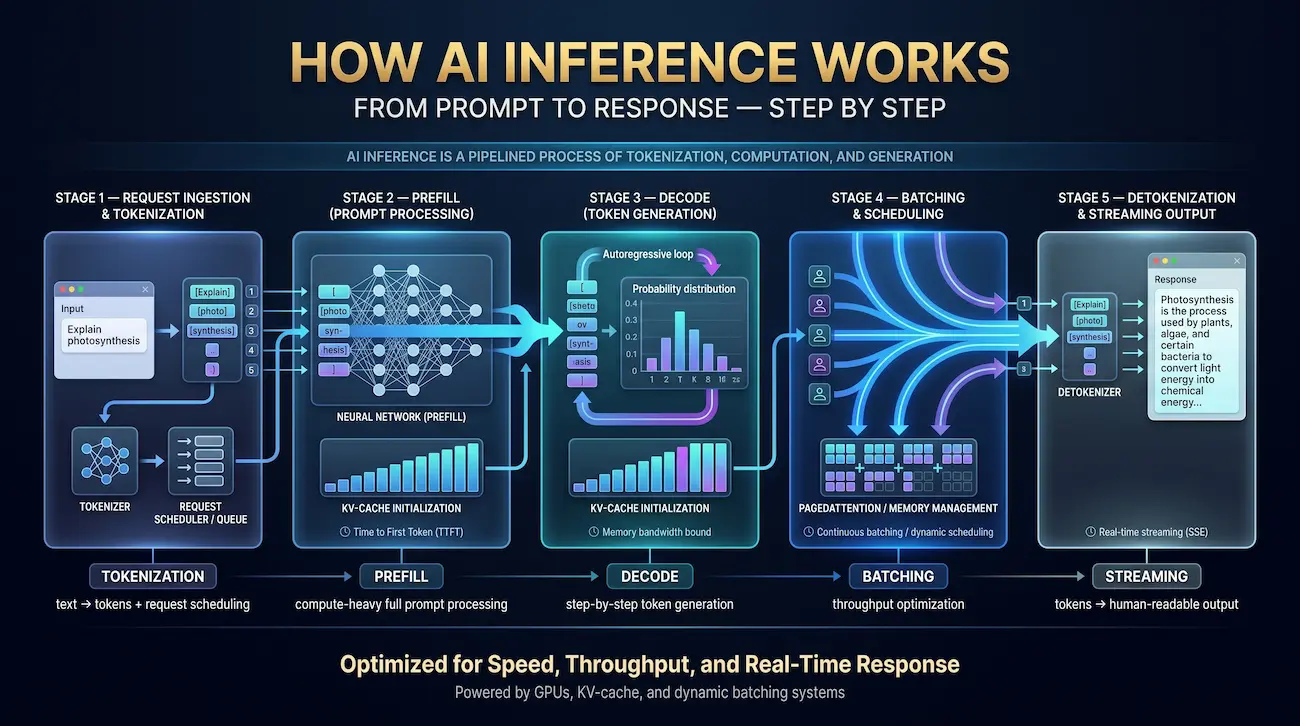
Понимание вывода ИИ требует отслеживания одного запроса в течение его полного жизненного цикла. Для большой языковой модели (LLM) конвейер имеет пять отдельных этапов:
Шаг 1: Запросите прием и токенизацию
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
Шаг 2: этап предварительного заполнения (обработка подсказки)
Во время предварительной заполнения вся вводная подсказка обрабатывается одновременно за один проход. Этот этап связан с вычислениями — он линейно масштабируется с длиной подсказки и является основным фактором времени для первого токена (TTFT). Системная подсказка 2048 токенов занимает примерно в два раза больше времени в предварительной заполнении, чем приглашение 1024 токена. Prefill генерирует начальный кэш KV (кэш-ключ-значение), который хранит промежуточные вычисления внимания, поэтому их не нужно пересчитывать во время декодирования.
Шаг 3: этап декодирования (генерация токенов)
После предварительного заполнения модель входит в стадию декодирования, генерируя один токен за раз в авторегрессионном цикле. Каждый новый токен зависит от всех предыдущих токенов — модель удовлетворяет полный кеш, производит распределение вероятностей по его лексике (~ 32 000–128 000 токенов), выборки из этого распределения и добавление выбранного токена. Этап декодирования связан с пропускной способностью памяти, а не с вычислительной линией. Вот почему пропускная способность HBM (не FLOPS) является решающей аппаратной спецификацией для вывода LLM — факт, что каждая таблица GPU закапывается в мелкую печать.
Шаг 4: Пакетирование и планирование
Наивный сервер вывода обрабатывал по одному запросу за раз, оставляя графический процессор в основном бездействовать во время декодирования (поскольку один токен за раз медленный). В современных системах используется непрерывная группировка (также называемая в полете или динамическая группировка): запросы сгруппированы в середине полета, новые запросы присоединяются к пакету, поскольку слоты открыты, а завершенные последовательности вытесняются без ожидания завершения всех запросов. Реализация VLLM PageDattention (Kwon et al., SOSP 2023) еще больше улучшила это, управляя памятью KV-кэша на несмежных страницах, аналогично виртуальной памяти в ОС, что дает 2–4-кратное усиление пропускной способности по статической Распределение.
Шаг 5: Детокенизация и потоковая передача ответов
После того, как модель генерирует токен окончания последовательности (или достигает предела максимальной длины), идентификаторы выходных токенов детокенизируются обратно в читаемый человеком текст и передаются клиенту. Большинство производственных систем используют события, отправленные сервером (SSE) для потоковой передачи, доставляющие маркеры по мере их создания, а не ожидающие полного ответа. Это значительно увеличивает воспринимаемую задержку — пользователь видит первое слово примерно за 200 мс, даже если полный ответ занимает 10 секунд.
AI Inference vs. AI Training — реальная разница
Большинство введений сочетают в себе обучение и выводы или рассматривают разницу в зависимости от времени. Техническое различие глубже и имеет глубокие последствия для оборудования:
| Измерение | Обучение | Вывод |
| Цель | Отрегулируйте вес модели, чтобы свести к минимуму потери | Примените фиксированные веса для производства продукции |
| Вычислительная модель | Вперед + обратный проход + шаг оптимизатора | Только вперед проход |
| узкое место в памяти | Активации (связанные с флопами) | KV-кэш + вес (привязанность к полосе пропускания) |
| Частота | Периодический (дни/недель за пробежку) | Миллиарды раз в день в производстве |
| Аппаратная цель | Максимальная пропускная способность флопа (H100 SXM5) | Максимальная пропускная способность HBM (H200, B200) |
| Размер партии | Большой (1024–4096+ проб) | Малый и средний (1–256 одновременный) |
| Точность | BF16/FP16/FP8 смешанный | FP8, Int8, Int4 сильно квантован |
| структура затрат | CAPEX-интенсивный, одноразовый (за тренировочный запуск) | Opex-интенсивная, текущая стоимость за токен |
Единственная самая важная строка в таблице выше: обучение связано с флопами; Вывод связан с шириной полосы hbm. Этот единственный факт объясняет, почему NVIDIA H200, которая имеет идентичное количество ядер CUDA, что и H100, но 141 ГБ HBM3E с пропускной способностью 4,8 ТБ/с по сравнению с 80 ГБ H100 AT 3,35 ТБ/с — превосходит H100 в выводе LLM, несмотря на отсутствие дополнительной обучающей пропускной способности. Когда вы покупаете аппаратное обеспечение для вывода, вы покупаете пропускную способность памяти, а не флопы.
Типы рабочих нагрузок вывода ИИ
Не все выводы выглядят одинаково. Тип рабочей нагрузки определяет конфигурацию оборудования, фреймворк, стратегию оптимизации и структуру затрат, которая имеет смысл:
| Тип | Цель задержки | Пример использования | Аппаратное значение |
| Онлайн/в режиме реального времени | < 200 мс TTFT, < 30 мс ITL | Чат, вторые пилоты, обнаружение мошенничества | Низкий размер партии, быстрая HBM, NVMe для загрузки веса |
| Пакет/офлайн | минут до часов (приоритет пропускной способности) | Суммирование документов, обогащение данных | Высокий уровень использования GPU, крупная партия, более дешевые графические процессоры |
| Текучий | Низкий TTFT, устойчивый ITL | Завершение кода, голосовые помощники | Потоковая передача SSE, низкий приоритет декодирования |
| Ребра/на-устройство | < 10 мс, < 5 Вт TDP | Мобильный AI, IoT, автономные транспортные средства | NPU, Jetson Orin, квантованные модели INT4/INT8 |
| Бессерверный | Холодный старт < 2 с, с оплатой за запрос | Приложения с низким трафиком, dev/test | Спотовые графические процессоры, быстрая загрузка веса, холостой ход = ноль стоимости |
Где работает вывод ИИ — облако, on-prem, edge, on-device
Каждая среда развертывания включает в себя другую матрицу компромисса. Правильный ответ зависит от ваших требований к задержке, обязательств по конфиденциальности данных, объема запроса и горизонта бюджета:
| Среда | Латентность | Конфиденциальность данных | Модель затрат | Типичное оборудование | лучше всего для |
| Публичный API (OpenAI, антропный) | Низко-средний | Общая инфраструктура | Плата за токен (самый высокий $/токен) | Управление поставщиком | Быстрое прототипирование, малообъемный |
| Облачный GPU (AWS, GCP, Azure) | Низко-средний | Возможна изоляция VPC | $/GPU-HR + выход | H100, A100, L40S экземпляры | Переменный спрос, без капиталовложений |
| On-Prem (выделенные серверы) | самый низкий | Полный контроль данных, возможен воздушный зазор | CAPEX + OPEX (самый низкий $/токен в масштабе) | Кластеры H100/H200/B200 | Большой объем, регулируемый, чувствительный к стоимости |
| Edge Server (Colo/On-Site) | Очень низко | Локальные данные остаются локальными | Смешанные сборы CAPEX + Коло | L40S, А30, Гауди 3 | Производство, здравоохранение, розница |
| На устройстве (телефон, ПК, IoT) | Сверхнизкий (< 10 мс) | Полная изоляция данных | Без регулярных затрат | Apple NPU, шестигранник Qualcomm, Jetson | Конфиденциальность, автономные сценарии |
Для организаций, обрабатывающих более ~5 млн токенов в день, локальные выделенные серверы Постоянно предлагают самую низкую общую стоимость владения. Для команд, нуждающихся в гибкости и меньших первоначальных инвестициях, VPS-решения Может преодолеть разрыв между зависимостью API и полным ON-PREM владением.
Аппаратное обеспечение за выводом ИИ
Аппаратный ландшафт для вывода ИИ быстро диверсифицировался. В 2023 году ответ был прост: H100. В 2026 году оптимальный выбор зависит от размера модели, цели задержки, бюджета мощности и требований по цене за токен.
Семейства графических процессоров для вывода — 2026 Сравнение
| ГПУ | Емкость ГБМ | пропускная способность ГБМ | FP8 TFLOPS | ТДП (Вт) | лучше всего для |
| NVIDIA H100 SXM5 | 80 ГБ HBM2E | 3,35 Тб/с | 3,958 | 700 Вт | Производство LLM Baseline, хорошо поддерживаемая экосистема |
| NVIDIA H200 SXM5 | 141 ГБ HBM3E | 4,8 ТБ/с | 3,958 | 700 Вт | Большие модели (70b+), чувствительная к полосе памяти |
| NVIDIA B200 SXM6 | 192 ГБ HBM3E | 8,0 ТБ/с | 9000 (FP4) | 1000 Вт | Модели Frontier, самая высокая пропускная способность, флагман 2026 года |
| AMD MI300X | 192 ГБ HBM3 | 5,3 ТБ/с | 5,220 | 750 Вт | Конкурентная альтернатива H200, большая пропускная способность |
| AMD MI355X | 288 ГБ HBM3E | 8,0 ТБ/с | 8,000+ | 750 Вт | Крупнейшие модели, очень высокая параллелизм |
| Интел Гауди 3 | 128 ГБ HBM2E | 3,7 ТБ/с | 1835 (BF16) | 900 Вт | Экономичная рабочая нагрузка, открытая экосистема |
| Google TPU v5e | 16 ГБ HBM2 (на чип) | 819 ГБ/с (в чип) | 393 (на чип) | ~170 Вт | Google Cloud-Native, оптимизированная для трансформаторов |
| NVIDIA L40S | 48 ГБ GDDR6 | 864 Гб/с | 1,457 | 350 Вт | Вывод краев, модели вычислительного света, смешанные рабочие нагрузки |
Когда вывод CPU имеет смысл
Для моделей с параметрами ~7B, работающих с точностью INT4, современные процессоры с наборами инструкций AVX-512 или AMX могут обеспечить приемлемую пропускную способность для рабочих нагрузок с устойчивостью к задержке. llama.cpp сделал вывод CPU практичным: 4-битная квантованная квантованная LLAMA-3-8B работает со скоростью ~ 25–35 токенов в секунду в системе Xeon Platinum с двумя разъемами. Экономика работает, когда стоимость GPU является непомерно высокой, а требования к задержке превышают ~2 секунды.
NPU, TPU, FPGA и ускорители ASIC
Помимо графических процессоров, появляется растущая экосистема специализированного кремния. Блоки нейронной обработки (NPU) теперь встроены в большинство потребительских устройств (Neural Engine от Apple M-Series, Qualcomm Hexagon, Intel NPU) и целевой вывод краев до 5 Вт. TPU (Google) оптимизированы для матрицы трансформаторов в облачной службе. FPGA предлагают реконфигурацию для пользовательских схем квантования, но требуют значительных инженерных усилий. ASICS (GROQ LPU, Cerebras WSE) может достигать необычайной задержки в фиксированных рабочих нагрузках, но им не хватает гибкости стеков GPU.
Почему нетворкинг имеет значение для вывода крупных моделей
Для использования модели 405B-параметров требуется распределение по 8–16 графическим процессорам. Межсоединение между этими графическими процессорами становится узким местом производительности. NVIDIA NVLink (в узле DGX) обеспечивает 900 ГБ/с GPU-к GPU-полосе GPU — примерно в 18 раз быстрее, чем PCIe Gen5. В разных узлах InfiniBand NDR (400 Гбит/с) или NVIDIA Spectrum-X Ethernet значительно превосходит товар 100 GbE. В наших тестах переход со 100 GbE на InfiniBand NDR на тензор-параллельное развертывание LLAMA-3-405B 8 × H100 улучшила декодирование 34%.
Метрики вывода AI, которые на самом деле имеют значение
Большинство дискуссий о выводах смутно измеряют задержку. Для производственных развертываний требуются точные стандартизированные метрики с целями SLA. Вот метрики, которые имеют значение и как их измерить:
| Метрика | Определение | Целевой показатель SLA в отрасли | Аппаратный драйвер |
| TTFT (время до первого жетона) | время от подачи запроса до первого сгенерированного токена | < 200 мс (чат), < 500 мс (партия) | Ширина полосы памяти GPU, эффективность предварительного заполнения |
| ITL (задержка между токеном) | Среднее время между последовательными генерируемыми токенами во время декодирования | < 30 мс (чат), < 100 мс (партия) | Полоса пропускания HBM, скорость доступа кеш-кВ |
| Пропускная способность (токены/сек) | Суммарные выходные токены, генерируемые в секунду для всех одновременных пользователей | Зависит от рабочей нагрузки | GPU Flops + эффективность пакета |
| хороший попутный | Производительность запросов, отвечающих целям SLA | Максимально для данного SLA | Эффективность планировщика, управление очередями |
| P50 / P99 задержка | Медиана и 99-й процентиль сквозная задержка | P99 < 2× P50 (хорошо настроенная система) | Задержка хвоста, термическая дросселирование, глубина очереди |
| Использование GPU | Доля времени, в течение которого вычислительные единицы GPU активны | Цель 70–85% выдержана | Размер партии, непрерывная эффективность дозирования |
| RPS (запросы в секунду) | Параллельные запросы, обрабатываемые системой в целевом SLA | Масштабная цель | Комбинированная эффективность TTFT + ITL + партия |
Сколько стоит вывод ИИ в 2026 году — реальные цифры
Цена за токен — это метрика, которая в конечном итоге определяет решения по сборке и покупке. Следующие данные были измерены на производстве оборудования Atal Networks в условиях устойчивой нагрузки. Допущения: $0.12/кВтч электричество, 3-летняя амортизация оборудования, использование графического процессора 80%, VLLM 0,5+ с точностью FP8.
Стоимость за 1 миллион токенов по конфигурации графического процессора (LLAMA-3-70B)
| Конфигурация | Входные токены ($/1M) | Выходные токены ($/1M) | Пропускная способность (TOK/S) | Мощность (Вт/ГПУ) |
| 8 × H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 Вт |
| 8 × H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 Вт |
| 8 × B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 Вт |
| 8х MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720 Вт |
| OpenAI GPT-4O | $2.50 | $10.00 | н/д (API) | Н/Д |
| Антропный Клод Сонет (API) | $3.00 | $15.00 | н/д (API) | Н/Д |
| Вместе ai lama-3-70b (API) | $0.88 | $0.88 | н/д (API) | Н/Д |
Анализ ON-PREM и API безубыточности
Безубыточность между самостоятельным on-prem-уводом и выводом на основе API зависит от объема запроса. При приведенной выше структуре затрат (8 × H200, 3-летняя амортизация, использование 80%) в режиме PREM становится дешевле, чем вместе с ценами API AI LLAMA-3-70B при примерно 12 млн выходных токенов в день. По сравнению с основными API модели Frontier (GPT-4O, Claude) ON-PREM-брейк даже при 2–3 м выходных токенов в день. Для большинства корпоративных развертываний, обслуживающих внутренние инструменты, чат-боты, ориентированные на клиента или конвейеры обработки документов, ON-PREM-приобретение обеспечивает экономию 60–80% в течение первых 18 месяцев.
TCO на уровне стойки — по чему скучают покупатели
Цена покупки оборудования составляет всего 55–65% от общей стоимости 3-х лет. Полный бюджет 42U для вывода должен включать:
- Аппаратное обеспечение сервера графического процессора: $287,000–$420,000 (8×Node H100/H200 + двухпроцессорный Xeon + 2 ТБ ОЗУ + NVMe + ConnectX-7 Ник)
- Сеть: $15,000–$35,000 (переключатели InfiniBand NDR, кабели ЦАП, волокно)
- Энергетическая инфраструктура: $8,000–$18,000 (PDU, UPS, BREAKER UPGRAINS в PUE 1.3)
- Охлаждение: $12,000–$45,000 (теплообменники задние двери добавляют $25K; жидкостное охлаждение прямого чипа добавляет $40K+, но снижает PUE до 1.05–1.10)
- 3-летняя электричество: $28,000–$52,000 (при $0.10–$0.18/кВтч, 5–8 кВт/стойка устойчивая тяга)
- Штатное персональное управление: $40,000–$80,000/год (0,5–1,0 FTE с опытом работы с графическим процессором)
Итого 3-летняя TCO для одной стойки вывода 8×H200: $580 000–$760 000. Разделите на токены, созданные при использовании 80% в течение 36 месяцев, и вы получите $0,15–$0,22 на миллион выходных токенов — значительно ниже даже бюджетных провайдеров API для больших объемов рабочих нагрузок.
Atal Networks’ Конфигурации выделенных серверов Включите прозрачное моделирование TCO — мы предоставляем разбивки по позициям по позициям, прежде чем вы фиксируете. Поговорите с нашей инфраструктурной командой по адресу atalnetworks.com.
Оптимизация вывода ИИ — методы, которые работают
Квантование (FP8, INT8, INT4 — точность и скорость компромиссов)
Квантование снижает числовую точность весов модели, сокращает объем памяти и увеличивает пропускную способность, но при некоторой стоимости до точности. Вот что показало наше тестирование на ламе-3-70Б:
| Точность | MMLU точность | Человеческая точность | Точность GSM8K | Усиление пропускной способности по сравнению с FP16 | Требуется VRAM (70B) |
| FP16 (базовый уровень) | 82.0% | 80.5% | 88.1% | 1.0× | ~140 ГБ |
| БФ16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140 ГБ |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70 ГБ |
| int8 (гладкая) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70 ГБ |
| int4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35 ГБ |
| NVFP4 (Блэквелл) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25 Гб |
Для большинства производственных рабочих нагрузок FP8 является наиболее удачным местом: он обеспечивает качество почти FP16 с примерно 2-кратной пропускной способностью и снижением памяти 50%, что позволяет модели 70B устанавливаться на одном узле 8×H100 SXM. Int4 (через GPTQ или AWQ) жизнеспособна для приложений, где допустимо небольшое снижение качества в обмен на дальнейшее снижение стоимости.
Непрерывный пакетирование и PageDattention
Статическая группировка — ожидание заполнения фиксированной партии перед обработкой — приводит к простому времени простоя графического процессора и высокой задержке хвоста. Непрерывная группировка (проходимая в VLLM и теперь стандартная для всех основных фреймворков вывода) обрабатывает запросы параллельно, вытесняя завершенные последовательности и допуская новые без паузы. В сочетании с непрерывным управлением памяти KV-кэша PageDattenttion этот подход обеспечивает 2–4-кратное использование графического процессора по сравнению со статическим пакетированием на одном и том же оборудовании при том же томе запроса.
KV-Cache Management — математическая память
KV-Cache сохраняет ключи внимания и значения для каждого токена в окне контекста, чтобы избежать повторного вычисления во время декодирования. Требования к памяти на запрос:
KV-кэш байт = 2 × NUM_Layers × NUM_HEADS × head_dim × sequence_length × bytes_per_element
Для LLAMA-3-70B в FP16 (2 байта/элемент, 80 слоев, 8 голов, 128 head_dim) с 4096-токеном контекстом: ~42 МБ на параллельный запрос. При 1000 одновременных пользователей, то есть только 42 ГБ кэша KV — до весов модели. Квантование кэша KV в INT8 вдвое сокращает его до 21 ГБ, позволяя примерно в 2 раза больше одновременных пользователей на одном и том же оборудовании.
Спекулятивное декодирование
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
Нарезанная дозаправка и разбивка
Для рабочих нагрузок с длинным контекстом предварительно заполнение разделяет большую подсказку на более мелкие фрагменты, обрабатываемые последовательно, что позволяет стадии декодирования чередовать токены из существующих запросов во время пробелов в предварительной заполнении. Дезагрегированная порция продвигает это дальше, запустив предварительное заполнение и декодирование в отдельных пулах графического процессора — предварительно заполнение на компьютерно-оптимизированном оборудовании (H100 SXM), декодирование на оптимизированном для полосы пропускной способности аппаратных средствах (H200) — обеспечении лучшего использования ресурсов и снижения P99 задержка одновременно.
Фреймворки для обработки вывода AI — сравнение лицом к лицу
Выбранная вами фреймворк так же важна, как и аппаратное обеспечение. Каждый из них имеет разные сильные стороны, ограничения и операционную сложность:
| Рамки | пропускная способность (относительно) | Простота настройки | Поддержка GPU | Ключевая сила | Лицензия |
| VLLM 0,5+ | Высокий (1,0 × базовый уровень) | Легко (установить пип) | NVIDIA, AMD ROCM | Непрерывный пакетный пакет, крупнейшее сообщество, API, совместимый с OpenAI | Апач 2.0 |
| Tensorrt-llm | Самый высокий (1,3–1,6×) | Комплекс (компиляция двигателя) | только nvidia | Максимальная пропускная способность NVIDIA, в полете, FP8/FP4 | Апач 2.0 |
| TGI (обнимающее лицо) | Средний (0,85×) | Легко | Нвидиа, AMD, Гауди | Интеграция Hugging Face Model Hub, поддержка широкой модели | Апач 2.0 |
| сгланг | Высокий (1,1–1,2×) | Средний | Нвидиа, AMD | Кэширование префиксов, RadixAttention, Структурированные выходные данные | Апач 2.0 |
| llama.cpp | Низкий (ЦП жизнеспособный) | Очень просто | CPU, CUDA, Металл, Вулкан | Вывод CPU/EDGE, минимальные зависимости, широкие квантования | Мит |
| Нвидиа Тритон | Варьируется (обертка) | Комплекс | NVIDIA (в первую очередь) | Многомодельный сервис, независимый от фреймворка, корпоративный MLOPS | БСД 3 - пункт |
Безопасность, конфиденциальность и соответствие требованиям для вывода ИИ
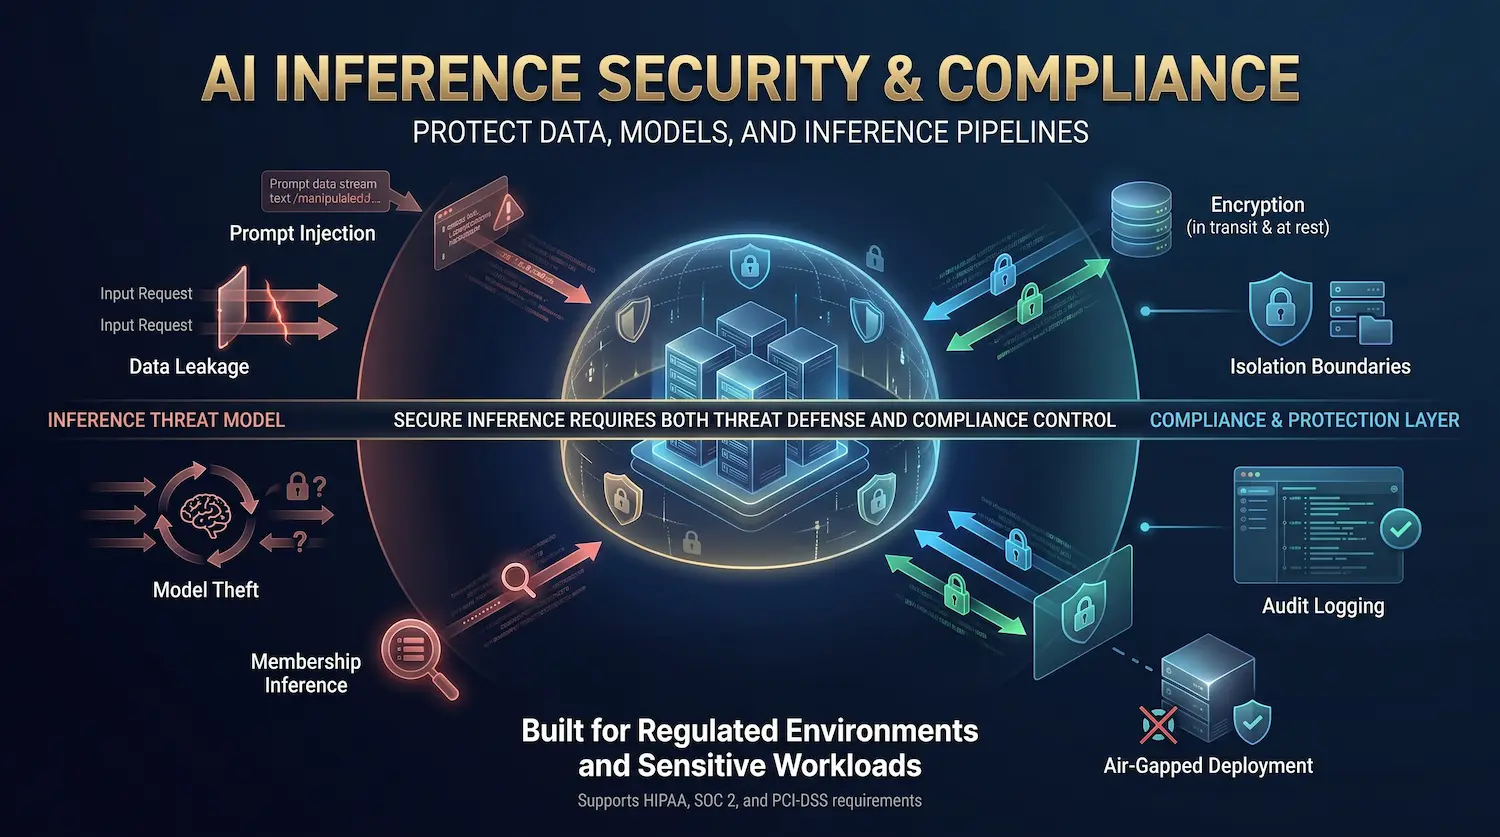
Вывод ИИ в регулируемых отраслях или с конфиденциальными данными требует понимания полной модели угроз и позиции соответствия.
Вывод Модель угрозы безопасности
- Подсказка: вредоносные входы, встроенные в пользовательские данные, пытаются переопределить системные инструкции или извлекать обучающие данные.
- Утечка данных: конфиденциальная информация из запроса одного пользователя утечка в ответ другого пользователя посредством перекрестного загрязнения кэша KV (смягченная изоляцией кэша для каждого пользователя).
- Кража модели: повторяющиеся запросы сражений пытаются восстановить вес модели с помощью выходного анализа.
- Вывод о членстве: Злоумышленники определяют, появились ли конкретные данные в обучающем наборе модели.
Рамки соответствия
Для вывода, совместимого с HIPAA: все данные должны оставаться в пределах вашей границы управления, шифрование в пути (TLS 1.3) и AT-REST шифрование (AES-256) обязательны, а аудит всех запросов на вывод должен быть сохраняется. Соответствие SOC 2 Тип II требует аудитов безопасности, нейтральных поставщиков, и документированного реагирования на инциденты. Среды PCI-DSS должны использовать серверы вывода с воздушным зазором без подключения к Интернету. Развертывание локального облака — а не инфраструктура общего облака или API — это единственная архитектура, которая удовлетворяет всем трем фреймворкам одновременно без значительных компенсирующих элементов управления.
Atal Networks’ Выделенная серверная инфраструктура Поддерживает развертывание с воздушными зазорами для регулируемого вывода ИИ. Свяжитесь с нами по atalnetworks.com чтобы обсудить ваши требования к соответствию.
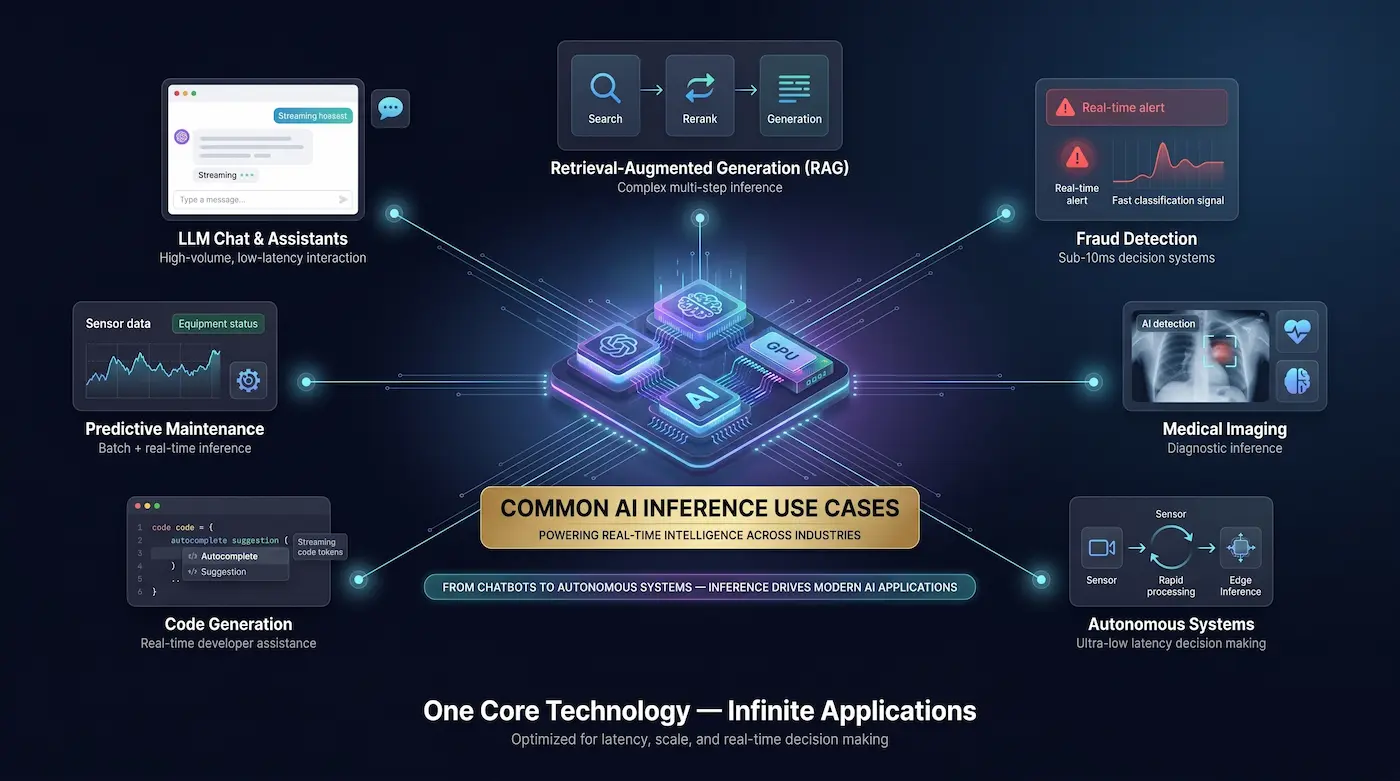
Распространенные варианты использования AI
Вывод AI обеспечивает расширение спектра производственных приложений в каждой отрасли:
- Чат LLM и помощники: боты обслуживания клиентов, помощники по внутренним знаниям, второпилоты кодирования — все это рабочие нагрузки с большим объемом, чувствительными к задержке.
- Поколение с расширенным числом (RAG): объединяет модель встраивания (для семантического поиска), реранкер и LLM в трехэтапном конвейере вывода. Каждый этап добавляет задержку и стоимость.
- Обнаружение мошенничества: вывод классификации в режиме реального времени при задержке до 10 мс с использованием небольших специализированных моделей.
- Медицинская визуализация: CNN и вывод трансформаторов зрения для радиологии, патологии и диагностики, часто требующие развертывания на PREM для соблюдения требований HIPAA.
- Автономные транспортные средства: вывод восприятия миллисекунды на специализированном бортовом оборудовании (Орин, D5).
- Генерация кода: потоковый вывод для автозаполнения требует чрезвычайно низкого ITL (< 15 мс), чтобы чувствовать себя в реальном времени.
- Агентские рабочие процессы: многоступенчатые агенты, вызывающие инструменты, генерируют множество вызовов вывода для каждой задачи пользователя, увеличивая стоимость 5–20 × по сравнению с однотактными ответами.
- Прогностическое техническое обслуживание: пакетный вывод о потоках данных датчика для прогнозирования отказа оборудования.
Будущее AI Inference — 2026 и выше
Ряд тенденций перестраивают ландшафт вывода до 2026 и 2027 года:
- Модели рассуждений и масштабирование во время тестирования: как продемонстрировали мышление DeepSeek-R1 и Gemini 2.5, генерация большего количества токенов во время вывода надежно улучшает качество вывода для сложных задач. Это коренным образом меняет кривую стоимости — счет за вывод на запрос растет, а не уменьшается.
- Доминирование смеси экспертов (MOE): Архитектуры MOE, такие как Mixtral 8x22B, активируют только часть параметров на один токен, обеспечивая производительность класса GPT-4 при 2–3 более низкой стоимости логического вывода. Ожидайте, что MO будет доминировать в новых выпусках моделей.
- Дезагрегированная и спекулятивная обслуживание в масштабе: разделение пулов предварительного заполнения и декодирования в сочетании со спекулятивным декодированием в стиле Eagle становится стандартной производственной архитектурой для крупномасштабных развертываний LLM.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- Модели Frontier на устройстве: Apple Intelligence, Gemini Nano и Phi-3-Mini демонстрируют, что квантованные модели 3B–7B могут полностью работать на потребительском оборудовании. Граница между облаком и выводом края размыта.
- Суверенное ИИ и резидентство данных: геополитическое давление заставляет предприятия и правительства требовать полного суверенитета данных — выводы в рамках своих национальных границ, на аппаратное обеспечение, которым они владеют. Спрос на Prem будет расти, а не сокращаться.
Часто задаваемые вопросы (FAQ)
Что такое вывод ИИ простыми словами?
Вывод ИИ — это когда обученная модель ИИ использует то, что она научилась, чтобы ответить на новый вопрос или выполнить новую задачу. Обучение учит модели; Вывод — это модель, выполняющая свою работу. Каждый раз, когда вы получаете ответ от CHATGPT, получаете рекомендацию о продукте или видите предупреждение о мошенничестве, то есть вывод ИИ, который происходит в режиме реального времени.
В чем разница между выводом ИИ и обучением ИИ?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
Является ли вывод или обучение в чате?
Когда вы общаетесь с ChatGPT, вы запускаете вывод — вес модели фиксирован, и он применяет их к вашему вводу для создания ответа. OpenAI Trains (и периодически переобучает) GPT-4 отдельно, на обширных наборах данных, за огромную стоимость. Это две совершенно разные операции. То, что вы испытываете как пользователь, — это вывод 100%.
Какое оборудование используется для вывода ИИ?
Доминирующим оборудованием для крупномасштабного вывода являются графические процессоры NVIDIA (H100, H200, B200, L40S), графические процессоры AMD (MI300X, MI355X) и TPU Google для облачных рабочих нагрузок. Для вывода краев: нейронный движок Apple, NPU Qualcomm Hexagon и Nvidia Jetson Orin. Для чувствительных к затратам или развертываниям, предназначенным только для CPU, современные процессоры Intel Xeon (AMX) и AMD EPYC могут запускать квантованные модели с приемлемой пропускной способностью.
Какой лучший графический процессор для вывода ИИ в 2026 году?
Для больших моделей (70B+): NVIDIA H200 SXM5 (141 ГБ HBM3E, 4,8 ТБ/с) предлагает лучшую производительность для большинства рабочих нагрузок. Для максимальной пропускной способности моделей Frontier: B200 SXM6 выводы. Для чувствительной к стоимости среднего диапазона: AMD Mi300X (192 ГБ HBM3, $10K–$15K ниже H200) становится все более конкурентоспособным. Для вывода Edge/Single-GPU: NVIDIA L40S (48 ГБ GDDR6) хорошо сбалансирует стоимость и возможности.
Как LLM-вывод работает поэтапно?
- Токенизация: Входной текст преобразуется в идентификаторы целочисленных токенов. 2. Prefill: Все входные маркеры обрабатываются одновременно за один проход, генерируя кеш KV и первый выходной токен. 3. Декодирование: новые токены генерируются по одному, каждый из которых принимает полный кеш KV. 4. Непрерывная группировка: несколько одновременных запросов разделяют вычисления графического процессора через пакетную работу. 5. Потоковая передача: выходные токены детокенируются и передаются клиенту по мере их создания.
Что такое TTFT и ITL в выводе LLM?
TTFT (время до первого токена) измеряет, как долго с момента отправки запроса не будет возвращен первый выходной токен — задержка, которую пользователь воспринимает как «время ожидания». В нем преобладает этап предварительного заполнения. ITL (Inter-Token Latency) измеряет среднее время между последовательными выходными токенами во время декодирования — что определяет «скорость потоковой передачи», которую видит пользователь. Оба должны быть оптимизированы для чата в реальном времени: обычно TTFT < 200 мс и ITL < 30 мс для адаптации.
Что такое КВ-кэш и почему это важно?
KV-Cache (кэш-ключ-значение) сохраняет промежуточные вычисления внимания (ключи и значения) для каждого токена в контексте разговора. Без него модели необходимо было бы переработать все контекстное окно для каждого нового токена — O(n²). С его помощью каждый шаг декодирования обрабатывает только один новый токен, делая вывод LLM возможным. KV-Cache является основным ограничением на то, сколько одновременных пользователей может обслуживать графический процессор и как долго может быть контекстное окно.
Сколько стоит вывод ИИ на 1 млн токенов?
На самостоятельном оборудовании (8×H200, 3-летняя амортизация, $0.12/кВтч, использование 80%, LLAMA-3-70B FP8): $0.18 на 1 м входные токены и $0.71 на 1M выходных токенов. через общедоступный API: GPT-4O стоит $2.50/$10.00 Вход/вывод на 1 м токены; Клод сонет стоит $3.00/$15.00. Самостоятельное размещение в масштабе обеспечивает снижение затрат на 5–20 раз, а безубыточность обычно составляет 5–15 млн выходных токенов в день в зависимости от поставщика и модели API.
Можете ли вы запустить вывод AI на процессоре?
Да — для небольших квантованных моделей. llama.cpp включает вывод INT4/INT8 на любом процессоре x86. Двухпротекторный Xeon Platinum с AMX генерирует ~25–40 токенов в секунду на модели 7B INT4, что подходит для рабочих нагрузок в не реальное время. Вывод процессора нежизнеспособен для моделей 70B+ при производственной пропускной способности. Экономика работает над разработкой, тестированием и задержками, устойчивыми к задержке, где стоимость аренды GPU превышает стоимость пропускной способности.
В чем разница между предзаполнением и декодированием в выводе LLM?
Prefill обрабатывает всю входную подсказку за одну параллельную операцию (вычисляемая, быстрая, масштабируемая с длиной подсказки). Декодирование генерирует выходные токены по одному в цикле авторегрессии (связанная с пропускной способностью памяти, более медленная на токен, масштабы с выходной длиной и одновременные пользователи). Переход между ними — когда генерируется первый токен — TTFT. Оптимизация предварительного заполнения снижает TTFT; Оптимизация декодирования снижает ITL и повышает пропускную способность.
Когда вы должны самостоятельно размещать вывод AI по сравнению с использованием API?
Используйте API, когда: низкая громкость (< 2 м токены в день), вам нужна модель закрытия границ (GPT-4O, Claude), или вы прототипируете и не хотите нулевые капитальные затраты. Самостоятельное размещение, когда: объем превышает 5 млн токенов в день, требует его конфиденциальности или соответствия требованиям, вы хотите точно настроить или управлять моделью, или вам нужен гарантированный SLA без ограничений по ставке. Точка безубыточности по сравнению с большинством API составляет 3–18 месяцев в зависимости от модели и объема, после чего ON-PREM выгодно сравнивается в течение многих лет.
Построить или купить — следующие шаги с Atal Networks
Если вы достигли этой точки, у вас есть полное представление о том, что такое вывод ИИ, как он работает, сколько стоит и какое оборудование питает его. Следующий вопрос - исполнение.
Atal Networks специализируется на специально созданной инфраструктуре вывода искусственного интеллекта для предприятий, которые переросли зависимость API. Наша команда разработала и развернула кластеры GPU в секторах здравоохранения, финансовых услуг, производства и программного обеспечения, и мы публикуем базовые данные, а не только брошюру.
Исследуйте наш Конфигурации выделенных серверов Для высокопроизводительных развертываний вывода с помощью систем H100, H200 и MI300X.
Ищете точку входа с низким капиталом? Наши Оптимизированные GPU планы VPS Позвольте вам начать запускать рабочие нагрузки с частным выводом сегодня, не владея стойкой.
Готовы говорить о цифрах? Посещение atalnetworks.com И поговорите напрямую с инженером-технологом, а не с скриптом продаж.
