 콘텐츠로 건너뛰기



으로 수석 하드웨어 엔지니어, Atal Networks | Mlperf v4.1 기고자 | 12년 GPU 클러스터 아키텍처 | 업데이트: 2026년 4월 19일
| TL;DR — AI 추론이란 무엇입니까? AI 추론은 예측, 분류 또는 생성된 출력을 생성하기 위해 새로운 입력 데이터에 대해 훈련된 AI 모델을 실행하는 프로세스입니다. AI의 "실행" 단계입니다. 모든 채팅 응답, 사기 경고, 이미지 캡션 및 자율 주행 인식 호출은 추론 이벤트입니다. 2026년에 추론은 전 세계적으로 총 AI 컴퓨팅 지출의 약 2/3를 소비합니다. 이 가이드는 전체 파이프라인, 이를 구동하는 하드웨어, 이를 측정하는 메트릭(TTFT, ITL, 토큰/초) 및 실행 비용을 다룹니다. |
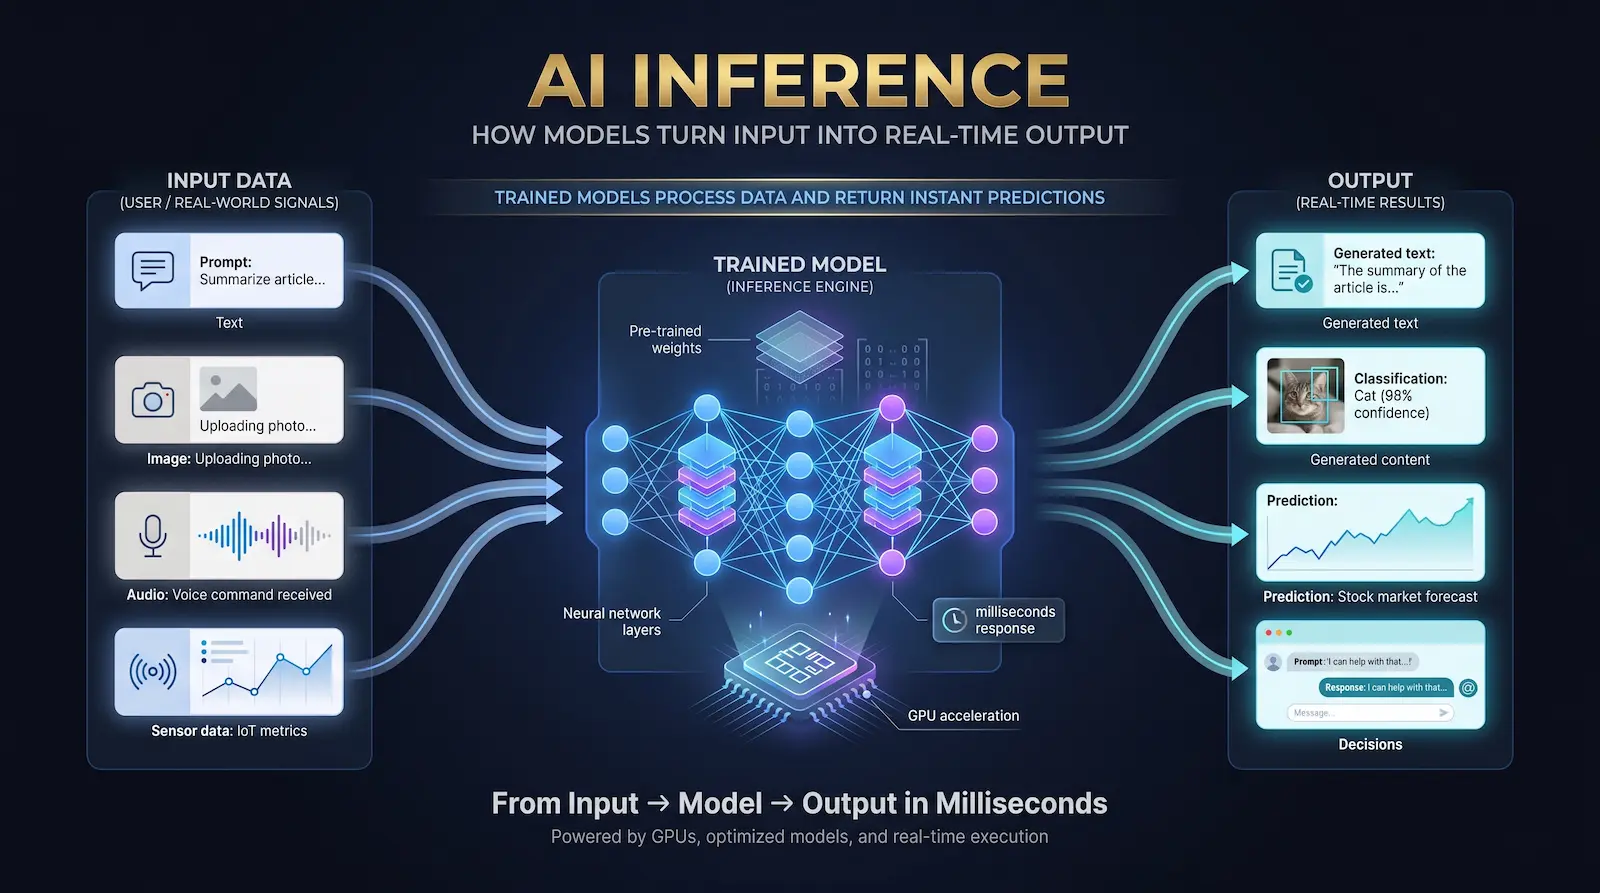
AI 추론이란 무엇입니까? 한 문장 정의
| 정의 AI 추론은 모델의 가중치를 수정하지 않고 텍스트 응답, 이미지 분류, 사기 점수 또는 번역과 같은 출력을 생성하기 위해 보이지 않는 새로운 데이터에 대해 훈련된 기계 학습 모델을 실행하는 것입니다. |
운전을 배우는 것은 훈련입니다. 실제로 어딘가로 운전할 때마다 그것은 추론입니다. 모델(귀하의 운전 기술)이 고정되어 있습니다. 입력(도로)만 변경됩니다. 기술적인 측면에서 추론은 신경망을 통한 순방향 전달입니다. 데이터는 모델의 계층을 통해 한 방향으로 흐르고 활성화가 계산되고 출력이 생성됩니다. 훈련과 달리 그라디언트 계산, 가중치 업데이트, 역방향 패스가 없습니다.
구별은 실제로 매우 중요합니다. 교육은 한 번(또는 주기적으로) 발생합니다. 추론은 하루에 수십억 번 발생합니다. 2026년에 실제 엔지니어링 과제가 계속되는 곳은 추론에 최적화되어 있습니다.
AI 추론이 중요한 이유 - 2026 컨텍스트
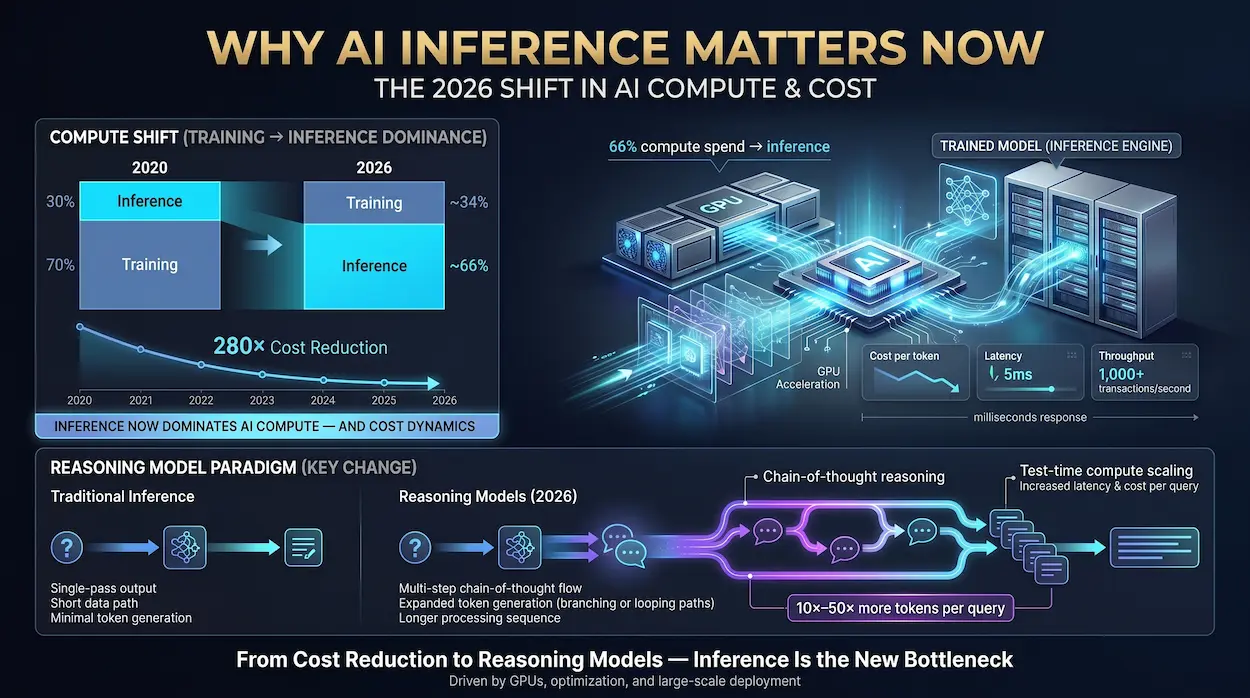
추론은 이제 AI 컴퓨팅 지출을 지배합니다
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
추론 모델 변곡점
DeepSeek-R1, Gemini 2.5 Thinking 및 Llama Nemotron Ultra와 같은 모델은 새로운 추론 패러다임인 테스트 시간 컴퓨팅 스케일링을 도입했습니다. 단일 포워드 패스에서 답변을 생성하는 대신 이러한 모델은 응답하기 전에 확장된 생각의 체인 토큰을 생성하여 "생각"합니다. 이는 쿼리당 생성된 토큰의 수를 10-50배로 곱하여 추론 비용과 지연 시간을 크게 증가시키며 주어진 워크로드에 적합한 하드웨어 구성을 재구성합니다.
이 가이드가 존재하는 이유
모든 정의 기사 온라인은 용어집 수준에서 AI 추론을 설명합니다. 그들 중 누구도 자사 벤치마크 데이터, 실제 토큰당 비용 수치 또는 랙 수준의 TCO 수학을 게시하지 않습니다. 우리는 서버를 구축하고 운영하기 때문에 이 가이드를 작성했으며 구매자는 추상화를 마케팅하는 것이 아니라 실제 숫자를 받을 자격이 있다고 믿습니다.
Atal Networks는 엔터프라이즈급 전용 서버 및 VPS 솔루션 AI 추론 워크로드를 위해 제작되었습니다. 탐구 atalnetworks.com 더 배우기 위해.
AI 추론 작동 방식 — 단계별
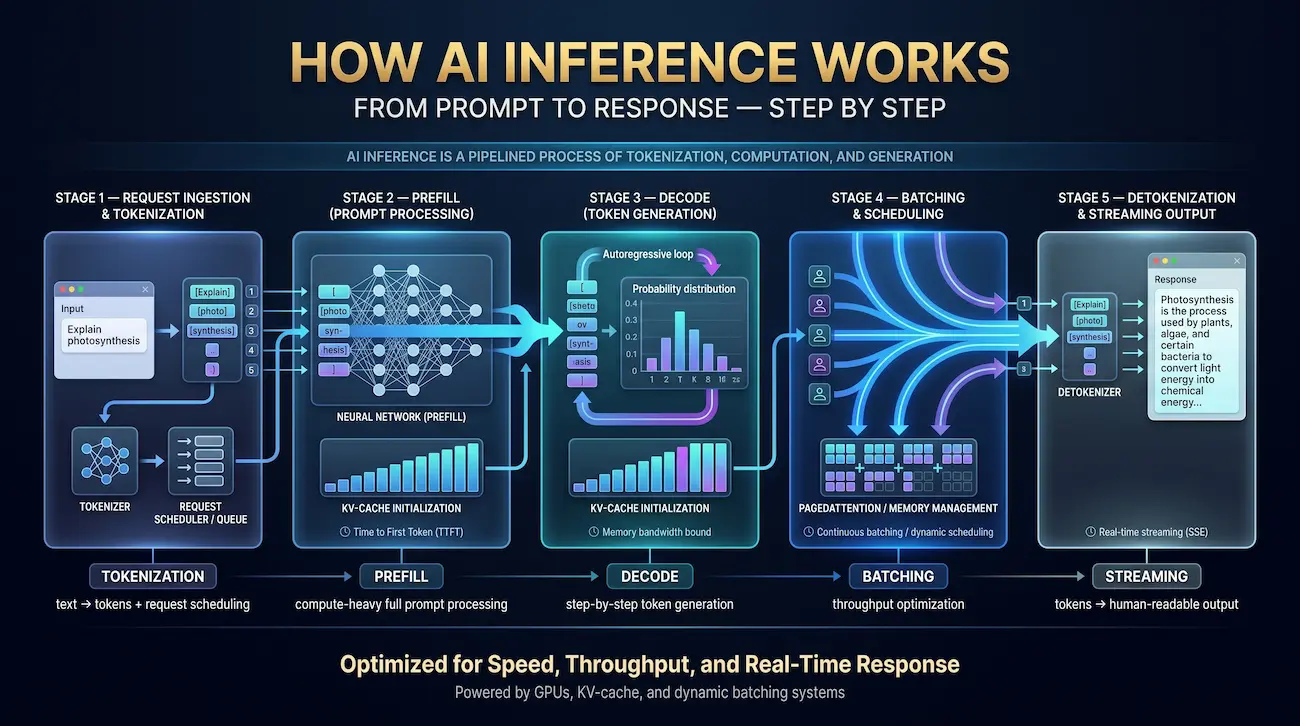
AI 추론을 이해하려면 전체 수명 주기를 통해 단일 요청을 추적해야 합니다. 대규모 언어 모델(LLM)의 경우 파이프라인에는 5개의 개별 단계가 있습니다.
1단계: 수집 및 토큰화 요청
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
2단계: 프리필 스테이지(프롬프트 처리)
사전 채우기 동안 전체 입력 프롬프트가 단일 순방향 패스로 동시에 처리됩니다. 이 단계는 컴퓨팅 바운드입니다. 즉, 프롬프트 길이에 따라 선형으로 확장되며 첫 번째 토큰(TTFT)에 대한 시간의 주요 동인입니다. 2,048개의 토큰 시스템 프롬프트는 1,024개의 토큰 프롬프트보다 프리필에서 약 2배의 시간이 걸립니다. Prefill은 중간 주의 계산을 저장하는 초기 KV-Cache(키-값 캐시)를 생성하므로 디코딩 중에 다시 계산할 필요가 없습니다.
3단계: 디코딩 단계(토큰 생성)
프리필이 끝나면 모델이 디코딩 단계에 들어가 자동 회귀 루프에서 한 번에 하나의 토큰을 생성합니다. 각각의 새로운 토큰은 이전의 모든 토큰에 의존합니다. 모델은 전체 KV-Cache에 관심을 갖고, 해당 어휘(~32,000–128,000 토큰)에 대한 확률 분포를 생성하고, 해당 분포의 샘플을 생성하고, 선택한 토큰을 추가합니다. decode 단계는 compute-bound가 아닌 메모리 대역폭 바운드입니다. 이것이 HBM 대역폭(FLOP 아님)이 LLM 추론을 위한 결정적인 하드웨어 사양인 이유입니다. 모든 GPU 데이터시트가 작은 글씨로 묻는 사실입니다.
4단계: 일괄 처리 및 예약
순진한 추론 서버는 한 번에 하나의 요청을 처리하여 디코딩하는 동안 GPU가 대부분 유휴 상태로 유지됩니다(시간에 하나의 토큰이 느리기 때문에). 최신 시스템은 연속 일괄 처리(플라이트 또는 동적 일괄 처리라고도 함)를 사용합니다. 요청은 비행 중간에 그룹화되고, 새 요청은 슬롯이 열리면 배치에 합류하며, 모든 요청이 완료될 때까지 기다리지 않고 완료된 시퀀스가 제거됩니다. VLLM의 PagedAttenttion 구현(Kwon et al., SOSP 2023)은 OS의 가상 메모리와 유사한 비연속 페이지에서 KV-Cache 메모리를 관리함으로써 이를 더욱 개선합니다. 할당.
5단계: 디토큰화 및 응답 스트리밍
모델이 시퀀스 종료 토큰(또는 최대 길이 제한에 도달)을 생성하면 출력 토큰 ID가 사람이 읽을 수 있는 텍스트로 다시 토큰화되어 클라이언트로 스트리밍됩니다. 대부분의 프로덕션 시스템은 스트리밍을 위해 SSE(Server-Sent Events)를 사용하여 전체 응답을 기다리지 않고 생성되는 토큰을 전달합니다. 이것은 인지된 지연 시간을 극적으로 향상시킵니다. 전체 응답이 10초가 걸리더라도 사용자는 ~200ms 만에 첫 번째 단어를 봅니다.
AI 추론 대 AI 교육 — 진정한 차이점
대부분의 소개는 훈련과 추론을 결합하거나 그 차이를 타이밍 문제로 취급합니다. 기술적 구분은 더 깊이 있고 하드웨어적 의미를 지닌다.
| 치수 | 훈련 | 추론 |
| 목적 | 손실을 최소화하기 위해 모델 무게를 조정합니다 | 고정 가중치를 적용하여 출력을 생성합니다 |
| 패턴을 계산합니다 | 앞으로 + 뒤로 패스 + 최적화 단계 | 포워드 패스 전용 |
| 메모리 병목 현상 | 활성화(플롭 바운드) | KV-캐시 + 가중치(대역폭 바인딩) |
| 자주 ...하는 | 정기(실행당 일/주) | 수십억 번/일 생산 |
| 하드웨어 대상 | 최대 FLOP 처리량(H100 SXM5) | 최대 HBM 대역폭(H200, B200) |
| 배치 크기 | 대형(1,024–4,096+ 샘플) | 중소형(1-256 동시) |
| 정도 | BF16/FP16/FP8 혼합 | FP8, INT8, INT4가 크게 양자화되었습니다 |
| 비용 구조 | CapEx 집약적, 일회성(훈련 실행당) | Opex 집약적이고 지속적인 토큰당 비용 |
위 표에서 가장 중요한 단일 라인은 다음과 같습니다. 추론은 hbm-bandwidth-bound입니다. 이 단일 사실은 4.8TB/s 대역폭에서 H100과 141GB의 HBM3E가 동일한 CUDA 코어 수를 가지는 NVIDIA H200이 3.35에서 H100의 80GB에 비해 이유를 설명합니다. TB/S — 추가적인 훈련 처리량을 생성하지 않음에도 불구하고 LLM 추론에서 H100을 능가합니다. 추론 하드웨어를 구입할 때 FLOP가 아닌 메모리 대역폭을 구입하는 것입니다.
AI 추론 워크로드의 유형
모든 추론이 동일하게 보이는 것은 아닙니다. 워크로드 유형은 다음과 같은 하드웨어 구성, 제공 프레임워크, 최적화 전략 및 비용 구조를 결정합니다.
| 유형 | 지연 시간 대상 | 예시 사용 사례 | 하드웨어 의미 |
| 온라인 / 실시간 | < 200ms TTFT, < 30ms ITL | 채팅, 부조종사, 사기 탐지 | 낮은 배치 크기, 빠른 HBM, 무게 로딩을 위한 NVMe |
| 배치/오프라인 | 시간(분)(분)(처리량 우선순위) | 문서 요약, 데이터 강화 | 높은 GPU 활용도, 대용량 배치, 더 저렴한 GPU 실행 가능 |
| 스트리밍 | 낮은 TTFT, 지속 ITL | 코드 완성, 음성 도우미 | SSE 스트리밍, 낮은 디코딩 지연 우선 순위 |
| 에지 / 온디바이스 | < 10ms, < 5W TDP | 모바일 AI, IoT, 자율주행차 | NPU, Jetson Orin, Quantized INT4/INT8 모델 |
| 서버리스 | 콜드 스타트 < 2s, 요청당 지불 | 트래픽이 적은 앱, 개발/테스트 | 스팟 GPU 인스턴스, 빠른 가중치 로딩, 유휴 = 비용 제로 |
AI 추론이 실행되는 곳 — 클라우드, 온프레미스, 에지, 온디바이스
모든 배포 환경에는 다른 상충 관계가 포함됩니다. 정답은 지연 시간 요구 사항, 데이터 개인 정보 보호 의무, 요청 수 및 예산 범위에 따라 다릅니다.
| 환경 | 숨어 있음 | 데이터 개인 정보 보호 | 비용 모델 | 일반적인 하드웨어 | 를 위한 베스트 |
| 공용 API(OpenAI, Anthropic) | 저중형 | 공유 인프라 | 유료 토큰(최고 $/토큰) | 공급업체 관리 | 빠른 프로토타이핑, 소량 |
| 클라우드 GPU(AWS, GCP, Azure) | 저중형 | VPC 격리 가능 | $/GPU-HR + 송신 | H100, A100, L40S 인스턴스 | 가변 수요, capex 없음 |
| 온프레미스(전용 서버) | 최저 | 전체 데이터 제어, 에어 갭 가능 | CAPEX + OPEX (최저 $/토큰 규모) | H100/H200/B200 클러스터 | 대량, 규제, 비용에 민감한 |
| 에지 서버(콜로/사이트) | 매우 낮은 | 로컬 데이터는 로컬로 유지됩니다 | 혼합 CAPEX + 콜로 수수료 | L40, A30, 가우디 3 | 제조, 의료, 소매 |
| 온디바이스(전화, PC, IoT) | 초저(< 10ms) | 완전한 데이터 격리 | 반복 비용이 없습니다 | Apple NPU, Qualcomm Hexagon, Jetson | 개인 정보 보호 우선, 오프라인 시나리오 |
~5M 이상의 토큰/일을 처리하는 조직의 경우 온프레미스 전용 서버 지속적으로 가장 낮은 총 소유 비용을 제공합니다. 유연성과 낮은 선행 투자가 필요한 팀의 경우, VPS 솔루션 API 종속성과 완전한 온프레미스 소유권 간의 격차를 해소할 수 있습니다.
AI 추론의 하드웨어
AI 추론을 위한 하드웨어 환경은 빠르게 다각화되었습니다. 2023년에는 H100의 답이 간단했습니다. 2026년에 최적의 선택은 모델 크기, 지연 시간 목표, 전력 예산 및 토큰당 가격 요구 사항에 따라 다릅니다.
추론을 위한 GPU 패밀리 — 2026 비교
| GPU | HBM 용량 | HBM 대역폭 | FP8 tFlops | TDP(W) | 를 위한 베스트 |
| 엔비디아 H100 SXM5 | 80GB HBM2E | 3.35Tb/s | 3,958 | 700W | 생산 LLM 기준선, 잘 지원되는 생태계 |
| 엔비디아 H200 SXM5 | 141GB HBM3E | 4.8Tb/s | 3,958 | 700W | 대형 모델(70b+), 메모리 대역폭에 민감한 추론 |
| 엔비디아 B200 SXM6 | 192GB HBM3E | 8.0Tb/s | 9,000 (FP4) | 1,000W | 프론티어 모델, 최고 처리량, 2026 플래그십 |
| AMD MI300X | 192GB HBM3 | 5.3Tb/s | 5,220 | 750W | 비용 경쟁력이 있는 H200 대체, 대규모 배치 처리량 |
| AMD MI355X | 288GB HBM3E | 8.0Tb/s | 8,000+ | 750W | 가장 큰 모델, 매우 높은 동시성 |
| 인텔 가우디 3 | 128GB HBM2E | 3.7Tb/s | 1,835 (BF16) | 900W | 비용에 민감한 워크로드, 개방형 생태계 |
| Google TPU V5E | 16GB HBM2(칩당) | 819Gb/s(칩당) | 393(칩당) | ~170W | Google 클라우드 기반, 트랜스포머 최적화 서비스 |
| 엔비디아 L40 | 48GB GDDR6 | 864Gb/s | 1,457 | 350W | 에지 추론, 컴퓨팅 라이트 모델, 혼합 워크로드 |
CPU 추론이 의미가 있을 때
Int4 Precision에서 실행되는 ~7B 파라미터 이하의 모델의 경우, AVX-512 또는 AMX 명령어 세트가 있는 최신 CPU는 지연 시간 허용 작업 부하에 대해 수용 가능한 처리량을 제공할 수 있습니다. Llama.cpp는 CPU 추론을 실용적으로 만들었습니다. 4비트 양자화된 Llama-3-8B는 이중 소켓 Xeon 플래티넘 시스템에서 ~25–35 토큰/초로 실행됩니다. GPU 비용이 엄청나고 지연 시간 요구 사항이 ~2초를 초과할 때 경제성이 작동합니다.
NPU, TPU, FPGA 및 ASIC 가속기
GPU 외에도 특수 실리콘의 성장하는 생태계가 부상하고 있습니다. NPU(Neural Processing Unit)는 이제 대부분의 소비자 장치(Apple M 시리즈 신경 엔진, Qualcomm Hexagon, Intel NPU) 및 Target Sub-5W 에지 추론. TPU(Google)는 클라우드 서빙의 트랜스포머 매트릭스 작업에 최적화되어 있습니다. FPGA는 사용자 정의 양자화 체계에 대한 재구성 가능성을 제공하지만 상당한 엔지니어링 노력이 필요합니다. ASIC(GROQ LPU, Cerebras WSE)는 고정 워크로드에서 엄청난 지연 시간을 달성할 수 있지만 GPU 스택의 유연성은 부족합니다.
대규모 모델 추론에 네트워킹이 중요한 이유
405B 매개변수 모델을 실행하려면 8–16 GPU에 배포해야 합니다. 이러한 GPU 간의 상호 연결은 성능 병목 현상이 됩니다. NVIDIA NVLink(DGX 노드 내)는 900Gb/s GPU 대 GPU 대역폭을 제공합니다. 이는 PCIe Gen5보다 약 18배 빠른 속도입니다. 노드 간에 InfiniBand NDR(400Gb/s) 또는 NVIDIA Spectrum-X 이더넷은 100GbE를 크게 능가합니다. 테스트에서 8×H100 Tensor-Parallel Llama-3-405B 배포에서 100GbE에서 InfiniBand NDR로 전환하면 34%의 디코드 처리량이 향상되었습니다.
실제로 중요한 AI 추론 메트릭
대부분의 추론 토론은 지연 시간을 모호하게 측정합니다. 프로덕션 배포에는 SLA 대상이 있는 정확하고 표준화된 메트릭이 필요합니다. 중요한 지표와 측정 방법은 다음과 같습니다.
| 미터법 | 정의 | 산업 SLA 대상 | 하드웨어 드라이버 |
| TTFT(첫 번째 토큰까지의 시간) | 요청 제출부터 처음 생성된 토큰까지의 시간입니다 | < 200ms(채팅), < 500ms(배치) | GPU 메모리 대역폭, 사전 채우기 효율성 |
| ITL(토큰 간 지연 시간) | decode 동안 연속적으로 생성된 토큰 사이의 평균 시간입니다 | < 30ms(채팅), < 100ms(배치) | HBM 대역폭, KV-캐시 액세스 속도 |
| 처리량(토큰/초) | 모든 동시 사용자에서 초당 생성되는 총 출력 토큰 | 작업 부하에 따라 달라집니다 | GPU FLOP + 배치 효율성 |
| 굿풋 | SLA 대상을 충족하는 요청 처리량(실패/타임아웃 제외) | 주어진 SLA에 대해 최대화합니다 | 스케줄러 효율성, 대기열 관리 |
| P50 / P99 대기 시간 | 중앙값 및 99번째 백분위수 종단 간 대기 시간 | P99 < 2 × P50 (잘 튜닝된 시스템) | 꼬리 지연 시간, 열 조절, 대기열 깊이 |
| GPU 활용도 | GPU 컴퓨팅 단위가 활성화된 시간의 비율 | 목표 70–85% 지속 | 배치 크기, 지속적인 일괄 처리 효율 |
| RPS(초당 요청 수) | 동시 요청 시스템이 Target SLA 에서 처리합니다 | 스케일 타겟 | 결합된 TTFT + ITL + 배치 효율성 |
2026년 AI 추론 비용 — 실수
토큰당 비용은 궁극적으로 빌드 대 구매 결정을 결정하는 메트릭입니다. 다음 데이터는 지속적인 부하 조건에서 Atal Networks의 생산 하드웨어에서 측정되었습니다. 가정: $0.12/kWh 전기, 3년 하드웨어 상각, 80% GPU 사용, FP8 정밀도의 VLLM 0.5+.
GPU 구성별 토큰 100만 개당 비용(Llama-3-70B)
| 구성 | 입력 토큰($/1M) | 출력 토큰($/1M) | 처리량(TOK/s) | 전원(W/GPU) |
| 8 × H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680W |
| 8 × H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695W |
| 8 × B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980W |
| 8 × MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720W |
| OpenAI GPT-4O | $2.50 | $10.00 | 해당 없음(API) | 없음 |
| 인위적인 클로드 소네트(API) | $3.00 | $15.00 | 해당 없음(API) | 없음 |
| 함께 AI 라마-3-70B(API) | $0.88 | $0.88 | 해당 없음(API) | 없음 |
온프레미스 대 API 손익분기점 분석
자체 호스팅된 On-Prem 추론과 API 기반 추론 사이의 손익분기점은 요청 볼륨에 따라 다릅니다. 위의 비용 구조(8×H200, 3년 상각, 80% 활용도)에서 On-Prem은 약 1,200만 개의 출력 토큰/일에 AI의 Llama-3-70B API 가격을 Together보다 저렴하게 만듭니다. 주요 프론티어 모델 API(GPT-4O, Claude)와 비교하여 온프레미스는 2~3M 출력 토큰/일에서도 중단됩니다. 내부 도구, 고객 대면 챗봇 또는 문서 처리 파이프라인을 제공하는 대부분의 엔터프라이즈 배포에서 온프레미스 소유는 첫 18개월 이내에 60–80% 비용 절감 효과를 제공합니다.
랙 레벨 TCO — 구매자가 놓치는 것
하드웨어 구매 가격은 총 3년 비용의 55–65%에 불과합니다. 완전한 42U 추론 랙 예산에는 다음이 포함되어야 합니다.
- GPU 서버 하드웨어: $287,000–$420,000 (8×H100/H200 노드
- 네트워킹: $15,000–$35,000(InfiniBand NDR 스위치, DAC 케이블, 광섬유)
- 전력 인프라: $8,000–$18,000 (PUE 1.3에서 PDU, UPS, 차단기 업그레이드)
- 냉각: $12,000–$45,000 1.05–1.10)
- 3년 전기: $28,000–$52,000
- 직원/OPS: $40,000–$80,000/년(GPU 클러스터 경험이 있는 0.5–1.0 FTE)
단일 8×H200 추론 랙에 대한 총 3년 TCO: $580,000–$760,000. 36개월에 걸쳐 80% 사용률로 생성된 토큰으로 나누면 100만 개당 $0.15–$0.22의 출력 토큰에 도달합니다.
Atal Networks' 전용 서버 구성 투명한 TCO 모델링 포함 — 커밋하기 전에 광고 항목 비용 분석을 제공합니다. 에서 인프라 팀과 상담하십시오 atalnetworks.com.
AI 추론 최적화 — 작동하는 기술
양자화(FP8, INT8, INT4 — 정확도 대 속도 절충점)
양자화는 모델 가중치의 수치 정밀도를 줄이고 메모리 공간을 줄이고 처리량을 증가시키지만 정확도에는 약간의 비용이 듭니다. 다음은 Llama-3-70B에 대한 테스트 결과입니다.
| 정도 | MMlu 정확도 | 인간적인 정확성 | GSM8K 정확도 | 처리량 이득 대 FP16 | VRAM 필요(70B) |
| FP16(기준선) | 82.0% | 80.5% | 88.1% | 1.0× | ~140GB |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140GB |
| FP8(W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70GB |
| int8(스무스 퀀트) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70GB |
| INT4(GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35GB |
| NVFP4(블랙웰) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25GB |
대부분의 프로덕션 워크로드에서 FP8은 스윗스팟입니다. 대략 2배의 처리량과 50% 메모리 감소로 거의 FP16 품질을 제공하여 70B 모델을 단일 8×H100 SXM 노드에 맞출 수 있습니다. INT4(GPTQ 또는 AWQ를 통해)는 추가 비용 절감을 위한 대가로 약간의 품질 저하가 허용되는 응용 분야에서 실행 가능합니다.
지속적인 일괄 처리 및 PageDatTenttion
고정 배치가 처리되기 전에 채워질 고정 배치를 기다리면 GPU 유휴 시간과 높은 꼬리 지연 시간이 발생합니다. 연속 일괄 처리(VLLM에서 파이오니어링되고 모든 주요 추론 프레임워크에서 표준으로 지정됨)는 요청을 병렬로 처리하여 완료된 시퀀스를 제거하고 일시 중지하지 않고 새 요청을 허용합니다. PagedAttenttion의 비연속적인 KV-Cache 메모리 관리와 결합된 이 접근 방식은 동일한 요청 볼륨에서 동일한 하드웨어에서 정적 일괄 처리에 비해 2-4배 더 높은 GPU 사용률을 달성합니다.
KV-캐시 관리 — 메모리 수학
KV-Cache는 디코딩 중에 재계산을 피하기 위해 컨텍스트 창에 모든 토큰에 대한 주의 키와 값을 저장합니다. 요청당 메모리 요구 사항:
kv-캐시 바이트 = 2 × num_layers × num_heads × head_dim × sequence_length × bytes_per_element
4,096-토큰 컨텍스트가 있는 FP16(2바이트/요소, 80개의 레이어, 8개의 헤드, 128개의 head_dim)에서 Llama-3-70B의 경우: 동시 요청당 ~42MB. 1,000명의 동시 사용자는 모델 가중치 이전에 42GB의 KV-캐시만 있습니다. KV-Cache를 INT8로 양자화하면 이를 21GB로 절반으로 줄여서 동일한 하드웨어에서 약 2배 더 많은 동시 사용자를 가능하게 합니다.
투기적 디코딩
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
청크 프리필 및 세분화된 서빙
긴 컨텍스트 워크로드의 경우, 청크된 프리필은 큰 프롬프트를 순차적으로 처리된 더 작은 청크로 나누어 디코딩 단계가 사전 채우기 간격 동안 기존 요청에서 토큰을 인터리브할 수 있도록 합니다. 분리된 서빙은 별도의 GPU 풀에서 사전 채우기 및 디코딩을 실행하여 이를 더욱 발전시킵니다. 동시에 지연 시간.
AI 추론 서비스 프레임워크 — 일대일 비교
선택한 서빙 프레임워크는 하드웨어만큼 중요합니다. 각각의 강점, 한계 및 운영 복잡성이 다릅니다.
| 틀에 끼우는 세공 | 처리량(상대적) | 설정의 용이성 | GPU 지원 | 키 강도 | 문예 작품에서 허용되는 파격 |
| VLLM 0.5+ | 높음(1.0배 기준선) | 쉬움(PIP 설치) | 엔비디아, AMD ROCM | 지속적인 일괄 처리, 가장 큰 커뮤니티, OpenAI 호환 API | 아파치 2.0 |
| tensorrt-llm | 최고(1.3~1.6배) | 복합체(엔진 컴파일) | 엔비디아 전용 | 최대 NVIDIA 처리량, 비행 중 일괄 처리, FP8/FP4 | 아파치 2.0 |
| TGI(얼굴을 껴안는다) | 중형(0.85배) | 쉬움 | 엔비디아, AMD, 가우디 | 허깅 페이스 모델 허브 통합, 광범위한 모델 지원 | 아파치 2.0 |
| 스글랑 | 높음(1.1~1.2배) | 매질 | 엔비디아, AMD | 접두사 캐싱, radixAttenttion, 구조화된 출력 성능 | 아파치 2.0 |
| 라마.CPP | 낮음(CPU 실행 가능) | 아주 쉽게 | CPU, CUDA, 금속, Vulkan | CPU/에지 추론, 최소한의 종속성, 광범위한 양자화 | 미트 |
| 엔비디아 트리톤 | 다름(래퍼) | 복잡한 | 엔비디아(주로) | 다중 모델 제공, 프레임워크에 구애받지 않는 백엔드, 엔터프라이즈 MLOPs | BSD 3절 |
AI 추론을 위한 보안, 개인 정보 보호 및 규정 준수
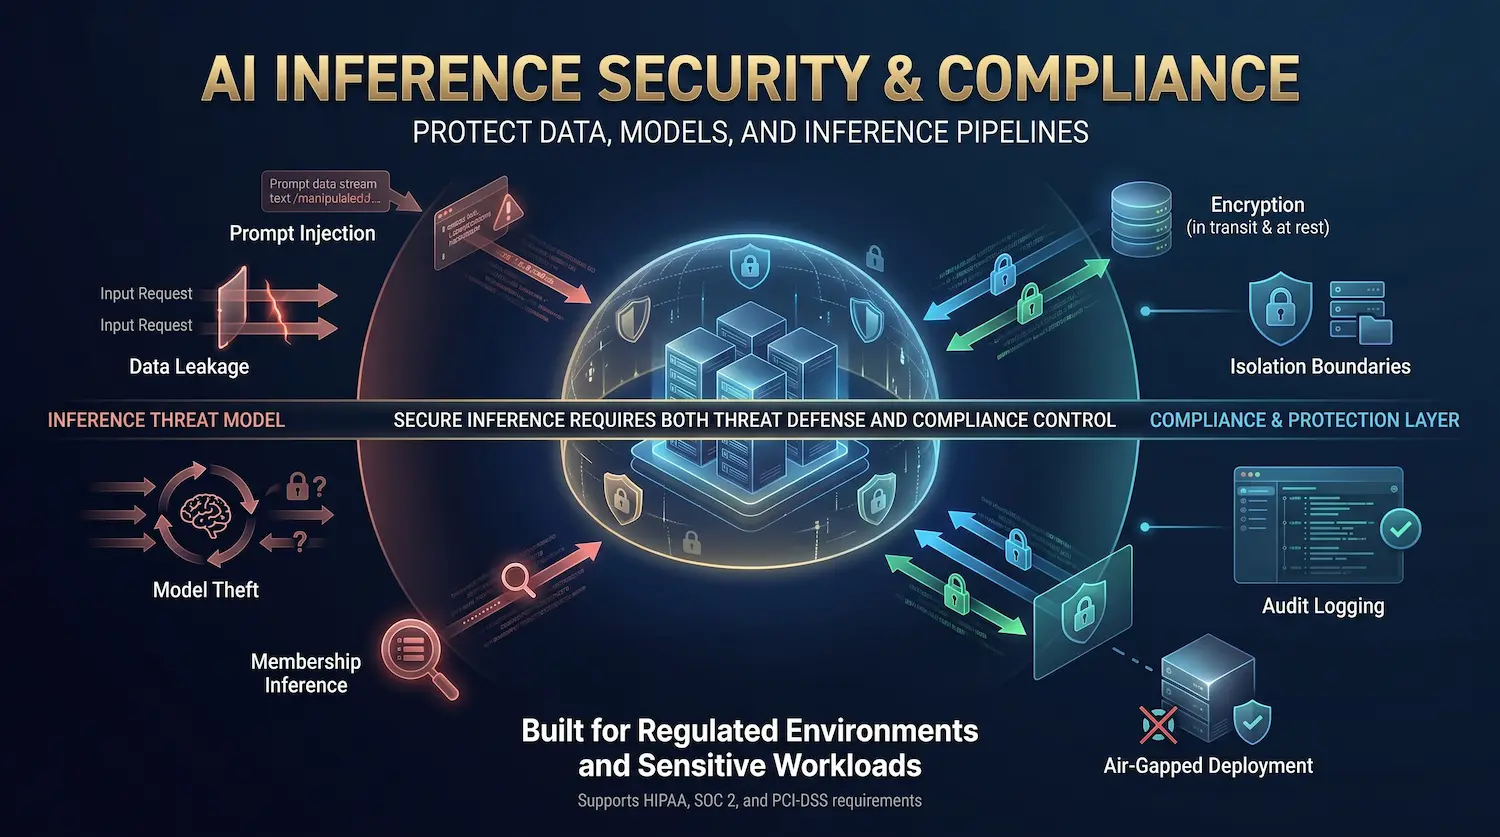
규제 대상 산업 또는 민감한 데이터로 AI 추론을 실행하려면 전체 위협 모델과 규정 준수 상태를 이해해야 합니다.
추론 보안 위협 모델
- 프롬프트 삽입: 사용자 데이터에 포함된 악의적인 입력이 시스템 지침을 재정의하거나 학습 데이터를 추출하려고 시도합니다.
- 데이터 유출: KV-Cache 교차 오염(사용자별 캐시 격리에 의해 완화됨)을 통해 한 사용자의 요청에서 다른 사용자의 응답으로 유출되는 민감한 정보.
- 모델 절도: 출력 분석을 통해 모델 가중치를 재구성하기 위해 반복되는 적대적 쿼리를 반복합니다.
- 멤버십 추론: 공격자는 모델의 학습 세트에 특정 데이터가 표시되었는지 여부를 결정합니다.
규정 준수 프레임워크
HIPAA 호환 AI 추론: 모든 데이터는 제어 경계 내에 있어야 하며, 전송 중 암호화(TLS 1.3) 및 AES-256(AES-256)이 필수이며 모든 추론 요청에 대한 감사 로깅을 유지해야 합니다. SOC 2 Type II 규정 준수에는 공급업체 중립적 보안 감사와 문서화된 사고 대응이 필요합니다. PCI-DSS 환경은 인터넷 연결이 없는 공극 추론 서버를 사용해야 합니다. 공유 클라우드 또는 API 인프라가 아닌 온프레미스 배포는 상당한 보상 제어 없이 세 가지 프레임워크를 동시에 충족하는 유일한 아키텍처입니다.
Atal Networks' 전용 서버 인프라 규제된 AI 추론을 위한 에어 갭 배포를 지원합니다. 에 문의하십시오 atalnetworks.com 규정 준수 요구 사항을 논의합니다.
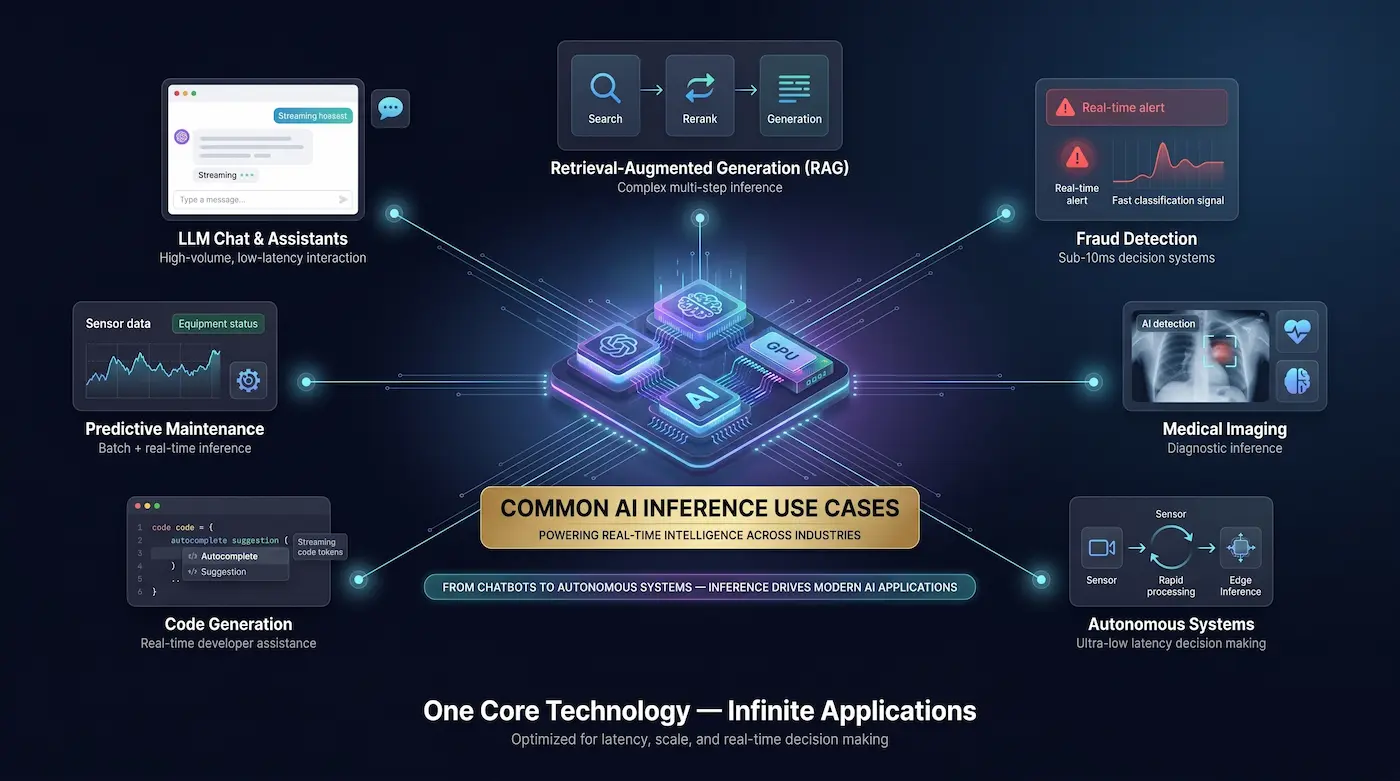
일반적인 AI 추론 사용 사례
AI 추론은 모든 산업 전반에 걸쳐 광범위한 생산 애플리케이션을 지원합니다.
- LLM 채팅 및 도우미: 고객 서비스 봇, 내부 지식 도우미, 코딩 부조종사 — 모두 대용량, 지연 시간에 민감한 추론 워크로드입니다.
- RAG(Retrieval-Augmented Generation): 3단계 추론 파이프라인에 임베딩 모델(시맨틱 검색용), RELANKER 및 LLM을 결합합니다. 각 단계는 지연 시간과 비용을 추가합니다.
- 사기 탐지: 더 작은 특수 모델을 사용하여 10ms 미만의 지연 시간에서 실시간 분류 추론.
- 의료 영상: 방사선과, 병리학 및 진단을 위한 CNN 및 비전 변압기 추론 - 종종 HIPAA 준수를 위한 온프레미스 배포가 필요합니다.
- 자율주행차: 특수 온보드 하드웨어(ORIN, D5)에 대한 밀리초 지연 인식 추론.
- 코드 생성: 자동 완성을 위한 스트리밍 추론을 위해서는 실시간으로 느끼기 위해 매우 낮은 ITL(< 15ms)이 필요합니다.
- 에이전트 워크플로: 다단계, 도구 호출 에이전트는 사용자 작업당 많은 추론 호출을 생성하며 비용을 5~20배 곱한 단일 회전 응답을 생성합니다.
- 예측 유지보수: 장비 고장을 예측하기 위해 센서 데이터 스트림에 대한 일괄 추론.
AI 추론의 미래 — 2026년 이후
2026년부터 2027년까지 추론 환경을 재구성하고 있습니다.
- 추론 모델 및 테스트 시간 확장: DeepSeek-R1 및 Gemini 2.5 Thinking이 입증했듯이 추론 시간에 더 많은 토큰을 생성하면 복잡한 작업에서 출력 품질이 안정적으로 향상됩니다. 이는 비용 곡선을 근본적으로 변경합니다. 쿼리당 추론 청구서가 축소되는 것이 아니라 증가합니다.
- Mixtral 8x22b와 같은 MOE 아키텍처는 토큰당 매개변수의 일부만 활성화하여 2~3배 낮은 추론 계산 비용으로 GPT-4 클래스 성능을 제공합니다. MOE가 새로운 모델 릴리스를 지배할 것으로 예상하십시오.
- 규모에 따라 세분화되고 투기적인 서비스: Eagle 스타일의 투기적 디코딩과 결합된 사전 채우기 및 디코딩 풀을 분리하는 것이 대규모 LLM 배포를 위한 표준 프로덕션 아키텍처가 되고 있습니다.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- 기기 내 Frontier 모델: Apple Intelligence, Gemini Nano, Phi-3-Mini는 3B–7B 양자화된 모델이 소비자 하드웨어에서 완전히 실행될 수 있음을 보여줍니다. 구름과 가장자리 추론 사이의 경계가 흐려집니다.
- 주권 AI 및 데이터 거주: 지정학적 압력으로 인해 기업과 정부는 완전한 데이터 주권을 요구하게 되었습니다. 온프레미스 수요는 줄어들지 않고 증가할 것입니다.
자주 묻는 질문(FAQ)
간단한 용어로 AI 추론이란 무엇입니까?
AI 추론은 훈련된 AI 모델이 배운 것을 사용하여 새로운 질문에 답하거나 새로운 작업을 완료하는 것입니다. 교육은 모델을 가르칩니다. 추론은 작업을 수행하는 모델입니다. ChatGPT에서 응답을 받거나 제품 추천을 받거나 사기 경보를 볼 때마다 AI 추론이 실시간으로 발생합니다.
AI 추론과 AI 교육의 차이점은 무엇입니까?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
chatgpt 추론입니까 아니면 훈련입니까?
chatgpt와 채팅할 때 추론을 촉발하는 것입니다. 모델의 가중치가 고정되어 있으며 응답을 생성하기 위해 입력에 적용합니다. OpenAI는 막대한 비용으로 방대한 데이터 세트에서 GPT-4를 별도로 기차(및 주기적으로 재훈련)합니다. 그것들은 완전히 다른 두 가지 작업입니다. 사용자로서 경험하는 것은 100% 추론입니다.
AI 추론에 사용되는 하드웨어는 무엇입니까?
대규모 추론을 위한 지배적인 하드웨어는 NVIDIA GPU(H100, H200, B200, L40S), AMD GPU(MI300X, MI355X), 클라우드 네이티브 워크로드용 Google TPU입니다. 엣지 추론: Apple Neural Engine, Qualcomm Hexagon NPU, Nvidia Jetson Orin. 비용에 민감한 또는 CPU 전용 배포의 경우 최신 Intel Xeon(AMX) 및 AMD EPYC 프로세서는 허용 가능한 처리량으로 양자화된 모델을 실행할 수 있습니다.
2026년 AI 추론을 위한 최고의 GPU는 무엇입니까?
대형 모델(70B+)의 경우: NVIDIA H200 SXM5(141GB HBM3E, 4.8TB/s)는 대부분의 워크로드에 대해 최고의 성능을 제공합니다. 프론티어 모델의 최대 처리량: B200 SXM6 리드. 비용에 민감한 중간 범위의 경우: AMD MI300X(192GB HBM3, $10K–$15K가 H200보다 낮음)가 점점 더 경쟁이 치열해지고 있습니다. Edge/Single-GPU 추론의 경우: NVIDIA L40S(48GB GDDR6)는 비용과 기능의 균형을 잘 맞춥니다.
LLM 추론은 단계별로 어떻게 작동합니까?
- 토큰화: 입력 텍스트가 정수 토큰 ID로 변환됩니다. 2. 사전 채우기: 모든 입력 토큰은 하나의 순방향 패스로 동시에 처리되어 KV-캐시와 첫 번째 출력 토큰을 생성합니다. 3. 디코딩: 새로운 토큰이 한 번에 하나씩 생성되며, 각각은 전체 kv-cache에 참석합니다. 4. 연속 일괄 처리: 다수의 동시 요청은 기내 일괄 처리를 통해 GPU 컴퓨팅을 공유합니다. 5. 스트리밍: 출력 토큰은 디토큰화되어 생성되는 대로 클라이언트로 스트리밍됩니다.
LLM 추론에서 TTFT와 ITL은 무엇입니까?
TTFT(최초 토큰까지의 시간)는 요청 제출부터 첫 번째 출력 토큰이 반환되는 시간을 측정합니다. 즉, 사용자가 "대기 시간"으로 인식하는 대기 시간입니다. 프리필 스테이지가 지배합니다. ITL(Inter-Token Latency)은 디코딩 중 연속 출력 토큰 사이의 평균 시간을 측정합니다. 즉, 사용자가 보는 "스트리밍 속도"를 결정합니다. 둘 다 실시간 채팅에 최적화되어야 합니다. 일반적으로 TTFT < 200ms 및 Itl < 30ms가 반응형 경험을 제공합니다.
KV-캐시란 무엇이며 왜 중요한가?
kv-cache(키-값 캐시)는 대화 컨텍스트의 모든 토큰에 대한 중간 주의 계산(키 및 값)을 저장합니다. 그것 없이 모델은 모든 새로운 토큰인 O(n²) 컴퓨팅에 대해 전체 컨텍스트 창을 재처리해야 합니다. 이를 통해 각 디코딩 단계는 하나의 새로운 토큰만 처리하므로 LLM 추론이 가능합니다. KV-Cache 크기는 GPU가 제공할 수 있는 동시 사용자 수와 컨텍스트 창의 시간에 대한 기본 제약 조건입니다.
AI 추론 비용은 1M 토큰당 얼마입니까?
자체 호스팅 하드웨어(8×H200, 3년 상각, $0.12/kWh, 80% 활용, Llama-3-70B FP8): 대략 1M 입력 토큰당 $0.18 및 1M 출력 토큰당 $0.71. 공용 API를 통해: GPT-4O 비용은 1M의 토큰당 $2.50/$10.00의 입력/출력 비용입니다. Claude Sonnet 비용은 $3.00/$15.00입니다. 규모에 따른 자체 호스팅은 5~20배의 비용 절감을 제공하며, 손익분기점은 일반적으로 API 공급자 및 모델에 따라 5~15m의 출력 토큰/일을 제공합니다.
CPU에서 AI 추론을 실행할 수 있습니까?
예 — 더 작고 양자화된 모델의 경우. Llama.cpp는 모든 x86 CPU에서 Int4/Int8 추론을 가능하게 합니다. AMX가 있는 이중 소켓 Xeon 플래티넘은 7B INT4 모델에서 ~25–40 토큰/초를 생성하며, 이는 비실시간 워크로드에 적합합니다. 프로덕션 처리량에서 70B+ 모델에서는 CPU 추론을 실행할 수 없습니다. 경제성은 GPU 렌탈 비용이 처리량의 가치를 초과하는 개발, 테스트 및 지연 시간 허용 배치 작업을 위해 작동합니다.
LLM 추론에서 prefill과 decode의 차이점은 무엇입니까?
Prefill은 한 번의 병렬 작업으로 전체 입력 프롬프트를 처리합니다(컴퓨팅 바운드, 빠름, 프롬프트 길이로 확장). Decode는 자동 회귀 루프(메모리 대역폭 바운드, 토큰당 느린), 출력 길이 및 동시 사용자에 따라 확장되는 출력 토큰을 한 번에 하나씩 생성합니다. 첫 번째 토큰이 생성될 때 그들 사이의 전환은 TTFT입니다. 프리필을 최적화하면 TTFT가 줄어듭니다. 디코드를 최적화하면 ITL이 줄어들고 처리량이 향상됩니다.
AI 추론과 API 사용은 언제 자가 호스팅해야 합니까?
다음과 같은 경우 API를 사용합니다. 볼륨이 낮음(< 2M 토큰/일), 프론티어 폐쇄형 모델(GPT-4O, Claude)이 필요하거나 프로토타이핑 중이고 CAPEX가 제로를 원합니다. 자체 호스팅: 일일 5M 토큰을 초과하는 볼륨, 데이터 개인 정보 보호 또는 규정 준수가 필요하거나, 모델을 미세 조정하거나 제어하고 싶거나, 속도 제한 없이 보장된 SLA가 필요합니다. 대부분의 API와의 손익분기점은 모델과 부피에 따라 3~18개월이며, 그 후 온프레미스는 몇 년 동안 유리하게 비교됩니다.
빌드 또는 구매 — Atal Networks를 사용한 다음 단계
이 지점에 도달했다면 AI 추론이 무엇인지, 어떻게 작동하는지, 비용이 얼마인지, AI 추론이 무엇인지에 대한 완전한 그림을 볼 수 있습니다. 다음 질문은 실행입니다.
Atal Networks는 API 종속성을 능가하는 기업을 위한 특수 제작 AI 추론 인프라를 전문으로 합니다. 우리 팀은 의료, 금융 서비스, 제조 및 소프트웨어 부문 전반에 걸쳐 GPU 클러스터를 설계 및 배포했으며 브로셔가 아닌 벤치마크 데이터를 게시합니다.
우리의 전용 서버 구성 H100, H200 및 MI300X 시스템을 사용하는 고처리량, 온프레미스 추론 배포의 경우.
낮은 Capex 진입점을 찾고 계십니까? 우리의 GPU 최적화 VPS 계획 랙을 소유하지 않고 오늘 개인 추론 워크로드를 실행할 수 있습니다.
숫자를 말할 준비가 되셨습니까? 방문 atalnetworks.com 영업 스크립트가 아닌 하드웨어 엔지니어와 직접 대화하십시오.
