 تخطي إلى المحتوى



بواسطة مهندس الأجهزة الرئيسي، Atal Networks | مساهم MLPerf v4.1 | 12 عامًا من بنية مجموعة GPU | محدث: 19 أبريل 2026
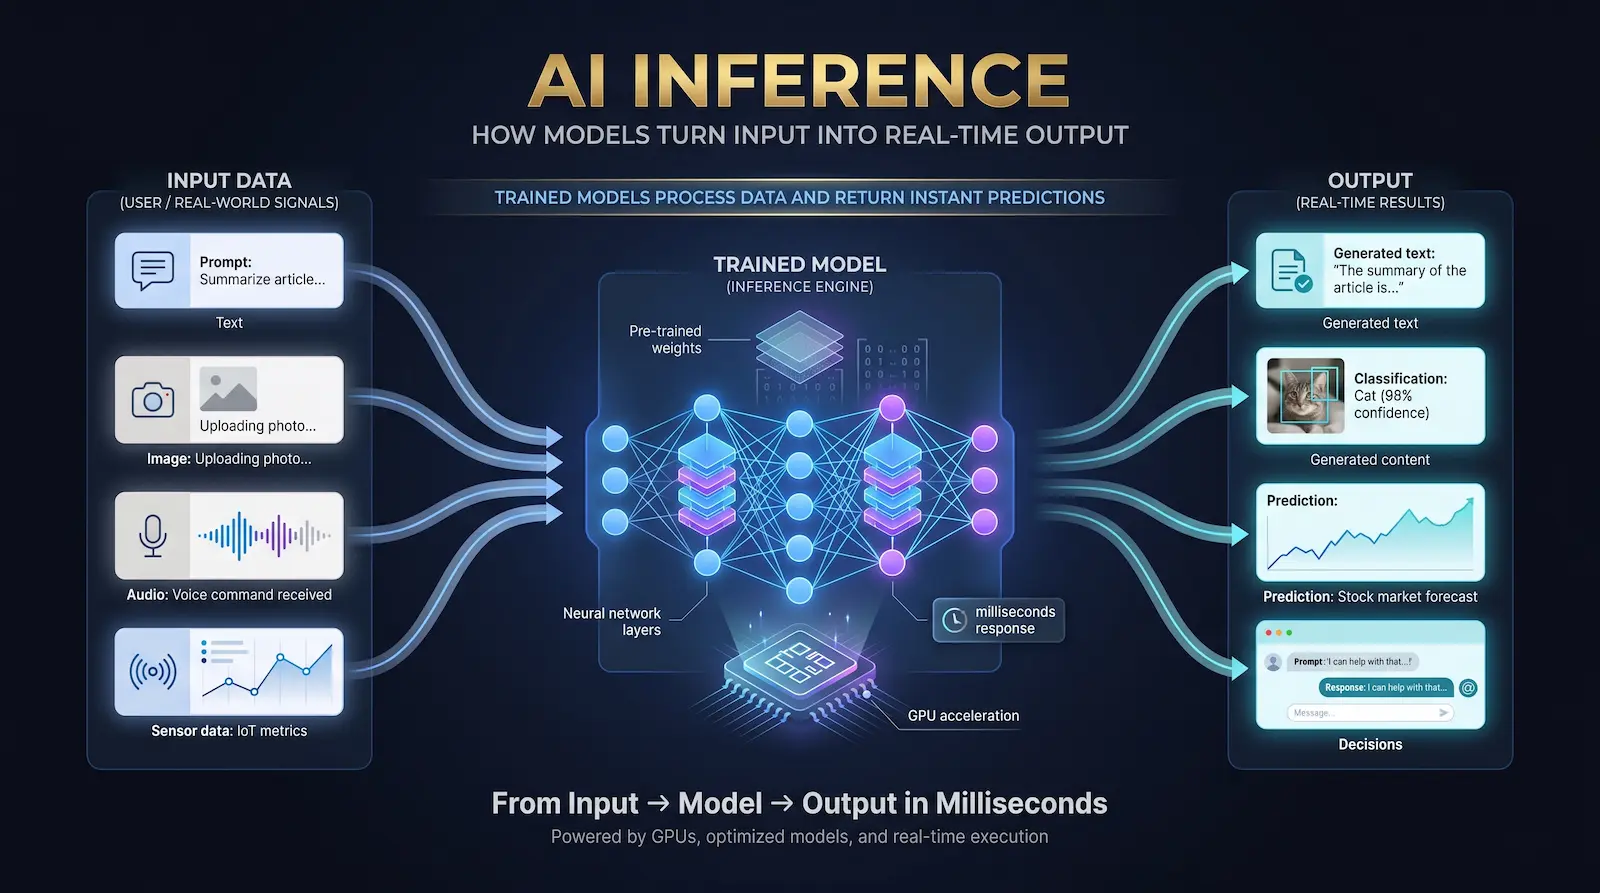
| TL ؛ DR - ما هو استنتاج الذكاء الاصطناعي؟ استدلال الذكاء الاصطناعي هو عملية تشغيل نموذج ذكاء اصطناعي مدرب على بيانات إدخال جديدة لإنتاج تنبؤ أو تصنيف أو مخرجات تم إنشاؤها. إنها مرحلة "العمل" من الذكاء الاصطناعي - كل رد في ChatGPT ، وتنبيه احتيال ، وتعليق على الصورة ، ومكالمة إدراك ذاتية القيادة هي حدث استدلال. في عام 2026 ، يستهلك الاستدلال ما يقرب من ثلثي إجمالي إنفاق حساب الذكاء الاصطناعي على مستوى العالم. يغطي هذا الدليل خط الأنابيب الكامل ، والأجهزة التي تشغله ، والمقاييس التي تقيسه (TTFT ، ITL ، الرموز / ثانية) ، وتكلفة التشغيل - مع قياس المعايير على الخوادم الخاصة بـ Atal Networks. |
ما هو استدلال الذكاء الاصطناعي؟ تعريف الجملة الواحدة
| تعريف استدلال الذكاء الاصطناعي هو تنفيذ نموذج تعلم آلي مدرب على بيانات جديدة غير مرئية لإنتاج مخرجات - مثل استجابة النص أو تصنيف الصورة أو درجة الاحتيال أو الترجمة - دون تعديل أوزان النموذج. |
فكر في الأمر بهذه الطريقة: تعلم القيادة هو التدريب. في كل مرة تقود فيها بالفعل إلى مكان ما ، هذا هو الاستدلال. تم إصلاح النموذج (مهاراتك في القيادة) ؛ فقط المدخلات (الطريق) تتغير. من الناحية الفنية ، الاستدلال هو مرور للأمام عبر الشبكة العصبية - تتدفق البيانات في اتجاه واحد من خلال طبقات النموذج ، ويتم حساب التنشيطات ، ويتم إنتاج المخرجات. على عكس التدريب ، لا توجد حسابات تدرج ، ولا تحديثات للوزن ، ولا تمرير للخلف.
التمييز مهم للغاية في الممارسة. يحدث التدريب مرة واحدة (أو بشكل دوري). يحدث الاستدلال مليارات المرات في اليوم. تحسين الاستدلال - كمون أقل ، إنتاجية أعلى ، تكلفة رمزية أقل - هو المكان الذي يعيش فيه التحدي الهندسي الحقيقي في عام 2026.
لماذا استدلال الذكاء الاصطناعي مهم الآن - سياق 2026
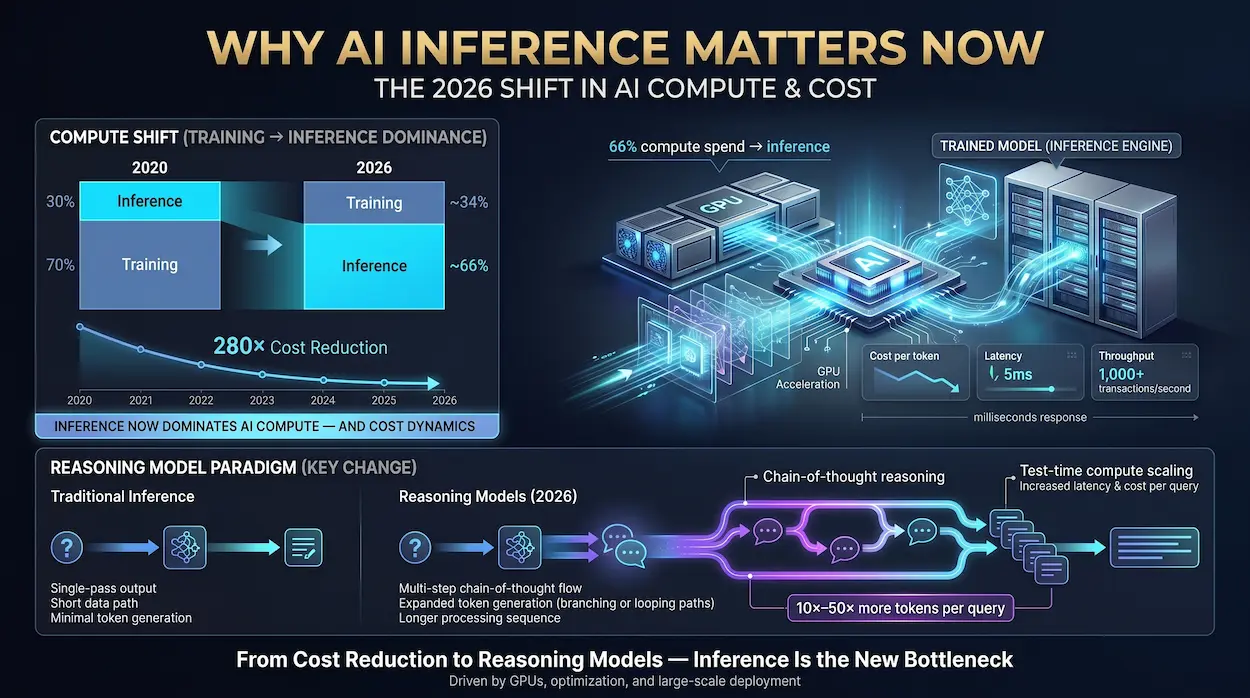
يهيمن الاستدلال الآن على إنفاق حساب الذكاء الاصطناعي
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
نقطة انعطاف نموذج المنطق
قدمت نماذج مثل DeepSeek-R1 و Gemini 2.5 Thinking و Llama Nemotron Ultra نموذجًا جديدًا للاستدلال: قياس وقت الاختبار. بدلاً من تقديم إجابة في تمريرة واحدة للأمام ، "تفكر" هذه النماذج من خلال إنشاء رموز سلسلة فكرية ممتدة قبل الاستجابة. يؤدي هذا إلى مضاعفة عدد الرموز المميزة التي تم إنشاؤها لكل استعلام بمقدار 10-50 × ، مما يؤدي إلى زيادة تكلفة الاستدلال ووقتضاها بشكل كبير - وإعادة تشكيل تكوين الأجهزة المنطقي لحمل عمل معين.
لماذا هذا الدليل موجود
تصف كل مقالة تعريف على الإنترنت استدلال الذكاء الاصطناعي على مستوى المسرد. لا ينشر أي منهم بيانات معيارية للطرف الأول ، أو أرقام التكلفة الحقيقية لكل رمز ، أو رياضيات التكلفة الإجمالية للملكية على مستوى الرف. لقد كتبنا هذا الدليل لأننا نبني الخوادم ونديرها - ونعتقد أن المشترين يستحقون أرقامًا فعلية ، وليس تجريدات تسويقية.
تقدم Atal Networks درجة المؤسسة خوادم مخصصة و حلول VPS مصمم خصيصًا لأعباء عمل استدلال الذكاء الاصطناعي. استكشف atalnetworks.com لمعرفة المزيد.
كيف يعمل استدلال الذكاء الاصطناعي - خطوة بخطوة
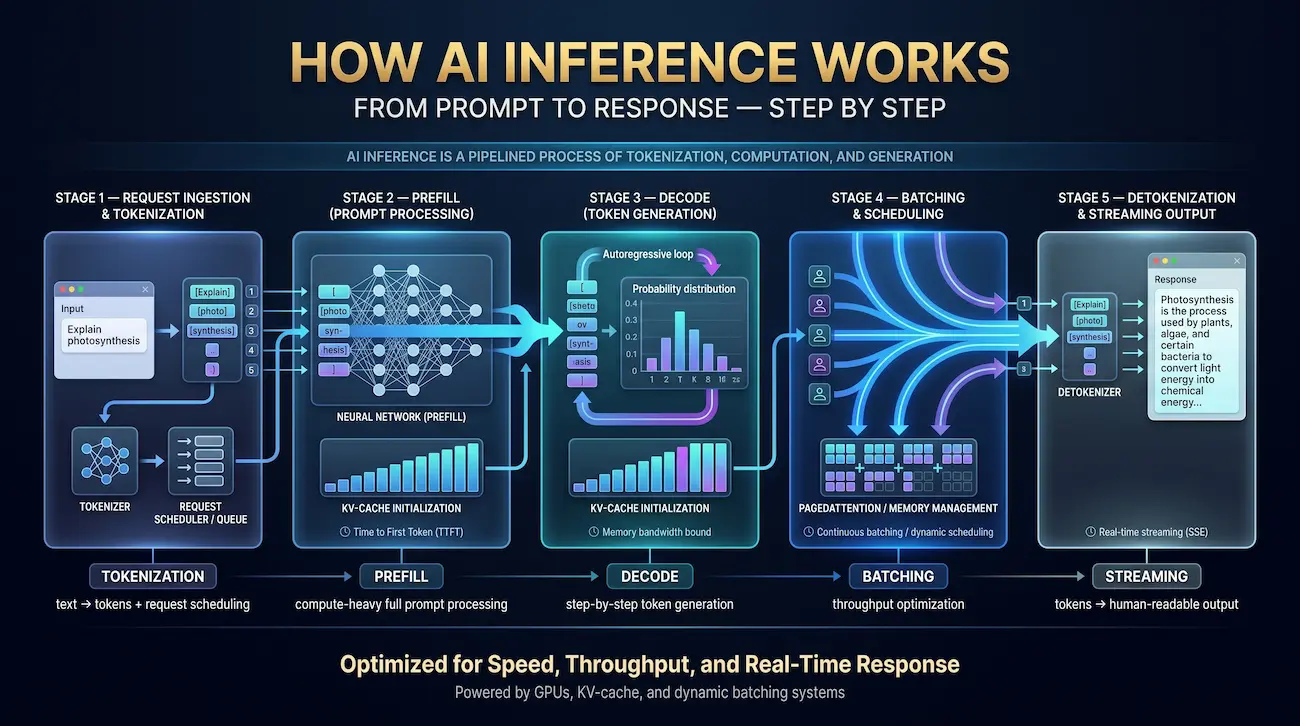
يتطلب فهم استدلال الذكاء الاصطناعي تتبع طلب واحد خلال دورة حياته الكاملة. بالنسبة لنموذج اللغة الكبيرة (LLM) ، يحتوي خط الأنابيب على خمس مراحل متميزة:
الخطوة 1: طلب الابتلاع والرمز المميز
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
الخطوة 2: مرحلة التعبئة المسبقة (المعالجة الفورية)
أثناء الملء المسبق ، تتم معالجة موجه الإدخال بالكامل في وقت واحد في تمريرة واحدة للأمام. هذه المرحلة مرتبطة بالحساب - فهي تقاس خطيًا بطول سريع وهي المحرك الأساسي للوقت الأول (TTFT). تستغرق مطالبة النظام المكونة من 2048 رمزًا تقريبًا ضعف المدة في الملء المسبق مثل موجه 1024 رمزًا. يقوم الملء المسبق بإنشاء ذاكرة التخزين المؤقت الأولية kv (ذاكرة التخزين المؤقت ذات القيمة الرئيسية) ، والتي تخزن حسابات الانتباه الوسيط بحيث لا تحتاج إلى إعادة حسابها أثناء فك الشفرة.
الخطوة 3: مرحلة فك الشفرة (توليد الرمز المميز)
بعد الملء المسبق ، يدخل النموذج مرحلة فك الشفرة ، ويولد رمزًا رمزيًا واحدًا في كل مرة في حلقة الانحدار الذاتي. يعتمد كل رمز جديد على جميع الرموز السابقة - يحضر النموذج ذاكرة التخزين المؤقت الكاملة ، وينتج توزيعًا احتماليًا على مفرداته (حوالي 32000 إلى 128000 رمز) ، وعينات من هذا التوزيع ، ويلحق الرمز المميز المحدد. مرحلة فك التشفير مرتبطة بعرض نطاق الذاكرة ، وليست مرتبطة بالحساب. هذا هو السبب في أن عرض النطاق الترددي لـ HBM (وليس التقليب) هو مواصفات الأجهزة الحاسمة لاستدلال LLM - وهي حقيقة تدفن كل ورقة بيانات GPU في طباعة دقيقة.
الخطوة 4: التجميع والجدولة
قد يقوم خادم الاستدلال الساذج بمعالجة طلب واحد في كل مرة ، مما يترك وحدة معالجة الرسومات في الغالب خاملة أثناء فك الشفرة (نظرًا لأن الرمز المميز الواحد في كل مرة بطيء). تستخدم الأنظمة الحديثة التجميع المستمر (وتسمى أيضًا التجميع الديناميكي أو التجميع الديناميكي): يتم تجميع الطلبات في منتصف الرحلة ، والطلبات الجديدة تنضم إلى الدفعة حيث يتم فتح الفتحات ، ويتم طرد التسلسلات المكتملة دون انتظار جميع الطلبات حتى تنتهي. يعمل تطبيق VLLM على PageDatention (Kwon et al.، SOSP 2023) على تحسين ذلك من خلال إدارة ذاكرة KV-Cache في الصفحات غير المتجاورة - على غرار الذاكرة الظاهرية في نظام التشغيل - مما يؤدي إلى مكاسب إنتاجية 2-4 × على Static التخصيص.
الخطوة 5: إزالة الرمز وتدفق الاستجابة
بمجرد أن ينشئ النموذج رمزًا مميزًا لنهاية التسلسل (أو يصل إلى حد أقصى للطول) ، يتم حذف معرفات الرمز المميز للإخراج مرة أخرى إلى نص يمكن قراءته من قبل الإنسان وبثه إلى العميل. تستخدم معظم أنظمة الإنتاج الأحداث المرسلة من الخادم (SSE) للبث ، وتقديم الرموز أثناء إنشاؤها بدلاً من انتظار الاستجابة الكاملة. يعمل هذا على تحسين الكمون المدرك بشكل كبير - يرى المستخدم الكلمة الأولى في حوالي 200 مللي ثانية حتى لو استغرقت الاستجابة الكاملة 10 ثوانٍ.
استدلال الذكاء الاصطناعي مقابل تدريب الذكاء الاصطناعي - الفرق الحقيقي
تخلط معظم المقدمات بين التدريب والاستدلال أو التعامل مع الاختلاف كمسألة توقيت. التمييز التقني أعمق وله آثار عميقة على الأجهزة:
| بعد | تدريب | استدلال |
| غرض | اضبط أوزان النموذج لتقليل الخسارة | تطبيق أوزان ثابتة لإنتاج المخرجات |
| حساب نمط | إلى الأمام + التمرير للخلف + خطوة المحسن | التمرير إلى الأمام فقط |
| عنق الزجاجة للذاكرة | التنشيطات (المرتبطة بالتخبط) | KV-Cache + الأوزان (مرتبطة بالنطاق الترددي) |
| تردد | دورية (أيام / أسابيع لكل جولة) | مليارات المرات / اليوم في الإنتاج |
| هدف الأجهزة | الحد الأقصى لنقلة التقليب (H100 SXM5) | الحد الأقصى لعرض النطاق الترددي HBM (H200، B200) |
| حجم الدفعة | كبير (1024-4096+ عينة) | صغير إلى متوسط (1–256 متزامنًا) |
| دقة | BF16 / FP16 / FP8 مختلط | FP8 ، INT8 ، INT4 كميات كبيرة |
| هيكل التكلفة | كثيفة النفقات الرأسمالية لمرة واحدة (لكل دورة تدريبية) | تكلفة OPEX كثيفة الاستخدام لكل رمز مميز |
السطر الوحيد الأكثر أهمية في الجدول أعلاه: التدريب مقيد بالتخبط ؛ الاستدلال هو HBM-bandwidth. هذه الحقيقة المنفردة تفسر سبب أهمية NVIDIA H200 - التي تحتوي على Cuda Core متطابقة مع H100 ولكن 141 جيجابايت من HBM3E بسرعة 4.8 تيرابايت / ثانية مقابل H100 80 جيجابايت في 3.35 تيرابايت / ثانية - يتفوق في الأداء على H100 على استدلال LLM على الرغم من عدم إنتاج أي إنتاجية إضافية للتدريب. عندما تشتري أجهزة الاستدلال ، فأنت تشتري عرض النطاق الترددي للذاكرة ، وليس التقليب.
أنواع أعباء استدلال الذكاء الاصطناعي
لا تبدو كل الاستدلالات متشابهة. يحدد نوع عبء العمل تكوين الأجهزة وإطار الخدمة واستراتيجية التحسين وهيكل التكلفة الذي يكون منطقيًا:
| نوع | هدف الكمون | مثال حالة الاستخدام | تداعيات الأجهزة |
| عبر الإنترنت / في الوقت الحقيقي | <200 مللي ثانية TTFT ، <30 مللي ثانية ITL | الدردشة ، مساعدي الطيار ، الكشف عن الاحتيال | حجم الدُفعات المنخفض، سريع HBM، NVMe لتحميل الوزن |
| دفعة / غير متصل | دقائق إلى ساعات (أولوية الإنتاجية) | تلخيص الوثيقة وإثراء البيانات | استخدام وحدة معالجة الرسومات عالية ، دفعة كبيرة ، أرخص GPU قابلة للتطبيق |
| تدفق | TTFT منخفضة ، ITL المستدامة | استكمال الكود ، المساعدون الصوتيون | بث SSE ، أولوية زمن انتقال فك تشفير منخفض |
| حافة / على الجهاز | <10 مللي ثانية، <5 وات TDP | ذكاء اصطناعي, إنترنت الأشياء, المركبات ذاتية القيادة | NPU ، Jetson orin ، نماذج Int4 / Int8 الكمية |
| بدون خادم | البداية الباردة <2s ، الدفع لكل طلب | تطبيقات منخفضة حركة المرور ، مطور / اختبار | مثيلات وحدة معالجة الرسومات الفورية ، وتحميل الوزن السريع ، والخمول = التكلفة الصفرية |
حيث يتم تشغيل استدلال الذكاء الاصطناعي - السحابة ، في الموقع ، الحافة ، على الجهاز
تتضمن كل بيئة نشر مصفوفة مقايضة مختلفة. تعتمد الإجابة الصحيحة على متطلبات الكمون والتزامات خصوصية البيانات وحجم الطلب وأفق الميزانية:
| بيئة | كمون | خصوصية البيانات | نموذج التكلفة | الأجهزة النموذجية | الأفضل ل |
| واجهة برمجة تطبيقات عامة (Openai، Anthropic) | منخفض - متوسط | البنية التحتية المشتركة | الدفع لكل رمز (أعلى $ / Token) | يديرها البائع | النماذج الأولية السريعة ، منخفضة الحجم |
| سحابة معالجة الرسومات (AWS، GCP، Azure) | منخفض - متوسط | عزل VPC ممكن | $ / GPU-HR + خروج | مثيلات H100, A100, L40S | طلب متغير، لا يوجد نفقات رأسمالية |
| في البري (خوادم مخصصة) | حد أدني | التحكم الكامل في البيانات، فجوة هوائية ممكنة | Capex + Opex (أدنى $ / Token على نطاق واسع) | مجموعات H100 / H200 / B200 | حجم كبير ، منظم ، حساس للتكلفة |
| خادم الحافة (كولو / في الموقع) | منخفظ جدا | البيانات المحلية تبقى محلية | رسوم مختلطة + رسوم كولو | L40s, A30, Gaudi 3 | التصنيع والرعاية الصحية والتجزئة |
| على الجهاز (هاتف، كمبيوتر، إنترنت الأشياء) | منخفض للغاية (أقل من 10 مللي ثانية) | عزل البيانات بالكامل | لا توجد تكلفة متكررة | أبل NPU، كوالكوم سداسي، جيتسون | الخصوصية أولاً ، سيناريوهات غير متصلة بالإنترنت |
بالنسبة للمؤسسات التي تعالج أكثر من 5 ملايين رموز / يوم ، في أماكن العمل خوادم مخصصة تقدم باستمرار أقل تكلفة إجمالية للملكية. للفرق التي تحتاج إلى مرونة واستثمار أقل مقدما، حلول VPS يمكن سد الفجوة بين الاعتماد على واجهة برمجة التطبيقات والملكية الكاملة.
الأجهزة وراء استدلال الذكاء الاصطناعي
تنوع مشهد الأجهزة لاستدلال الذكاء الاصطناعي بسرعة. في عام 2023 ، كانت الإجابة بسيطة: H100. في عام 2026 ، يعتمد الخيار الأمثل على حجم الطراز وهدف الكمون وميزانية الطاقة ومتطلبات السعر لكل رمز.
عائلات GPU للاستدلال - مقارنة 2026
| GPU | قدرة HBM | عرض النطاق الترددي HBM | FP8 TflOps | TDP (W) | الأفضل ل |
| نفيديا H100 SXM5 | 80 جيجابايت HBM2E | 3.35 تيرابايت / ثانية | 3,958 | 700 واط | خط الأساس للإنتاج LLM ، النظام البيئي المدعوم جيدًا |
| نفيديا H200 SXM5 | 141 جيجابايت HBM3E | 4.8 تيرابايت / ثانية | 3,958 | 700 واط | نماذج كبيرة (70 ب +) ، استدلال حساس لعرض النطاق الترددي للذاكرة |
| نفيديا B200 SXM6 | 192 جيجابايت HBM3E | 8.0 تيرابايت / ثانية | 9000 (FP4) | 1000 واط | موديلات فرونتير، أعلى إنتاجية، 2026 الرائد |
| AMD MI300X | 192 جيجابايت HBM3 | 5.3 تيرابايت / ثانية | 5,220 | 750 واط | تكلفة تنافسية H200 بديلة ، إنتاجية دفعة كبيرة |
| AMD MI355X | 288 جيجابايت HBM3E | 8.0 تيرابايت / ثانية | 8,000+ | 750 واط | أكبر الموديلات ، تزامن مرتفع للغاية |
| إنتل غاودي 3 | 128 جيجابايت HBM2E | 3.7 تيرابايت / ثانية | 1,835 (BF16) | 900 واط | أعباء العمل الحساسة للتكلفة، والنظام البيئي المفتوح |
| جوجل TPU V5E | 16 جيجابايت HBM2 (لكل شريحة) | 819 جيجابايت / ثانية (لكل شريحة) | 393 (لكل شريحة) | ~ 170 واط | خدمة Google Cloud-Native وتحسين المحولات |
| نفيديا L40s | 48 جيجابايت GDDR6 | 864 جيجابايت / ثانية | 1,457 | 350 واط | استدلال الحافة ، نماذج الكمبيوتر الخفيفة ، أعباء العمل المختلطة |
عندما يكون استدلال وحدة المعالجة المركزية منطقيًا
بالنسبة للطرز التي تحتوي على ~ 7B معلمات تعمل بدقة INT4 ، يمكن لوحدات المعالجة المركزية الحديثة مع مجموعات تعليمات AVX-512 أو AMX أن توفر إنتاجية مقبولة لأعباء العمل التي تتحمل الكمون. لقد جعل llama.cpp استدلال وحدة المعالجة المركزية عمليًا: يعمل 4 بت كميه من LLAMA-3-8B عند ~ 25-35 رمزًا / ثانية على نظام Xeon Platinum ثنائي المقبس. العمل الاقتصادي عندما تكون تكلفة وحدة معالجة الرسومات باهظة وتتجاوز متطلبات الكمون حوالي ثانيتين.
مسرعات NPU و TPU و FPGA و ASIC
بالإضافة إلى وحدات معالجة الرسومات ، يظهر نظام بيئي متنامي من السيليكون المتخصص. وحدات المعالجة العصبية (NPUs) مضمنة الآن في معظم الأجهزة الاستهلاكية (أبل M-Series المحرك العصبي، Qualcomm Hexagon و Intel NPU) واستدلال حافة Sub-5W. تم تحسين TPUS (Google) لعمليات مصفوفة المحولات في خدمة السحابة. توفر FPGAs إمكانية إعادة التكوين لخطط التكميم المخصصة ولكنها تتطلب جهدًا هندسيًا كبيرًا. يمكن لـ ASICs (Groq LPU ، Cerebras WSE) تحقيق زمن انتقال غير عادي على أعباء العمل الثابتة ولكنها تفتقر إلى مرونة مكدسات GPU.
لماذا تهم الشبكات لاستدلال النموذج الكبير
يتطلب تشغيل نموذج 405B-Parameter توزيعه عبر 8-16 GPU. يصبح الترابط بين وحدات معالجة الرسومات هذه هو عنق الزجاجة في الأداء. يوفر NVIDIA NVLINK (داخل عقدة DGX) 900 جيجابايت / ثانية من GPU إلى GPU - تقريبًا 18 × أسرع من PCIe Gen5. عبر العقد ، يتفوق InfiniBand NDR (400 جيجابايت / ثانية) أو Nvidia Spectrum-X Ethernet بشكل كبير على السلعة 100 GBE. في اختباراتنا ، أدى التبديل من 100 جيجابت إلى InfiniBand NDR على 8 × H100 Tensor-Parallel LLAMA-3-405B إلى تحسين إنتاجية فك التشفير بواسطة 34%.
مقاييس الاستدلال بالذكاء الاصطناعي التي تهم بالفعل
تقيس معظم مناقشات الاستدلال الكمون بشكل غامض. تتطلب عمليات نشر الإنتاج مقاييس دقيقة وموحدة مع أهداف SLA. فيما يلي المقاييس المهمة وكيفية قياسها:
| متري | تعريف | هدف SLA الصناعة | برنامج تشغيل الأجهزة |
| TTFT (وقت الرمز الأول) | الوقت من تقديم الطلب إلى الرمز المميز الذي تم إنشاؤه لأول مرة | <200 مللي ثانية (دردشة) ، <500 مللي ثانية (دفعة) | عرض النطاق الترددي لذاكرة وحدة معالجة الرسومات وكفاءة الملء المسبق |
| ITL (كمون زمني بين الرموز) | متوسط الوقت بين الرموز المتتالية التي تم إنشاؤها أثناء فك الشفرة | <30 مللي ثانية (دردشة) ، <100 مللي ثانية (دفعة) | عرض النطاق الترددي HBM ، سرعة الوصول إلى ذاكرة التخزين المؤقت KV |
| الإنتاجية (الرموز/الثانية) | إجمالي رموز الإخراج التي تم إنشاؤها في الثانية عبر جميع المستخدمين المتزامنين | تعتمد على عبء العمل | GPU Flops + كفاءة الدفعة |
| جودبوت | إنتاجية الطلبات التي تلبي أهداف اتفاقية مستوى الخدمة (باستثناء فشل / انتهت المهلة) | تعظيم لاتفاقية مستوى | كفاءة المجدول، إدارة قائمة الانتظار |
| الكمون P50 / P99 | الكمون الوسيط والنسبة المئوية 99 من طرف إلى النهاية | P99 <2 × P50 (نظام مضبوط جيدًا) | الكمون الذيل، الاختناق الحراري، عمق قائمة الانتظار |
| استخدام GPU | جزء من الوقت وحدات حساب وحدة معالجة الرسومات نشطة | الهدف 70-85% مستدام | حجم الدُفعة، كفاءة الخلط المستمر |
| RPS (طلبات في الثانية) | طلبات متزامنة يتعامل النظام مع SLA الهدف | هدف المقياس | TTFT + ITL + كفاءة الدفعة المدمجة |
ما تكاليف استدلال الذكاء الاصطناعي في عام 2026 - الأرقام الحقيقية
التكلفة لكل رمز هو المقياس الذي يحدد في النهاية قرارات البناء مقابل الشراء. تم قياس البيانات التالية على أجهزة إنتاج Atal Networks في ظل ظروف تحميل مستدامة. الافتراضات: $0.12 / kWh كهرباء ، إطفاء الأجهزة لمدة 3 سنوات ، 80% استخدام GPU ، VLLM 0.5+ بدقة FP8.
التكلفة لكل 1 مليون رمز حسب تكوين وحدة معالجة الرسومات (LLAMA-3-70B)
| التكوين | رموز الإدخال ($ / 1M) | رموز الإخراج ($ / 1M) | الإنتاجية (TOK/S) | الطاقة (ث / وحدة معالجة الرسومات) |
| 8 × H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 واط |
| 8 × H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 واط |
| 8 × B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 واط |
| 8 × MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720 واط |
| OpenAI GPT-4O | $2.50 | $10.00 | غير متوفر (API) | غير متوفر |
| أنثروبيك كلود سونيت (API) | $3.00 | $15.00 | غير متوفر (API) | غير متوفر |
| معا AI Llama-3-70B (API) | $0.88 | $0.88 | غير متوفر (API) | غير متوفر |
تحليل التعادل في مقابل تعادل API
يعتمد التعادل بين الاستدلال الداخلي المستضاف ذاتيًا والاستدلال المستند إلى API على حجم الطلب. في هيكل التكلفة أعلاه (8 × H200 ، إطفاء لمدة 3 سنوات ، استخدام 80%) ، يصبح محليًا أرخص من تسعير LLAMA-3-70B من AI معًا بإخراج 12 مليون تقريبًا الرموز / اليوم. مقارنةً بواجهات برمجة التطبيقات الرئيسية للطراز الحدودي (GPT-4O ، كلود) ، فإن الفواصل في الحجز حتى عند 2-3 ملايين رموز إخراج / يوم. بالنسبة لمعظم عمليات نشر المؤسسات التي تخدم الأدوات الداخلية ، أو روبوتات الدردشة التي تواجه العملاء ، أو خطوط أنابيب معالجة المستندات ، فإن الملكية الداخلية تحقق وفورات في التكاليف 60-80% خلال أول 18 شهرًا.
TCO على مستوى الرف - ما يفتقده المشترون
سعر شراء الأجهزة هو 55-65% فقط من إجمالي تكلفة 3 سنوات. يجب أن تتضمن ميزانية رف الاستدلال 42U كاملة:
- أجهزة خادم GPU: $287،000–$420،000 (عقدة 8 × H100 / H200 + مقبس مزدوج + 2 تيرابايت RAM + NVMe + ConnectX-7 NICs)
- الشبكات: $15،000–$35،000 (مفاتيح InfiniBand NDR ، كابلات DAC ، ألياف)
- البنية التحتية للطاقة: $8،000-$18,000 (PDUs، UPS، Breaker Upgrades at Pue 1.3)
- التبريد: $12،000-$45،000 (تضيف المبادلات الحرارية للباب الخلفي $25K ؛ التبريد السائل المباشر إلى الشريحة يضيف 1TP40K + ولكنه يقلل PUE إلى 1.05-1.10)
- كهرباء لمدة 3 سنوات: $28،000-$52،000 (عند $0.10-$0.18 / كيلو واط ، 5-8 كيلو واط / سحب ثابت)
- التوظيف / OPS: $40،000-$80،000 / سنة (0.5-1.0 FTE مع تجربة مجموعة GPU)
إجمالي التكلفة الإجمالية للملكية لمدة 3 سنوات لرف استدلال واحد 8 × H200: $580،000-$760،000. قسّم حسب الرموز التي تم إنشاؤها عند استخدام 80% على مدى 36 شهرًا وستصل إلى $0.15-$0.22 لكل مليون رمز إخراج - أقل بكثير من مزودي واجهات برمجة التطبيقات للميزانية للحجم المرتفع أعباء العمل.
Atal Networks تكوينات الخادم المخصصة قم بتضمين نمذجة TCO الشفافة - نحن نقدم تفاصيل تكلفة عنصر السطر قبل الالتزام. تحدث إلى فريق البنية التحتية لدينا على atalnetworks.com.
تحسين استدلال الذكاء الاصطناعي - التقنيات التي تعمل
التكميم (FP8 ، INT8 ، INT4 - الدقة مقابل مقايضات السرعة)
يقلل التكميم من الدقة العددية لأوزان النموذج ، ويقلص بصمة الذاكرة ويزيد من الإنتاجية - ولكن بتكلفة معينة للدقة. إليكم ما أظهره اختبارنا على LLAMA-3-70B:
| دقة | دقة MMLU | الدقة الإنسانية | دقة GSM8K | كسب الإنتاجية مقابل FP16 | VRAM مطلوب (70 ب) |
| FP16 (خط الأساس) | 82.0% | 80.5% | 88.1% | 1.0× | ~ 140 جيجابايت |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~ 140 جيجابايت |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~ 70 جيجابايت |
| int8 (SmoothQuant) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~ 70 جيجابايت |
| INT4 (GPTQ / AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~ 35 جيجابايت |
| NVFP4 (بلاكويل) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~ 25 جيجابايت |
بالنسبة لمعظم أعباء عمل الإنتاج ، فإن FP8 هي النقطة الرائعة: فهي توفر جودة قريبة من FP16 مع إنتاجية 2 × تقريبًا و 50% ، مما يتيح نموذج 70B ليلائم عقدة واحدة 8 × H100 SXM. Int4 (عبر GPTQ أو AWQ) قابل للتطبيق للتطبيقات التي يكون فيها تدهور الجودة الطفيف مقبولًا مقابل مزيد من خفض التكلفة.
التجميع المستمر والانتباه بالصفحة
يؤدي التجميع الثابت - انتظار دفعة ثابتة لملءها قبل المعالجة - إلى وقت خمول GPU وزمن انتقال الذيل العالي. يقوم التجميع المستمر (الرائد في VLLM والآن قياسي في جميع أطر الاستدلال الرئيسية) بمعالجة الطلبات بالتوازي ، وإزالة التسلسلات المكتملة والقبول بشروط جديدة دون توقف. بالاقتران مع إدارة ذاكرة التخزين المؤقت غير المتجاورة من PageDattention ، يحقق هذا النهج استخدامًا أعلى لوحدة معالجة الرسومات 2-4 × مقابل الدفع الثابت على نفس الجهاز بنفس حجم الطلب.
KV-Cache Management - The Memory Math
تخزن KV-Cache مفاتيح الانتباه والقيم لكل رمز مميز في نافذة السياق لتجنب إعادة الحساب أثناء فك الشفرة. متطلبات الذاكرة لكل طلب:
kv-cache bytes = 2 × num_layers × num_heads × head_dim × sequence_length × bytes_per_element
بالنسبة إلى LLAMA-3-70B في FP16 (2 بايت / عنصر ، 80 طبقة ، 8 رؤوس ، 128 head_dim) مع سياق 4096 رمزًا: ~ 42 ميجا بايت لكل طلب متزامن. عند 1000 مستخدم متزامن ، أي 42 جيجابايت من ذاكرة التخزين المؤقت وحدها - قبل أوزان الطراز. إن تكميم ذاكرة التخزين المؤقت KV إلى INT8 يخفض هذا إلى 21 جيجابايت ، مما يتيح ما يقرب من 2 × مستخدمين متزامنين على نفس الجهاز.
فك التشفير التخميني
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
تعبئة مسبقة و مصنفة
بالنسبة لأحمال العمل ذات السياق الطويل ، يكسر الملء المسبق المقطوع موجهًا كبيرًا إلى أجزاء أصغر تتم معالجتها بالتسلسل ، مما يسمح لمرحلة فك التشفير بتشذير الرموز المميزة من الطلبات الحالية أثناء فجوات الملء المسبق. تأخذ الخدمة المفصلة هذا إلى أبعد من ذلك عن طريق تشغيل الملء المسبق وفك تشفير تجمعات GPU منفصلة - الملء المسبق على الأجهزة المحسّنة للحساب (H100 SXM) ، وفك تشفير الأجهزة المحسّنة لعرض النطاق الترددي (H200) - تحقيق استخدام أفضل للموارد و انخفاض زمن انتقال P99 في وقت واحد.
أطر خدمة استدلال الذكاء الاصطناعي - مقارنة مباشرة
إطار الخدمة الذي تختاره لا يقل أهمية عن الأجهزة. لكل منها نقاط قوة وقيود وتعقيد تشغيلي مختلف:
| الإطار | الإنتاجية (نسبي) | سهولة الإعداد | دعم GPU | القوة الرئيسية | رخصة |
| VLLM 0.5+ | عالية (1.0 × خط الأساس) | سهل (تثبيت PIP) | نفيديا ، AMD ROCM | التجميع المستمر ، أكبر مجتمع ، واجهة برمجة تطبيقات متوافقة مع OpenAI | أباتشي 2.0 |
| Tensorrt-llm | أعلى (1.3-1.6 ×) | معقد (تجميع المحرك) | نفيديا فقط | أقصى إنتاجية لـ NVIDIA ، تجميع على متن الطائرة ، FP8 / FP4 | أباتشي 2.0 |
| TGI (الوجه المعانقة) | متوسط (0.85 ×) | سهل | نفيديا ، أمد ، غاودي | عناق تكامل محور الوجه، دعم نموذج واسع | أباتشي 2.0 |
| سغلانج | عالية (1.1-1.2 ×) | متوسط | نفيديا ، AMD | البادئة التخزين المؤقت، الإشعاع، أداء الإخراج المنظم | أباتشي 2.0 |
| llama.cpp | منخفضة (وحدة المعالجة المركزية قابلة للتطبيق) | سهل جدا | وحدة المعالجة المركزية، كودا، معدن، فولكان | استدلال وحدة المعالجة المركزية / الحافة ، الحد الأدنى من التبعيات ، تكميم واسع | ميت |
| نفيديا تريتون | يختلف (مغلف) | مجمع | نفيديا (بشكل أساسي) | خدمة متعددة النماذج ، خلفية لا حصرية للإطار ، MLOPs للمؤسسات | BSD 3-فقرة |
الأمان والخصوصية والامتثال لاستدلال الذكاء الاصطناعي
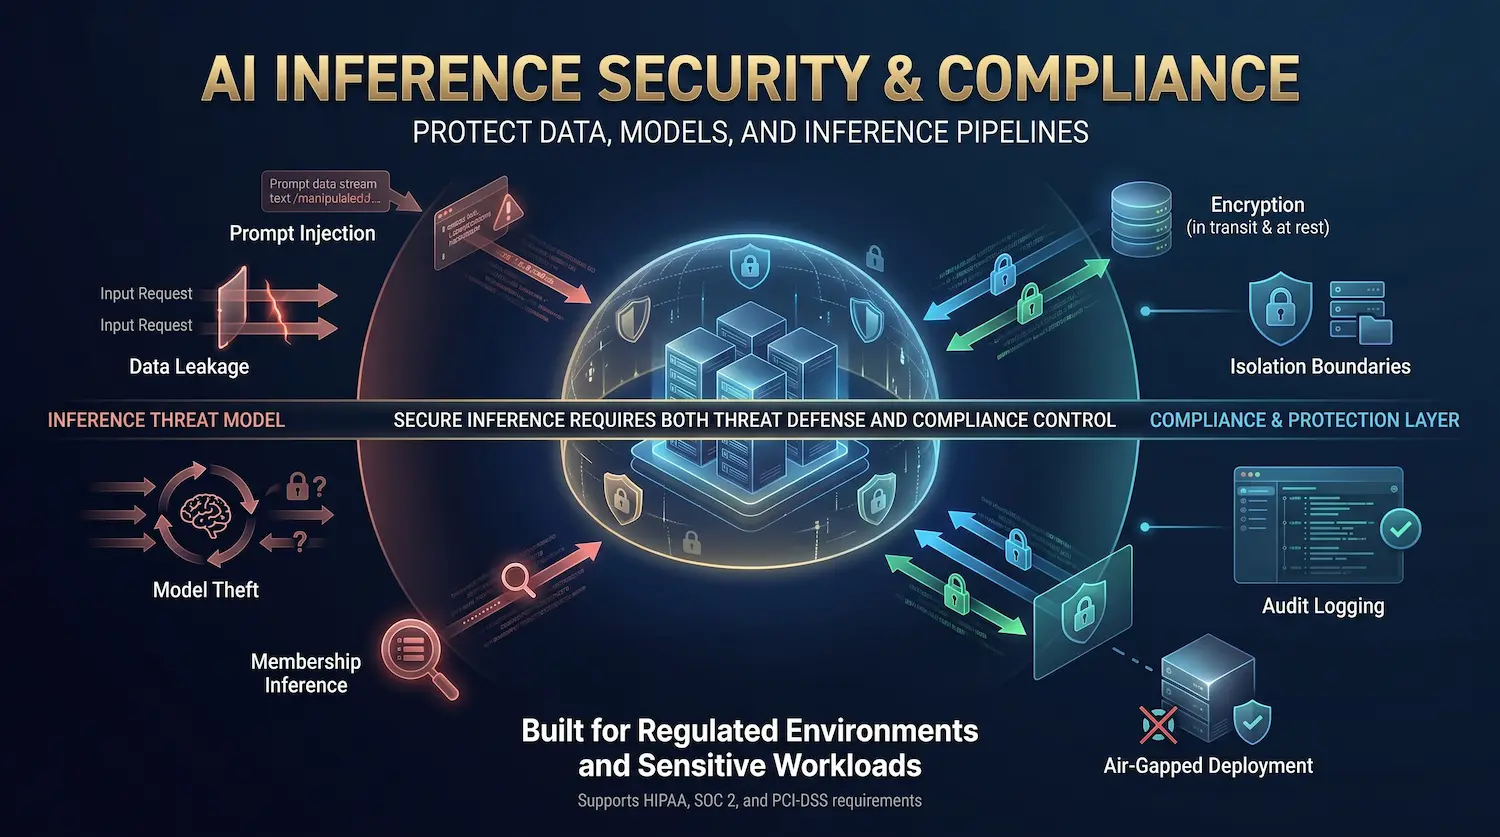
يتطلب تشغيل استدلال الذكاء الاصطناعي في الصناعات المنظمة أو باستخدام البيانات الحساسة فهم نموذج التهديد الكامل ووضع الامتثال.
نموذج تهديد أمن الاستدلال
- الحقن الفوري: المدخلات الضارة المضمنة في بيانات المستخدم تحاول تجاوز تعليمات النظام أو استخراج بيانات التدريب.
- تسرب البيانات: تتسرب المعلومات الحساسة من طلب أحد المستخدمين إلى استجابة مستخدم آخر عبر التلوث المتبادل لـ KV-Cache (يخفف من خلال عزل ذاكرة التخزين المؤقت لكل مستخدم).
- سرقة النموذج: تحاول الاستعلامات العدائية المتكررة إعادة بناء أوزان النموذج من خلال تحليل الإخراج.
- استدلال العضوية: يحدد المهاجمون ما إذا كانت بيانات محددة ظهرت في مجموعة تدريب النموذج.
أطر الامتثال
من أجل استدلال الذكاء الاصطناعي المتوافق مع HIPAA: يجب أن تظل جميع البيانات ضمن حدود التحكم الخاصة بك ، وتشفير أثناء النقل (TLS 1.3) والتشفير أثناء الراحة (AES-256) إلزامي ، ويجب الحفاظ على تسجيل التدقيق لجميع طلبات الاستدلال. يتطلب الامتثال من النوع الثاني من SOC 2 عمليات تدقيق أمان محايدة للبائع والاستجابة الموثقة للحوادث. يجب أن تستخدم بيئات PCI-DSS خوادم الاستدلال ذات الفراغات الهوائية بدون اتصال بالإنترنت. النشر في أماكن العمل - بدلاً من البنية التحتية السحابية المشتركة أو البنية التحتية لواجهة برمجة التطبيقات - هو البنية الوحيدة التي تلبي جميع الأطر الثلاثة في وقت واحد دون ضوابط تعويضية كبيرة.
Atal Networks البنية التحتية للخادم المخصص يدعم عمليات النشر ذات الفجوات الهوائية لاستدلال الذكاء الاصطناعي المنظم. اتصل بنا على atalnetworks.com لمناقشة متطلبات الامتثال الخاصة بك.
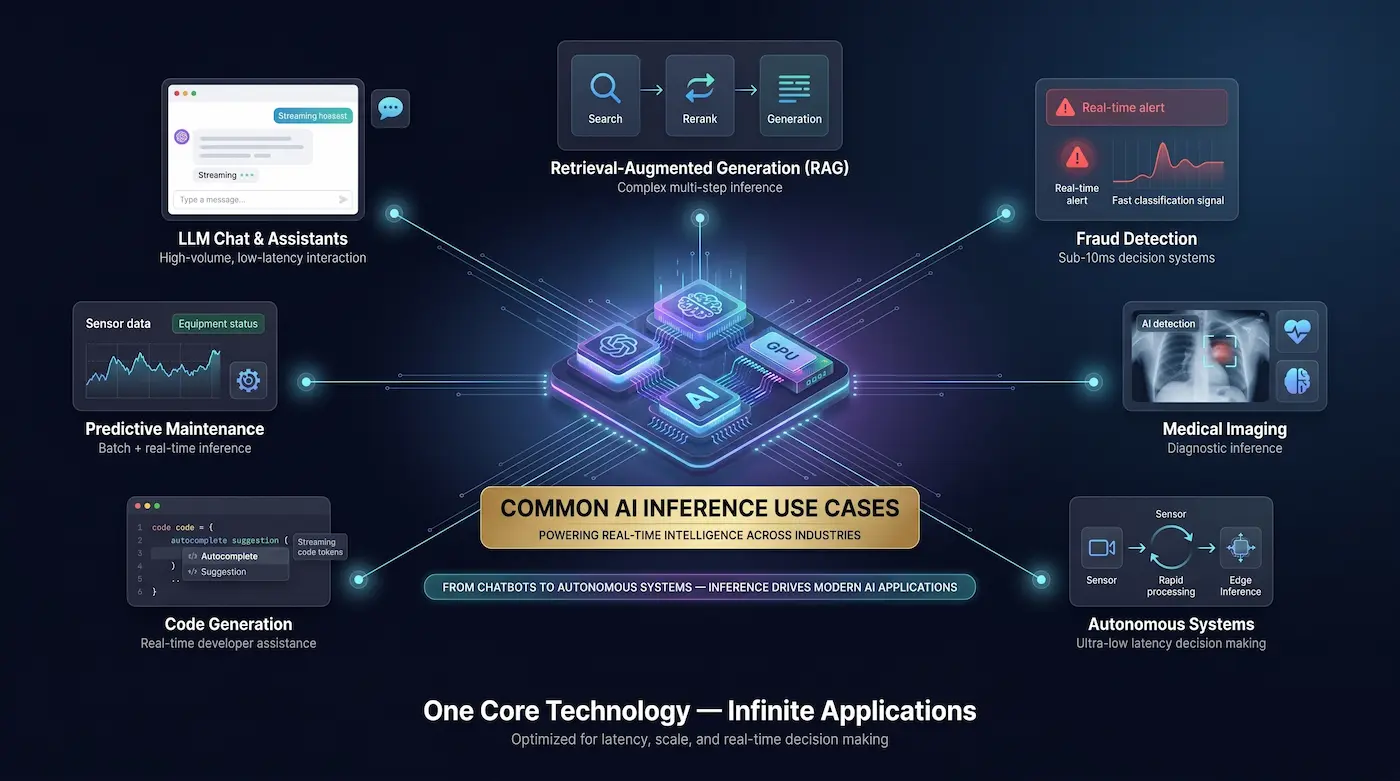
حالات استخدام الاستدلال بالذكاء الاصطناعي الشائعة
يعمل استدلال الذكاء الاصطناعي على تمكين مجموعة واسعة من تطبيقات الإنتاج في كل صناعة:
- LLM دردشة ومساعدين: روبوتات خدمة العملاء ، ومساعدي المعرفة الداخلية ، ومساعدات الترميز - كلها أعباء عمل استدلال كبيرة الحجم وحساسة لوقت الاستجابة.
- التوليد المعزز بالاسترجاع (RAG): يجمع بين نموذج التضمين (للبحث الدلالي) ، و Renerer ، و LLM في خط أنابيب استدلال ثلاثي المراحل. كل مرحلة تضيف الكمون والتكلفة.
- اكتشاف الاحتيال: الاستدلال التصنيفي في الوقت الفعلي عند زمن انتقال أقل من 10 مللي ثانية باستخدام نماذج متخصصة أصغر.
- التصوير الطبي: استدلال CNN و Vision Transformer للأشعة وعلم الأمراض والتشخيص - غالبًا ما يتطلب النشر في مكان العمل للامتثال لـ HIPAA.
- المركبات ذاتية القيادة: استدلال إدراك الكمون بالمللي ثانية على الأجهزة المتخصصة على متن الطائرة (Orin ، D5).
- إنشاء الكود: يتطلب دفق الاستدلال للإكمال التلقائي ITL منخفضًا للغاية (أقل من 15 مللي ثانية) ليشعر بالوقت الفعلي.
- مهام سير العمل الوكيل: تولد عوامل استدعاء الأدوات متعددة الخطوات العديد من مكالمات الاستدلال لكل مهمة مستخدم ، ومضاعفة التكلفة 5-20 × مقابل الاستجابات أحادية الدور.
- الصيانة التنبؤية: استدلال دفعي على تدفقات بيانات المستشعر للتنبؤ بفشل المعدات.
مستقبل استدلال الذكاء الاصطناعي - 2026 وما بعده
تعيد العديد من الاتجاهات تشكيل مشهد الاستدلال حتى عام 2026 وحتى عام 2027:
- نماذج الاستدلال وقياس وقت الاختبار: كما أظهر تفكير DeepSeek-R1 و Gemini 2.5 ، فإن إنشاء المزيد من الرموز في وقت الاستدلال يحسن بشكل موثوق جودة المخرجات في المهام المعقدة. هذا يغير بشكل أساسي منحنى التكلفة - فاتورة الاستدلال لكل استعلام تنمو ، ولا تتقلص.
- هيمنة خليط من الخبراء (MOE): بنى MOE مثل Mixtral 8x22B تنشط جزءًا صغيرًا فقط من المعلمات لكل رمز ، مما يوفر أداء GPT-4-Class بتكلفة 2-3 × أقل تكلفة حساب الاستدلال. توقع أن تهيمن وزارة التربية على إصدارات الطرازات الجديدة.
- الخدمة المفصلة والمضاربة على نطاق واسع: أصبح فصل تجمعات الملء المسبق وفك التشفير ، جنبًا إلى جنب مع فك تشفير المضاربة على غرار النسر ، بنية الإنتاج القياسية لعمليات نشر LLM على نطاق واسع.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- نماذج الحدود على الجهاز: توضح Apple Intelligence و Gemini Nano و Phi-3-Mini أن النماذج الكمية 3B-7B يمكن أن تعمل بالكامل على الأجهزة الاستهلاكية. الحدود بين السحابة واستدلال الحافة غير واضحة.
- الذكاء الاصطناعي السيادي وإقامة البيانات: تدفع الضغوط الجيوسياسية الشركات والحكومات إلى المطالبة بسيادة البيانات الكاملة - الاستدلال داخل حدودها الوطنية ، على الأجهزة التي تمتلكها. سوف ينمو الطلب في السوق ولا يتقلص.
الأسئلة الشائعة (FAQs)
ما هو استدلال الذكاء الاصطناعي بعبارات بسيطة؟
استدلال الذكاء الاصطناعي هو عندما يستخدم نموذج الذكاء الاصطناعي المدرب ما تعلمه للإجابة على سؤال جديد أو إكمال مهمة جديدة. التدريب يعلم النموذج. الاستدلال هو النموذج الذي يقوم بعمله. في كل مرة تحصل فيها على رد من ChatGPT ، تتلقى توصية منتج ، أو ترى تنبيهًا بالاحتيال ، وهذا هو استنتاج الذكاء الاصطناعي الذي يحدث في الوقت الفعلي.
ما هو الفرق بين استدلال الذكاء الاصطناعي والتدريب على الذكاء الاصطناعي؟
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
هل chatgpt الاستدلال أم التدريب؟
عند الدردشة مع ChatGPT ، فأنت تقوم بتشغيل الاستدلال - يتم إصلاح أوزان النموذج ، ويتم تطبيقها على مدخلاتك لإنشاء استجابة. قطارات OpenAI (وتعيد تدريبها بشكل دوري) GPT-4 بشكل منفصل ، على مجموعات بيانات ضخمة ، بتكلفة هائلة. هاتان عمليتان مختلفتان تمامًا. ما تواجهه كمستخدم هو 100% الاستدلال.
ما الأجهزة المستخدمة لاستدلال الذكاء الاصطناعي؟
الأجهزة المهيمنة للاستدلال على نطاق واسع هي NVIDIA GPUs (H100 ، H200 ، B200 ، L40S) ، AMD GPU (MI300X ، MI355X) ، و Google TPUs لأعباء العمل السحابية. للاستدلال على الحافة: Apple Engine و Qualcomm Hexagon NPU و Nvidia Jetson Orin. بالنسبة لعمليات النشر الحساسة للتكلفة أو وحدة المعالجة المركزية فقط ، يمكن لمعالجات Intel Xeon الحديثة (AMX) و AMD EPYC تشغيل نماذج كمية عند الإنتاجية المقبولة.
ما هي أفضل وحدة معالجة رسومات لاستدلال الذكاء الاصطناعي في عام 2026؟
بالنسبة للطرز الكبيرة (70 ب +): تقدم NVIDIA H200 SXM5 (141 جيجابايت HBM3E ، 4.8 تيرابايت / ثانية) أفضل أداء لكل دولار لمعظم أعباء العمل. للحصول على أقصى إنتاجية على الطرازات الحدودية: يؤدي B200 SXM6. بالنسبة للمدى المتوسط الحساس للتكلفة: AMD MI300X (192 جيجابايت HBM3 ، $10K – $15K أقل من H200) تنافسية بشكل متزايد. للاستدلال على الحافة / وحدة معالجة الرسومات المفردة: يوازن NVIDIA L40S (48 جيجابايت GDDR6) التكلفة والقدرة بشكل جيد.
كيف يعمل الاستدلال LLM خطوة بخطوة؟
- الترميز: يتم تحويل نص الإدخال إلى معرفات رمز عدد صحيح. 2. الملء المسبق: تتم معالجة جميع رموز الإدخال في وقت واحد في تمريرة واحدة للأمام ، مما يؤدي إلى إنشاء ذاكرة التخزين المؤقت KV والرمز المميز الأول للإخراج. 3. فك الشفرة: يتم إنشاء الرموز الجديدة واحدًا تلو الآخر ، كل منها يحضر إلى KV-cache الكامل. 4. التجميع المستمر: تشترك الطلبات المتزامنة المتعددة في حساب وحدة معالجة الرسومات عبر التجميع على متن الطائرة. 5. البث: يتم فصل الرموز المميزة عن الإخراج وبثها إلى العميل أثناء إنشائها.
ما هي TTFT و ITL في LLM الاستدلال؟
يقيس TTFT (الوقت إلى الرمز المميز الأول) المدة من تقديم الطلب حتى يتم إرجاع رمز الإخراج الأول - الكمون الذي يراه المستخدم على أنه "وقت الانتظار". تهيمن عليها مرحلة التعبئة المسبقة. يقيس ITL (كمون زمني بين الرموز) متوسط الوقت بين رموز الإخراج المتتالية أثناء فك الشفرة - ما الذي يحدد "سرعة البث" التي يراها المستخدم. يجب تحسين كلاهما للدردشة في الوقت الفعلي: عادةً TTFT <200 مللي ثانية و ITL <30 مللي ثانية للحصول على تجربة سريعة الاستجابة.
ما هو KV-Cache ولماذا هو مهم؟
تخزن KV-cache (ذاكرة التخزين المؤقت لقيمة المفتاح) حسابات الانتباه الوسيط (المفاتيح والقيم) لكل رمز مميز في سياق المحادثة. بدونها ، سيحتاج النموذج إلى إعادة معالجة نافذة السياق بالكامل لكل رمز جديد - O (n ²). باستخدامه ، تعالج كل خطوة فك تشفير رمزًا جديدًا واحدًا فقط ، مما يجعل استدلال LLM ممكنًا. يعد حجم KV-Cache قيدًا أساسيًا على عدد المستخدمين المتزامنين الذين يمكن لوحدة معالجة الرسومات تقديمها والمدة التي يمكن أن تكون عليها نافذة السياق.
ما هي تكلفة استدلال الذكاء الاصطناعي لكل 1 مليون توكن؟
على الأجهزة المستضافة ذاتيًا (8 × H200 ، إطفاء لمدة 3 سنوات ، $0.12 / kWH ، 80% ، استخدام LLAMA-3-70B FP8): تقريبًا $0.18 لكل 1M رموز الإدخال و $0.71 لكل 1 متر رموز إخراج. عبر واجهة برمجة التطبيقات العامة: يكلف GPT-4O $2.50 / $10.00 الإدخال / الإخراج لكل 1M الرموز ؛ تبلغ تكلفة كلود سونيت $3.00 / $15.00. توفر الاستضافة الذاتية على نطاق واسع تخفيضًا في التكلفة من 5 إلى 20 × ، مع تعادل عادةً عند 5-15 مترًا من الرموز / اليوم اعتمادًا على مزود واجهة برمجة التطبيقات والطراز.
هل يمكنك تشغيل استنتاج الذكاء الاصطناعي على وحدة المعالجة المركزية؟
نعم - للنماذج الأصغر والكمية. يتيح Llama.cpp الاستدلال على أي وحدة معالجة مركزية x86. يولد بلاتينيوم Xeon ذو المقبس المزدوج مع AMX ~ 25-40 رمزًا / ثانية على طراز 7B Int4 ، وهو مناسب لأعباء العمل في الوقت الفعلي. استدلال وحدة المعالجة المركزية غير قابل للتطبيق لنماذج 70B + في إنتاجية الإنتاج. تعمل الاقتصادات من أجل التطوير والاختبار والمهام الدُفعية التي تتحمل الكمون حيث تتجاوز تكلفة تأجير وحدة معالجة الرسومات قيمة الإنتاجية.
ما هو الفرق بين الملء المسبق وفك الشفرة في استدلال LLM؟
يعالج التعبئة المسبقة موجه الإدخال بالكامل في عملية واحدة متوازية (موازين مرتبطة بالحساب ، سريعة ، بطول موجه). يقوم فك التشفير بإنشاء رموز إخراج واحدة تلو الأخرى في حلقة انحدارية ذاتية (مرتبطة بالذاكرة-عرض نطاق ترددي ، أبطأ لكل رمز ، مقاييس ذات طول الإخراج والمستخدمين المتزامنين). الانتقال بينهما - عند إنشاء الرمز المميز الأول - هو TTFT. يؤدي تحسين الملء المسبق إلى تقليل TTFT ؛ يؤدي تحسين فك التشفير إلى تقليل ITL وتحسين الإنتاجية.
متى يجب أن تستضيف استضافة الذكاء الاصطناعي مقابل استخدام واجهة برمجة التطبيقات؟
استخدم واجهة برمجة التطبيقات عندما: مستوى الصوت منخفض (أقل من 2 مليون توكن / يوم) ، فأنت بحاجة إلى نموذج مغلق Frontier (GPT-4O ، Claude) ، أو أنك تضع نماذج أولية وتريد صفرًا من النفقات الرأسمالية. الاستضافة الذاتية عندما: يتجاوز الحجم 5 ملايين رمز / يوم ، تتطلب خصوصية البيانات أو الامتثال ذلك ، وتريد ضبط النموذج أو التحكم فيه ، أو تحتاج إلى SLA مضمونًا بدون حدود معدل. نقطة التعادل مقابل معظم واجهات برمجة التطبيقات هي 3-18 شهرًا اعتمادًا على الطراز والحجم ، وبعد ذلك تقارن بشكل إيجابي لسنوات.
بناء أو شراء - الخطوات التالية مع Atal Networks
إذا كنت قد وصلت إلى هذه النقطة ، فلديك صورة كاملة لما هو استدلال الذكاء الاصطناعي ، وكيف يعمل ، وما يكلفه ، وما هي الأجهزة التي تشغله. السؤال التالي هو التنفيذ.
Atal Networks متخصص في البنية التحتية للذكاء الاصطناعي المبنية لهذا الغرض للمؤسسات التي تجاوزت تبعية واجهة برمجة التطبيقات. قام فريقنا بتصميم ونشر مجموعات GPU عبر قطاعات الرعاية الصحية والخدمات المالية والتصنيع والبرمجيات - وننشر البيانات المعيارية ، وليس فقط الكتيب.
استكشاف لدينا تكوينات الخادم المخصصة بالنسبة لعمليات نشر الاستدلال عالية الإنتاجية مع أنظمة H100 و H200 و MI300X.
هل تبحث عن نقطة دخول منخفضة النفقات الرأسمالية؟ لنا خطط VPS المحسنة لوحدة معالجة الرسومات تتيح لك بدء تشغيل أعباء عمل الاستدلال الخاص اليوم دون امتلاك الرف.
هل أنت جاهز للحديث عن الأرقام؟ زيارة atalnetworks.com والتحدث مباشرة مع مهندس أجهزة - وليس برنامج نصي للمبيعات.
