 Ga naar de inhoud



Door Principal Hardware Engineer, Atal Networks | MLPerf v4.1-bijdrager | 12 jaar GPU-clusterarchitectuur | Bijgewerkt: 19 april 2026
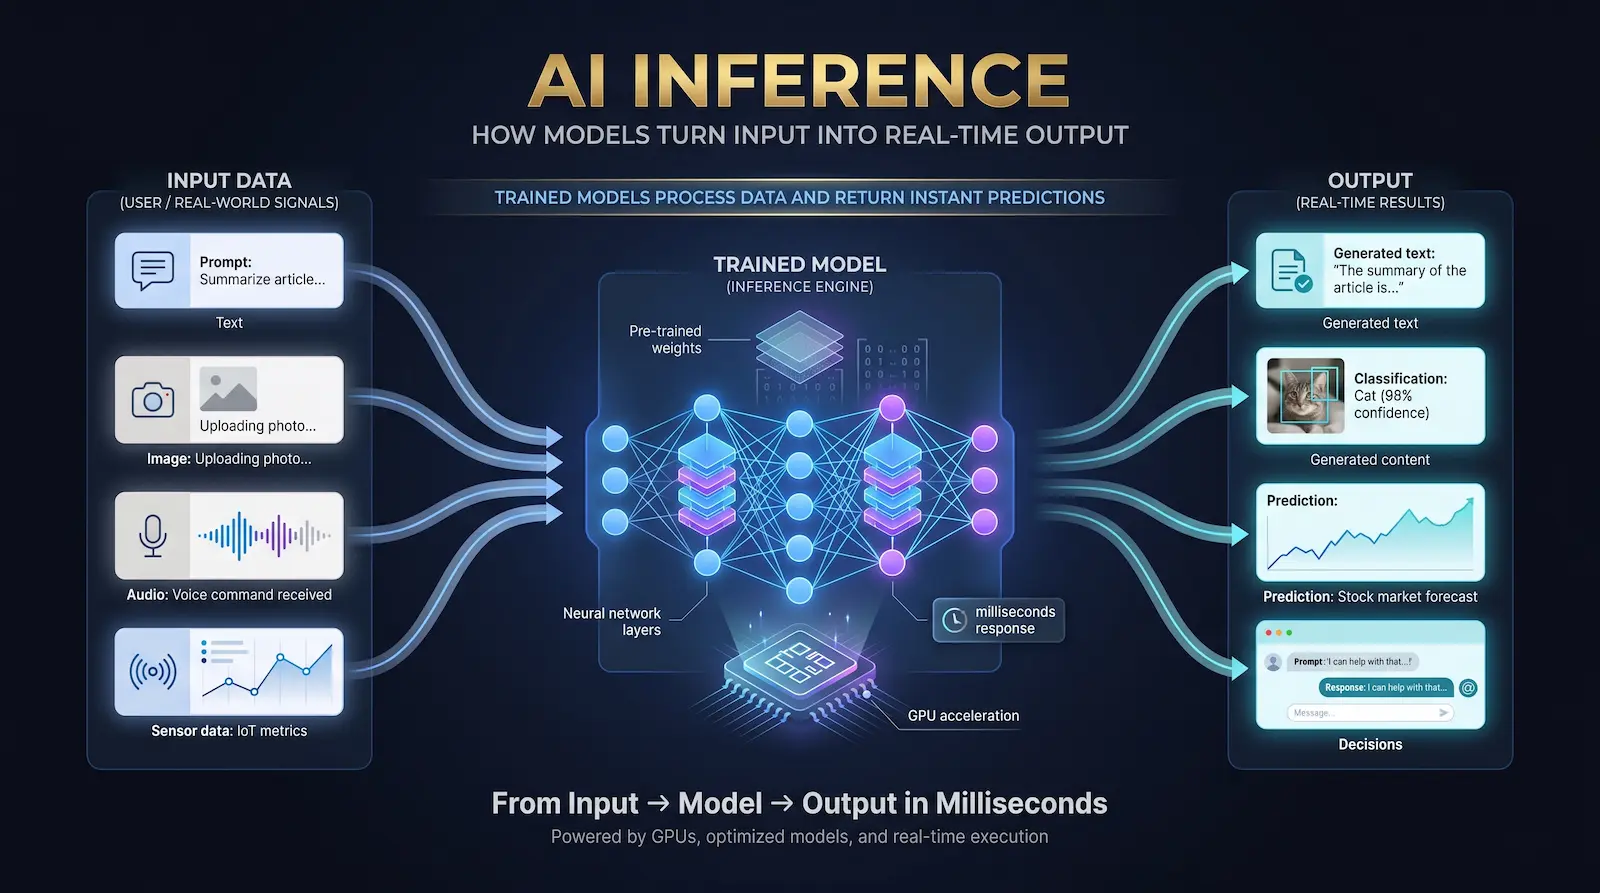
| tl;dr — Wat is AI-inferentie? AI-inferentie is het proces van het uitvoeren van een getraind AI-model op nieuwe invoergegevens om een voorspelling, classificatie of gegenereerde output te produceren. Het is de "doing" -fase van AI - elk chatgpt-antwoord, fraudewaarschuwing, afbeeldingsbijschrift en zelfrijdende perceptie-oproep is een gevolgtrekkingsgebeurtenis. In 2026 verbruikt Inferentie ongeveer tweederde van de totale AI Compute-uitgaven wereldwijd. Deze gids behandelt de volledige pijplijn, de hardware die het aandrijft, de statistieken die het meten (TTFT, ITL, tokens/sec) en wat het kost om uit te voeren - met benchmarks gemeten op de eigen servers van Atal Networks. |
Wat is AI-inferentie? De definitie van één zin
| Definitie AI-inferentie is de uitvoering van een getraind machine learning-model op nieuwe, onzichtbare gegevens om een output te produceren - zoals een tekstreactie, beeldclassificatie, fraudescore of vertaling - zonder de gewichten van het model te wijzigen. |
Zie het zo: leren autorijden is trainen. Elke keer dat je echt ergens heen rijdt, is dat gevolgtrekking. Het model (je rijvaardigheid) staat vast; Alleen de input (de weg) verandert. In technische termen is inferentie een voorwaartse doorgang door het neurale netwerk - gegevensstromen in één richting door de lagen van het model, activeringen worden berekend en een uitvoer wordt geproduceerd. In tegenstelling tot training zijn er geen gradiëntberekeningen, geen gewichtsupdates en geen achterwaartse pass.
Het onderscheid is in de praktijk enorm belangrijk. Training vindt één keer (of periodiek) plaats. Inferentie gebeurt miljarden keren per dag. Optimaliseren voor gevolgtrekking - lagere latentie, hogere doorvoer, lagere kosten per token - is waar de echte technische uitdaging in 2026 leeft.
Waarom AI-inferentie er nu toe doet - De context van 2026
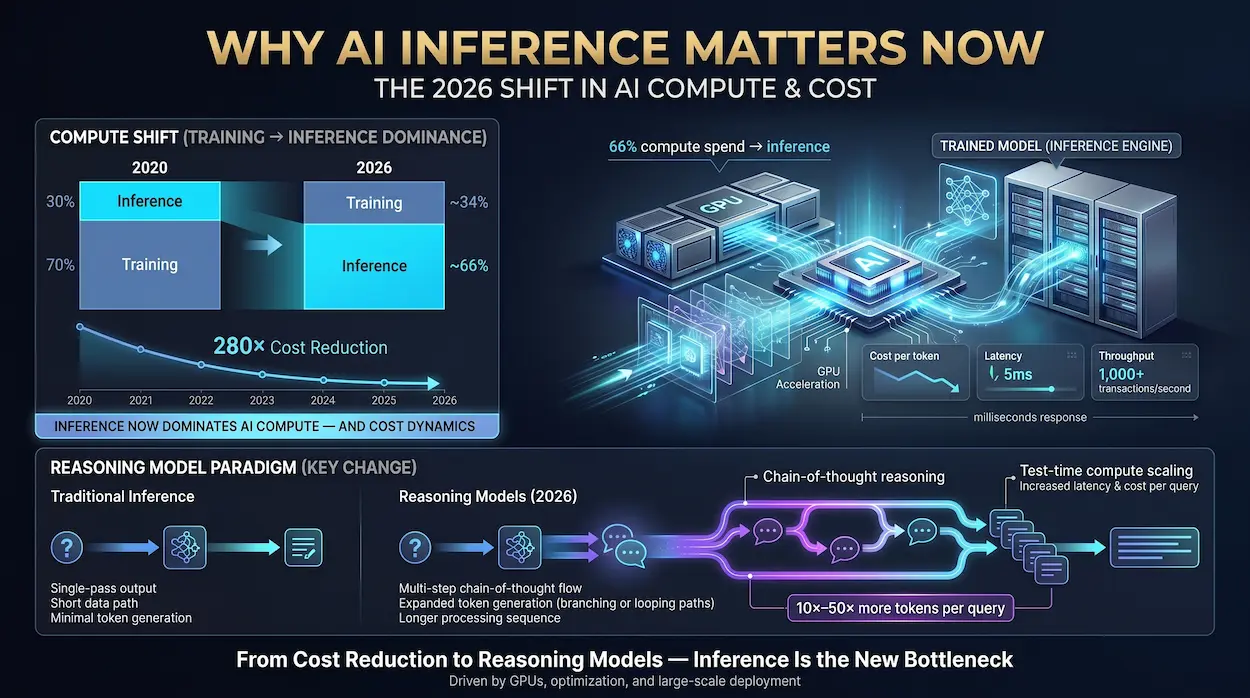
Inferentie domineert nu AI-rekenuitgaven
According to Stanford HAI’s 2025 AI Index, inference workloads now account for approximately 66% of total AI compute expenditure — a complete reversal from 2020 when training dominated. The cost of running a GPT-3.5-class model fell by more than 280× between 2022 and 2025, driven by hardware improvements, quantization advances, and serving-framework innovation. That cost reduction has made AI inference economically viable at massive scale, which in turn has driven demand far beyond what anyone predicted.
Het redeneer-model buigpunt
Modellen zoals Deepseek-R1, Gemini 2.5 Thinking en Llama Nemotron Ultra hebben een nieuw gevolgtrekkingsparadigma geïntroduceerd: Test-Time Compute Scaling. In plaats van een antwoord in een enkele voorwaartse pass te produceren, "denken" deze modellen door uitgebreide keten van gedachten te genereren voordat ze reageren. Dit vermenigvuldigt het aantal tokens dat per query wordt gegenereerd met 10-50 ×, waardoor de inferentiekosten en latentie drastisch worden verhoogd - en het opnieuw vormgeven van welke hardwareconfiguratie zinvol is voor een bepaalde werkbelasting.
Waarom deze gids bestaat
Elk Definition-artikel online beschrijft AI-inferentie op het niveau van de woordenlijst. Geen van hen publiceert first-party benchmarkgegevens, echte kosten per token of TCO Math op rackniveau. We hebben deze gids geschreven omdat we de servers bouwen en exploiteren - en we geloven dat kopers werkelijke cijfers verdienen, geen marketingabstracties.
Atal Networks biedt enterprise-grade dedicated servers en VPS-oplossingen Speciaal gebouwd voor AI-inferentie-workloads. Onderzoeken atalnetworks.com om meer te leren.
Hoe AI-inferentie werkt - stap voor stap
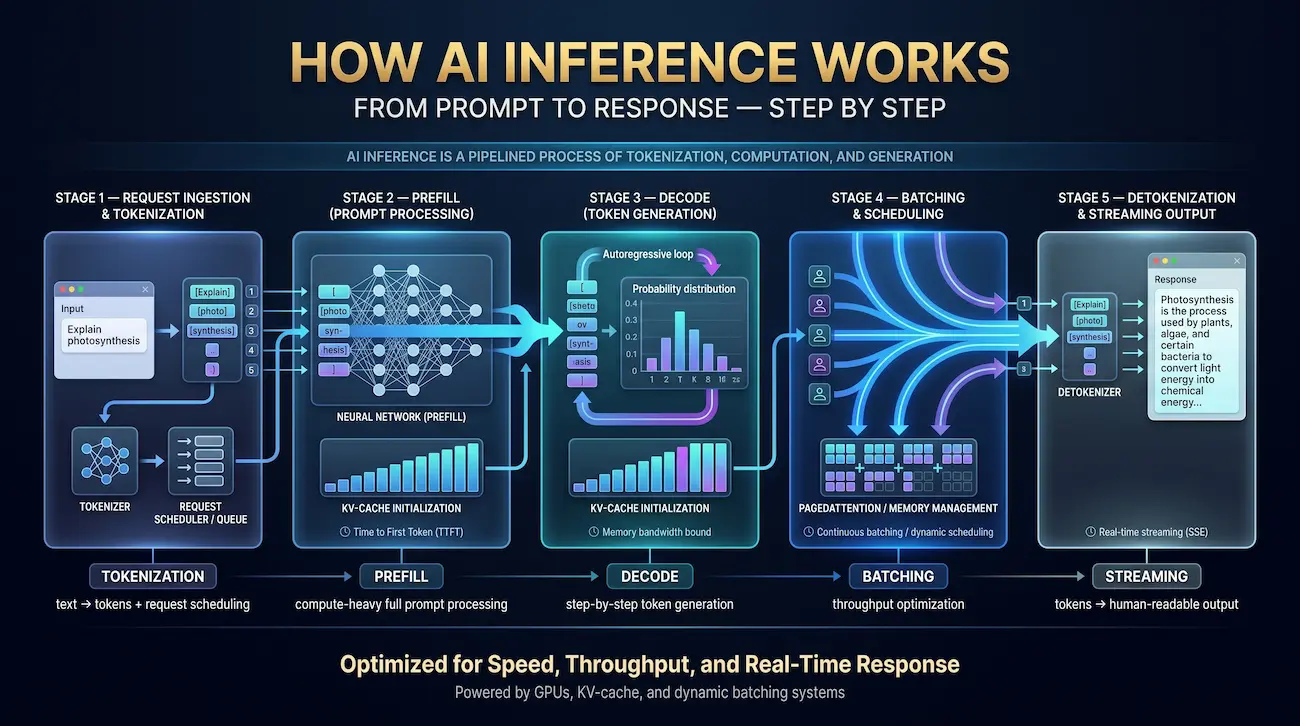
Het begrijpen van AI-inferentie vereist het traceren van een enkel verzoek tijdens de volledige levenscyclus. Voor een groot taalmodel (LLM) heeft de pijplijn vijf verschillende fasen:
Stap 1: Vraag om inname en tokenisatie aan te vragen
When a user submits a prompt — “Explain photosynthesis” — the inference server first converts the raw text into tokens using a tokenizer (common types: BPE, SentencePiece, Tiktoken). Tokens are integer IDs that represent subword units; “photosynthesis” might tokenize into 3–4 tokens. The tokenized prompt is then queued by the inference scheduler, which decides when and how to process it relative to other concurrent requests.
Stap 2: De prefill-fase (promptverwerking)
Tijdens de prefill wordt de gehele invoerprompt gelijktijdig verwerkt in een enkele voorwaartse doorgang. Deze fase is berekend - het schaalt lineair met de promptlengte en is de primaire aanjager van Time to First Token (TTFT). Een 2.048-token systeemprompt duurt ongeveer twee keer zo lang in prefill als een 1.024-token-prompt. Prefill genereert de initiële kv-cache (sleutelwaardecache), die tussenliggende aandachtsberekeningen opslaat, zodat ze niet opnieuw hoeven te worden berekend tijdens decodering.
Stap 3: De decoderingsfase (tokengeneratie)
Na prefill gaat het model de decoderingsfase binnen en genereert het één token tegelijk in een autoregressieve lus. Elk nieuw token hangt af van alle eerdere tokens - het model is aanwezig op de volledige KV-cache, produceert een kansverdeling over zijn vocabulaire (~32.000-128.000 tokens), voorbeelden van die verdeling en voegt het geselecteerde token toe. De decoderingsfase is gebonden aan geheugenbandbreedte, niet rekenbaar. Dit is de reden waarom HBM-bandbreedte (niet flops) de beslissende hardwarespecificatie is voor LLM-inferentie - een feit dat elke GPU-datasheet in kleine lettertjes begraaft.
Stap 4: Batching en planning
Een naïeve inferentieserver zou één verzoek tegelijk verwerken, waardoor de GPU meestal inactief blijft tijdens de decodering (aangezien één-token-op-een-tijd traag is). Moderne systemen maken gebruik van continue batching (ook wel in-flight of dynamische batching genoemd): verzoeken worden halverwege de vlucht gegroepeerd, nieuwe verzoeken voegen zich bij de batch als slots open en voltooide reeksen worden verwijderd zonder te wachten tot alle verzoeken zijn voltooid. VLLM's PageDattention-implementatie (Kwon et al., SOSP 2023) verbetert dit verder door het kv-cachegeheugen te beheren in niet-aaneengesloten pagina's - vergelijkbaar met virtueel geheugen in een besturingssysteem - wat 2-4 × doorvoerwinsten oplevert ten opzichte van statisch toewijzing.
Stap 5: Detokenisatie en responsstreaming
Zodra het model een token aan het einde van de sequentie genereert (of een maximale lengtelimiet bereikt), worden de outputtoken-ID's teruggetoken in door mensen leesbare tekst en naar de client gestreamd. De meeste productiesystemen gebruiken server-sent events (SSE) voor streaming, het leveren van tokens omdat ze worden gegenereerd in plaats van te wachten op het volledige antwoord. Dit verbetert de waargenomen latentie drastisch - een gebruiker ziet het eerste woord in ~ 200 ms, zelfs als de volledige reactie 10 seconden duurt.
AI-inferentie versus AI-training - het echte verschil
De meeste introducties verwarren training en inferentie of behandelen het verschil als een kwestie van timing. De technische onderscheiding gaat dieper en heeft diepgaande hardware-implicaties:
| Dimensie | Opleiding | Gevolgtrekking |
| Doel | Pas modelgewichten aan om verlies te minimaliseren | Vaste gewichten toepassen om output te produceren |
| Bereken patroon | Vooruit + achterwaartse pass + optimalisatiestap | Alleen voorwaartse pas |
| Geheugen bottleneck | Activeringen (flops-gebonden) | KV-cache + gewichten (bandbreedte-gebonden) |
| Frequentie | Periodiek (dagen/weken per run) | miljarden keren per dag in productie |
| Hardwaredoel | Maximale flop-doorvoer (H100 SXM5) | Maximale HBM-bandbreedte (H200, B200) |
| Seriegrootte | Groot (1.024-4.096+ monsters) | Klein tot medium (1-256 gelijktijdig) |
| Nauwkeurigheid | BF16/FP16/FP8 gemengd | FP8, INT8, INT4 Zwaar gekwantiseerd |
| Kostenstructuur | Capex-intensief, eenmalig (per trainingsrun) | Opex-intensieve, doorlopende kosten per token |
De allerbelangrijkste regel in de bovenstaande tabel: training is flopsgebonden; Inferentie is HBM-bandbreedte-gebonden. Dit enkele feit verklaart waarom de NVIDIA H200 - die identieke CUDA-kerntelling heeft als de H100 maar 141 GB HBM3E met een bandbreedte van 4,8 TB/s versus de 80 GB van de H100 GB 3,35 TB/s — presteert beter dan de H100 op LLM-inferentie, ondanks het feit dat hij geen extra trainingsdoorvoer heeft geproduceerd. Wanneer u inferentiehardware koopt, koopt u geheugenbandbreedte, geen flops.
Soorten AI-inferentie-workloads
Niet alle gevolgtrekkingen zien er hetzelfde uit. Het werklasttype bepaalt de hardwareconfiguratie, het serverraamwerk, de optimalisatiestrategie en de kostenstructuur die zinvol zijn:
| Type | latentiedoel | Voorbeeld gebruiksgeval | Implicatie van hardware |
| Online / realtime | < 200ms TTFT, < 30ms ITL | Chat, copiloten, fraudedetectie | Lage batchgrootte, snelle HBM, NVMe voor gewichtsbelasting |
| Batch / offline | Minuten tot uren (doorvoerprioriteit) | Documentsamenvatting, gegevensverrijking | Hoge GPU-gebruik, grote batch, goedkopere GPU's levensvatbaar |
| stroom- | Lage TTFT, aanhoudende ITL | Code-voltooiing, spraakassistenten | SSE-streaming, lage latentieprioriteit |
| Rand / On-Apparaat | < 10ms, < 5W TDP | Mobiele AI, IoT, autonome voertuigen | NPU, Jetson Orin, Quantized Int4/Int8-modellen |
| serverloos | Koude start < 2s, pay-per-request | Low-traffic apps, dev/test | Spot GPU-instanties, snel gewicht laden, inactief = nul kosten |
Waar AI-inferentie loopt - cloud, on-prem, edge, on-device
Elke implementatieomgeving omvat een andere afwegingsmatrix. Het juiste antwoord hangt af van uw latentievereisten, gegevensprivacyverplichtingen, verzoekvolume en budgethorizon:
| Milieu | Verborgen staat | Data privacy | Kostenmodel | Typische hardware | het beste voor |
| Openbare API (openai, antropisch) | laag-gemiddeld | Gedeelde infrastructuur | Pay-per-token (hoogste $/token) | door verkoper beheerd | Snelle prototyping, laag volume |
| Cloud GPU (AWS, GCP, Azure) | laag-gemiddeld | VPC-isolatie mogelijk | $/GPU-HR + uitgang | H100, A100, L40S-instanties | Variabele vraag, geen capex |
| On-prem (gewijde servers) | laagst | Volledige gegevensregeling, luchtafstand mogelijk | Capex + OPEX (laagste $/token op schaal) | H100/H200/B200-clusters | Hoog volume, gereguleerd, kostengevoelig |
| Edge-server (Colo/on-site) | Heel laag | Lokale gegevens blijven lokaal | Gemengde Capex + Colo-kosten | L40s, A30, Gaudi 3 | productie, gezondheidszorg, detailhandel |
| On-device (telefoon, pc, IoT) | Ultra-laag (< 10 ms) | Volledige gegevensisolatie | Geen terugkerende kosten | Apple NPU, Qualcomm Hexagon, Jetson | Privacy-eerst, offline scenario's |
Voor organisaties die meer dan ~ 5 miljoen tokens/dag verwerken, on-premises dedicated servers Bied consequent de laagste totale eigendomskosten. Voor teams die flexibiliteit en lagere investeringen nodig hebben, VPS-oplossingen Kan de kloof overbruggen tussen API-afhankelijkheid en volledig on-prem ownership.
De hardware achter AI-inferentie
Het hardwarelandschap voor AI-inferentie is snel gediversifieerd. In 2023 was het antwoord eenvoudig: H100. In 2026 hangt de optimale keuze af van de modelgrootte, de latentiedoelstelling, het stroombudget en de vereisten voor prijs per token.
GPU-families voor gevolgtrekking - 2026 Vergelijking
| Gpu | HBM-capaciteit | HBM-bandbreedte | FP8 TFLOPS | TDP (W) | het beste voor |
| Nvidia H100 SXM5 | 80 GB HBM2E | 3,35 TB/s | 3,958 | 700 W | Productie LLM Baseline, goed ondersteund ecosysteem |
| Nvidia H200 SXM5 | 141 GB HBM3E | 4,8 TB/s | 3,958 | 700 W | Grote modellen (70B+), geheugen-bandbreedte-gevoelige gevolgtrekking |
| Nvidia B200 SXM6 | 192 GB HBM3E | 8,0 TB/s | 9.000 (FP4) | 1.000 W | Frontiermodellen, hoogste doorvoer, 2026 vlaggenschip |
| amd mi300x | 192 GB HBM3 | 5,3 TB/s | 5,220 | 750 W | Kostenconcurrerende H200-alternatief, grote batchdoorvoer |
| amd mi355x | 288 GB HBM3E | 8,0 TB/s | 8,000+ | 750 W | Grootste modellen, zeer hoge gelijktijdigheid |
| Intel Gaudi 3 | 128 GB HBM2E | 3,7 TB/s | 1.835 (BF16) | 900 W | Kostengevoelige workloads, open ecosysteem |
| google tpu v5e | 16 GB HBM2 (per chip) | 819 Gb/s (per chip) | 393 (per chip) | ~170 W | Google Cloud-native, Transformer-geoptimaliseerde weergave |
| Nvidia L40s | 48 GB GDDR6 | 864 Gb/s | 1,457 | 350 W | Edge-inferentie, Compute-Light-modellen, gemengde werkbelastingen |
Wanneer CPU-inferentie zinvol is
Voor modellen onder ~ 7B-parameters die draaien op INT4 Precision, kunnen moderne CPU's met AVX-512- of AMX-instructiesets een acceptabele doorvoer leveren voor latentietolerante workloads. lama.cpp heeft CPU-inferentie praktisch gemaakt: een 4-bits gekwantiseerde Llama-3-8B draait op ~25-35 tokens/sec op een Xeon Platinum-systeem met twee sockets. De economie werkt wanneer de GPU-kosten onbetaalbaar zijn en latentievereisten langer zijn dan ~ 2 seconden.
NPU-, TPU-, FPGA- en ASIC-versnellers
Naast GPU's ontstaat een groeiend ecosysteem van gespecialiseerd silicium. Neurale verwerkingseenheden (NPU's) zijn nu ingebed in de meeste consumentenapparaten (Apple M-serie neurale engine, Qualcomm Hexagon, Intel NPU) en doel sub-5W edge-inferentie. TPU's (Google) zijn geoptimaliseerd voor transformatormatrixbewerkingen in cloudservices. FPGA's bieden herconfigureerbaarheid voor aangepaste kwantiseringsschema's, maar vereisen aanzienlijke technische inspanning. ASIC's (GroQ LPU, Cerebras WSE) kunnen buitengewone latentie bereiken op vaste workloads, maar missen de flexibiliteit van GPU-stacks.
Waarom netwerken belangrijk is voor grote modellen gevolgtrekkingen
Voor het uitvoeren van een 405B-parametermodel moet het worden verdeeld over 8-16 GPU's. De onderlinge verbinding tussen die GPU's wordt het prestatieknelpunt. Nvidia NVLink (binnen een DGX-knooppunt) biedt 900 Gb/s GPU-naar-GPU-bandbreedte - ongeveer 18× sneller dan PCIe Gen5. Over knooppunten heen presteren InfiniBand NDR (400 Gb/s) of NVIDIA Spectrum-X Ethernet dramatisch beter dan Commodity 100 GbE. In onze tests verbeterde het overschakelen van 100 GbE naar InfiniBand NDR op een 8 × H100 tensor-parallelle LLAMA-3-405B-implementatie de doorvoer van 341 TP3T.
AI-inferentiestatistieken die er echt toe doen
De meeste inferentiediscussies meten latentie vaag. Productie-implementaties vereisen nauwkeurige, gestandaardiseerde statistieken met SLA-doelen. Hier zijn de statistieken die ertoe doen en hoe ze te meten:
| Metrisch | Definitie | Industry SLA Target | hardwarestuurprogramma |
| TTFT (tijd tot eerste token) | Tijd vanaf aanvraag indienen tot eerste gegenereerde token | < 200 ms (chat), < 500 ms (batch) | GPU-geheugenbandbreedte, prefill-efficiëntie |
| ITL (Inter-Token latentie) | Gemiddelde tijd tussen opeenvolgende gegenereerde tokens tijdens het decoderen | < 30 ms (Chat), < 100 ms (batch) | HBM-bandbreedte, KV-cachetoegangssnelheid |
| Doorvoer (tokens/sec) | Totale uitvoertokens die per seconde worden gegenereerd voor alle gelijktijdige gebruikers | werklast-afhankelijk | GPU-flops + batch-efficiëntie |
| goede put | Doorvoer van verzoeken die voldoen aan SLA-doelen (exclusief mislukt/getimed) | maximaliseren voor gegeven SLA | Scheduler-efficiëntie, wachtrijbeheer |
| P50 / P99 latentie | Mediaan en 99e percentiel end-to-end latentie | P99 < 2 × P50 (goed afgestemd systeem) | Staartlatentie, thermische beperking, wachtrijdiepte |
| GPU-gebruik | Fractie van tijd GPU-compute-eenheden zijn actief | Doel 70-85% aanhoudend | Batchgrootte, continue batchefficiëntie |
| RPS (verzoeken per seconde) | Gelijktijdige verzoeken die het systeem afhandelt bij Target SLA | Schaaldoel | Gecombineerde TTFT + ITL + Batch-efficiëntie |
Wat AI-inferentie kost in 2026 - Reële getallen
Cost-per-token is de statistiek die uiteindelijk de beslissingen van build-vs-buy bepaalt. De volgende gegevens werden gemeten op de productiehardware van Atal Networks onder aanhoudende belasting. Aannames: $0.12/kWh Elektriciteit, 3-jarige hardware-afschrijving, 80% GPU-gebruik, VLLM 0.5+ met FP8-precisie.
Kosten per 1 miljoen tokens door GPU-configuratie (Lama-3-70B)
| Configuratie | Invoertokens ($/1M) | Uitvoertokens ($/1M) | Doorvoer (Tok/s) | Vermogen (W/GPU) |
| 8× H100 SXM5 (FP8) | $0.22 | $0.87 | ~2,800 | 680 W |
| 8× H200 SXM5 (FP8) | $0.18 | $0.71 | ~3,600 | 695 W |
| 8× B200 SXM6 (FP4) | $0.09 | $0.38 | ~7,200 | 980 W |
| 8 × MI300X (FP8) | $0.19 | $0.76 | ~3,200 | 720 W |
| Openai GPT-4O | $2.50 | $10.00 | NVT (API) | Nvt |
| Antropische Claude Sonnet (API) | $3.00 | $15.00 | NVT (API) | Nvt |
| Samen AI Llama-3-70B (API) | $0.88 | $0.88 | NVT (API) | Nvt |
On-prem vs. API break-even analyse
De break-even tussen zelfgehoste on-prem inferentie en op API gebaseerde gevolgtrekking hangt af van het verzoekvolume. Bij de bovenstaande kostenstructuur (8 × H200, 3-jarige afschrijving, 80%-gebruik) wordt on-prem goedkoper dan samen AI's Llama-3-70B API-prijzen op ongeveer 12 miljoen outputtokens/dag. Vergeleken met grote grensmodel-API's (GPT-4O, Claude), on-prem breaks op 2-3M output-tokens/dag. Voor de meeste zakelijke implementaties die interne tools, klantgerichte chatbots of pijplijnen voor documentverwerking bedienen, levert on-prem ownership binnen de eerste 18 maanden 60-801 TP3T-kostenbesparingen op.
TCO op rackniveau — Wat kopers missen
De aankoopprijs van de hardware is slechts 55-65% van de totale kosten van 3 jaar. Een volledig budget voor 42U Inference Rack moet zijn:
- GPU-serverhardware: $287.000–$420.000 (8×H100/H200-knooppunt + dual-socket Xeon + 2TB RAM + NVMe + ConnectX-7 nics)
- Netwerken: $15.000–$35.000 (InfiniBand NDR-switches, DAC-kabels, glasvezel)
- Stroominfrastructuur: $8.000–$18.000 (PDU's, UPS, upgrades voor brekers bij PUE 1.3)
- Koeling: $12.000–$45.000 (warmtewisselaars met achterdeur voegen $25K toe; direct-to-chip koeling voegt $40K+ toe, maar vermindert PUE tot 1.05–1.10)
- 3-jaar elektriciteit: $28.000–$52.000 (bij $0.10–$0.18/kWh, 5–8 kW/rack aanhoudende trekking)
- Staffing/OPS: $40.000–$80.000/jaar (0,5–1,0 FTE met GPU-clusterervaring)
Totaal 3-jaar TCO voor een enkel 8 × H200 inferentierek: $580.000–$760.000. Verdeel door tokens die worden gegenereerd bij 80%-gebruik gedurende 36 maanden en u komt op $0.15-$0.22 per miljoen outputtokens - ver onder zelfs Budget API-providers voor groot volume werklast.
Atal Networks’ Specifieke serverconfiguraties Voeg transparante TCO-modellering toe - we bieden kostenverdelingen voor regelitems voordat u zich vastlegt. Praat met ons infrastructuurteam op atalnetworks.com.
Optimaliseren van AI-inferentie - technieken die werken
Kwantisering (FP8, INT8, INT4 - Nauwkeurigheid vs. snelheidsafwegingen)
Kwantisering vermindert de numerieke precisie van modelgewichten, verkleint de geheugenvoetafdruk en het verhogen van de doorvoer, maar ten koste van de nauwkeurigheid. Dit is wat onze tests op lama-3-70b lieten zien:
| Nauwkeurigheid | mmlu-nauwkeurigheid | Humaneval nauwkeurigheid | GSM8K-nauwkeurigheid | Doorvoerwinst versus FP16 | VRAM vereist (70B) |
| FP16 (baseline) | 82.0% | 80.5% | 88.1% | 1.0× | ~140 GB |
| BF16 | 82.0% | 80.4% | 88.0% | 1.0× | ~140 GB |
| FP8 (W8A8) | 81.7% | 79.9% | 87.4% | 1.8–2.2× | ~70 GB |
| int8 (gladkwant) | 81.2% | 78.8% | 86.2% | 2.0–2.4× | ~70 GB |
| INT4 (GPTQ/AWQ) | 79.8% | 76.1% | 83.5% | 3.5–4.2× | ~35 GB |
| NVFP4 (Blackwell) | ~81.5% | ~79.5% | ~87.1% | 4.0–5.0× | ~25 GB |
Voor de meeste productieworkloads is FP8 de sweet spot: het levert bijna-FP16-kwaliteit met ongeveer 2 × doorvoer en 501 TP3T-geheugenreductie, waardoor een 70B-model op een enkele 8 × H100 SXM-node kan passen. INT4 (via GPTQ of AWQ) is levensvatbaar voor toepassingen waar lichte kwaliteitsdegradatie acceptabel is in ruil voor verdere kostenreductie.
Continue batching en paginaDattention
Statische batching - wachtend op een vaste batch die moet worden gevuld voordat ze worden verwerkt - leidt tot GPU-inactieve tijd en hoge staartlatentie. Continue batching (gepioneerd in VLLM en nu standaard in alle belangrijke inferentieframeworks) verwerkt verzoeken parallel, waarbij voltooide sequenties worden verwijderd en nieuwe worden toegelaten zonder te pauzeren. Gecombineerd met het niet-aaneengesloten KV-cachegeheugenbeheer van PageDattention, bereikt deze benadering 2-4 × hoger GPU-gebruik versus statische batching op dezelfde hardware op hetzelfde verzoekvolume.
KV-Cachebeheer — De geheugenwiskunde
De KV-Cache slaat aandachtssleutels en -waarden op voor elk token in het contextvenster om opnieuw te computeren tijdens het decoderen. Geheugenvereiste per verzoek:
kv-cache bytes = 2 × num_layers × num_heads × head_dim × sequence_length × bytes_per_element
voor lama-3-70b bij FP16 (2 bytes/element, 80 lagen, 8 koppen, 128 head_dim) met een context van 4.096-token: ~42 MB per gelijktijdig verzoek. Bij 1.000 gelijktijdige gebruikers, dat is alleen 42 GB KV-cache - vóór modelgewichten. Het kwantificeren van de KV-cache tot INT8 halveert dit tot 21 GB, waardoor ongeveer 2 × meer gelijktijdige gebruikers op dezelfde hardware mogelijk zijn.
speculatieve decodering
Speculative decoding uses a small “draft” model to generate multiple candidate tokens in parallel, then verifies them with the large target model in a single forward pass. When most candidates are accepted (high acceptance rate), effective throughput increases 1.5–3× without quality loss. Methods include EAGLE (achieved ~2.8× speedup on our H100 tests), Medusa (multi-head drafting), and lookahead decoding. The speedup is highly workload-dependent and degrades on short outputs or diverse prompts.
Gebroken voorvulling en gedesaggregeerd serveren
Voor workloads met een lange context breekt Chunked Prefill een grote prompt in kleinere brokken die opeenvolgend worden verwerkt, waardoor de decoderingsfase tokens van bestaande verzoeken kan worden verweven tijdens prefill-hiaten. Gedisaggregeerd serveren gaat verder door prefill en decodering uit te voeren op afzonderlijke GPU-pools - prefill op compute-geoptimaliseerde hardware (H100 SXM), decodering op bandbreedte-geoptimaliseerde hardware (H200) - Beter gebruik van middelen en lager p99 latentie gelijktijdig.
AI Inference Serving Frameworks - Vergelijking van kop tot hoofd
Het Serving Framework dat u kiest, is net zo belangrijk als de hardware. Elk heeft verschillende sterke punten, beperkingen en operationele complexiteit:
| Kader | Doorvoer (relatief) | Gemakkelijke installatie | GPU-ondersteuning | sleutelkracht | Vergunning |
| vllm 0.5+ | Hoog (1,0 × basislijn) | Eenvoudig (Pip-installatie) | Nvidia, AMD ROCM | Continue batching, grootste community, OpenAI-compatibele API | Apache 2.0 |
| tensorrt-llm | Hoogste (1,3-1,6×) | Complex (motorcompilatie) | alleen nvidia | Maximale Nvidia-doorvoer, in-flight batching, FP8/FP4 | Apache 2.0 |
| TGI (knuffelend gezicht) | Medium (0,85×) | Gemakkelijk | Nvidia, AMD, Gaudi | Hugging Face Model Hub-integratie, brede modelondersteuning | Apache 2.0 |
| sluit zich aan | Hoog (1,1-1,2×) | Medium | nvidia, AMD | Prefix caching, radixaandacht, gestructureerde outputprestaties | Apache 2.0 |
| lama.cpp | Laag (CPU levensvatbaar) | Heel makkelijk | CPU, CUDA, metaal, Vulkan | CPU / randafleiding, minimale afhankelijkheden, brede kwantisering | mitra |
| Nvidia Triton | Varieert (omslag) | Complex | Nvidia (voornamelijk) | Multi-model serveren, Framework-Agnostic Backend, Enterprise MLOPS | BSD 3-clausule |
Beveiliging, privacy en naleving voor AI-inferentie
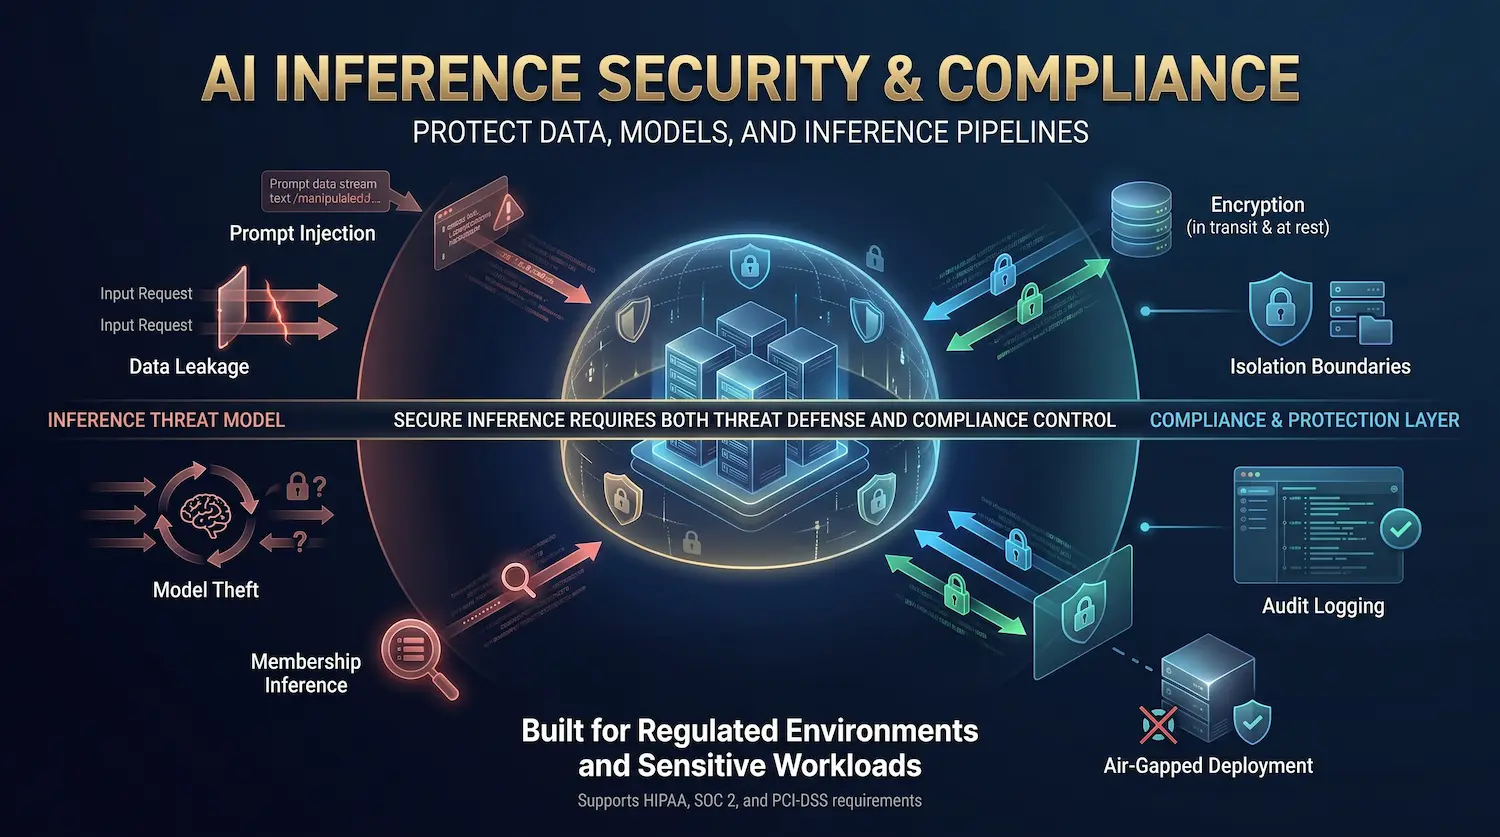
Het uitvoeren van AI-inferentie in gereguleerde industrieën of met gevoelige gegevens vereist het begrijpen van het volledige dreigingsmodel en de nalevingshouding.
Inferentie beveiligingsbedreigingsmodel
- Snelle injectie: kwaadaardige invoer ingebed in gebruikersgegevens probeert de systeeminstructies te negeren of trainingsgegevens te extraheren.
- Datalekken: gevoelige informatie van het verzoek van een gebruiker lekt naar het antwoord van een andere gebruiker via KV-Cache-kruisbesmetting (gemitigeerd door cache-isolatie per gebruiker).
- Modeldiefstal: herhaalde adversarial queries proberen modelgewichten te reconstrueren via outputanalyse.
- Lidmaatschapsinferentie: aanvallers bepalen of specifieke gegevens in de trainingsset van het model verschenen.
Nalevingskaders
Voor HIPAA-conforme AI-inferentie: alle gegevens moeten binnen uw controlegrens blijven, in-transit-codering (TLS 1.3) en at-rest-codering (AES-256) zijn verplicht, en auditregistratie van alle inferentieverzoeken moet zijn onderhouden. SOC 2 Type II-compliance vereist leverancierneutrale beveiligingsaudits en gedocumenteerde incidentrespons. PCI-DSS-omgevingen moeten gebruik maken van luchtafgeluisterde inferentieservers zonder internetconnectiviteit. On-premises implementatie - in plaats van gedeelde cloud- of API-infrastructuur - is de enige architectuur die tegelijkertijd aan alle drie de frameworks voldoet zonder dat er aanzienlijke compenserende besturingselementen worden gecompenseerd.
Atal Networks’ Toegewijde serverinfrastructuur Ondersteunt air-gapped implementaties voor gereguleerde AI-inferentie. Neem contact met ons op via atalnetworks.com om uw nalevingsvereisten te bespreken.
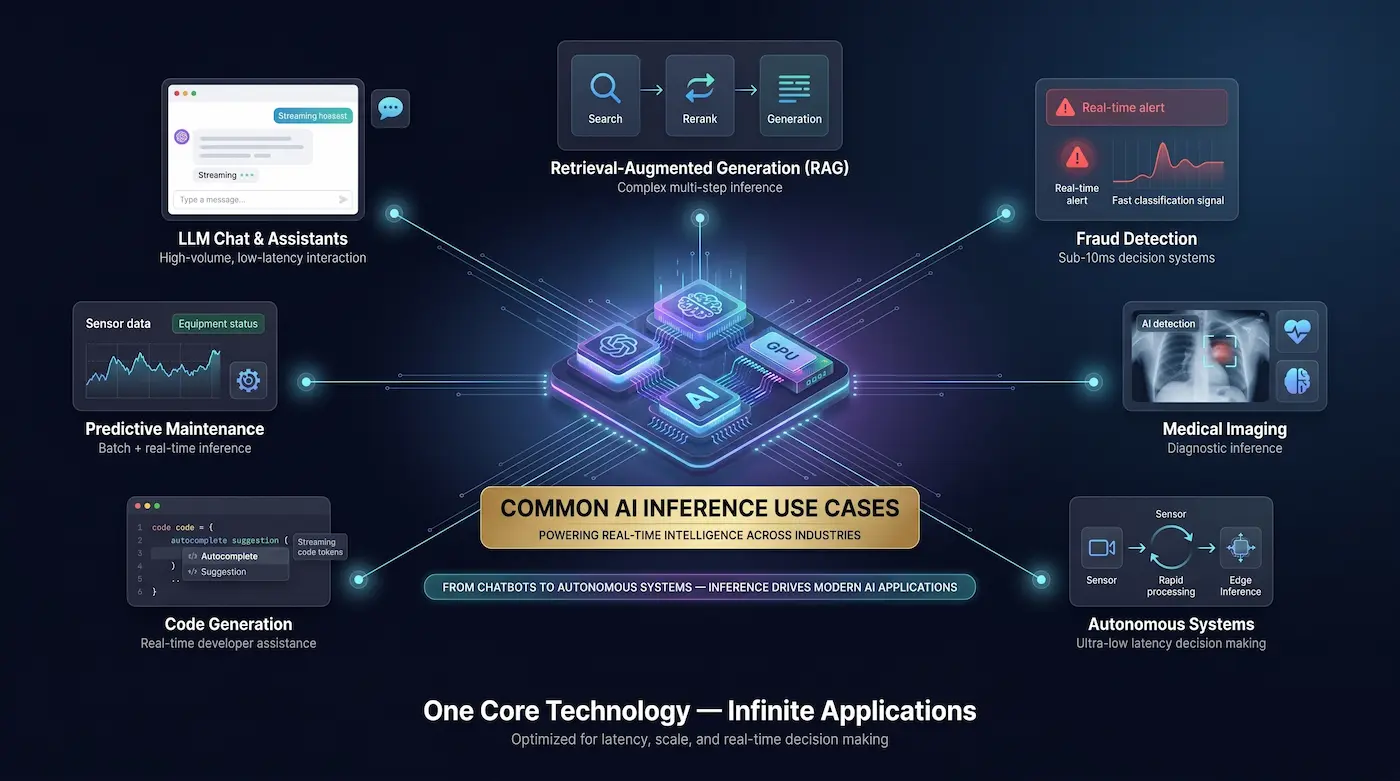
Gemeenschappelijke AI-inferentiegebruiksgevallen
AI Inference zorgt voor een breder scala aan productietoepassingen in elke branche:
- LLM-chat en assistenten: klantenservice-bots, interne kennisassistenten, coderingscodes - het zijn allemaal groot volume, latentiegevoelige inferentie-workloads.
- Retrieval-Augmented Generation (RAG): combineert een inbeddingsmodel (voor semantisch zoeken), een reranker en een LLM in een drietraps inferentiepijplijn. Elke fase voegt latentie en kosten toe.
- Fraudedetectie: realtime classificatie-inferentie bij latentie van minder dan 10 ms met behulp van kleinere gespecialiseerde modellen.
- Medische beeldvorming: CNN en visietransformator-inferentie voor radiologie, pathologie en diagnostiek - vaak vereist on-prem inzet voor HIPAA-compliance.
- Autonome voertuigen: inferentie van milliseconde-latency-perceptie op gespecialiseerde hardware aan boord (ORIN, D5).
- Codegeneratie: streaming-inferentie voor autocomplete vereist extreem lage ITL (< 15 ms) om realtime aan te voelen.
- Agentische workflows: agenten in meerdere stappen, tool-calling genereren veel inferentieaanroepen per gebruikerstaak, vermenigvuldigingskosten 5-20× versus single-turn-reacties.
- Voorspellend onderhoud: batch-inferentie op sensorgegevensstromen om het falen van apparatuur te voorspellen.
De toekomst van AI-inferentie - 2026 en verder
Verschillende trends hervormen het inferentielandschap tot 2026 en in 2027:
- Redeneringsmodellen en test-time schalen: zoals Deepseek-R1 en Gemini 2.5 denken aantoonden, verbetert het genereren van meer tokens op inferentietijd op betrouwbare wijze de outputkwaliteit op complexe taken. Dit verandert fundamenteel de kostencurve - de inferentierekening per query groeit, niet krimpt.
- Mengsel-of-experts (MOE) Dominantie: MOE-architecturen zoals Mixtral 8x22b activeren slechts een fractie van parameters per token, wat de prestaties van GPT-4-klasse levert bij 2-3 × lagere inferentierekenkosten. Verwacht dat Moe nieuwe modelreleases zal domineren.
- Uitgesplitst en speculatief dienend op schaal: het scheiden van voorvul- en decodepools, gecombineerd met speculatieve decodering in Eagle-stijl, wordt de standaard productiearchitectuur voor grootschalige LLM-implementaties.
- FP4 and FP6 maturation: NVIDIA’s Blackwell architecture introduced native NVFP4 support, enabling up to 5× throughput versus FP16 with acceptable quality. As framework support matures, FP4 inference will become mainstream by late 2026.
- Frontiermodellen op het apparaat: Apple Intelligence, Gemini Nano en Phi-3-Mini tonen aan dat 3b-7b gekwantiseerde modellen volledig op consumentenhardware kunnen draaien. De grens tussen wolk- en randinferentie vervaagt.
- Soevereine AI en data-ingezetenschap: geopolitieke druk drijft bedrijven en regeringen ertoe om volledige gegevenssoevereiniteit te eisen - gevolgtrekking binnen hun nationale grenzen, op hardware die ze bezitten. On-prem vraag zal groeien, niet krimpen.
Veelgestelde vragen (FAQ)
Wat is AI-inferentie in eenvoudige bewoordingen?
AI-inferentie is wanneer een getraind AI-model gebruikt wat het heeft geleerd om een nieuwe vraag te beantwoorden of een nieuwe taak te voltooien. Training leert het model; Inferentie is het model dat zijn werk doet. Elke keer dat u een reactie krijgt van CHATGPT, ontvangt u een productaanbeveling of ziet u een fraudewaarschuwing, dat is AI-inferentie in realtime.
Wat is het verschil tussen AI-inferentie en AI-training?
Training adjusts the model’s internal parameters (weights) by processing large datasets over days or weeks. Inference applies those fixed weights to new inputs to produce outputs — no learning occurs. Training is compute-bound and happens periodically; inference is memory-bandwidth-bound and happens billions of times daily. Training optimizes for FLOP throughput; inference optimizes for token throughput and latency.
Is ChatGPT-inferentie of training?
Wanneer u chatgpt met ChatGPT, activeert u gevolgtrekkingen - de gewichten van het model zijn vast en het past ze toe op uw input om een reactie te genereren. OpenAI traint (en retraint periodiek) GPT-4 afzonderlijk, op enorme datasets, tegen enorme kosten. Dat zijn twee totaal verschillende operaties. Wat je als gebruiker ervaart is 100% Inferentie.
Welke hardware wordt gebruikt voor AI-inferentie?
De dominante hardware voor grootschalige gevolgtrekkingen is Nvidia GPU's (H100, H200, B200, L40S), AMD GPU's (MI300X, MI355X) en Google TPU's voor cloud-native workloads. Voor edge-inferentie: Apple Neural Engine, Qualcomm Hexagon NPU en Nvidia Jetson Orin. Voor kostengevoelige of alleen-CPU-implementaties kunnen moderne Intel Xeon (AMX) en AMD ePYC-processors gekwantiseerde modellen uitvoeren met een acceptabele doorvoer.
Wat is de beste GPU voor AI-inferentie in 2026?
Voor grote modellen (70B+): de NVIDIA H200 SXM5 (141 GB HBM3E, 4,8 TB/s) biedt de beste prestatie per dollar voor de meeste workloads. Voor maximale doorvoer op grensmodellen: de B200 SXM6-leads. Voor kostengevoelige mid-range: de AMD MI300X (192 GB HBM3, $10K-$15K lager dan H200) wordt steeds concurrerender. Voor edge/single-GPU-inferentie: de NVIDIA L40S (48 GB GDDR6) balanceert de kosten en capaciteit goed.
Hoe werkt LLM-inferentie stap voor stap?
- Tokenization: De invoertekst wordt geconverteerd naar IDS voor integer-tokens. 2. Prefill: Alle invoertokens worden gelijktijdig verwerkt in één voorwaartse doorgang, waardoor de KV-cache en het eerste uitvoertoken worden gegenereerd. 3. Decodeer: Nieuwe tokens worden één voor één gegenereerd, elk aandachtig voor de volledige KV-cache. 4. Continue batching: Meerdere gelijktijdige verzoeken Delen GPU Compute via in-flight batching. 5. Streaming: uitvoertokens worden getokeniseerd en naar de client gestreamd wanneer ze worden gegenereerd.
Wat zijn TTFT en ITL in LLM-inferentie?
TTFT (Time to First Token) meet hoe lang vanaf het indienen van het verzoek tot het eerste uitvoertoken is geretourneerd - de latentie die de gebruiker ziet als "wachttijd". Het wordt gedomineerd door de prefill-fase. ITL (Inter-Token latentie) meet de gemiddelde tijd tussen opeenvolgende outputtokens tijdens decodering - wat de "streamingsnelheid" bepaalt die de gebruiker ziet. Beide moeten worden geoptimaliseerd voor realtime chat: meestal TTFT < 200ms en ITL < 30ms voor een responsieve ervaring.
Wat is een KV-cache en waarom maakt het uit?
De kv-cache (key-value cache) slaat de intermediaire aandachtsberekeningen (sleutels en waarden) op voor elk token in de gesprekscontext. Zonder dit zou het model het hele contextvenster opnieuw moeten verwerken voor elke nieuwe token - O(n²) Compute. Hiermee verwerkt elke decodeerstap slechts één nieuw token, waardoor LLM-inferentie haalbaar wordt. KV-cachegrootte is een primaire beperking voor het aantal gelijktijdige gebruikers dat een GPU kan bedienen en hoe lang het contextvenster kan zijn.
Hoeveel kost AI-inferentie per 1 miljoen tokens?
Op zelf-gehoste hardware (8 × H200, 3-jarige afschrijving, $0.12/kWh, 80%-gebruik, LLAMA-3-70B FP8): ongeveer $0.18 per 1M-ingangtokens en $0.71 per 1M-uitvoertokens. Via openbare API: GPT-4O kost $2.50/$10.00 Input/output per 1M tokens; Claude Sonnet kost $3.00/$15.00. Zelfhosting op schaal levert 5-20× kostenreductie op, met break-even meestal op 5-15 miljoen outputtokens/dag, afhankelijk van de API-provider en het model.
Kun je AI-inferentie uitvoeren op een CPU?
Ja — voor kleinere, gekwantiseerde modellen. lama.cpp maakt int4/int8-inferentie mogelijk op elke x86-cpu. Een dual-socket Xeon Platinum met AMX genereert ~25-40 tokens/sec op een 7B Int4-model, wat voldoende is voor niet-realtime workloads. CPU-inferentie is niet levensvatbaar voor 70B+-modellen bij productiedoorvoer. De economie werkt voor ontwikkeling, testen en latentietolerante batchtaken waarbij GPU-huurkosten de waarde van de doorvoer overschrijden.
Wat is het verschil tussen prefill en decodering in LLM-inferentie?
Prefill verwerkt de volledige invoerprompt in één parallelle bewerking (compute-gebonden, snel, schaalt met promptlengte). Decode genereert uitvoertokens één voor één in een autoregressieve lus (geheugenbandbreedte-gebonden, langzamer per token, schaalt met uitvoerlengte en gelijktijdige gebruikers). De overgang tussen hen - wanneer het eerste token wordt gegenereerd - is TTFT. Het optimaliseren van Prefill vermindert TTFT; Het optimaliseren van decode vermindert ITL en verbetert de doorvoer.
Wanneer moet u zelf-host AI-inferentie versus een API gebruiken?
Gebruik een API wanneer: het volume laag is (< 2M-tokens/dag), je hebt een Frontier Closed-model nodig (GPT-4O, Claude), of je bent aan het prototypen en wilt nul capex. Self-host Wanneer: Volume groter is dan 5 miljoen tokens/dag, gegevensprivacy of naleving vereist, u wilt het model verfijnen of besturen, of u hebt gegarandeerde SLA zonder tarieflimieten nodig. Het break-even-punt versus de meeste API's is 3-18 maanden, afhankelijk van het model en het volume, waarna on-prem jarenlang gunstig steekt.
Bouwen of kopen — Volgende stappen met Atal Networks
Als je dit punt hebt bereikt, heb je een volledig beeld van wat AI-inferentie is, hoe het werkt, wat het kost en welke hardware het aandrijft. De volgende vraag is de uitvoering.
Atal Networks is gespecialiseerd in speciaal gebouwde AI-inferentie-infrastructuur voor ondernemingen die API-afhankelijkheid zijn ontgroeid. Ons team heeft GPU-clusters ontworpen en geïmplementeerd in de sectoren gezondheidszorg, financiële diensten, productie en software - en we publiceren de benchmarkgegevens, niet alleen de brochure.
Ontdek onze Specifieke serverconfiguraties Voor high-throughput, on-prem inferentie-implementaties met H100-, H200- en MI300X-systemen.
Op zoek naar een instappunt met een lagere Capex? Onze GPU-geoptimaliseerde VPS-abonnementen Laat u vandaag beginnen met het uitvoeren van privé-inferentieworkloads zonder het rack te bezitten.
Klaar om nummers te praten? Bezoek atalnetworks.com En spreek rechtstreeks met een hardware-engineer - geen verkoopscript.
